

Mēs Badoo pastāvīgi uzraugām jaunas tehnoloģijas un izvērtējam, vai tās ir vērts ieviest mūsu sistēmā. Ar šo pētījumu mēs vēlamies dalīties ar kopienu. Tas ir veltīts Loki — žurnālu apkopojuma sistēmai.
Loki ir risinājums žurnālu glabāšanai un skatīšanai, kā arī šis komplekts piedāvā elastīgu sistēmu to analīzei un datu sūtīšanai uz Prometheus. Maijā tika izlaists nākamais atjauninājums, kuru aktīvi popularizē izstrādātāji. Mūs interesēja, ko spēj Loki, kādas iespējas tas nodrošina un cik lielā mērā tas var kalpot kā alternatīva ELK — stekam, kuru mēs pašlaik izmantojam.
Kas ir Loki
Grafana Loki ir komponentu komplekts pilnvērtīgai sistēmai darbam ar žurnāliem. Atšķirībā no citām līdzīgām sistēmām, Loki balstās uz ideju indeksēt tikai žurnālu metadatus — labels (tāpat kā Prometheus), bet pašus žurnālus blakus saspiest atsevišķos blokos.
,
Pirms pārejām pie apraksta par to, ko var darīt ar Loki, vēlos skaidrot, ko nozīmē „ideja indeksēt tikai metadatus”. Salīdzināsim Loki pieeju un datu indeksēšanu tradicionālajās risinājumos, piemēram, Elasticsearch, izmantojot strīpu no nginx žurnāla kā piemēru:
172.19.0.4 - - [01/Jun/2020:12:05:03 +0000] "GET /purchase?user_id=75146478&item_id=34234 HTTP/1.1" 500 8102 "-" "Stub_Bot/3.0" "0.001"Tradicionālās sistēmas analizē visu rindu, tostarp laukus ar lielu unikālo vērtību skaitu user_id un item_id, un saglabā visu lielos indeksos. Šī pieeja ir priekšrocība, jo var veikt sarežģītus vaicājumus ātri, jo gandrīz visi dati ir indeksā. Taču tam jāmaksā, jo indekss kļūst liels, kas izriet no prasībām pēc atmiņas. Rezultātā pilnteksta žurnālu indekss ir līdzīgs pati žurnālu izmēram. Lai ātri meklētu tajā, indeksam jābūt ielādētam atmiņā. Un jo vairāk žurnālu, jo ātrāk indekss palielinās un jo vairāk atmiņas tas patērē.
Loki pieeja prasa, lai no virknē tiktu izvilkti tikai nepieciešamie dati, kuru vērtību skaits ir mazs. Tādējādi mēs iegūstam mazu indeksu un varam meklēt datus, filtrējot tos pēc laika un indeksētajiem laukiem, pēc tam skanējot atlikumu ar regulāriem izteiksmēm vai apakšvirknēm. Process šķiet nav pats ātrākais, taču Loki sadala pieprasījumu vairākās daļās un veic tās paralēli, apstrādājot lielu datu apjomu īsā laikā. Shardu un paralēlo pieprasījumu skaits tajos ir konfigūrējams; tādējādi datu daudzums, ko var apstrādāt noteiktā laika vienībā, lineāri atkarīgs no sniegto resursu skaita.
Šis kompromiss starp lielu ātru indeksu un mazu indeksu ar paralēlu pilno pārlūkšanu ļauj Loki kontrolēt sistēmas izmaksas. To var elastīgi pielāgot un paplašināt atbilstoši vajadzībām.
Loki steks sastāv no trim komponentiem: Promtail, Loki, Grafana. Promtail savāc žurnālus, apstrādā tos un nosūta uz Loki. Loki tos glabā. Bet Grafana prot pieprasīt datus no Loki un rādīt tos. Patiesībā Loki var izmantot ne tikai žurnālu glabāšanai un meklēšanai tajos. Viss steks sniedz lielas iespējas apstrādei un ienākošo datu analīzei, izmantojot Prometheus veidu.
Procesa uzstādīšanas aprakstu var atrast .
Meklēšana pa žurnāliem
Meklēt žurnālos var speciālā Grafana interfeisā — Explorer. Pieprasījumiem tiek izmantota LogQL valoda, kas ļoti līdzīga PromQL, kas tiek izmantota Prometheus. Principā to var uzskatīt par sadalītu grep.
Meklēšanas interfeiss izskatās šādi:
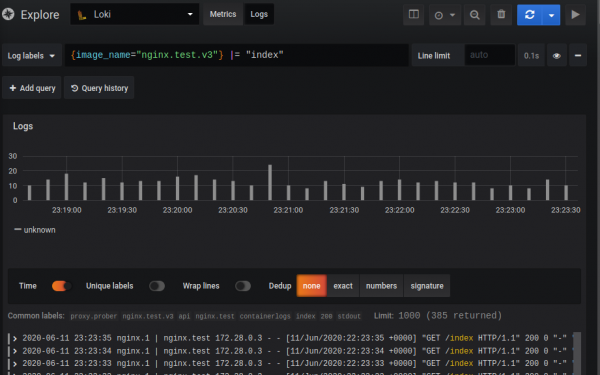
Pats pieprasījums sastāv no divām daļām: selektors un filtrs. Selektors — tas ir meklējums pēc indeksētajiem metadatiem (etiketēm), kas piešķirti žurnāliem, bet filtrs — meklēšanas virkne vai regulārā izteiksme, ar kuras palīdzību tiek filtrēti ieraksti, ko nosaka selektors. Dotajā piemēra: Liekie iekavās — selektors, viss pēc — filtrs.
{image_name="nginx.promtail.test"} |= "index"Dēļ Loki darbības principa nav iespējams veikt pieprasījumus bez selektora, taču etiķetes var būt tik pat vispārīgas, cik vien vēlaties.
Selektors — tas ir key-value vērtības liekā iekavās. Var kombinēt selektorus un noteikt dažādus meklēšanas nosacījumus, izmantojot operatorus =, != vai regulārās izteiksmes:
{instance=~"kafka-[23]",name!="kafka-dev"}
// Atradīs žurnālus ar lable instance, kuriem vērtība ir kafka-2, kafka-3, un izslēgs dev
Filtrs ir teksts vai regulārā izteiksme, kas atlasīs visus datus, ko iegūst selektors.
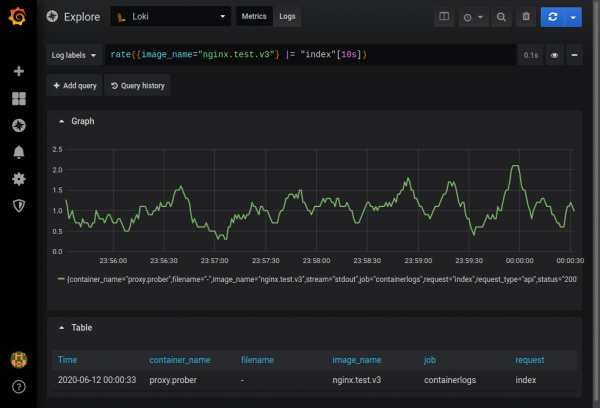
Ir iespēja iegūt ad-hoc diagrammas par iegūtajiem datiem metrics režīmā. Piemēram, var uzzināt, cik bieži žurnālos nginx parādās ieraksts, kurā ir rinda index:
Pilnu iespēju aprakstu var atrast dokumentācijā .
Žurnālu parsēšana
Ir vairākas metodes, kā savākt žurnālus:
- Izmantojot Promtail, standarta komponentu žurnālu vākšanai.
- Tieši no docker konteinera, izmantojot
- Izmantot Fluentd vai Fluent Bit, kas spēj sūtīt datus uz Loki. Atšķirībā no Promtail, tiem ir gatavi parsētāji praktiski jebkura veida žurnāliem, un tie tiek galā arī ar multiline žurnāliem.
Parasti žurnālu parsēšanai izmanto Promtail. Tas veic trīs uzdevumus:
- Atrod datu avotus.
- Pievieno tiem lable.
- Sūta datus uz Loki.
Pašlaik Promtail var lasīt žurnālus no vietējiem failiem un no systemd žurnāla. Tam jābūt instalētam katrā mašīnā, no kuras savāc žurnālus.
Ir integrācija ar Kubernetes: Promtail automātiski, izmantojot Kubernetes REST API, uzzina klastera stāvokli un savāc žurnālus no mezgla, servisa vai poda, nekavējoties pievienojot lable, pamatojoties uz metadatiem no Kubernetes (poda nosaukums, faila nosaukums utt.).
Tāpat var pievienot lable pamatojoties uz datiem no žurnāla, izmantojot Pipeline. Promtail Pipeline var sastāvēt no četriem posmiem. Plašāk — , šeit es atzīmēšu dažas nianses.
- Parsēšanas posmi. Tas ir RegEx un JSON posms. Šajā etapā mēs izvelkam datus no žurnāliem tā sauktajā extracted map. Datus var izvilkt no JSON, vienkārši kopējot nepieciešamos laukus extracted map, vai izmantojot regulārās izteiksmes (RegEx), kur extracted map “mapē” nosauktās grupas. Extracted map ir key-value krātuve, kur key ir lauka nosaukums, bet value ir tā vērtība no žurnāliem.
- Transformācijas posmi. Šim posmam ir divas opcijas: transformēt, kur mēs nosakām pārveidošanas noteikumus, un source — datu avots pārveidošanai no extracted map. Ja extracted map nav šāda lauka, tas tiks izveidots. Tādējādi var izveidot lable, kas nav balstīti uz extracted map. Šajā etapā mēs varam manipulēt ar datiem extracted map, izmantojot pietiekami jaudīgu . Turpinot, jāatceras, ka extracted map tiek pilnībā ielādēta, kad to analizē, kas ļauj, piemēram, pārbaudīt vērtību tajā: “{{if .tag}tag value exists{end}}”. Template atbalsta nosacījumus, ciklus un dažas virkņu funkcijas, piemēram, Replace un Trim.
- Darbību posmi. Šajā posmā var izdarīt kaut ko ar iegūto:
- Izveidot birku no extracted data, kas tiks indeksēta Loki.
- Mainīt vai iestatīt notikuma laiku no žurnāla.
- Mainīt datus (žurnāla tekstu), kas tiks nosūtīti uz Loki.
- Izveidot metriku.
- Filtrēšanas posmi. Match posms, kurā var vai nu sūtīt uz /dev/null ierakstus, kas mums nav nepieciešami, vai arī novirzīt tos tālākai apstrādei.
Parādīšu, kā piemēru parasto nginx žurnālu apstrādē, kā var analizēt žurnālus, izmantojot Promtail.
Testam ņemsim kā nginx-proxy modificētu attēlu nginx jwilder/nginx-proxy:alpine un nelielu demon, kas spēj jautāt pats sev pa HTTP. Demonam ir norādīti daži galapunkti, uz kuriem tas var sniegt atbildes atšķirīga lieluma, ar dažādiem HTTP statusiem un dažādu aizturi.
Žurnālus savāksim no Docker konteineriem, kurus var atrast ceļā /var/lib/docker/containers//-json.log
docker-compose.yml konfigurējam Promtail un norādām ceļu uz konfigurāciju:
promtail:
  image: grafana/promtail:1.4.1
 // ...
 volumes:
   - /var/lib/docker/containers:/var/lib/docker/containers:ro
   - promtail-data:/var/lib/promtail/positions
   - ${PWD}/promtail/docker.yml:/etc/promtail/promtail.yml
 command:
   - '-config.file=/etc/promtail/promtail.yml'
 // ...
Pievienojam promtail.yml ceļu uz žurnāliem (konfigurācijā ir opcija "docker", kas dara to pašu vienā rindā, bet tas nebūtu tik pārskatāmi):
scrape_configs:
 - job_name: containers

   static_configs:
       labels:
         job: containerlogs
         __path__: /var/lib/docker/containers/*/*log  # tikai linux
Ieslēdzot šādu konfigurāciju, Loki tiks iekļauti žurnāli no visiem konteineriem. Lai to novērstu, mainām testējamā nginx iestatījumus docker-compose.yml — pievienojam žurnālu lauku tag:
proxy:
 image: nginx.test.v3
 //…
 logging:
   driver: "json-file"
   options:
     tag: "{{.ImageName}}|{{.Name}}"
Labojam promtail.yml un konfigurējam Pipeline. Iegūstam žurnālus šāda veida:
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] \"GET /api/index HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.096\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.66740443Z"}
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] \"GET /200 HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.000\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.702925272Z"}
Pipeline posms:
 - json:
     expressions:
       stream: stream
       attrs: attrs
       tag: attrs.tag
Izvelkam no ienākoša JSON lauka stream, attrs, attrs.tag (ja tādi ir) un ievietojam tos extracted map.
 - regex:
     expression: ^(?P([^|]+))|(?P([^|]+))$
     source: "tag"
Ja lauka tag ievietošana extracted map izdevās, tad ar regex izvelkam attēla un konteineru nosaukumus.
 - labels:
     image_name:
     container_name:
Piešķiram birkas. Ja extracted data tiks konstatēti atslēgvārdi image_name un container_name, to vērtības tiks piešķirtas atbilstošajām birkām.
 - match:
     selector: '{job="docker",container_name="",image_name=""}'
     action: drop
Noraidām visus žurnālus, kur nav atrastas noteiktās birkas image_name un container_name.
  - match:
     selector: '{image_name="nginx.promtail.test"}'
     stages:
       - json:
           expressions:
             row: log
Visiem žurnāliem, kuros image_name ir vienāds ar nginx.promtail.test, izvelkam no sākotnējā žurnāla lauku log un ievietojam to extracted map ar atslēgu row.
  - regex:
         # suppress forego colors
         expression: .+nginx.+|.+[0m(?P[a-z_.-]+) +(?P.+)
         source: logrow
Attīram ieejas virkni ar regulāriem izteiksmēm un izvelkam nginx virtuālo hostu un nginx žurnāla rindu.
     - regex:
         source: nginxlog
         expression: ^(?P[w.]+) - (?P[^ ]*) [(?P[^ ]+).*] "(?P[^ ]*) (?P[^ ]*) (?P[^ ]*)" (?P[d]+) (?P[d]+) "(?P[^"]*)" "(?P[^"]*)"( "(?P[d.]+)")?
Parsējam nginx žurnālu ar regulāriem izteiksmēm.
    - regex:
           source: request_url
           expression: ^.+.(?Pjpg|jpeg|gif|png|ico|css|zip|tgz|gz|rar|bz2|pdf|txt|tar|wav|bmp|rtf|js|flv|swf|html|htm)$
     - regex:
           source: request_url
           expression: ^/photo/(?P[^/?]+).*$
       - regex:
           source: request_url
           expression: ^/api/(?P[^/?]+).*$
Izvērtējam request_url. Ar regex palīdzību nosakām pieprasījuma mērķi: statikai, fotogrāfijām, API un ievietojam extracted map atbilstošo atslēgu.
       - template:
           source: request_type
           template: "{{if .photo}}photo{{else if .static_type}}static{{else if .api_request}}api{{else}}other{{end}}"
Ar nosacījuma operatoru palīdzību Template pārbaudām noteiktos laukus extracted map un piešķiram laukam request_type vajadzīgās vērtības: photo, static, API. Piešķiram other, ja tas neizdevās. Tagad request_type satur pieprasījuma tipu.
       - labels:
           api_request:
           virtual_host:
           request_type:
           status:
Nosakām birkas api_request, virtual_host, request_type un status (HTTP status) balstoties uz to, kas tika ievietots extracted map.
       - output:
           source: nginx_log_row
Mainām output. Tagad Loki tiek nosūtīts attīrīts nginx žurnāls no extracted map.
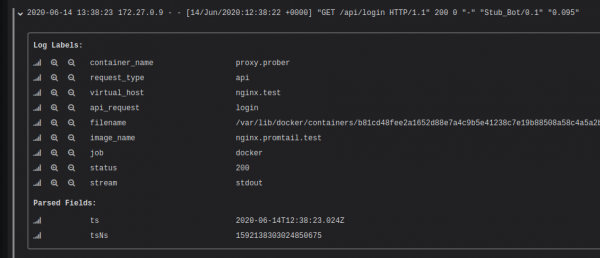
Pēc šī konfigurācijas iedarbināšanas var redzēt, ka katrai ierakstam ir piešķirtas birkas, balstoties uz žurnāla datiem.
Jāņem vērā, ka birku iegūšana ar augstu vērtību skaitu (cardinality) var būtiski palēnināt Loki darbību. Tādēļ nevajadzētu ievietot indeksā, piemēram, user_id. Par to vairāk lasiet rakstā “”. Bet tas nenozīmē, ka nevar meklēt pēc user_id bez indeksiem. Jāizmanto filtri meklēšanā (veicot „grep” datiem), bet indekss šajā gadījumā kalpo kā plūsmas identifikators.
Žurnālu vizualizācija
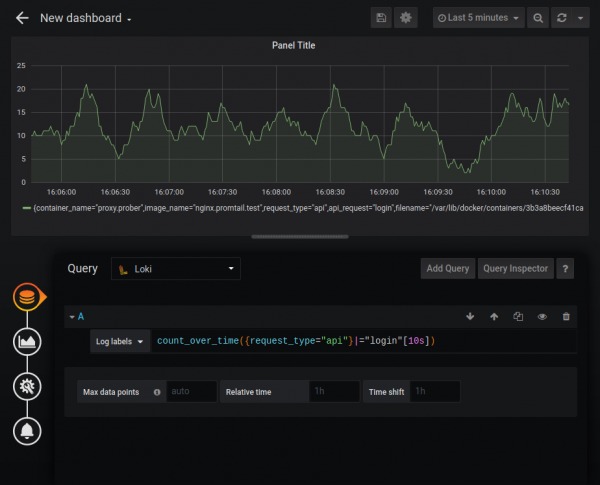
Loki var kalpot kā datu avots Grafana grafikiem, izmantojot LogQL. Atbalsta šādas funkcijas:
- rate — ierakstu skaits sekundē;
- count over time — ierakstu skaits noteiktā laika intervālā.
Ir pieejamas arī agregācijas funkcijas Sum, Avg un citas. Var izveidot diezgan sarežģītus grafikus, piemēram, HTTP kļūdu skaita grafiku:
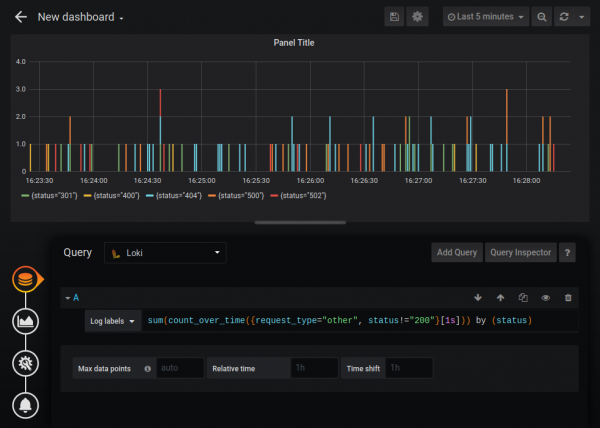
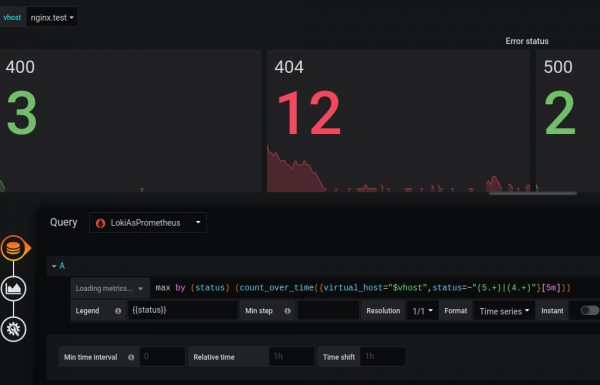
Standarta datu avots Loki ir nedaudz ierobežots salīdzinājumā ar datu avotu Prometheus (piemēram, nevar mainīt leģendu), taču Loki var pievienot kā avotu ar Prometheus tipu. Neesmu pārliecināts, vai tas ir dokumentēts uzvedības veids, bet, pēc izstrādātāju atbildes “”, piemēram, tas ir pilnīgi likumīgi, un Loki ir pilnīgi saderīgs ar PromQL.
Pievienojam Loki kā datu avotu ar Prometheus tipu un norādām URL /loki:

Un varam veidot grafikus, tāpat kā tad, ja mēs strādājam ar metrikām no Prometheus:
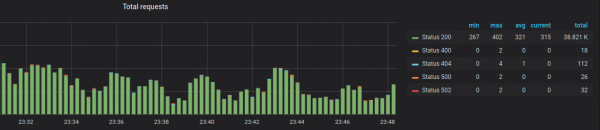
Domāju, ka atšķirība funkcionālajā līmenī ir pagaidu, un izstrādātāji to nākotnē labos.
Metarīz
Loki piedāvā iespēju iegūt skaitliskās metriskas no žurnāliem un nosūtīt tās Prometheus. Piemēram, nginx žurnālā ir ierakstīts atbildes baitus skaits, kā arī, veicot noteiktas modifikācijas standarta žurnāla formātā, arī laiks sekundēs, kas bija nepieciešams atbildei. Šos datus var iegūt un nosūtīt Prometheus.
Pievienojam vēl vienu sadaļu promtail.yml:
- match:
   selector: '{request_type="api"}'
   stages:
     - metrics:
         http_nginx_response_time:
           type: Histogram
           description: "atbildes laiks ms"
           source: response_time
           config:
             buckets: [0.010,0.050,0.100,0.200,0.500,1.0]
- match:
   selector: '{request_type=~"static|photo"}'
   stages:
     - metrics:
         http_nginx_response_bytes_sum:
           type: Counter
           description: "atbildes baitu summa"
           source: bytes_out
           config:
             action: add
         http_nginx_response_bytes_count:
           type: Counter
           description: "atbildes baitu skaits"
           source: bytes_out
           config:
             action: inc
Šī opcija ļauj definēt un atjaunināt metriku, pamatojoties uz datiem, kas iegūti no extracted map. Šīs metrikas netiek nosūtītas uz Loki — tās parādās Promtail /metrics galapunktā. Prometheus ir jābūt konfigurētam tā, lai iegūtu datus no šī posma. Norādītajā piemērā, kad request_type="api", mēs vācam histogrammas metriku. Ar šāda veida metrikām ir ērti iegūt percentīļus. Statistikas un foto materiāliem mēs vācam byte skaitu un rindu skaitu, kurās saņēmām bytes, lai aprēķinātu vidējo vērtību.
Sīkāk par metrikām lasiet .
Atveram portu Promtail:
promtail:
     image: grafana/promtail:1.4.1
     container_name: monitoring.promtail
     expose:
       - 9080
     ports:
       - "9080:9080"
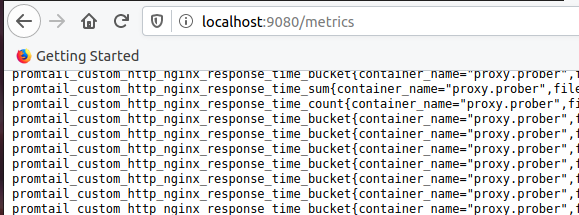
Pārliecināmies, ka metrikas ar prefiksu promtail_custom parādās:
Konfigurējam Prometheus. Pievienojam job promtail:
- job_name: 'promtail'
 scrape_interval: 10s
 static_configs:
   - targets: ['promtail:9080']
Un zīmējam grafiku:
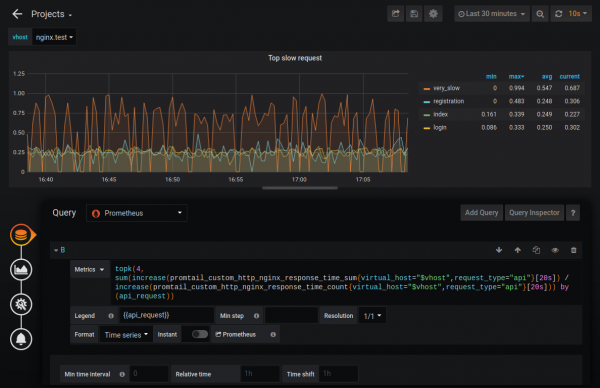
Tādējādi var uzzināt, piemēram, četrus lēnāko pieprasījumu. Arī uz šiem datiem var iestatīt uzraudzību.
Mērogošana
Loki var būt gan vienas bināras lietošanas režīmā (single binary mode), gan šardēšanas režīmā (horizontally-scalable mode). Otrajā gadījumā tas var saglabāt datus mākonī, turklāt čankas un indekss tiek glabāti atsevišķi. 1.5 versijā ir ieviesta iespēja glabāt vienā vietā, bet pagaidām nav ieteicams to izmantot ražošanā.
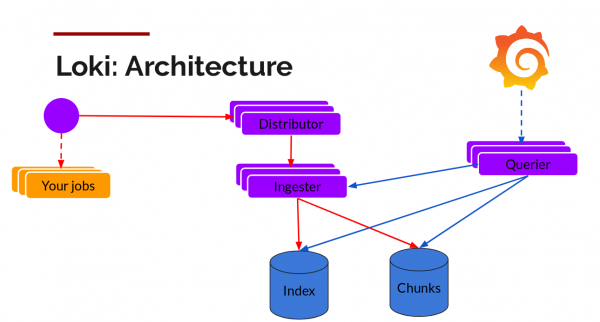
Čankas var glabāt S3 saderīgā krātuvē, bet indeksu glabāšanai ir jāizmanto horizontāli skalojamas datubāzes: Cassandra, BigTable vai DynamoDB. Pārējās Loki daļas — Distributors (rakstīšanai) un Querier (vaicājumiem) — ir stateless un arī tās tiek horizontāli skalotas.
2019. gada DevOpsDays Vancouver konferencē viens no dalībniekiem Callum Styan paziņoja, ka ar Loki viņa projekts ir iegūst petabaitus žurnālu ar indeksu, kas ir mazāks par 1% no kopējā apjoma: “”.
Loki un ELK salīdzinājums
Indeksa lielums
Indeksa iegūtā lieluma testēšanai es paņēmu žurnālus no nginx konteineru, kuram tika konfigurēts iepriekš minētais Pipeline. Žurnālu fails saturēja 406 624 rindas ar kopējo apjomu 109 MB. Žurnāli tika ģenerēti stundas laikā, aptuveni 100 ieraksti sekundē.
Divu rindkopu piemērs no žurnāla:
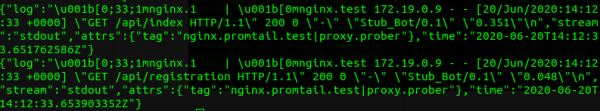
Indeksējot ELK, tas deva indeksa lielumu 30,3 MB:
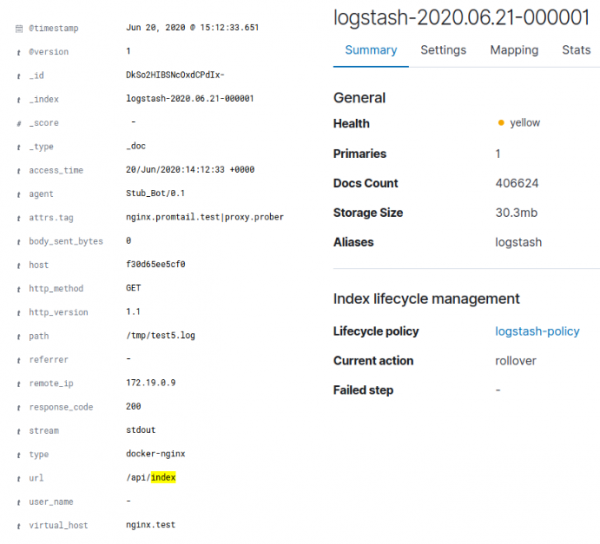
Runājot par Loki, tas deva aptuveni 128 KB indeksu un aptuveni 3,8 MB datu čankos. Jāatzīmē, ka žurnāls tika mākslīgi ģenerēts un neizcēlās ar lielu datu dažādību. Parastais gzip uz sākotnējā Docker JSON žurnāla datiem nodrošināja 95,4% kompresiju, bet ņemot vērā, ka pats Loki saņēma tikai attīrītu nginx žurnālu, tad samazinājums līdz 4 MB ir saprotams. Kopējais unikālo vērtību skaits Loki标签iem bija 35, kas izskaidro mazo indeksu izmēru. ELK žurnāls tika arī attīrīts. Tādējādi Loki samazināja sākotnējos datus par 96%, bet ELK – par 70%.
Atmiņas patēriņš
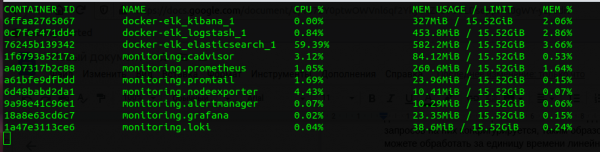
Salīdzinot visu Prometheus un ELK stogu, Loki «ēd» vairākas reizes mazāk. Ir skaidrs, ka pakalpojums uz Go patērē mazāk nekā pakalpojums uz Java, un salīdzinājums starp JVM Heap Elasticsearch un Loki piešķirto atmiņu nav precīzs, tomēr jāatzīmē, ka Loki izmanto daudz mazāk atmiņas. Tās priekšrocība CPU ziņā nav tik acīmredzama, bet arī pastāv.
Ātrums
Loki ātrāk «apēd» žurnālus. Ātrums atkarīgs no daudziem faktoriem — kādi ir žurnāli, kā mēs tos apstrādājam, tīkls, disks utt. — bet tas noteikti ir augstāks nekā ELK (manā testā — aptuveni divreiz). Tas izskaidrojams ar to, ka Loki ievieto daudz mazāk datu indeksā un, attiecīgi, tērē mazāk laika indeksēšanai. Attiecībā uz meklēšanas ātrumu situācija ir pretēja: Loki ievērojami palēninās ar datiem, kuru izmērs ir vairāk nekā daži gigabaiti, savukārt ELK meklēšanas ātrums nav atkarīgs no datu izmēra.
Meklēšana pa žurnāliem
Loki ievērojami atpaliek no ELK iespēju ziņā meklēšanai pa žurnāliem. Grep ar regulārām izteiksmēm ir spēcīgs rīks, bet tas nav tādu datu bāzu līmenī. Range pieprasījumu trūkums, agregācija tikai pēc etiķetēm, nespēja meklēt bez etiķetēm — tas viss ierobežo mūs atbilstošas informācijas meklēšanā Loki. Tas nenozīmē, ka ar Loki neko nevar atrast, bet nosaka darba plūsmu ar žurnāliem, kad vispirms nosaka problēmu Prometheus grafikos, un pēc tam pēc šīm etiķetēm meklē, kas notika žurnālos.
Interfeiss
Pirmkārt, tas ir skaisti (atvainojiet, nespēju atturēties). Grafana ir patīkama acij saskarne, bet Kibana ir daudz funkcionālāka.
Loki priekšrocības un trūkumi
Nozīmīgi ieguvumi ir tas, ka Loki integrējas ar Prometheus, tādējādi mēs iegūstam metrikas un brīdinājumus automātiski. Tas ir ērti logu vākšanai un glabāšanai no Kubernetes Pods, jo tam ir mantošana no Prometheus service discovery un tas automātiski pievieno birkas.
Trūkumi — vāja dokumentācija. Dažas lietas, piemēram, Promtail īpašības un iespējas, es atklāju tikai kodu izpētes procesā, par laimi, tā ir open-source. Vēl viens trūkums — vājas parsēšanas iespējas. Piemēram, Loki neskaidro multiline-logus. Tādējādi, trūkumu sarakstā var iekļaut arī to, ka Loki ir salīdzinoši jauna tehnoloģija (1.0 izlaišana notika 2019. gada novembrī).
Secinājums
Loki ir 100% interesanta tehnoloģija, kas ir piemērota mazajiem un vidējiem projektiem, ļaujot risināt daudzas logu apkopojuma, meklēšanas, uzraudzības un analīzes problēmas.
Mēs Badoo neizmantojam Loki, jo mums ir ELK steka risinājums, kas mums der un kas ir attīstījies gadu gaitā ar dažādām pielāgotām shēmām. Mums ir svarīgi spēt ātri atrast visu un nedaudz vairāk, jo katru dienu mums ir gandrīz 100 GB logu. Grafiku veidošanai un uzraudzībai mēs izmantojam citas risinājums, kas ir pielāgoti mūsu vajadzībām un ir integrēti savā starpā. Loki stekam ir acīmredzami ieguvumi, bet tas mums nesniegs vairāk, nekā mums jau ir, un tā priekšrocības noteikti nepārspēs migrācijas izmaksas.
Un, lai gan pēc izpētes bija skaidrs, ka mēs Loki nevaram izmantot, mēs ceram, ka šis raksts palīdzēs jums izvēlēties.
Koda repozitorijs, ko izmantojām rakstā, atrodas .
Avots: habr.com
