

Raksta tulkojums sagatavots īpaši kursa studentiem .
— programmatūras izstrādātājs, Go entuziasts un sarežģītu problēmu risinātājs. Viņš ir arī Prometheus uzturētājs un Kubernetes SIG instrumentation līdzīpašnieks. Iepriekš viņš bija produkcijas inženieris uzņēmumā SoundCloud un vadīja monitoringa grupu CoreOS. Šobrīd viņš strādā Google.
— infrastruktūras inženieris uzņēmumā Improbable. Viņam patīk jaunas tehnoloģijas un sadalītu sistēmu izaicinājumi. Viņam ir zemu līmeņu programmēšanas pieredze Intel, pieredze kā Mesos ieguldītājam un SRE produkcijas līmeņa pieredze globālā mērogā uzņēmumā Improbable. Viņš strādā pie mikroservisu pasaules uzlabošanas. Trīs viņa mīlestības: Golang, atvērtā koda un volejbols.
Skatoties uz mūsu flagmaņu produktu SpatialOS, jūs varat nojaust, ka Improbable nepieciešama augstas dinamikas globāla mākonī balstīta infrastruktūra ar desmitiem Kubernetes klasteru. Mēs bijām vieni no pirmajiem, kas uzsāka uzraudzības sistēmas izmantošanu . Prometheus spēj reāllaikā sekot līdzi miljoniem metrikām un nāk ar spēcīgu vaicājumu valodu, kas ļauj iegūt nepieciešamo informāciju.
Prometheus vienkāršība un uzticamība ir viens no tā galvenajiem ieguvumiem. Tomēr, sasniedzot noteiktu mērogu, mēs saskārāmies ar dažām problēmām. Lai risinātu šīs problēmas, mēs izstrādājām — atvērtā koda projektu, ko izveidojusi uzņēmums Improbable, lai bezšuvju veidā transformētu esošos Prometheus klasterus vienotā uzraudzības sistēmā ar neierobežotu vēsturisko datu krātuvi. Thanos ir pieejams Github .
Mūsu mērķi ar Thanos
Sasniedzot noteiktu mērogu, rodas problēmas, kas pārsniedz vaniļas Prometheus iespējas. Kā uzticami un ekonomiski uzglabāt petabaitus vēsturisko datu? Vai to var izdarīt, nesamazinot atbildes laiku uz pieprasījumu? Vai var piekļūt visām metrikām, kas atrodas dažādos Prometheus serveros, izmantojot vienu API pieprasījumu? Vai ir iespēja apvienot replikētus datus, ko savākuši Prometheus HA?
Lai risinātu šos jautājumus, mēs izveidojām Thanos. Nākamajās sadaļās tiks aprakstīts, kā mēs pievēršamies šo jautājumu risināšanai, un tiks izskaidroti mērķi, kurus mēs centāmies sasniegt.
Datu pieprasījums no vairākiem Prometheus eksemplāriem (globālais vaicājums)
Prometheus piedāvā funkcionālu pieeju šardingu. Pat viens Prometheus serveris nodrošina pietiekamu mērogojamību, lai atbrīvotu lietotājus no horizontālā šardinga sarežģītībām praktiski visos izmantošanas scenārijos.
Lai arī tā ir lieliska izvietošanas modeļa, bieži vien ir nepieciešams piekļūt datiem no dažādiem Prometheus serveriem, izmantojot vienotu API vai UI — global view. Protams, ir iespēja attēlot vairākus pieprasījumus vienā Grafana paneļa, taču katrs pieprasījums var tikt izpildīts tikai uz viena Prometheus servera. Savukārt, izmantojot Thanos, jūs varat pieprasīt un agregēt datus no vairākiem Prometheus serveriem, jo visi tie ir pieejami no vienas galapunkta.
Iepriekš, lai iegūtu global view Improbable, mēs organizējām savus Prometheus instancēm daudzlīmeņu . Tas nozīmēja vienas meta-Prometheus servera izveidi, kas apkopo daļu metriku no katra “lapu" servera.
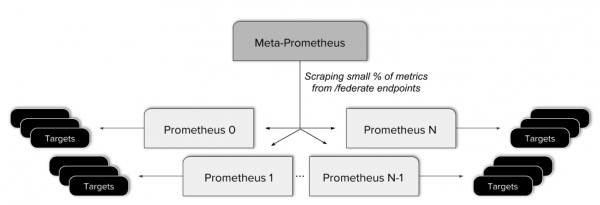
Šī pieeja izrādījās problemātiska. Tā radīja konfigurācijas sarežģījumus, pievienojot papildu potenciālo kļūmes punktu un pielietojot sarežģītus noteikumus, lai nodrošinātu federēto galapunktu tikai ar nepieciešamajiem datiem. Turklāt šāda veida federācija neļauj iegūt patiesu global view, jo ne visi dati ir pieejami no viena API pieprasījuma.
Ar to cieši saistīts vienots datu attēls, kas savākts augstas pieejamības (high-availability, HA) Prometheus serveros. HA Prometheus modelis neatkarīgi divreiz savāc datus, kas ir tik vienkārši, ka grūti iedomāties vienkāršāk. Tomēr izmantot apvienotu un de-duplikētu abi plūsmas attēlu būtu daudz ērtāk.
Protams, augstas pieejamības Prometheus serveros pastāv nepieciešamība. Improbable mēs tiešām nopietni pieejam datu uzraudzību ik minūti, taču vienas Prometheus instancē klasterī ir vienīgais kļūmes punkts. Jebkura konfigurācijas kļūda vai aparatūras bojājums var potenciāli novest pie svarīgu datu zuduma. Pat vienkārša izvietošana var izraisīt nelielus traucējumus metriku savākšanā, jo restartēšana var būt ievērojami ilgāka par skrāpēšanas intervālu.
Uzticama vēsturisko datu glabāšana
Lēts, ātrs un ilgtermiņa metriku uzglabāšanas risinājums ir mūsu sapnis, ko dalās vairums Prometheus lietotāju. Improbable mēs bijām spiesti iestatīt metriku uzglabāšanas termiņu uz deviņām dienām (Prometheus 1.8 versijai). Tas pievieno acīmredzamas robežas tam, cik tālu mēs varam skatīties atpakaļ.
Prometheus 2.0 šajā ziņā ir uzlabojies, jo laika sēriju skaits vairs neietekmē servera kopējo veiktspēju (skat. ). Neskatoties uz to, Prometheus uzglabā datus lokālajā diskā. Lai gan augstas efektivitātes datu saspiešana var ievērojami samazināt lokālā SSD izmantošanu, tomēr galu galā joprojām pastāv ierobežojumi uzglabājamās vēsturiskās informācijas apjomā.
Turklāt Improbable mēs rūpējamies par uzticamību, vienkāršību un izmaksām. Lieli lokālie diski ir sarežģītāki ekspluatācijā un dublēšanā. Tie maksā dārgāk un prasa vairāk rīku dublēšanai, kas noved pie liekas sarežģītības.
Samazināšana
Kad mēs sākām strādāt ar vēsturiskajiem datiem, sapratām, ka pastāv fundamentālas grūtības ar O-lielo, kas padara vaicājumus arvien lēnākus, ja mēs strādājam ar datiem nedēļām, mēnešiem un gadiem.
Standarta risinājums šai problēmai būs (downsampling) — signāla izlases frekvences samazināšana. Pateicoties samazināšanai, mēs varam "saskanēt" uz garāku laika periodu un saglabāt iepriekšējo izlases skaitu, kas ļaus saglabāt vaicājumu atbildes ātrumu.
Samazināšana veciem datiem ir neizbēgama prasība jebkuram ilgtermiņa uzglabāšanas risinājumam un pārsniedz parasto Prometheus.
Papildu mērķi
Viena no sākotnējām projekta Thanos mērķiem bija bezšuvju integrācija ar jebkurām esošajām Prometheus instalācijām. Otrais mērķis bija nodrošināt vienkāršu ekspluatāciju ar minimālu piekļuves slieksni. Jebkuras atkarības jābūt viegli apmierinātām gan mazajiem, gan lielajiem lietotājiem, kas nozīmē arī mazākas pamatizmaksas.
Thanos arhitektūra
Pēc tam, kad iepriekšējā sadaļā tika uzskaitīti mūsu mērķi, ļausimies tiem un apskatīsim, kā Thanos risina šīs problēmas.
Globālā skats
Lai iegūtu global view virs esošajiem Prometheus instancēm, mums ir jāsasaista vienota piekļuves punkts visām serveriem. To tieši dara Thanos komponents. . Tas tiek izvietots blakus katram Prometheus serverim un darbojas kā proksis, apkalpojot lokālos Prometheus datus caur gRPC interfeisu Store API, kas ļauj izgūt time series datus pēc atzīmēm un laika intervāla.
Savukārt ir horizontāli mērogojams Querier komponents bez stāvokļa saglabāšanas, kas dara nedaudz vairāk nekā vienkārši atbild uz PromQL pieprasījumiem caur standarta Prometheus HTTP API. Querier, Sidecar un citi Thanos komponenti savstarpēji sazinās pa .
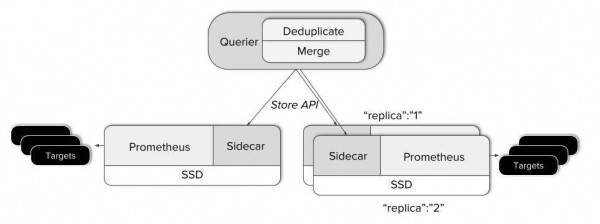
- Kad Querier saņem pieprasījumu, tas pieslēdzas atbilstošajam Store API serverim, t.i., mūsu Sidecar un iegūst time series datus no attiecīgajiem Prometheus serveriem.
- Pēc tam tas apvieno atbildes un izpilda uz tām PromQL pieprasījumu. Querier var apvienot gan nepārklājošos datus, gan dublētos datus no HA Prometheus serveriem.
Tas atrisina lielāko daļu mūsu mīklas — datu apvienošana no izolētiem Prometheus serveriem vienotā skatījumā. Faktiski Thanos var izmantot tikai šīs iespējas dēļ. Esošajos Prometheus serveros nav nepieciešams veikt nekādas izmaiņas!
Neierobežota uzglabāšanas termiņš!
Tomēr agri vai vēlu mēs vēlēsimies saglabāt datus, kas pārsniedz parasto Prometheus uzglabāšanas laiku. Vēsturisko datu glabāšanai mēs izvēlējāmies objektu glabātuvi. Tā ir plaši pieejama jebkurā mākoņvidē, kā arī lokālajos datu centros un ir ļoti izdevīga. Turklāt gandrīz jebkura objektu glabātuve ir pieejama caur labi pazīstamo S3 API.
Prometheus ieraksta datus no operatīvās atmiņas diskā aptuveni ik pēc divām stundām. Saglabāto datu bloks satur visus datus noteiktam laika intervalam un ir nemainīgs. Tas ir ļoti ērti, jo Thanos Sidecar var vienkārši skatīties Prometheus datu katalogu un, kad tiek pievienoti jauni bloki, augšupielādēt tos objektu glabātuvē.
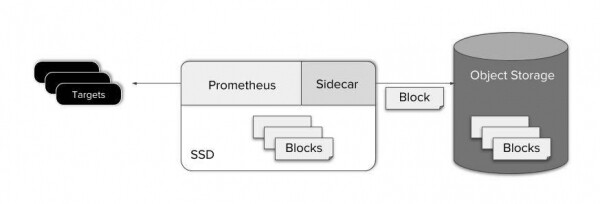
Augšupielāde objektu glabātuvē uzreiz pēc ierakstīšanas diskā arī ļauj saglabāt “scraper” (Prometheus un Thanos Sidecar) vienkāršību. Tas vienkāršo atbalstu, izmaksas un sistēmas dizainu.
Kā redzat, datu dublēšana tiek īstenota ļoti vienkārši. Bet kāds ir pieprasījums uz datiem objektu krātuvē?
Thanos Store komponents darbojas kā proksi datu iegūšanai no objektu krātuves. Tāpat kā Thanos Sidecar, tas piedalās gossip klasterī un īsteno Store API. Tādējādi esošie Querier var uzskatīt to par Sidecar, kā vēl vienu avotu laika sēriju datiem — nav nepieciešama īpaša konfigurācija.
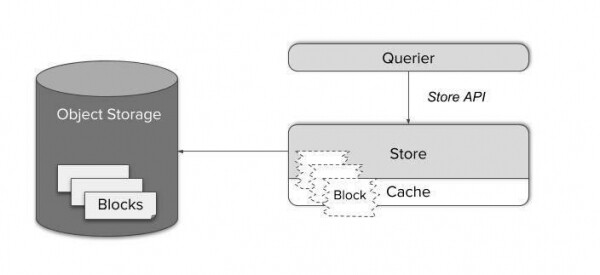
Laika sēriju datu bloki sastāv no vairākiem lieliem failiem. To ielāde pēc pieprasījuma būtu diezgan neefektīva, bet lokālā kešošana prasītu milzīgu atmiņu un diska vietu.
Tādēļ Store Gateway zina, kā strādāt ar Prometheus uzglabāšanas formātu. Pateicoties viedajam pieprasījumu plānotājam un kešošanai tikai nepieciešamajām indeksu daļām, ir izdevies samazināt sarežģītos pieprasījumus līdz minimālajam HTTP pieprasījumu skaitam uz objektu krātuves failiem. Tādējādi iespējams samazināt pieprasījumu skaitu par četriem līdz sešiem lielumiem un panākt reakcijas laikus, kurus kopumā grūti atšķirt no pieprasījumiem uz datiem lokālajā SSD.
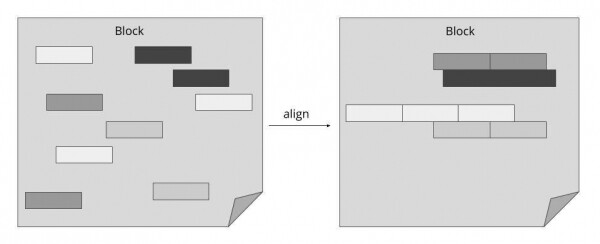
Kā redzams iepriekšējā diagrammā, Thanos Querier būtiski samazina izmaksas par katru pieprasījumu uz datiem objektu krātuvē, izmantojot Prometheus uzglabāšanas formātu un novietojot saistītos datus blakus. Izmantojot šo pieeju, mēs varam apvienot vairākus atsevišķus pieprasījumus minimālajā bulk operāciju skaitā.
Kompaktēšana un samazināšana
Pēc tam, kad jaunais laika sēriju datu bloks ir veiksmīgi augšupielādēts objektu krātuvē, mēs to uzskatām par "vēsturiskajiem" datiem, kuri nekavējoties kļūst pieejami caur Store Gateway.
Tomēr pēc kāda laika, blokiem no viena avota (Prometheus ar Sidecar) uzkrājoties, tie jau nesniedz visu indeksa potenciālu. Lai risinātu šo problēmu, mēs ieviesām vēl vienu komponentu, ko sauc par Compactor. Tas vienkārši piemēro vietējo Prometheus kompakti mehānismu vēsturiskajiem datiem objektu krātuvē un var tikt palaists kā vienkārša periodiska partiju uzdevums.
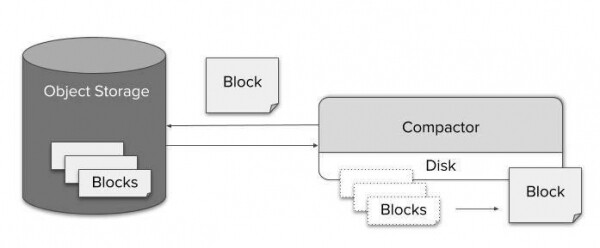
Efektīvas saspiešanas dēļ piekļuve glabāšanai ilgā laikā nerada problēmas datu apjoma ziņā. Tomēr potenciālās izmaksas, ko rada miljarda vērtību atpakotne un to pārlaišana caur vaicājumu apstrādātāju, neizbēgami novedīs pie ievērojama vaicājuma izpildes laika pieauguma. No otras puses, ņemot vērā, ka katram ekrāna pikselim ir simtiem datu punktu, praktiski nav iespējams vizualizēt datus pilnā izšķirtspējā. Tādējādi lejasparaugošana ir ne tikai iespējama, bet arī nebūs ievērojami samazinājusi precizitāti.
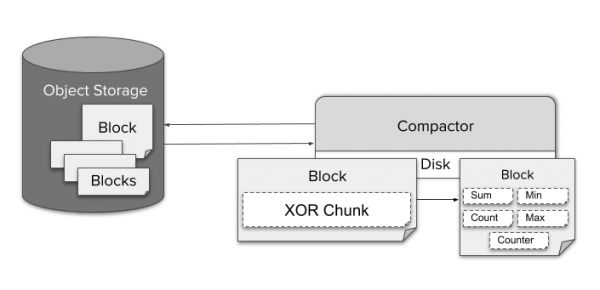
Datu lejasparaugošanai Compactor nepārtraukti agregē datus ar piecu minūšu un stundas izšķirtspēju. Katram neapstrādātajam fragmentam, kas kodēts, izmantojot TSDB XOR saspiešanu, tiek glabāti dažādi agregētu datu veidi, piemēram, min, max vai sum vienam blokam. Tas ļauj Querier automātiski izvēlēties agregātu, kas atbilst dotajam PromQL vaicājumam.
Lai izmantotu datus ar samazinātu precizitāti, lietotājam nav nepieciešama nekādas īpašas konfigurācijas. Querier automātiski pārvietojas starp dažādām izšķirtspējām un neapstrādātiem datiem, samazinoties un palielinoties mērogam. Ja vēlas, lietotājs var tieši pārvaldīt to caur parametru 'step' vaicājumā.
Tā kā uzglabāšanas izmaksas par vienu GB ir nelielas, pēc noklusējuma Thanos saglabā sākotnējos datus, datus ar piecu minūšu un stundas izšķirtspēju. Nav nepieciešams dzēst sākotnējos datus.
Reģistrēšanas noteikumi
Pat ar Thanos reģistrēšanas noteikumi ir nozīmīga uzraudzības steka sastāvdaļa. Tie samazina vaicājumu sarežģītību, aizturi un izmaksas. Tie arī ir ērti lietotājiem, lai iegūtu agregētus datus par metriku. Thanos balstās uz vaniļas Prometheus instancēm, tāpēc ir pilnīgi pieņemami uzglabāt reģistrēšanas un brīdināšanas noteikumus pastāvošajā Prometheus serverī. Tomēr dažos gadījumos tas var būt nepietiekami:
- Globālā brīdinājuma un noteikuma (piemēram, brīdinājums, kad pakalpojums nedarbojas vairāk nekā divos no trim klasteriem).
- Noteikums neizvietotajiem datiem.
- Tendence glabāt visus noteikumus un brīdinājumus vienā vietā.
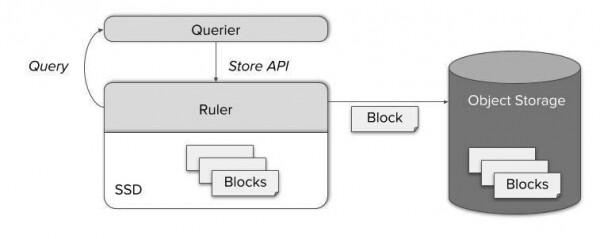
Visām šīm situācijām Thanos ietver atsevišķu komponentu, kas saucas Ruler, kurš aprēķina noteikumus un brīdinājumus, izmantojot Thanos Queries. Nodrošinot labi zināmo StoreAPI, Query mezgls var piekļūt svaigi aprēķinātām metriskajām vērtībām. Vēlāk tās tiek saglabātas objektu glabāšanā un kļūst pieejamas caur Store Gateway.
Thanos jauda
Thanos ir pietiekami elastīgs, lai to varētu pielāgot jūsu prasībām. Tas ir īpaši noderīgi migrējot no vienkārša Prometheus. Ļaujiet mums īsi atcerēties, ko esam uzzinājuši par Thanos komponentiem. Šeit ir, kā pārvērst jūsu vaniļas Prometheus uz „neierobežotas metrikas glabāšanas” pasauli:
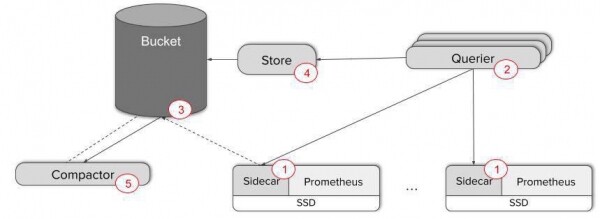
- Pievienojiet Thanos Sidecar saviem Prometheus serveriem — piemēram, blakus konteineru Kubernetes podā.
- Izvietojiet vairākas Thanos Querier repliku, lai skatītu datus. Šajā posmā ir viegli iestatīt gossip starp Scraper un Querier. Lai pārbaudītu komponentu mijiedarbību, izmantojiet metrikas ‘thanos_cluster_members’.
Tik vien šo divu soļu pietiek, lai nodrošinātu globālu skatu un nevainojamu datu deduplicēšanu no potenciālajām HA Prometheus replikām! Vienkārši pievienojiet savus paneļus HTTP Querier galapunktam vai izmantojiet Thanos UI saskarni tieši.
Tomēr, ja jums nepieciešama metrikas dublēšana un ilgtermiņa glabāšana, jums būs jāveic vēl trīs soļi:
- Izveidojiet AWS S3 vai GCS tvertni. Iestatiet Sidecar, lai datus kopētu šajās tvertnēs. Tagad varat minimizēt vietējo datu glabāšanu.
- Izvietojiet Store Gateway un pievienojiet to esošajam gossip-klasterim. Tagad varat sūtīt pieprasījumus uz datiem dublējumos!
- Izvietojiet Compactor, lai uzlabotu pieprasījumu efektivitāti ilgstošos laika periodos, izmantojot saspiesto un samazināto paraugu.
Ja vēlaties uzzināt vairāk, nevilcinieties, apskatiet mūsu un !
Tikai piecos soļos mēs pārvēršam Prometheus par uzticamu monitoringa sistēmu ar globālu skatu, neierobežotu glabāšanas laiku un potenciāli augstu pieejamību metrikām.
Pull request: mums jūs nepieciešami!
jau no paša sākuma bija atvērtā koda projekts. Nepārtraukta integrācija ar Prometheus un iespēja izmantot tikai daļu no Thanos padara to par lielisku izvēli monitoringa sistēmas paplašināšanai bez liekām pūlēm.
Mēs vienmēr priecājamies par GitHub Pull Request un Issues. Tajā pašā laikā, nevilcinieties sazināties ar mums caur Github Issues vai Slack., ja jums ir jautājumi vai atsauksmes, vai vēlaties dalīties ar savu pieredzi! Ja jums patīk tas, ko mēs darām Improbable, droši sazinieties ar mums — !
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish