

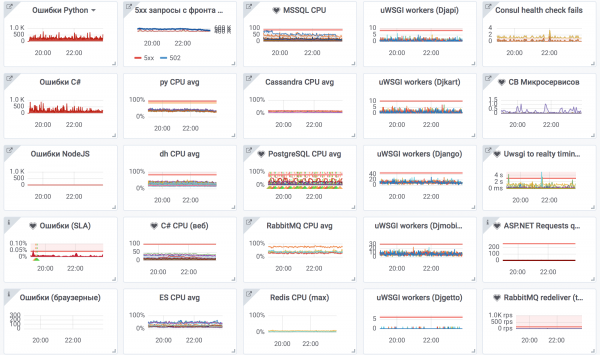
Visiem labu!
Mani sauc Nikita, esmu komandas inženieru līderis Cian. Viens no maniem pienākumiem uzņēmumā ir samazināt infrastruktūras incidentu skaitu līdz nullei.
To, par ko tiks runāts tālāk, ir radījis mums daudz sāpju, un šī raksta mērķis ir novērst citu cilvēku iespēju atkārtot mūsu kļūdas vai vismaz minimizēt to ietekmi.
Priekšvārds
Sen, kad Cian sastāvēja no monolītiem un nebija nekādu norāžu uz mikropakalpojumiem, mēs mērījām resursa pieejamību, pārbaudot 3–5 lapas.
Ja atbild, — viss ir labi, ja neatbild ilgāku laiku — brīdinājums. Cik ilgi lapām jābūt neaktīvām, lai to uzskatītu par incidentu, — lēma cilvēki sanāksmēs. Inženieru komanda vienmēr piedalījās incidenta izmeklēšanā. Kad izmeklēšana bija pabeigta, tika rakstīts postmortem — savdabīgs ziņojums pa e-pastu formātā: kas notika, cik ilgi tas ilga, ko darījām brīdī, ko darīsim nākotnē.
Galvenās vietnes lapas vai kā mēs saprotam, ka esam sasnieguši apakšu
Lai varētu saprast kļūdu prioritāti, mēs izdalījām vissvarīgākās biznesa funkcionalitātei kritiskās lapas. Mēs skaitām veiksmīgo/neveiksmīgo pieprasījumu un laika izbeigšanās skaitu. Tā mēs mēra uptime.
Pieņemsim, ka esam noskaidrojuši, ka ir virkne super svarīgu vietnes sadaļu, kas atbild par galveno pakalpojumu — sludinājumu meklēšanu un iesniegšanu. Ja kļūdu skaits pieprasījumos pārsniedz 1% — tas ir kritisks incidents. Ja pa 15 minūtēm aug peak laikā kļūdu procents pārsniedz 0,1% — tas tiek uzskatīts arī par kritisku incidentu. Šie kritēriji aptver lielāko daļu incidentu, pārējie iznāk ārpus šī raksta robežām.
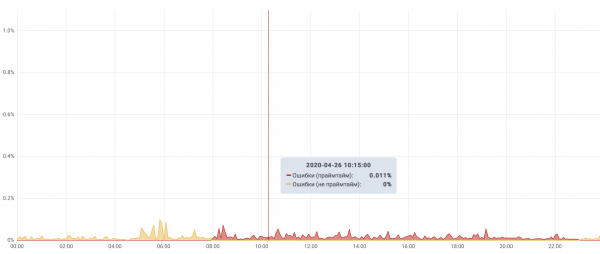
Top labākie incidenti Cian
Tātad, mēs noteikti esam iemācījušies identificēt faktu, ka incidents ir noticis.
Tagad katrs incidents mums ir detalizēti aprakstīts un atspoguļots Jira epikā. Starp citu, šim nolūkam mēs izveidojām atsevišķu projektu, nosaucām to par FAIL — tajā var izveidot tikai epikus.
Ja apkopotu visus neveiksmīgos incidentus pēdējo gadu laikā, tad vadošās pozīcijas ieņem:
- incidenti, kas saistīti ar mssql;
- incidenti, ko izraisījuši ārēji faktori;
- administratora kļūdas.
Pievērsīsimies detalizētāk administratoru kļūdām un dažiem citiem interesantiem neveiksmēm.
Piektā vieta — «Kārtojam DNS»
Tas bija slikts otrdienas rīts. Izmantojām iespēju sakārtot DNS klasteri.
Gribējās pārvērst iekšējos DNS serverus no bind uz powerdns, izveidojot pilnīgi atsevišķus serverus, kur vienīgā lieta ir DNS.
Mēs ievietojām pa vienam DNS serverim katrā no mūsu datu centriem, un pienāca brīdis pārvietot zonas no bind uz powerdns un pārorientēt infrastruktūru uz jaunajiem serveriem.
Pārvietošanas vidū no visiem serveriem, kas tika norādīti lokālajos kešējojošos bind-ī, palika tikai viens, kas atradās datu centrā Sanktpēterburgā. Šis Datu centrs sākotnēji bija deklarēts kā ne kritisks mums, bet pēkšņi kļuva par vienīgo kļūdas punktu.
Tieši šajā pārvietošanas periodā krita kanāls starp Maskavu un Sanktpēterburgu. Mēs faktiski palikām bez DNS piecas minūtes un atjaunojām to, kad mitinātājs tika novērsti traucējumi.
Secinājumi:
Ja agrāk mēs ignorējām ārējos faktorus darba sagatavošanas laikā, tad tagad tos arī iekļāvām sarakstā, uz ko gatavojamies. Tagad mēs cenšamies nodrošināt, ka visi komponenti ir rezervēti n-2, bet darba laikā varam pazemināt šo līmeni līdz n-1.
- Izstrādājot rīcības plānu, atzīmējiet punktus, kur serviss varētu sabrukt, un izstrādājiet scenārijus, kur viss notiek „sliktākajā gadījumā” iepriekš.
- Izvietojiet iekšējos DNS serverus dažādās ģeolokācijās/datu centros/skapjos/slēgtos tīklos.
- Katram serverim iestatiet vietējo kešējo DNS serveri, kas pāradresē pieprasījumus uz galvenajiem DNS serveriem, un gadījumā, ja tas nav pieejams, atbildēs no keša.
Ceturtā vieta — „Kārtība Nginx”
Vienā jaukā dienā mūsu komanda izlemj, ka „ir pienācis laiks beigt paciest”, un sākās nginx konfigurācijas pārfaktorizēšanas process. Galvenais mērķis ir pārveidot konfigurācijas uz intuitīvi saprotamu struktūru. Agrāk viss bija „vēsturiski izveidots” un nesaturēja nekādu loģiku. Tagad katrs server_name ir izvietots atsevišķā failā, un visas konfigurācijas ir sadalītas pa mapēm. Starp citu — konfigurācijā ir 253949 rindiņas vai 7836520 simbolu, un tā aizņem gandrīz 7 megabaitus. Augšējais struktūras līmenis:
Nginx struktūra
├── piekļuve
│   ├── allow.list
...
│   └── whitelist.conf
├── geobase
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── geodb
│   ├── GeoIP.dat
│   ├── GeoIP2-Country.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dynamic
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logics
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ru
│   │   ├── cian.ru.conf
│   │   ├── ...
│   │   └── my.cian.ru.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
Kļuva ievērojami labāk, bet pārdēvēšanas un konfigurāciju sadalīšanas procesā daļai no tām bija nepareizs paplašinājums un tās netika iekļautas direktīvā include *.conf. Rezultātā daļa hostu kļuva nepieejami un atgrieza 301 uz galveno lapu. Tā kā atbildes kods nebija 5xx/4xx, to nevarēja pamanīt uzreiz, bet tikai rīta stundās. Pēc tam mēs sākām rakstīt testus infrastruktūras komponentu pārbaudei.
Secinājumi:
- Pareizi strukturējiet konfigurācijas (ne tikai nginx) un izstrādājiet struktūru projekta agrīnā posmā. Tas padarīs tās saprotamākas komandai, kas savukārt samazinās TTM.
- Dažādiem infrastruktūras komponentiem rakstiet testus. Piemēram: pārbaudiet, vai visi svarīgie server_name atgriež pareizo statusu un atbildes saturu. Pietiks ar dažiem skriptiem, kas pārbauda galvenās komponentes funkcijas, lai trīcīgi neatcerētos 3 naktī, ko vēl jāpārbauda.
Trešā vieta — "Pēkšņi beidzās vieta Cassandra"
Dati pakāpeniski pieauga, un viss bija labi līdz brīdim, kad Cassandra klasterī sāka izgāzties lielo keyspace remonti, jo tie nevarēja izpildīt compaction.
Vienā neskaidrā dienā klasteris gandrīz pārvērtās par ķirbi, proti:
- klasterī palika aptuveni 20% no kopējās vietas;
- nav iespējams pilnībā pievienot mezglus, jo pēc mezgla pievienošanas nepāriet cleanup dēļ vietas trūkuma apgabalos;
- veiktspēja pakāpeniski samazinās, jo kompakcija nestrādā;
- klasteris darbojas avārijas režīmā.
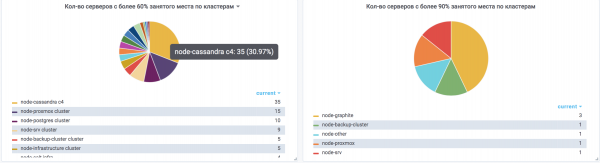
Izvade — pievienojām vēl 5 mezglus bez attīrīšanas, pēc tam sākām pakāpeniski izņemt no klastera un atkal iekļaut, kā tukšus mezglus, kurās beidzās vieta. Laika patēriņš bija krietni lielāks, nekā vēlētos. Pastāvēja risks daļējai vai pilnīgai klastera nepieejamībai.
Secinājumi:
- Visos serveros Cassandra nedrīkst būt aizņemti vairāk kā 60% vietas katrā nodalījumā.
- Tie jānoslogo ne vairāk kā 50% pēc CPU.
- Nepalaidiet garām kapacitātes plānošanu, un to ir jāizstrādā katram komponentam, ņemot vērā tā specifiku.
- Jo vairāk mezglu klasterī — jo labāk. Serveri, kas satur nelielu datu apjomu, ātrāk tiek pārsūtīti, un šāds klasteris ir vieglāk reanimējams.
Otrā vieta — "Dati izzuduši no consul key-value krātuves"
Mēs, tāpat kā daudzi, izmantojam consul pakalpojumu atklāšanai. Bet mūsu key-value tiek izmantots arī blue-green izvietošanai monolītā. Tur tiek glabāta informācija par aktīvajiem un neaktīvajiem augšējā plāno, kas mainās vietām izvietošanas procesa laikā. Šim nolūkam tika izveidots izvietošanas pakalpojums, kas mijiedarbojās ar KV. Kādā brīdī dati no KV izzuda. Atjaunojām tos pēc atmiņas, taču ar vairākām kļūdām. Rezultātā, veicot izvietošanu, slodze uz augšējiem plāniem tika sadalīta nevienmērīgi, un mēs saņēmām daudz 502 kļūdu, jo aizmugures serveri tika pārslogoti pēc CPU. Galu galā pārgājām no consul KV uz postgres, no kura tos vairs nav tik vienkārši izdzēst.
Secinājumi:
- Pakalpojumiem bez nekādas autorizācijas nedrīkst saturēt kritiskus datus, kas nepieciešami vietnes darbībai. Piemēram, ja jums nav autorizācijas ES — labāk būtu aizliegt piekļuvi tīkla līmenī no visur, kur tas nav nepieciešams, atstājt tikai nepieciešamos, kā arī izveidojiet action.destructive_requires_name: true.
- Iepriekš izstrādājiet rezerves kopēšanas un atjaunošanas mehānismu. Piemēram, izveidojiet skriptu (piemēram, uz python), kas spēj gan veikt rezerves kopēšanu, gan atjaunot.
Pirmā vieta — "Kapitāns neuzmanība"
Kādu brīdi mēs pamanījām nevienmērīgu slodzes sadalījumu uz nginx augšupplūdes gadījumos, kad aizmugurē bija 10+ serveri. Tā kā round-robin novirzīja pieprasījumus no 1. līdz pēdējam augšupplūdes kārtībā, un katra nginx atkārtota ielāde sākās no jauna, uz pirmajām augšupplūdēm vienmēr nāca vairāk pieprasījumu nekā uz pārējām. Rezultātā tās strādāja lēnāk, un viss tīmekļa vietne cieta. Tas kļuva arvien pamanāmāks pieaugot satiksmei. Vienkārši atjaunināt nginx, lai iekļautu random, nesanāca - bija jāpārstrādā liela daļa lua koda, kas nedarbojās versijā 1.15 (tajā laikā). Aizvien nācās ieviest patch mūsu nginx 1.14.2, šajā versijā iekļaujot random atbalstu. Tas atrisināja problēmu. Šī kļūda uzvar nominācijā
Secinājumi:
Bija ļoti interesanti un aizraujoši izpētīt šo kļūdu).
- Veidojiet monitoringu tā, lai tas palīdzētu ātri atrast līdzīgas svārstības. Piemēram, var izmantot ELK, lai uzraudzītu rps katram aizmugures katram augšupplūdei, sekojot viņu atbildes laikam no nginx skatpunkta. Šajā gadījumā tas mums palīdzēja atklāt problēmu.
Izvēloties rūpīgāku pieeju, varēja izvairīties no lielākās daļas neveiksmju. Jāatceras par Mērfija likumu: Anything that can go wrong will go wrong, un būvējot komponentes, vadoties pēc tā.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish