

Visticam visiem jau sen nav jautājuma, kāpēc nepieciešams vākt pakalpojumu metrikas. Nākamais loģiskais solis ir konfigurēt brīdinājumus par vāktajām metrikām, kas informēs par jebkādiem datu novirzījumiem ērtās jums kanālos (e-pasts, Slack, Telegram). Viesnīcu tiešsaistes rezervēšanas servisa visas mūsu pakalpojumu metrikas tiek sūtītas uz InfluxDB un attēlotas Grafana, tur arī ir konfigurēti pamata brīdinājumi. Uzdevumiem, piemēram, „jāaprēķina kaut kas un jāsalīdzina ar to”, mēs izmantojam Kapacitor.
Kapacitor ir daļa no TICK steka, kas spēj apstrādāt metrikas no InfluxDB. Tas var savienot vairākas dimensijas kopā (join), no iegūtajiem datiem aprēķināt kaut ko noderīgu, ierakstīt rezultātu atpakaļ InfluxDB, nosūtīt brīdinājumu uz Slack/Telegram/e-pastu.
Visam stekam ir lieliska un detalizēta , taču vienmēr atradīsies noderīgas lietas, kas skaidri nav norādītas rokasgrāmatās. Šajā rakstā es nolēmu apkopot vairākus šādus noderīgus, ne tik acīmredzamus padomus (pamatā TICKscipt sintakse aprakstīta ) un parādīt, kā tos var izmantot, pamatojoties uz vienu no mūsu uzdevumiem.
Aiziet!
float & int, aprēķinu kļūdas
Pilnīgi standarta problēma, ko atrisina caur kastēšanu:
var alert_float = 5.0
var alert_int = 10
data|eval(lambda: float("value") > alert_float OR float("value") < float("alert_int"))
default() izmantošana
Ja tag / lauks nav aizpildīts, rodas kļūdas aprēķinos:
|default()
        .tag('status', 'empty')
        .field('value', 0)
fill join (inner vs outer)
Pēc noklusējuma join noraidīs punktus, kur dati nav (inner).
Ja tiks izmantots fill(‘null’), tiks veikts outer join, pēc kura jāveic default() un jāaizpilda tukšie vērtības:
var data = res1
    |join(res2)
        .as('res1', 'res2)
        .fill('null')
    |default()
        .field('res1.value', 0.0)
        .field('res2.value', 100.0)
Šeit ir vēlviens nianses. Ja iepriekš minētajā piemērā kāds no sērijām (res1 vai res2) būs tukšs, gala sērija (data) arī būs tukša. Par šo tēmu ir vairāki biļetes GitHubā (, , ) – gaidām labojumus un mazliet ciešam.
Nosacījumu izmantošana aprēķinos (if lambda)
|eval(lambda: if("value" > 0, true, false)
Pēdējās piecas minūtes no cauruļvada periodā
Piemēram, jums jāsalīdzina pēdējo piecu minūšu vērtības ar iepriekšējo nedēļu. Var ņemt divas partijas datu divās atsevišķās partijās vai izvilkt daļu datu no lielāka perioda:
|where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u) < 5m)
Alternatīva pēdējām piecām minūtēm var būt BarrierNode izmantošana, kas pārtrauc datus pirms norādītā laika:
|barrier()
        .period(5m)
Go’šnie šablonu piemēri ziņojumā
Šabloni atbilst iepakojuma formātam , zemāk ir dažas bieži sastopamas uzdevumu piemēru.
if-else
Kārtību ieviešam, netrigerējot cilvēkus ar nevajadzīgu tekstu:
|alert()
    ...
    .message(
        '{{ if eq .Level "OK" }}Tagad viss ir kārtībā{{ else }}Šef, viss ir sabojājies{{end}}'
    )
Divas cipari pēc komata ziņojumā
Uzlabojam ziņojuma lasāmību:
|alert()
    ...
    .message(
        'tagad vērtība ir {{ index .Fields "value" | printf "%0.2f" }}'
    )
Mainīgo izplešanās ziņojumā
Pievienojam ziņojumā vairāk informācijas, lai atbildētu uz jautājumu «Kāpēc tas kliedz?»
var warnAlert = 10
  |alert()
    ...
    .message(
       'Šodien vērtība ir zemāk par '+string(warnAlert)+'%'
    )
Unikāls brīdinājuma identifikators
Noderīga lieta, kad datos ir vairāk nekā viena grupa, citādi tiks ģenerēts tikai viens brīdinājums:
|alert()
      ...
      .id('{{ index .Tags "myname" }}\/{{ index .Tags "myfield" }}')
Pielāgotie handler’ji
Lielajā handleru sarakstā ir exec, kas ļauj izpildīt jūsu skriptu ar nodotajiem parametriem (stdin) – tikai radošums!
Viens no mūsu pielāgojumiem ir neliels Python skripts, lai sūtītu paziņojumus uz Slack.
Vispirms vēlējāmies ziņojumā nosūtīt attēlu no Grafanas, kas aizsargāta ar autorizāciju. Pēc tam – rakstīt OK iepriekšējā brīdinājuma pavedienā no tās pašas grupas, nevis kā atsevišķu ziņojumu. Vēlāk – pievienot ziņojumam visbiežāk sastopamo kļūdu pēdējo X minūšu laikā.
Atsevišķa tēma ir saikne ar citiem pakalpojumiem un jebkuras darbības, ko iniciē brīdinājums (tikai ja jūsu uzraudzība darbojas pietiekami labi).
Handlera apraksta piemērs, kur slack_handler.py ir mūsu pašu rakstītais skripts:
topic: slack_graph
id: slack_graph.alert
match: level() != INFO AND changed() == TRUE
kind: exec
options:
  prog: \/sbin\/slack_handler.py
  args: ["-c", "CHANNELID", "--graph", "--search"]
Kā debuggot?
Variants ar ierakstu žurnālā
|log()
      .level("error")
      .prefix("something")
Skatīt (cli): kapacitor -url :9092 žurnāli lvl=error
Variants ar httpOut
Parāda datus pašreizējā caurulē:
|httpOut('something')
Skatīt (get): :9092\/kapacitor\/v1\/tasks\/task_name\/something
Izpildes shēma
- Katrs uzdevums atgriež izpildes koku ar noderīgiem skaitļiem formātā .
- Ņemam bloku .
- Ievietojam skatītājā, .
Kur vēl var iegūt timestamp InfluxDB, ierakstot sliktā secībā
timestamp infludb, ierakstot sliktā secībā
Piemēram, mēs iestatām brīdinājumu par pieprasījumu summu stundā (groupBy(1h)) un vēlamies saglabāt notikušo brīdinājumu infludb (lai skaisti parādītu problēmas esamību grafikā grafanā).
influxDBOut() ierakstīs timestamp vērtību no brīdinājuma, attiecīgi punkts grafikā tiks ierakstīts agrāk/vēlāk nekā ieradās brīdinājums.
Kad nepieciešama precizitāte: mēs šo problēmu risinām, izsaucot pielāgoto handler’i, kas ierakstīs datus infludb ar pašreizējo timestamp.
docker, būvniecība un izvietošana
Kapacitor palaišanas brīdī var ielādēt uzdevumus, šablonus un handlerus no direktorijas, kas noteikta konfigurācijā, blokā [load].
Lai pareizi izveidotu uzdevumu, ir nepieciešamas šādas lietas:
- Faila nosaukums – attiecīgi tiek izveidots kā id/nosaukums skriptam.
- Tips – stream/batch
- dbrp – atslēgvārds, lai norādītu, kura datu bāzē + politikā strādā skripts (dbrp "supplier"."autogen")
Ja kādā batch-uzdevumā nebūs rindiņas ar dbrp, viss serviss atteiksies strādāt un godīgi paziņos par to žurnālā.
Savukārt, chronograf’ā šai rindiņai nevajadzētu būt, caur saskarni tā netiek pieņemta un izmet kļūdu.
Haks, būvējot konteineru: Dockerfile noslēdzas ar -1, ja ir rindas ar //.+dbrp, kas ļaus uzreiz saprast būvniecības neizdošanās iemeslu.
join viens pret daudziem
Uzdevuma piemērs: nepieciešams ņemt 95. percentīli pakalpojuma darbības laika nedēļā, salīdzinot katru minūti no pēdējām 10 ar šo vērtību.
Nav iespējams veikt join viens pret daudziem, last/mean/median grupā punktu pārvērš mezglu par stream, atgriezīsies kļūda “cannot add child mismatched edges: batch -> stream”.
Batch rezultāts, kā mainīgais lambda izteiksmē, arī netiek iestatīts.
Ir iespēja saglabāt vajadzīgās skaitļus no pirmā batch failā caur udf un augšupielādēt šo failu caur sideload.
Ko mēs ar to risinājām?
Mums ir apmēram 100 viesnīcu piegādātāji, katram no tiem var būt vairāki savienojumi, ko sauksim par kanālu. Šo kanālu ir aptuveni 300, katrs kanāls var izkrist. Mēs uzraudzīsim kļūdu rādītājus (requests un errors) no visām ierakstītajām metriskajām datiem.
Kāpēc ne grafana?
Kļūdas brīdinājumi, kas iestatīti grafanā, ir ar vairākiem mīnusiem. Daži ir kritiski, uz dažiem var aizvērt acis, atkarībā no situācijas.
Grafana neprot veikt aprēķinus starp mērījumiem + brīdināšanas funkcijas, bet mums nepieciešams rādītājs (requests-errors)/requests.
Kļūdas izskatās draudīgi:
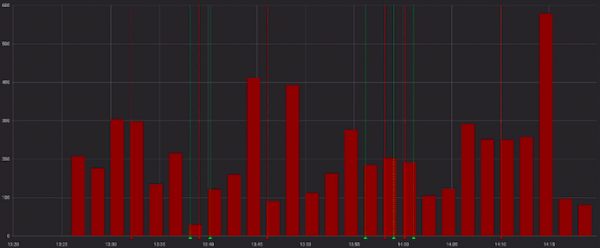
Un mazāk draudīgi, ja skatāmies kopā ar veiksmīgiem pieprasījumiem:
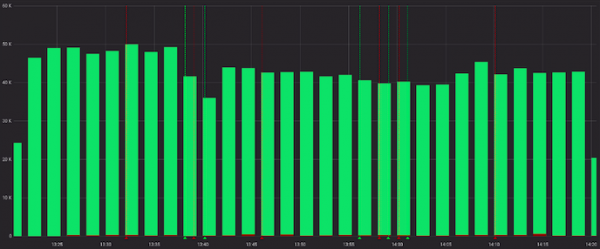
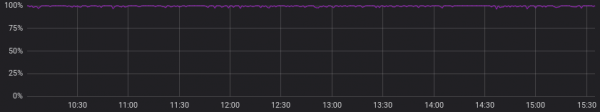
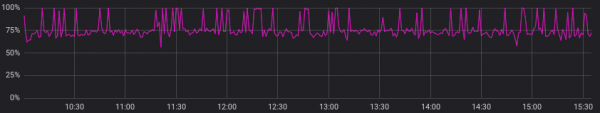
Labi, mēs varam iepriekš aprēķināt rādītāju pakalpojumā pirms Grafana, un dažos gadījumos tas būs piemērots. Bet ne mūsu gadījumā, jo katram kanālam tiek aprēķināta sava «normālā» attiecība, un brīdinājumi darbojas pēc statiskiem rādītājiem (meklējam ar acīm, mainām, ja bieži brīdina).
Tie ir «normāli» piemēri dažādiem kanāliem:
Noraidām iepriekšējo punktu un pieņemam, ka visiem piegādātājiem «normālā» aina ir līdzīga. Tagad viss ir labi, vai varam iztikt ar brīdinājumiem Grafana?
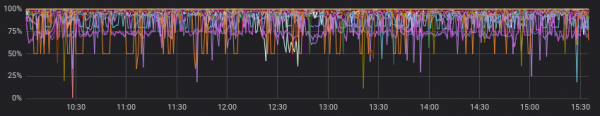
Varam, bet ļoti negribētos, jo jāizvēlas viens no variantiem:
a) izveidot daudzas grafikus katram kanālam atsevišķi (un mokoši tos apkalpot)
b) atstāt vienu grafiku visiem kanāliem (un pazaudēt krāsainajās līnijās un konfigurētajos brīdinājumos)
Kā izdarījām?
Atkal, dokumentācijā ir labs sākuma piemērs (), to var apskatīt vai izmantot kā pamatu līdzīgām problēmām.
Ko mēs izdarījām rezultātā:
- savienojām divas sērijas dažu stundu laikā, grupējot pēc kanāliem;
- aizpildām sērijas pēc grupām, ja datu nebija;
- salīdzinām pēdējo 10 minūšu mediānu ar iepriekšējiem datiem;
- kliedzam, ja kaut ko atklājām;
- pierakstām aprēķinātos rādītājus un notikušos brīdinājumus influxdb;
- sūtām noderīgu ziņojumu uz slack.
Manuprāt, mums izdevās maksimums no tā, ko vēlējāmies saņemt izejā (pat nedaudz vairāk ar pielāgotiem apstrādātājiem).
Github.com var apskatīt un saņemtā skripta.
Saņemtā koda piemērs:
dbrp "supplier"."autogen"
var name = 'requests.rate'
var grafana_dash = 'pczpmYZWU/mydashboard'
var grafana_panel = '26'
var period = 8h
var todayPeriod = 10m
var every = 1m
var warnAlert = 15
var warnReset = 5
var reqQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."requests"'
var errQuery = 'SELECT sum("count") AS value FROM "supplier"."autogen"."errors"'

var prevErr = batch
 |query(errQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var prevReq = batch
 |query(reqQuery)
 .period(period)
 .every(every)
 .groupBy(1m, 'channel', 'supplier')

var rates = prevReq
 |join(prevErr)
 .as('req', 'err')
 .tolerance(1m)
 .fill('null')
 // aizpildām vērtības ar nullēm, ja tās nebija
 |default()
 .field('err.value', 0.0)
 .field('req.value', 0.0)
 // ja iekš lambda: aprēķinām rādītāju tikai, ja bija kļūdas
 |eval(lambda: if("err.value" > 0, 100.0 * (float("req.value") - float("err.value")) / float("req.value"), 100.0))
 .as('rate')

// ierakstām aprēķinātās vērtības inflūksā
rates
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('rates')

// izvēlamies datus pēdējām 10 minūtēm, aprēķinam mediānu
var todayRate = rates
 |where(lambda: duration((unixNano(now()) - unixNano("time")) / 1000, 1u)  warnAlert)
 .warnReset(lambda: ("prev.median" - "today.median") < warnReset)
 .flapping(0.25, 0.5)
 .stateChangesOnly()
 // savācam ziņojumā saiti uz grafana paneļa diagrammu
 .message(
 '{{ .Level }}: {{ index .Tags "channel" }} err/req attiecība ({{ index .Tags "supplier" }})
{{ if eq .Level "OK" }}Tagad viss ir kārtībā{{ else }}
'+string(todayPeriod)+' mediāna ir {{ index .Fields "today.median" | printf "%0.2f" }}%, iepriekšējā '+string(period)+' ir {{ index .Fields "prev.median" | printf "%0.2f" }}%{{ end }}
http://grafana.ostrovok.in/d/'+string(grafana_dash)+'
?var-supplier={{ index .Tags "supplier" }}&var-channel={{ index .Tags "channel" }}&panelId='+string(grafana_panel)+'&fullscreen&tz=UTC0300'
 )
 .id('{{ index .Tags "name" }}\/{{ index .Tags "channel" }}')
 .levelTag('level')
 .messageField('message')
 .durationField('duration')
 .topic('slack_graph')

// "today.median" dubultojam kā "value", arī rakstām inflūksā pārējos alereta laukus (keep)
trigger
 |eval(lambda: "today.median")
 .as('value')
 .keep()
 |influxDBOut()
 .quiet()
 .create()
 .database('kapacitor')
 .retentionPolicy('autogen')
 .measurement('alerts')
 .tag('alertName', name)
Kāds ir iznākums?
Kapacitor lieliski spēj veikt monitoringu un trauksmi ar daudzām grupēšanām, veikt papildu aprēķinus pēc jau ierakstītajām metriķēm, izpildīt pielāgotas darbības un palaist skriptus (udf).
Ienākšanas slieksnis nav ļoti augsts – izmēģiniet to, ja Grafana vai citi rīki pilnībā nesniedz to, ko vēlaties.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish