

Neliels ievada vārds
Es uzskatu, ka mēs varētu paveikt daudz vairāk, ja mums tiktu sniegtas soli pa solim instrukcijas, kas pateiks, kas un kā jādara. Es pats atceros savas dzīves brīžus, kad nevarēju sākt kādu projektu, jo bija vienkārši grūti saprast, no kā sākt. Varbūt kādreiz senos laikos tu internetā redzēji vārdus "Data Science" un domāji, ka tas ir tālu no tevis, bet cilvēki, kas ar to nodarbojas, ir tepat, blakus. Un, iespējams, pateicoties cilvēkiem šajā nozarē, tev pēdējā laikā tika ieteikta šī raksts. Ir daudz kursu, kas palīdzēs tev apgūt šo amatu, un šeit es palīdzēšu tev spert pirmo soli.
Nu, vai tu esi gatavs? Uzreiz saku, ka tev būs jāzina Python 3, jo to es šeit lietošu. Iesaku iepriekš instalēt Jupyter Notebook vai noskatīties, kā izmantot Google Colab.
Pirmais solis
Kaggle ir tavs nozīmīgs palīgs šajā lietā. Principā var iztikt arī bez tā, bet par to es runāšu citā rakstā. Tas ir tāda platforma, kur norisinās Data Science sacensības. Katram šādam konkursam agrīnajos posmos tu iegūsi neticamu pieredzi dažādu uzdevumu risināšanā, izstrādē un komandā strādāšanā, kas mūsdienās ir svarīgi.
Mūsu uzdevums tiks ņemts no turienes. Tas tā saucas: "Titāniks". Nosacījums ir šāds: jāprognozē, vai izdzīvos katrs atsevišķs cilvēks. Vispārīgi runājot, cilvēka, kas nodarbojas ar DS, uzdevums ir datu vākšana, to apstrāde, modeļa apmācība, prognozēšana un tā tālāk. Kaggle mums ļauj izlaist datu vākšanas posmu — tie ir pieejami platformā. Mums ir jāielādē tie un varam sākt darbu!
To var izdarīt šādā veidā:
datņu cilnē Data ir faili, kuros ir dati


Ielādējām datus, sagatavojām mūsu Jupyter piezīmju grāmatiņas un…
Otrais solis
Kā mums tagad ielādēt šos datus?
Vispirms importējam nepieciešamās bibliotēkas:
import pandas as pd
import numpy as np
Pandas ļaus mums ielādēt .csv failus turpmākai apstrādei.
Numpy nepieciešams, lai attēlotu mūsu datu tabulu kā skaitļu matricu.
Turpinām. Paņemsim failu train.csv un ielādēsim to pie mums:
dataset = pd.read_csv('train.csv')
Mēs atsauksimies uz mūsu datu kopu train.csv caur mainīgo dataset. Apskatīsim, kas tur atrodas:
dataset.head()
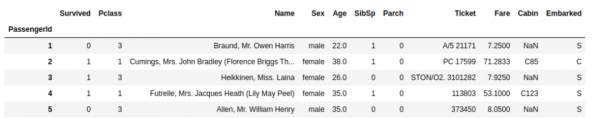
Funkcija head() ļauj mums apskatīt pirmās dažas rindas datu ietvarā.
Kolonna Survived ir tieši mūsu rezultāti, kas šajā datu ietvarā ir zināmi. Mūsu uzdevumā ir jāpārprot kolonna Survived datiem test.csv. Šajos datos ir informācija par citiem Titānika pasažieriem, kuru iznākumi mums, uzdevuma risinātājiem, nav zināmi.
Tātad, sadalīsim mūsu tabulu atkarīgajās un neatkarīgajās datu grupās. Šeit viss ir vienkārši. Atkarīgie dati ir tie, kas ir atkarīgi no neatkarīgiem, proti, tie, kas atrodas iznākumos. Neatkarīgie dati ir tie, kas ietekmē iznākumu.
Piemēram, mums ir šāds datu kopums:
«Vova mācījās informātiku — nē.
Vova saņēma 2 par informātiku.»
Vērtējums par informātiku ir atkarīgs no atbildes uz jautājumu: vai Vova mācījās informātiku? Skaidrs? Virzāmies tālāk, mēs jau tuvu mērķim!
Tradicionālais mainīgais neatkarīgajiem datiem ir X. Atkarīgajiem — y.
Veicam sekojošo:
X = dataset.iloc[ : , 2 : ]
y = dataset.iloc[ : , 1 : 2 ]
Kas tas ir? Ar funkciju iloc[:, 2: ] mēs sakām Pythonam: vēlos redzēt mainīgajā X datus, sākot no otrā kolonnas (ieskaitot, ja saskaitām no nulles). Otrajā rindā sakām, ka vēlamies redzēt y datus pirmajā kolonnā.
[ a:b, c:d ] — šī ir konstrukcija, kuru mēs izmantojam iekavās. Ja neliekam kādas mainīgās, tās tiks saglabātas noklusējuma. Tātad mēs varam norādīt [:,: d] un tad mēs iegūsim datu ietvarā visus kolonnas, izņemot tās, kas sākas no d numura un tālāk. Mainīgie a un b nosaka rindas, bet tās mums visas ir nepieciešamas, tādēļ atstāsim to noklusēto.
Apskatīsim, ko mēs ieguvām:
X.head() 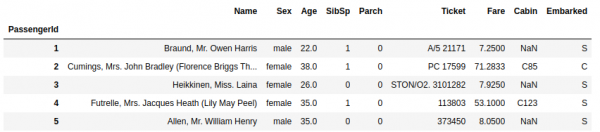
y.head() 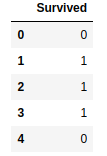
Lai atvieglotu šo nelielo mācību, mēs izdzēsīsim kolonnas, kurām nepieciešama īpaša «apkope», vai tās vispār neietekmē izdzīvošanu. Tajās ir dati, kas ir tipa str.
count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X.drop(count, inplace=True, axis=1)
Super! Dodamies uz nākamo soli.
Trešais solis
Šeit mums būs jākodē mūsu dati, lai mašīna labāk izprastu, kā šie dati ietekmē rezultātu. Bet kodēsim ne visus, bet tikai datus, kas ir tipa str, kurus atstājām. Kolonna "Sex". Kā mēs vēlamies kodēt? Iedomāsimies, ka personas dzimuma dati ir attēloti vektorā: 10 — vīrišķais dzimums, 01 — sievišķais dzimums.
Vispirms mūsu tabulas pārvērtīsim par NumPy matricu:
X = np.array(X)
y = np.array(y)
Un tagad paskatīsimies:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X = np.array(ct.fit_transform(X))
Bibliotēka sklearn ir tiešām lieliska bibliotēka, kas ļauj mums veikt visu darbu Data Science. Tajā ir liels skaits interesantu mašīnmācīšanās modeļu, kā arī tā ļauj mums nodarboties ar datu sagatavošanu.
OneHotEncoder ļaus mums kodēt personas dzimumu tādā attēlojumā, kā mēs to aprakstījām. Tiks radīti 2 klasifikatori: vīrišķais, sievišķais. Ja persona ir vīrietis, tad kolonnā "vīrišķais" tiks ierakstīta 1, bet "sievišķais" attiecīgi - 0.
Pēc OneHotEncoder() ir [1] — tas nozīmē, ka vēlamies kodēt kolonnas numuru 1 (skaitīšana sākas no nulles).
Super. Turpinām vēl tālāk!
Parasti gadās, ka daži dati paliek neizpildīti (t.i., NaN — not a number). Piemēram, ir informācija par personu: viņa vārds, dzimums. Bet nav datu par viņa vecumu. Šādā gadījumā pielietosim šādu metodi: atradīsim aritmētisko vidējo visās kolonnās un, ja kādi dati kādā kolonnā ir iztrūkuši, tad aizpildīsim tukšumu ar aritmētisko vidējo.
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X)
X = imputer.transform(X)
Un tagad ņemsim vērā, ka var būt situācijas, kad dati ir ļoti plaši izkliedēti. Daži dati atrodas intervālā [0:1], bet citi var pārsniegt simtus un tūkstošus. Lai izslēgtu šādu izkliedi un dators būtu precīzāks aprēķinos, mēs skalēsim datus, normalizēsim. Rādīsim, lai visi skaitļi nepārsniedz trīs. Tam izmantosim funkciju StandartScaler.
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X[:, 2:] = sc.fit_transform(X[:, 2:])
Tagad mūsu dati izskatās tā:

Klase. Mēs jau esam tuvu mūsu mērķim!
Ceturtā darbība
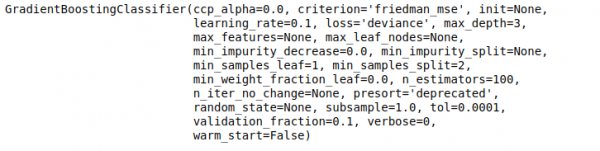
Apmācīsim mūsu pirmo modeli! No sklearn bibliotēkas mēs varam atrast daudzas interesantas lietas. Es piemēroju šai uzdevumam Gradient Boosting Classifier modeli. Mēs izmantojam klasifikatoru, jo mūsu uzdevums ir klasifikācijas uzdevums. Mums jāprognozē, vai jāpiešķir 1 (izdzīvojis) vai 0 (neizdzīvojis).
from sklearn.ensemble import GradientBoostingClassifier
gbc = GradientBoostingClassifier(learning_rate=0.5, max_depth=5, n_estimators=150)
gbc.fit(X, y)
Fit funkcija saka pythonam: ļauj modelim meklēt sakarības starp X un y.
Mazāk nekā sekundes laikā modelis ir gatavs.
Kā to izmantot? Tagad redzēsim!
Piektais solis. Secinājumi
Tagad mums jāielādē tabula ar mūsu testdatiem, kuriem jāveic prognoze. Ar šo tabulu mēs veiksim visus tos pašus soļus, ko veicām ar X.
X_test = pd.read_csv('test.csv', index_col=0)

skaitīt = ['Name', 'Ticket', 'Cabin', 'Embarked']
X_test.drop(skaitīt, inplace=True, axis=1)

X_test = np.array(X_test)

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X_test = np.array(ct.fit_transform(X_test))

from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X_test)
X_test = imputer.transform(X_test)

from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X_test[:, 2:] = sc.fit_transform(X_test[:, 2:])
Piemērosim jau mūsu modeli!
gbc_predict = gbc.predict(X_test)
Viss. Mēs esam izveidojuši prognozi. Tagad tā jāieraksta csv un jānosūta uz vietni.
np.savetxt('my_gbc_predict.csv', gbc_predict, delimiter=",", header = 'Survived')
Gatavs. Iegūts fails, kas satur prognozes katram pasažierim. Atliek tikai augšupielādēt šīs atbildes vietnē un saņemt prognozes novērtējumu. Šāds primitīvs risinājums sniedz ne tikai 74% pareizu atbilžu publiskajā telpā, bet arī noteiktu grūdienu Data Science jomā. Visinteresantākie var jebkurā laikā uzrakstīt man privātās ziņās un uzdot jautājumu. Paldies visiem!
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish