

Sveiki, Habr!
Saistībā ar pašreizējiem notikumiem, kas saistīti ar koronavīrusu, vairāki interneta pakalpojumi ir saņēmuši palielinātu slodzi. Piemēram, , jo jaudu nepietika. Un ne vienmēr ir iespējams paātrināt serveri, vienkārši pievienojot jaudīgāku aparatūru, tomēr klientu pieprasījumi ir jāapstrādā (vai tie aizies pie konkurentiem).
Šajā rakstā es īsi pastāstīšu par populārām praksēm, kuras ļaus izveidot ātru un noturīgu pakalpojumu. Tomēr no iespējamajām izstrādes shēmām es izvēlējos tikai tās, ar kurām šobrīd ir viegli izmantot.Katram punktam jums vai nu ir jau gatavas bibliotēkas, vai iespēja atrisināt uzdevumu, izmantojot mākoņa platformu.
Horizontālā mērogošana
Visvienkāršākais un visiem zināms punkts. Nosacīti visbiežāk sastopamas divas slodzes sadales shēmas — horizontālā un vertikālā mērogošana. jūs ļaujat pakalpojumiem darboties paralēli, tādējādi sadalot slodzi starp tiem. jūs pasūtāt jaudīgākus serverus vai optimizējat kodu.
Piemēram, es paņemšu abstraktu mākoņu failu glabāšanu, tātad noteiktu OwnCloud, OneDrive u.c. analogu.
Standarta attēls šādas shēmas apakšā ir norādīts zemāk, tomēr tas tikai demonstrē sistēmas sarežģītību. Galu galā mums ir nepieciešams kādā veidā sinhronizēt pakalpojumus. Kas notiks, ja no planšetdatora lietotājs saglabās failu, bet pēc tam vēlas to apskatīt ar telefonu?
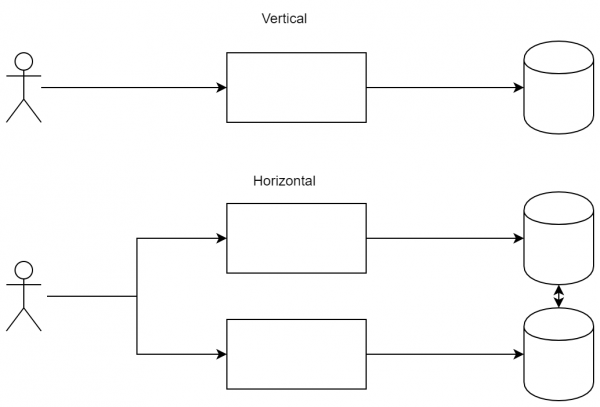
Atšķirība starp pieejām: vertikālajā mērogošanā mēs esam gatavi palielināt mezglu jaudu, bet horizontālajā — pievienot jaunus mezglus, lai sadalītu slodzi.
CQRS
ir diezgan svarīga shēma, jo tā ļauj dažādiem klientiem ne tikai pieslēgties dažādiem pakalpojumiem, bet arī saņemt vienādus notikumu plūsmas. Tās priekšrocības nav tik acīmredzamas vienkāršai lietojumprogrammai, tomēr tās ir ārkārtīgi svarīgas (un vienkāršas) slodzes pakalpojumam. Tās būtība: ienākošajām un izejošajām datu plūsmām nedrīkst krustoties. Proti, jūs nevarat nosūtīt pieprasījumu un gaidīt atbildi, vietā tam jūs nosūtāt pieprasījumu pakalpojumā A, tomēr saņemat atbildi pakalpojumā B.
Šī pieejas pirmā priekšrocība ir iespēja pārtraukt savienojumu (plašā nozīmē) ilga pieprasījuma izpildes laikā. Apskatīsim vairāk vai mazāk standarta secību:
- Klients nosūtīja pieprasījumu uz serveri.
- Serveris uzsāka garu apstrādi.
- Serveris atbildēja klientam ar rezultātu.
Iedomāsimies, ka 2. punktā notika savienojuma pārtraukums (vai nu tīkls pārslēdzās, vai lietotājs pārgāja uz citu lapu, pārtraucot savienojumu). Šajā gadījumā serverim būs grūti nosūtīt atbildi lietotājam ar informāciju par to, kas tieši tika apstrādāts. Izmantojot CQRS, secība būs nedaudz atšķirīga:
- Klients pierakstījās uz atjauninājumiem.
- Klients nosūtīja pieprasījumu uz serveri.
- Serveris atbildēja: "pieprasījums pieņemts".
- Serveris atbildēja ar rezultātu caur kanālu no punkta "1".
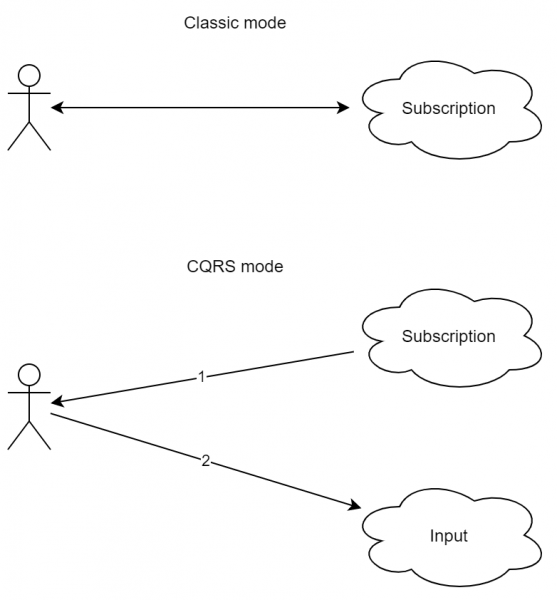
Kā redzams, shēma ir nedaudz sarežģītāka. Vairāk nekā tam, intuitīvā pieeja pieprasījums-atbilde šeit nav klātesoša. Tomēr kā redzams, savienojuma pārtraukums pieprasījuma apstrādes laikā nenovedīs pie kļūdas. Turklāt, ja lietotājs patiešām ir savienots ar pakalpojumu no vairākiem ierīcēm (piemēram, no mobilā telefona un planšetes), ir iespējams panākt, ka atbilde tiek saņemta uz abām ierīcēm.
Interesanti, ka ienākošo ziņojumu apstrādes kods kļūst līdzīgs (ne uz 100%) gan tiem notikumiem, uz kuriem ietekmēja pats klients, gan citiem notikumiem, tostarp no citiem klientiem.
Tomēr realitātē mēs iegūstam papildu priekšrocības, jo vienvirziena plūsmu var apstrādāt funkcionālajā stilā (izmantojot RX un analogus). Un tas ir nopietns pluss, jo būtībā lietojumprogrammu var izveidot pilnīgi reaktīvu, izmantojot vēl funkcionālo pieeju. Lieliem projektiem tas var būtiski ietaupīt resursus izstrādē un atbalstā.
Ja apvieno šo pieeju ar horizontālu mērogojamību, tad bonusā mēs iegūstam iespēju nosūtīt pieprasījumus uz vienu serveri, bet saņemt atbildes no cita. Tādējādi klients var pats izvēlēties sev ērtu pakalpojumu, bet sistēma iekšpusē tomēr spēs pareizi apstrādāt notikumus.
Notikumu avotu
Kā jūs zināt, viena no galvenajām izplatīto sistēmu īpašībām ir kopīga laika un kopīgas kritiskās sekcijas trūkums. Vienam procesam varat veikt sinhronizāciju (uz to pašu mutex), iekšā kurā esat pārliecināts, ka neviens cits neizpilda šo kodu. Tomēr izplatītai sistēmai tas ir bīstami, jo tam būs nepieciešami papildu izdevumi, kā arī tiks zaudēta visa mērogošanas pievilcība — tomēr visi komponenti gaidīs vienu.
No tā iegūstam svarīgu faktu — ātru izplatītu sistēmu nevar sinhronizēt, jo tad mēs samazināsim veiktspēju. No otras puses, bieži vien mums nepieciešama noteikta komponentu saskaņotība. Un tam var izmantot pieeju ar , kur tiek garantēts, ka datos neizmaiņu gadījumā pēc kāda laika pēc pēdējās atjaunināšanas (“galu galā”) visas pieprasījumi atgriezīs pēdējo atjaunināto vērtību.
Ir svarīgi saprast, ka klasiskām datu bāzēm bieži tiek izmantota , kur katram mezglam ir vienāda informācija (šādu parasti sasniedz, ja darījums tiek uzskatīts par izveidotu tikai pēc otrā servera atbildes). Šeit ir daži atvieglojumi dēļ izolācijas līmeņiem, tomēr kopējā būtība paliek nemainīga — jūs varat dzīvot pilnīgi saskaņotā pasaulē.
Tomēr atgriezīsimies pie sākotnējās uzdevuma. Ja daļa sistēmas var tikt uzbūvēta ar , tad var uzbūvēt nākamo shēmu.
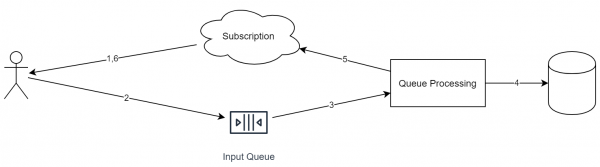
Svarīgas šī pieejas iezīmes:
- Katrs ienākošais pieprasījums tiek ievietots vienā rindā.
- Apmeklējot pieprasījumu, pakalpojums var arī ievietot uzdevumus citās rindās.
- Katram ienākošajam notikumam ir identifikators (kas nepieciešams dublikātu noņemšanai).
- Rinda ideoloģiski darbojas pēc “append only” shēmas. No tās nevar izdzēst elementus vai pārvietot tos.
- Rinda darbojas pēc FIFO shēmas (atvainojiet par tautoloģiju). Ja nepieciešams veikt paralēlu izpildi, tad jāveic objekti citās rindās vienā no posmiem.
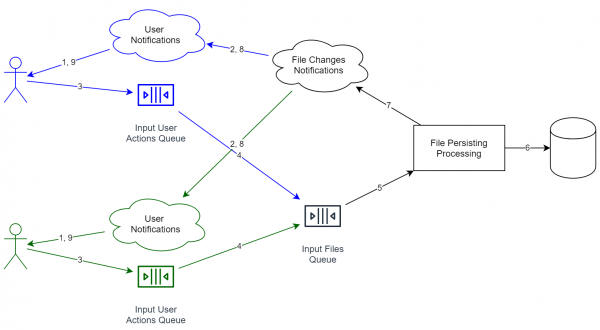
Atgādinu, ka mēs izskatām tiešsaistes failu glabāšanas gadījumu. Šādā gadījumā sistēma izskatīsies apmēram tā:
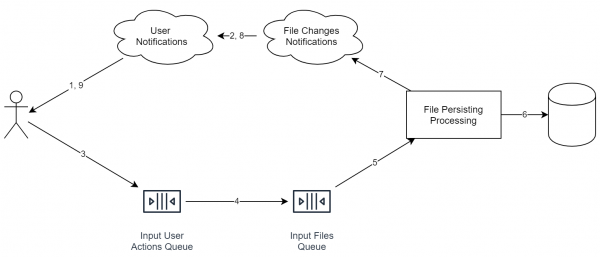
Ir svarīgi, ka diagrammā redzamie pakalpojumi ne vienmēr apzīmē atsevišķu serveri. Pat process var būt viens un tas pats. Svarīgāks ir cits jautājums: ideoloģiski šīs lietas ir sadalītas tā, lai būtu viegli pielietot horizontālo mērogošanu.
Un diviem lietotājiem shēma izskatīsies šādi (pakalpojumi, kas paredzēti dažādiem lietotājiem, ir apzīmēti ar dažādām krāsām):
Bonusi no tādas kombinācijas:
- Informācijas apstrādes pakalpojumi ir sadalīti. Rindas arī ir sadalītas. Ja mums nepieciešams palielināt sistēmas caurlaidspēju, mums tikai jāpalaiž vairāk pakalpojumu uz lielāka skaita serveriem.
- Kad mēs saņemam informāciju no lietotāja, mums nav obligāti jāgaida pilnīga datu saglabāšana. Gluži pretēji, mums ir pietiekami atbildēt "labi", un pēc tam pakāpeniski uzsākt darbu. Rinda tādējādi izlīdzina pēkšņas pieauguma, jo jauna objekta pievienošana notiek ātri, un lietotājam nav jāgaida, lai nostātos pie visa cikla.
- Piemēram, es pievienoju datu deduplication pakalpojumu, kas cenšas apvienot vienādus failus. Ja tas ilgstoši darbojas 1% gadījumu, klients to praktiski nenovēros (skat. iepriekš), kas ir liels plus, jo mēs vairs neprasām simtprocentīgu ātrumu un uzticamību.
Tomēr tūlīt ir redzami arī trūkumi:
- Mūsu sistēmā ir zudusi stingra konsekvence. Tas nozīmē, ka, piemēram, piesakoties dažādiem pakalpojumiem, teorētiski var iznākt atšķirīgs stāvoklis (jo viens no pakalpojumiem var nesagaidīt paziņojumu no iekšējās rindas). Kā vēl viena sekas, sistēmā vairs nav kopīga laika. Tātad, piemēram, nevar vienkārši sakārtot visus notikumus pēc to ierašanās laika, jo starp serveriem pulksteņi var nebūt sinhronizēti (turklāt, identisks laiks diviem serveriem ir utopija).
- Nav iespējams vienkārši atgriezt iepriekšējos notikumus (kā to varētu izdarīt ar datu bāzi). Tā vietā ir nepieciešams pievienot jaunu notikumu — , kas mainīs pēdējo stāvokli uz nepieciešamo. Kā piemērs no līdzīgas jomas: bez vēstures pārrakstīšanas (kas dažos gadījumos ir slikti) git nevar atgriezt komanda, tomēr var veikt īpašu , kas patiesībā vienkārši atgriezīs veco stāvokli. Tomēr vēsturē paliks gan kļūdains komits, gan rollback.
- Datu shēma var mainīties no izlaiduma līdz izlaidumam, taču vecos notikumus vairs nevar atjaunināt uz jauno standartu (jo notikumus būtībā nevar mainīt).
Kā redzams, Event Sourcing lieliski sader ar CQRS. Turklāt izveidot sistēmu ar efektīvām un ērtām rindām, bet bez datu plūsmu dalīšanas, jau pašā būtībā ir grūti, jo būs jāpievieno sinhronizācijas punkti, kas iznīcinās visu pozitīvo efektu no rindām. Lietojot abus pieejas vienlaicīgi, nepieciešams nedaudz koriģēt programmas darba kodu. Mūsu gadījumā, nosūtot failu uz serveri, atbildē saņemam tikai "ok", kas nozīmē tikai to, ka "faila pievienošanas operācija ir saglabāta". Formāli tas nenozīmē, ka dati jau ir pieejami citās ierīcēs (piemēram, deduplicēšanas pakalpojums var pārveidot indeksu). Tomēr pēc kāda laika klients saņems paziņojumu stilā "failu X ir saglabāts".
Kā rezultātā:
- Fails sūtot statusu skaits pieaug: vietā klasiskā "fails nosūtīts" mēs saņemam divus: "fails pievienots rindā serverī" un "fails saglabāts glabātuvē". Pēdējais nozīmē, ka citas ierīces jau var sākt saņemt failu (ņemot vērā, ka rindas darbojas ar atšķirīgu ātrumu).
- Ņemot vērā, ka informācija par nosūtīšanu tagad nāk pa dažādiem kanāliem, mums ir nepieciešams izstrādāt risinājumus, lai saņemtu faila apstrādes statusu. Kā rezultāts: atšķirībā no klasiskā request-response, klients var tikt restartēts faila apstrādes laikā, tomēr šīs apstrādes statuss būs pareizs. Un šis punkts darbojas būtībā automātiski. Tādējādi: mēs tagad esam tolerantāki pret kļūdām.
Sharding
Kā jau minēts iepriekš, sistēmās ar notikumu avotu stingra saskaņotība neeksistē. Tas nozīmē, ka mēs varam izmantot vairākus glabāšanas veidus bez jebkādas sinhronizācijas starp tiem. Tuvojoties mūsu uzdevumam, mēs varam:
- Sadalīt failus pēc veidiem. Piemēram, attēlus/video var dekodēt un izvēlēties efektīvāku formātu.
- Dalīt kontus pa valstīm. Ņemot vērā daudzas likumdošanas prasības, šāda iespēja var būt nepieciešama, taču šī arhitektūras shēma nodrošina automātisku šādus risinājumus.
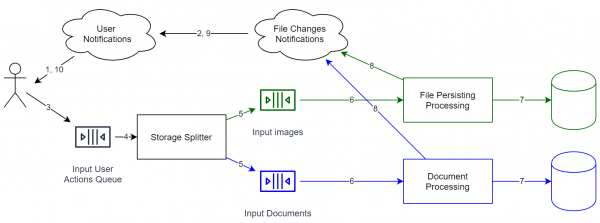
Ja vēlaties pārvietot datus no viena krātuves uz citu, tad šeit pēc noklusējuma nestrādās standarta metodes. Diemžēl šajā gadījumā ir nepieciešams apturēt rindu, veikt migrāciju un pēc tam to atsākt. Parasti datus nav iespējams pārvietot 'uz lido', taču, ja notikumu rinda tiek pilnībā saglabāta un jums ir iepriekšējo stāvokļu kopijas, tad mēs varam pārspēlēt notikumus šādā veidā:
- Katram notikumam Event Source ir savu identifikatoru (ideālā gadījumā — ne samazinošu). Tādējādi krātuvē varam pievienot lauku — pēdējā apstrādātā elementa id.
- Dublējam rindu, lai visi notikumi varētu tikt apstrādāti vairākiem neatkarīgiem krātuves veidiem (pirmais — tas, kur jau šobrīd tiek glabāti dati, bet otrais — jauns, kas šobrīd ir tukšs). Otrā rinda, protams, šobrīd netiek apstrādāta.
- Sākam otro rindu (t.i., sākam pārspēlēt notikumus).
- Kad jaunā rinda būs salīdzinoši tukša (t.i., vidējā laika atšķirība starp elementa pievienošanu un tā izvilkšanu būs pieņemama), var sākt pārslēgt lasītājus uz jauno krātuvi.
Kā redzams, mūsu sistēmā nekad nav bijusi stingra saskaņotība. Ir tikai beigu saskaņotība, t.i., garantija, ka notikumi tiek apstrādāti tajā pašā secībā (taču ar dažādu aizturi). Izmantojot to, mēs salīdzinoši viegli varam pārvietot datus bez sistēmas apstāšanās uz otras pasaules pusi.
Tādējādi, turpinot mūsu piemēru par tiešsaistes krātuvi failiem, šāda arhitektūra jau piedāvā mums vairākus ieguvumus:
- Mēs varam pārvietot objektus tuvāk lietotājiem, un tādējādi dinamiski uzlabot servisa kvalitāti.
- Mēs varam glabāt daļu datu iekšējās kompānijās. Piemēram, Enterprise lietotāji bieži pieprasa, lai viņu dati tiktu glabāti kontrolētos datu centros (lai izvairītos no datu noplūdēm). Pateicoties sharding, mēs varam viegli atbalstīt šo prasību. Uzdevums vēl vairāk vienkāršojas, ja pasūtītājam ir saderīga mākoņa infrastruktūra (piemēram, ).
- Un svarīgākais ir tas, ka mums to nevajag darīt. Sākumā mums pilnībā pietiktu ar vienu krātuvi visiem kontiem (lai ātrāk sāktu strādāt). Un šīs sistēmas galvenā iezīme ir tā, ka, lai gan tā ir paplašināma, sākotnējā posmā tā ir pietiekami vienkārša. Vienkārši nav nepieciešams uzreiz rakstīt kodu, kas darbojas ar miljonu atsevišķu neatkarīgu rindām utt. Ja būs nepieciešams, to var izdarīt nākotnē.
Statiskā satura mitināšana
Šis punkts var šķist pavisam acīmredzams, tomēr tas ir nepieciešams vismaz puslīdz standartizētai noslogotai lietojumprogrammai. Tās būtība ir vienkārša: viss statiskais saturs tiek piegādāts ne no tā paša servera, kur atrodas lietojumprogramma, bet no īpašiem serveriem, kas speciāli paredzēti šim nolūkam. Tādējādi šie darbi tiek veikti ātrāk (nosacīts nginx piegādā failus ātrāk un lētāk nekā Java serveris). Plus, CDN arhitektūra () ļauj izvietot mūsu failus tuvāk galalietotājiem, kas pozitīvi ietekmē pakalpojuma lietošanas ērtumu.
Vienkāršākais un standartizētākais statiskā satura piemērs ir skriptu un attēlu kopums vietnei. Ar tiem viss ir vienkārši — tie tiek iepriekš zināmi, tad arhīvs tiek augšupielādēts uz CDN serveriem, no kuriem tas tiek piegādāts galalietotājiem.
Tomēr praksē statiskajam saturam var piemērot pieeju, kas ir līdzīga lambda arhitektūrai. Atgriežamies pie mūsu uzdevuma (interneta failu krātuve), kur mums nepieciešams piegādāt failus lietotājiem. Vienkāršākais risinājums ir izveidot pakalpojumu, kas katram lietotāja pieprasījumam veic visas nepieciešamās pārbaudes (autorizācija u.t.t.), un pēc tam lejupielādē failu tieši no mūsu krātuves. Galvenā šāda pieejas mīnuss ir tas, ka statiskais saturs (un fails ar noteiktu revīziju faktiski ir statisks saturs) tiek piegādāts no tā paša servera, kurā ir biznesa loģika. Tā vietā var izveidot šādu shēmu:
- Serveris izsniedz URL faila lejupielādei. Tam var būt forma file_id + key, kur key ir mazs ciparu paraksts, kas sniedz tiesības piekļūtu resursam tuvākās diennakts laikā.
- Faila piegādi nodrošina vienkāršs nginx ar šādām opcijām:
- Saturašana ar saturu. Tā kā šis pakalpojums var atrasties uz atsevišķa servera, mēs esam atstājuši iespēju nākotnei saglabāt visus jaunākos lejupielādētos failus diskā.
- Atslēgas pārbaude savienojuma izveides brīdī
- Papildus: satura straumēšana. Piemēram, ja mēs saspringstam visus failus pakalpojumā, tad var veikt izsaiņošanu tieši šajā modulī. Tādējādi: IO operācijas tiek veiktas tur, kur tām ir visvairāk vietas. Java arhivators var viegli patērēt daudz liekas atmiņas, tomēr pārveidot pakalpojumu ar biznesa loģiku uz Rust/C++ var būt arī neefektīvi. Mūsu gadījumā tiek izmantoti dažādi procesi (vai pat pakalpojumi), tāpēc biznesa loģiku un IO operācijas var efektīvi nošķirt.
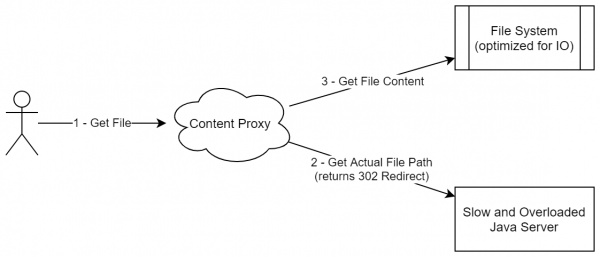
Šāda shēma neizskatās līdzīga statiska satura izplatīšanai (jo mēs neko neizlaižam uz citu statiskā satura paketi), tomēr patiesībā šāda pieeja pievēršas nemainīgu datu izplatīšanai. Vairāk nekā tas, šo shēmu var vispārināt arī uz citām situācijām, kad saturs nav tikai statisks, bet to var attēlot kā nemainīgu un neizdzēšamu bloku kopumu (lai gan tos var pievienot).
Vēl viens piemērs (lai nostiprinātu): ja jūs esat strādājuši ar Jenkins/TeamCity, tad zināt, ka abas šīs risinājumi ir uzrakstītas Java. Abas ir Java procesi, kas apstrādā gan būvju orķestrāciju, gan satura pārvaldību. Īpaši viņiem abiem ir uzdevumi, piemēram, "pārsūtīt failu/mapi no servera". Piemēram: artefaktu piegāde, avota koda pārsūtīšana (kad aģents nenolasa kodu tieši no krātuves, bet to veic serveris), piekļuve žurnāliem. Visas šīs uzdevumi atšķiras ar IO slodzi. Tātad, serverim, kas atbild par sarežģītu biznesa loģiku, jāspēj efektīvi virzīt cauri sevi lielus datu plūsmas. Un kas ir visinteresantākais, šādu operāciju var deleģēt arī nginx tieši tādā pašā shēmā (vienīgi pieprasījumā jāiekļauj datu atslēga).
Tomēr, ja atgriežamies pie mūsu sistēmas, mēs redzam šādu shēmu:
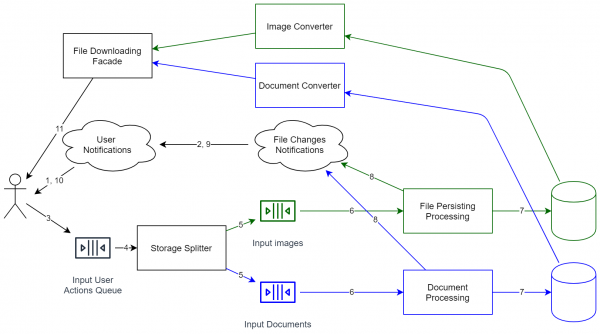
Kā redzams, sistēma ir radikāli sarežģījusies. Tagad tā vairs nav vienkārša mini-process, kas glabā failus lokāli. Tagad ir nepieciešama jau ne tā vienkāršākā atbalsta, API versiju kontroles utt. Tāpēc, kad visas diagrammas ir uzzīmētas, vislabāk ir detalizēti novērtēt, vai šīs paplašināmības izmaksas ir pamatotas. Taču, ja vēlaties spēt paplašināt sistēmu (tai skaitā, strādājot ar vēl lielāku lietotāju skaitu), tad būs jāizdara šādi risinājumi. Toties, kā rezultātā, sistēmas arhitektūra ir gatava slodzes palielināšanai (praktiski katru komponentu var klonēt horizontālai mērogošanai). Sistēmu var atjaunināt, nepārtraucot to (vienkārši dažas darbības nedaudz palēninās).
Kā es jau teicu pašā sākumā, šobrīd daži interneta pakalpojumi ir sākuši saņemt palielinātu slodzi. Un daži no tiem vienkārši ir pārstājuši strādāt pareizi. Patiesībā sistēmas atteicās tieši tajā brīdī, kad uzņēmumam vajadzētu pelnīt naudu. Tātad, vietā, lai atliktu piegādi, vietā, lai piedāvātu klientiem 'plānojiet piegādi tuvākajiem mēnešiem', sistēma vienkārši teica 'dodieties pie konkurentiem'. Faktiski, tā ir zemas veiktspējas cena: zaudējumi notiks tieši tad, kad peļņa būtu visaugstākā.
Secinājums
Visi šie pieejas jau bija zināmas iepriekš. Tas pats VK jau sen izmanto Static Content Hosting ideju attēlu izsniegšanai. Daudzas tiešsaistes spēles izmanto Sharding shēmu spēlētāju sadalīšanai pa reģioniem vai arī spēļu lokāciju sadalīšanai (ja pats pasaule ir vienota). Event Sourcing pieeja tiek aktīvi izmantota elektroniskajā pasta sistēmā. Lielākā daļa tirgotāju lietojumprogrammu, kurās nepārtraukti ienāk dati, patiesībā ir būvētas uz CQRS pieejas, lai spētu filtrēt saņemto informāciju. Un horizontāla mērogošana jau gadu desmitiem tiek izmantota daudzu pakalpojumu nodrošināšanā.
Tomēr vissvarīgākais ir tas, ka šos modeļus tagad ir ļoti viegli piemērot mūsdienu lietojumprogrammās (ja tās ir piemērotas, protams). Mākoņi piedāvā sharding un horizontālu mērogošanu uzreiz, kas ir daudz vieglāk nekā pasūtīt dažādus veltītus serverus dažādos datu centros patstāvīgi. CQRS ir kļuvis daudz vienkāršāks, pateicoties bibliotēku, piemēram, RX, attīstībai. Pirms 10 gadiem reti kurš tīmekļa vietne spēja atbalstīt tādu. Event Sourcing ir arī neticami viegli konfigurēts, pateicoties jau gataviem konteineriem ar Apache Kafka. Pirms 10 gadiem tas būtu bijis inovācija, tagad tas ir ikdienišķs. Līdzīgi arī ar statisko satura mitināšanu: pateicoties ērtākām tehnoloģijām (t.sk. arī tāpēc, ka ir detalizēta dokumentācija un liela atbilžu bāze), šāds pieejas veids kļuvis vēl vienkāršāks.
Kā secinājums, ieviešana vairākām diezgan sarežģītām arhitektūras shēmām tagad ir kļuvusi daudz vienkāršāka, un tādēļ to labāk apskatīt iepriekš. Ja desmit gadu vecā lietojumprogrammā atteicās no viena no iepriekš minētajiem risinājumiem augsto ieviešanas un darbības izmaksu dēļ, tad tagad, jaunajā lietojumprogrammā vai pēc refaktoringa, var izveidot pakalpojumu, kas arhitektūras ziņā būs gan paplašināms (veiktspējas ziņā), gan gatavs jauniem klientu pieprasījumiem (piemēram, personisko datu lokalizācijai).
Un pats svarīgākais: lūdzu, neizmantojiet šos pieejas veidus, ja jums ir vienkārša lietojumprogramma. Jā, tās ir glītas un interesantas, tomēr vietnei ar maksimālo apmeklējumu 100 cilvēku bieži vien var pietikt ar klasisku monolītu (vismaz no ārpuses, iekšpusē to var sadalīt modulos utt.).
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish