

Savā darbā es bieži saskaros ar jaunām tehniskām risinājumiem/programmatūras produktiem, par kuriem informācijas krievu valodā internetā ir diezgan maz. Ar šo rakstu centīšos aizpildīt vienu no šīm tukšajām vietām, izmantojot piemēru no savas nesenās prakses, kad bija nepieciešams konfigurēt CDC notikumu nosūtīšanu no divām populārām DBMS (PostgreSQL un MongoDB) uz Kafka klasteri, izmantojot Debezium. Ceru, ka šis pārskata raksts, kas radies, pamatojoties uz paveikto darbu, izrādīsies noderīgs arī citiem.
Kas ir Debezium un vispār CDC?
ir pārstāvis CDC programmatūras risinājumu kategorijā (), proti, tas ir savienotāju kopums dažādām DBMS, kas ir saderīgas ar Apache Kafka Connect ietvaru.
Tas ir kas izmanto Apache License v2.0 licenci un tiek sponsorēts uzņēmuma Red Hat. Izstrāde notiek kopš 2016. gada, un pašlaik tajā ir oficiāla atbalsta piedāvājums sekojošām DBMS: MySQL, PostgreSQL, MongoDB, SQL Server. Tāpat ir pieejami savienotāji Cassandra un Oracle, bet šobrīd tie atrodas "agrīnās piekļuves" statusā, un jauni laidieni negarantē atpakaļsaderību.
Salīdzinot CDC ar tradicionālo pieeju (kad lietojumprogramma tieši lasa datus no DBMS), tā galvenās priekšrocības ir datu izmaiņu straumēšanas realizācija līmeņa rindās ar zemu nokavēšanos, augstu uzticamību un pieejamību. Pēdējie divi punkti tiek sasniegti, izmantojot Kafka klasteri kā CDC notikumu krātuvi.
Tāpat par priekšrocību var uzskatīt to, ka notikumu glabāšanai tiek izmantota vienota modeļa pieeja, tāpēc gala lietojumprogrammai nebūs jāuztraucas par dažādu DBMS ekspluatācijas niansēm.
Visbeidzot, pateicoties ziņojumu starpnieka izmantošanai, tiek radīta iespēja horizontālai lietojumprogrammu mērogošanai, kas seko datu izmaiņām. Tajā pašā laikā ietekme uz datu avotu tiek samazināta līdz minimumam, jo dati tiek iegūti nevis tieši no DBMS, bet gan no Kafka klastera.
Par Debezium arhitektūru
Debezium izmantošanas process samazinās līdz šādai vienkāršai shēmai:
DBMS (kā datu avots) → savienotājs Kafka Connect → Apache Kafka → patērētājs
Kā ilustrāciju sniegšu diagrammu no projekta vietnes:
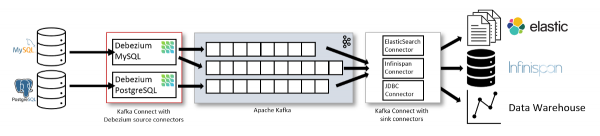
Tomēr šī shēma man nepatīk, jo rodas iespaids, ka iespējama tikai sinka savienotāja izmantošana.
Tomēr situācija ir atšķirīga: jūsu Data Lake piepildījums (pēdējais posms iepriekšējā shēmā) — tas nav vienīgais veids, kā izmantot Debezium. Notikumi, kas nosūtīti uz Apache Kafka, var tikt izmantoti jūsu lietotnēs dažādu situāciju risināšanai. Piemēram:
- novecojusi datu dzēšana no kešatmiņas;
- paziņojumu sūtīšana;
- meklēšanas indeksu atjaunināšana;
- kaut kas līdzīgs audita žurnāliem;
- …
Ja jums ir Java lietotne un nav nepieciešamības/vēlmes izmantot Kafkas klasteri, pastāv arī iespēja strādāt caur . Acīmredzams ieguvums ir tas, ka varat atteikties no papildu infrastruktūras (kā konektora un Kafkas). Tomēr šis risinājums ir pasludināts par novecojušu (deprecated) kopš versijas 1.1 un vairs netiek ieteikts lietošanai (nākamajos laidienos tā atbalstu var noņemt).
Šajā rakstā tiks aplūkota ieteicamā izstrādātāju arhitektūra, kas nodrošina noturību pret kļūdām un iespēju mērogot.
Konektora konfigurācija
Lai sāktu sekot izmaiņām pašā vērtīgākajā — datos, — mums būs nepieciešams:
- datu avots, kas var būt MySQL, sākot ar versiju 5.7, PostgreSQL 9.6+, MongoDB 3.2+ ();
- Apache Kafka klasteris;
- Kafka Connect instances (versijas 1.x, 2.x);
- konfigurēts Debezium konektors.
Pirmo divu punktu, t.i., datu bāzes un Apache Kafka instalācijas procesu, apstrāde pārsniedz šī raksta ietvarus. Tomēr tiem, kas vēlas izveidot visu smiltīs, oficiālajā atmiņā ir pieejams gatavs .
Mēs koncentrēsimies uz diviem pēdējiem punktiem.
0. Kafka Connect
Šeit un turpmāk rakstā visi konfigurācijas piemēri tiks aplūkoti Docker attēlos, ko izstrādājusi Debezium. Tas satur visus nepieciešamos spraudņa failus (konektorus) un paredz Kafka Connect konfigurāciju, izmantojot vides mainīgos.
Ja paredzēta Kafka Connect izmantošana no Confluent, jums būs pašam manuāli pievienot nepieciešamos konektoru spraudņus direktorijā, kas norādīta plugin.path vai norādīta caur vides mainīgo CLASSPATH. Kafka Connect darba iestatījumi un konektori tiek noteikti, izmantojot konfigurācijas failus, kurus nodod kā argumentus darba palaišanas komandai. Sīkāku informāciju skatiet .
Visa Debeizum iestatīšanas process ar savienotāju tiek veikts divos posmos. Apskatīsim katru no tiem:
1. Kafka Connect ietvara iestatīšana
Lai straumētu datus Apache Kafka klasterī, Kafka Connect ietvaram jānosaka specifiskas konfigurācijas parametru vērtības, piemēram:
- savienojuma iestatījumi ar klasteri,
- tēmu nosaukumi, kuros tiks saglabāta paša savienotāja konfidencialitāte,
- grupas nosaukums, kurā ir palaists savienotājs (ja tiek izmantots izplatīts režīms).
Oficiālais projekta Docker attēls atbalsta konfigurāciju, izmantojot vides mainīgos — to arī izmantosim. Tātad, lejupielādējam attēlu:
docker pull debezium/connectMinimālais nepieciešamo vides mainīgo komplekts savienotāja palaišanai izskatās šādi:
-
BOOTSTRAP_SERVERS=kafka-1:9092,kafka-2:9092,kafka-3:9092— sākotnējais klastera Kafka serveru saraksts, lai saņemtu pilnu klastera dalībnieku sarakstu; -
OFFSET_STORAGE_TOPIC=connector-offsets— tēma, kurā tiek saglabātas pozīcijas, kurās šobrīd atrodas savienotājs; -
CONNECT_STATUS_STORAGE_TOPIC=connector-status— tēma savienotāja un tā uzdevumu statusa saglabāšanai; -
CONFIG_STORAGE_TOPIC=connector-config— tēma savienotāja un tā uzdevumu konfigurācijas datu saglabāšanai; -
GROUP_ID=1— darba grupas identifikators, uz kurām var tikt palaists savienotāja uzdevums; nepieciešams, izmantojot izplatīto (distributed) režīmu.
Palaižam konteineru ar šiem mainīgajiem:
docker run
  -e BOOTSTRAP_SERVERS='kafka-1:9092,kafka-2:9092,kafka-3:9092'
  -e GROUP_ID=1
  -e CONFIG_STORAGE_TOPIC=my_connect_configs
  -e OFFSET_STORAGE_TOPIC=my_connect_offsets
  -e STATUS_STORAGE_TOPIC=my_connect_statuses  debezium/connect:1.2
Piezīme par Avro
Noklusējuma iestatījumā Debezium raksta datus JSON formātā, kas ir pieņemams smilšu kastēm un nelieliem datu apjomiem, taču var radīt problēmas augstas slodzes datubāzēs. Alternatīva JSON konvertoram ir ziņu sērijas izmantošana binārā formātā, kas ļauj samazināt I/O subsistēmas slodzi Apache Kafka.
Lai izmantotu Avro, ir jāizveido atsevišķa (shēmu uzglabāšanai). Mainīgie konvertoram izskatīsies šādi:
name: CONNECT_VALUE_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: CONNECT_KEY_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: VALUE_CONVERTER
value: io.confluent.connect.avro.AvroConverter
Detalizētāka informācija par Avro izmantošanu un reģistra iestatīšanu pārsniedz šī raksta ietvarus — turpmāk, lai parādītu piemēru, izmantosim JSON.
2. Konnektora iestatīšana
Tagad varam pāriet tieši pie konnektora konfigurācijas, kas lasīs datus no avota.
Apskatīsim uz divu DBMS piemēriem: PostgreSQL un MongoDB, par kuriem man ir pieredze un ir zināmas atšķirības (pat ja nelielas, dažos gadījumos – būtiskas!).
Konfigurācija tiek aprakstīta JSON notācijā un tiek ielādēta Kafka Connect, izmantojot POST pieprasījumu.
2.1. PostgreSQL
Konnektora konfigurācijas piemērs PostgreSQL:
{
  "name": "pg-connector",
  "config": {
    "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
    "plugin.name": "pgoutput",
    "database.hostname": "127.0.0.1",
    "database.port": "5432",
    "database.user": "debezium",
    "database.password": "definitelynotpassword",
    "database.dbname" : "dbname",
    "database.server.name": "pg-dev",
    "table.include.list": "public.(.*)",
    "heartbeat.interval.ms": "5000",
    "slot.name": "dbname_debezium",
    "publication.name": "dbname_publication",
    "transforms": "AddPrefix",
    "transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
    "transforms.AddPrefix.regex": "pg-dev.public.(.*)",
    "transforms.AddPrefix.replacement": "data.cdc.dbname"
  }
}
Konnektora darbības princips pēc šādas iestatīšanas ir diezgan vienkāršs:
- Pirmajā palaidē tas savienojas ar datubāzi, kas norādīta konfigurācijā, un darbojas režīmā initial snapshot, sūtot Kafka sākotnējo datu kopu, kas iegūta, izmantojot nosacījumu
SELECT * FROM table_name. - Kad inicializācija ir pabeigta, konnektors pāriet uz WAL failu lasīšanas režīmu PostgreSQL.
Par izmantotajām opcijām:
-
name— konnektora nosaukums, kuram tiek izmantota tālāk aprakstītā konfigurācija; turpmāk šo nosaukumu izmantos konnektora pārvaldīšanai (t.i., statusa verificēšanai/atkārtotai palaišanai/konfigurācijas atjaunināšanai) caur Kafka Connect REST API; -
connector.class— DBMS konnektora klase, kas tiks izmantota konfigurētajam konnektoram; -
plugin.name— nosaukums papildinājumam loģiskai datu dekodēšanai no WAL failiem. Ir pieejami izvēleiwal2json,decoderbuffsunpgoutput. Pirmie divi prasa attiecīgu paplašinājumu uzstādīšanu DBMS, betpgoutputPostgreSQL versijai 10 un augstākai nav nepieciešama papildu apstrāde; -
database.*— parametri savienojumam ar DB, kurdatabase.server.name— PostgreSQL instance nosaukums, kas tiek izmantots nosaukuma veidošanai tēmas klasterī Kafka; -
table.include.list— tabulu saraksts, kurās vēlamies uzraudzīt izmaiņas; tiek norādīts formātāschema.table_name; nevar izmantot kopā artable.exclude.list; -
heartbeat.interval.ms— intervāls (milisekundēs), ar kura starpniecību savienotājs nosūta heartbeat ziņojumus noteiktā tēmā; -
heartbeat.action.query— pieprasījums, kas tiks izpildīts, katru reizi nosūtot heartbeat ziņojumu (šī opcija pieejama kopš versijas 1.1); -
slot.name— replikācijas slotu nosaukums, kuru izmantos savienotājs; publication.name— nosaukums PostgreSQL, kuru izmanto savienotājs. Ja tādas nepastāv, Debezium mēģinās to izveidot. Ja lietotājam, ar kuru notiek pieslēgšanās, nav pietiekamu tiesību šai darbībai — savienotājs pabeigs darbu ar kļūdu;-
transformsnosaka, kā tieši mainīt mērķa tēmas nosaukumu:-
transforms.AddPrefix.typenorāda, ka izmantosim regulāros izteicienus; -
transforms.AddPrefix.regex— maska, pēc kuras pārrakstām mērķa tēmas nosaukumu; -
transforms.AddPrefix.replacement— tieši tas, uz ko mēs pārrakstām.
-
Uzzināt vairāk par heartbeat un transforms
Pēc noklusējuma savienotājs sūta datus Kafka pēc katras apstiprinātās transakcijas, un tās LSN (Log Sequence Number) ieraksta apkalpojošajā tēmā offset. Bet kas notiks, ja savienotājs ir konfigurēts lasīt ne visu datu bāzi kopumā, bet tikai dažas tās tabulas (kuras tiek atjauninātas ne bieži)?
- Savienotājs lasīs WAL failus un neatradīs tajos transakciju apstiprinājumus tajās tabulās, kuras viņš uzrauga.
- Tāpēc viņš neatjaunos savu pašreizējo pozīciju ne tēmā, ne replikācijas slotā.
- Tas, savukārt, novedīs pie WAL failu 'noturēšanas' diskā un iespējamā visu diska vietas izsīka.
Un šeit palīdz opcijas heartbeat.interval.ms un heartbeat.action.query. Šo opciju izmantošana kopā ļauj katru reizi, nosūtot heartbeat ziņojumu, veikt datu izmaiņu pieprasījumu atsevišķā tabulā. Tādējādi pastāvīgi tiek atjaunots LSN, kurā šobrīd atrodas savienotājs (replikācijas slotā). Tas ļauj DBMS dzēst WAL failus, kuri vairs nav nepieciešami. Vairāk par opciju darbību var uzzināt .
Cita opcija, kas pelnījusi lielāku uzmanību, — tas ir transforms. Lai gan tā drīzāk ir par ērtību un estētiku…
Pēc noklusējuma Debezium izveido tēmas, vadoties pēc šādas nosaukšanas politikas: serverName.schemaName.tableName. Tas ne vienmēr var būt ērti. Opcijas transforms izmantojot regulāros izteicienus, var noteikt tabulu sarakstu, no kurām notikumus nepieciešams maršrutēt uz tēmu ar konkrētu nosaukumu.
Mūsu konfigurācijā pateicoties Pabeidzot savienotāja konfigurācijas aprakstu PostgreSQL, jārunā par sekojošām īpatnībām/ierobežojumiem tā darbībā: Tātad, ielādēsim mūsu konfigurāciju savienotājā: Pārbaudām, vai ielāde ir veiksmīga un savienotājs ir palaists: Lieliski: tas ir konfigurēts un gatavs darbam. Tagad izliksimies par patērētāju un pieslēgsimies Kafka, pēc tam pievienosim un mainīsim ierakstu tabulā: Mūsu tēma to atspoguļos šādā veidā: Ļoti garš JSON ar mūsu izmaiņām Abos divos gadījumos ieraksti sastāv no atslēgas (PK) ierakstam, kas tika mainīts, un tieši no paša būtības izmaiņām: kāds bija ieraksts pirms un kāds kļuva pēc tam. Šis savienotājs izmanto standarta MongoDB replikācijas mehānismu, lasot informāciju no primārā DBMS oploga. Līdzīgi iepriekš aprakstītajam savienotājam PgSQL, arī šeit, pirmo reizi palaižot, tiek izveidots primārais datu snapshots, pēc kura savienotājs pārslēdzas uz oploga lasīšanas režīmu. Konfigurācijas piemērs: Kā redzams, šeit nav jaunu iespēju salīdzinājumā ar iepriekšējo piemēru, bet ir samazinājies tikai opciju skaits, kas atbild par savienojumu ar datubāzi un to prefiksiem. Iestatījumi Uzticības un augstas pieejamības jautājums šodien ir aktuālāk nekā jebkad — it īpaši, kad runājam par datiem un darījumiem, un datu izmaiņu uzraudzība šajā jautājumā nav izslēgta. Apskatīsim, kas principā var noiet greizi un kas notiks ar Debezium katrā gadījumā. Ir trīs atteikuma varianti: Tomēr ir izņēmumi. Ja konnektors ilgu laiku ir bijis atslēgts (vai nevarēja piekļūt MongoDB instancei), un oplogs šajā laikā ir tiks rotēts, tad, atjaunojot savienojamību, konnektors mierīgi turpinās lasīt datus no pirmās pieejamās pozīcijas, kā rezultātā daļa datu nonāks Kafka nees . Debezium — tas ir mans pirmais pieredze ar CDC sistēmām, un kopumā tas ir ļoti pozitīvs. Projekts piesaistīja ar atbalstu galvenajām DB, konfigurācijas vienkāršību, klasterizācijas atbalstu un aktīvu kopienu. Interesentiem praksē iesaku iepazīties ar rokasgrāmatām priekš un . Salīdzinājumā ar JDBC konnektoru priekš Kafka Connect galvenā Debezium priekšrocība ir tā, ka izmaiņas tiek nolasītas no DB žurnāliem, kas ļauj iegūt datus ar minimālu aizturi. JDBC konnektors (no Kafka Connect piegādes) veic pieprasījumus uz uzraudzīto tabulu ar fiksētu intervālu un (tieši šī iemesla dēļ) nerada ziņojumus, dzēšot datus (kā var pieprasīt datus, kuru nav?). Lai risinātu līdzīgas problēmas, var pievērst uzmanību šādiem risinājumiem (turklāt Debezium): Lasiet arī mūsu emuāra rakstos: Avots: habr.comtransforms notiek sekojošais: visi CDC notikumi no uzraudzītās datubāzes nonāks tēma ar nosaukumu data.cdc.dbname. Savukārt, ja šo iestatījumu nav, Debezium noklusējuma izveidotu pa vienai tēmai katrai tabulai ar šādu formātu: pg-dev.public..
Savienotāja ierobežojumi
Konfigurācijas pielietošana
curl -i -X POST -H "Accept:application/json"
-H "Content-Type:application/json" http://localhost:8083/connectors/
-d @pg-con.json$ curl -i http://localhost:8083/connectors/pg-connector/status
HTTP/1.1 200 OK
Date: Thu, 17 Sep 2020 20:19:40 GMT
Content-Type: application/json
Content-Length: 175
Server: Jetty(9.4.20.v20190813)
{"name":"pg-connector","connector":{"state":"RUNNING","worker_id":"172.24.0.5:8083"},"tasks":[{"id":0,"state":"RUNNING","worker_id":"172.24.0.5:8083"}],"type":"source"}$ kafka/bin/kafka-console-consumer.sh
--bootstrap-server kafka:9092
--from-beginning
--property print.key=true
--topic data.cdc.dbname
postgres=# insert into customers (id, first_name, last_name, email) values (1005, 'foo', 'bar', 'foo@bar.com');
INSERT 0 1
postgres=# update customers set first_name = 'egg' where id = 1005;
UPDATE 1{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":null,
"after":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600374991648,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":602,
"lsn":34088472,
"xmin":null
},
"op":"c",
"ts_ms":1600374991762,
"transaction":null
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"after":{
"id":1005,
"first_name":"egg",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600375609365,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":603,
"lsn":34089688,
"xmin":null
},
"op":"u",
"ts_ms":1600375609778,
"transaction":null
}
}
INSERT: vērtība pirms (before) ir vienāda ar null, bet pēc tam — rindiņa, kas tika ievietota. UPDATE: payload.before parāda iepriekšējo rindu stāvokli, bet payload.after — jauno ar izmaiņu būtību.2.2 MongoDB
{
"name": "mp-k8s-mongo-connector",
"config": {
"connector.class": "io.debezium.connector.mongodb.MongoDbConnector",
"tasks.max": "1",
"mongodb.hosts": "MainRepSet/mongo:27017",
"mongodb.name": "mongo",
"mongodb.user": "debezium",
"mongodb.password": "dbname",
"database.whitelist": "db_1,db_2",
"transforms": "AddPrefix",
"transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
"transforms.AddPrefix.regex": "mongo\.([a-zA-Z_0-9]*)\.([a-zA-Z_0-9]*)",
"transforms.AddPrefix.replacement": "data.cdc.mongo_$1"
}
}transforms šoreiz paveic sekojošo: pārvērš mērķa tēmas nosaukumu no shēmas <server_name>.<db_name>.<collection_name> par data.cdc.mongo_<db_name>.Izmaksu noturība
Secinājums
P.S.

 Russian Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish