

Sveiki, Habr! Iepazīstinu ar tulkojumu raksta
.
Kad runa ir par relāciju datu bāzēm, es nevaru nenovērot, ka trūkst padziļinātas informācijas. Tās tiek izmantotas visur. Pastāv daudzas dažādas datu bāzes: no mazas un noderīgas SQLite līdz jaudīgajai Teradata. Taču ir tikai dažas publikācijas, kas izskaidro, kā darbojas datu bāze. Jūs varat meklēt paši, izmantojot vaicājumu "howdoesarelationaldatabasework" ("kā darbojas relāciju datu bāzes"), lai redzētu, cik maz rezultātu ir. Vēl vairāk, šie raksti parasti ir īsi. Ja jūs meklējat jaunākās modernas tehnoloģijas (BigData, NoSQL vai JavaScript), jūs atradīsiet vairāk padziļinātu rakstu, kas izskaidro, kā tās darbojas.
Vai relāciju datu bāzes ir pārāk novecojušas un garlaicīgas, lai tās varētu izskaidrot ārpus universitātes kursiem, pētījumiem un grāmatām?
Kā izstrādātājs, es ienистēju izmantot to, ko nesaprotu. Ja datu bāzes tiek izmantotas vairāk nekā 40 gadus, tam jābūt iemeslam. Šo gadu laikā esmu pavadījis simtiem stundu, lai patiešām saprastu šos dīvainos melnos kastītes, kuras izmantoju katru dienu. Relāciju datu bāzes ir ļoti interesanti, jo tās balstās uz noderīgām un atkārtoti izmantojām koncepcijām. Ja jūs interesē datu bāzes sapratne, taču jums nekad nav bijis laika vai vēlmes iedziļināties šajā plašajā tēmā, jums patiks šis raksts.
Lai gan šī raksta nosaukums ir skaidrs, raksta mērķis nav saprast, kā izmantot datu bāzi. Tādējādi, jums jau jāzina, kā uzrakstīt vienkāršu savienojuma vaicājumu un pamata vaicājumus CRUD; citādi jūs, iespējams, nesapratīsiet šo rakstu. Tas ir vienīgais, kas jums jāzina, es izskaidrošu visu pārējo.
Sākušu ar dažām datorspēku pamatiem, piemēram, algoritmu laika sarežģītību (BigO). Es zinu, ka daži no jums ienīst šo koncepciju, taču bez tās jūs nevarēsiet saprast nianses datu bāzē. Tā kā tā ir milzīga tēma, es koncentrēšos uz to, ko uzskatu par svarīgu: kā datu bāze apstrādā SQL pieprasījums. Es iepazīstināšu tikai ar pamats koncepcijām datu bāzē, lai raksta beigās jums būtu priekšstats par to, kas notiek zem vāka.
Tā kā šis ir garš un tehnisks raksts, kas ietver daudzas algoritmus un datu struktūras, nesteidzieties to lasīt. Dažas koncepcijas var būt grūti saprotamas; jūs varat tās izlaist un joprojām iegūt vispārēju priekšstatu.
Vairāk informētiem no jums šis raksts ir sadalīts trijās daļās:
- Zemāko un augstāko datu bāzes komponenšu pārskats
- Vaicājumu optimizācijas procesa pārskats
- Transakciju un buferu pārvaldības pārskats
Atgriežoties pamatos
Pirms daudziem gadiem (tālā, tālā galaksijā…) izstrādātājiem bija precīzi jāzina, cik darbību viņi kodē. Viņi zināja savus algoritmus un datu struktūras no galvas, jo nevarēja atļauties tērēt procesora jaudu un atmiņu saviem lēnajiem datoriem.
Šajā daļā es jums atgādinu par dažām no šīm koncepcijām, jo tās ir nepieciešamas, lai izprastu datu bāzi. Es arī ievadīšu jēdzienu datu bāzes indekss.
O(1) pret O(n2)
Pašreiz daudzi izstrādātāji nepievērš uzmanību algoritmu laika sarežģītībai... un viņi ir taisnība!
Bet, kad jūs risināt ar lielu datu apjomu (ne runājot par tūkstošiem) vai ja jūs cīnāties par milisekundēm, ir kritiski svarīgi saprast šo koncepciju. Un, kā jūs saprotat, datu bāzēm ir jārisina abas situācijas! Es negribu jūs tērēt vairāk laika, nekā nepieciešams, lai saprastu būtību. Tas mums vēlāk palīdzēs saprast izmaksu pamatojumu (cost based optimization).
Koncepta
Algoritma laika sarežģītība tiek lietota, lai redzētu, cik daudz laika prasīs algoritma izpilde dotajam datu apjomam. Lai aprakstītu šo sarežģītību, izmanto lielā O matemātisko simboliku. Šī notācija tiek izmantota ar funkciju, kas apraksta, cik daudz darbību algoritmam nepieciešams, lai apstrādātu noteiktu ieejas datu apjomu.
Piemēram, kad es saku "šim algoritmam ir sarežģītība O (some_function() )", tas nozīmē, ka algoritmam, lai apstrādātu noteiktu datu apjomu, ir nepieciešams some_function(a_certain_amount_of_data) darbības.
Šādā gadījumā svarīgi nav datu daudzums**, bet gan tas, ** kā palielinās darbību skaits, palielinoties datu apjomam. Laika sarežģītība nenodrošina precīzu darbību skaitu, bet tā ir laba metode laika novērtēšanai.
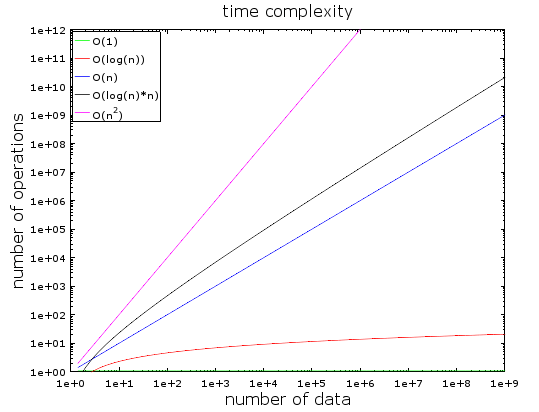
Šajā grafikā jūs varat redzēt operāciju skaita atkarību no ieejas datu apjoma dažādu algoritmu laika sarežģītības veidiem. Esmu izmantojis logaritmisko skalu, lai tos attēlotu. Citiem vārdiem sakot, datu apjoms ātri pieaug no 1 līdz 1 miljardam. Mēs varam redzēt, ka:
- O(1) vai konstantais sarežģītības līmenis paliek nemainīgs (pretējā gadījumā to nesauks par konstantu sarežģītību).
- O(log(n)) paliek zems pat ar miljardiem datu.
- Sliktākā sarežģītība — O(n2), kur operāciju skaits ātri pieaug.
- Divas citas sarežģītības arī pieaug tikpat ātri.
Piemēri
Nelielā datu apjomā atšķirība starp O(1) un O(n2) ir niecīga. Piemēram, pieņemam, ka jums ir algoritms, kuram jāapstrādā 2000 elementi.
- O(1) algoritms izmaksās 1 operāciju
- O(log(n)) algoritms izmaksās 7 operācijas
- O(n) algoritms izmaksās 2000 operācijas
- O(n * log(n)) algoritms izmaksās 14 000 operāciju
- O(n2) algoritms izmaksās 4 000 000 operāciju
Atšķirība starp O(1) un O(n2) šķiet liela (4 miljoni operāciju), taču jūs zaudēsiet ne vairāk kā 2 ms, kas ir laiks, lai aizvērtu acis. Patiesībā mūsdienu procesori var apstrādāt . Tieši tādēļ veiktspēja un optimizācija nav problēma daudzos IT projektos.
Kā jau teicu, joprojām ir svarīgi saprast šo konceptu, strādājot ar milzīgu datu apjomu. Ja šoreiz algoritmam jāapstrādā 1 000 000 elementu (kas nav daudz datu bāzei):
- O(1) algoritms izmaksās 1 operāciju
- O(log(n)) algoritms izmaksās 14 operācijas
- O(n) algoritms izmaksās 1 000 000 operāciju
- O(n * log(n)) algoritms izmaksās 14 000 000 operāciju
- O(n2) algoritms izmaksās 1 000 000 000 000 operāciju
Es neesmu veicis aprēķinus, bet es teiktu, ka ar O(n2) algoritmu jums ir laiks iedzert kafiju (pat divus!). Ja jūs pievienosiet vēl 0 datu apjomam, jums būs laiks padusot.
Iedziļināsimies
Informācijai:
- Meklēšana labā heša tabulā atrod elementu ar O(1).
- Meklēšana labi līdzsvarotā kokā dod rezultātu ar O(log(n)).
- Meklēšana masīvā dod rezultātu ar O(n).
- Labākajiem kārtošanas algoritmiem ir sarežģītība O(n * log(n)).
- Sliktam kārtošanas algoritmam ir sarežģītība O(n2).
Piezīme: nākamajās daļās mēs apskatīsim šos algoritmus un datu struktūras.
Ir ir vairāki algoritma laika sarežģītības veidi:
- vidējā gadījuma scenārijs
- labākais iznākums
- un sliktākais scenārijs
Laika sarežģītība bieži ir sliktākais scenārijs.
Es runāju tikai par algoritma laika sarežģītību, bet sarežģītība attiecas arī uz:
- algoritma atmiņas patēriņu
- algoritma diska ievade / izvadē
Protams, ir sarežģītības, kas ir sliktākas nekā n2, piemēram:
- n4: tas ir briesmīgi! Daži no minētajiem algoritmiem ir ar šādu sarežģītību.
- 3n: tas ir vēl sliktāk! Viens no algoritmiem, ko redzēsim šī raksta vidū, ir ar šo sarežģītību (un tas patiešām tiek izmantots daudzās datu bāzēs).
- faktoriāls n: jūs nekad nesaņemsiet savus rezultātus, pat ar nelielu datu apjomu.
- nn: ja jūs sastopaties ar šo sarežģītību, jums vajadzētu jautāt sev, vai tiešām tā ir jūsu joma…
Piezīme: es jums devu nevis reālu lielā O apzīmējuma definīciju, bet tikai ideju. Jūs varat izlasīt šo rakstu par reālo (asimptotisko) definīciju.
MergeSort (Sadalīt un apvienot)
Ko jūs darāt, kad jums vajag sakārtot kolekciju? Ko? Jūs izsaucat funkciju sort()… Labi, labs atbildes veids… Bet datu bāzē jums jāizprot, kā darbojas šī sort() funkcija.
Ir vairāki labi kārtošanas algoritmi, tāpēc es koncentrēšos uz vissvarīgāko: sadalījuma un apvienošanas kārtošana. Iespējams, jūs šobrīd nesaprotat, kāpēc datu kārtošana ir noderīga, bet jums tas būs jāsaprot pēc daļas, kas veltīta vaicājumu optimizācijai. Turklāt sapratne par sadalījuma un apvienošanas kārtošanu palīdzēs mums vēlāk izprast kopējo datu bāzu operāciju, ko sauc par merge join (apvienošana, izmantojot sadalījumu).
Merge (apvienošana)
Tāpat kā daudzi noderīgi algoritmi, sadalījuma un apvienošanas kārtošana balstās uz viltību: apvienojot 2 sakārtotās masas ar izmēru N / 2, tiek izveidota N elementu sakārtota masa, kas izmaksā tikai N operācijas. Šī operācija tiek saukta par apvienošanu.
Apskatīsim, ko tas nozīmē vienkāršā piemērā:
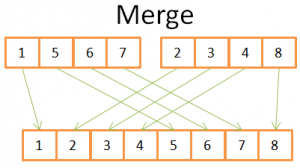
Šajā attēlā redzams, ka, lai izveidotu galīgo sakārtoto masu no 8 elementiem, jums vien jāveic iterācija vienreiz 2x 4-elementu masīvā. Jo abi 4-elementu masīvi jau ir sakārtoti:
- 1) jūs salīdzināt abus pašreizējos elementus divos masīvos (uz sākuma pašreizējais = pirmajam)
- 2) pēc tam paņemiet mazāko, lai to ievietotu 8 elementu masīvā
- 3) un pārejiet pie nākamā elementa masīvā, kur paņēmāt vismazāko elementu
- un atkārtojiet 1,2,3, līdz nonāksiet pie pēdējā elementa vienā no masīviem.
- Pēc tam jūs paņemat pārējos elementus no otra masīva, lai ievietotu tos 8 elementu masīvā.
Tas darbojas, jo abi 4 elementu masīvi ir sakārtoti, un tādēļ jums nav nepieciešams "atgriezties" šajos masīvos.
Tagad, kad esam sapratuši šo triku, lūk, mans pseido-kods apvienošanai:
array mergeSort(array a)
   if(length(a)==1)
      return a[0];
   end if

   //rekursīvie izsaukumi
   [left_array right_array] := split_into_2_equally_sized_arrays(a);
   array new_left_array := mergeSort(left_array);
   array new_right_array := mergeSort(right_array);

   //apvieno divus mazus sakārtotus masīvus lielākajā
   array result := merge(new_left_array,new_right_array);
   return result;
Sakārtošana ar apvienošanu sadala uzdevumu mazākos uzdevumos un pēc tam atrod mazāko uzdevumu rezultātus, lai iegūtu sākotnējā uzdevuma rezultātu (piezīme: šāda veida algoritmi tiek saukti par "dalīt un valdīt"). Ja nesaprotat šo algoritmu, neuztraucieties; es to pirmo reizi nesapratu, kad to redzēju. Ja tas jums var palīdzēt, es šo algoritmu redzu kā divfāžu algoritmu:
- Dalīšanas fāze, kur masīvs tiek sadalīts mazākos masīvos
- Kārtošanas fāze, kur mazie masīvi tiek apvienoti (izmantojot apvienošanu), lai izveidotu lielāku masīvu.
Dalīšanas fāze
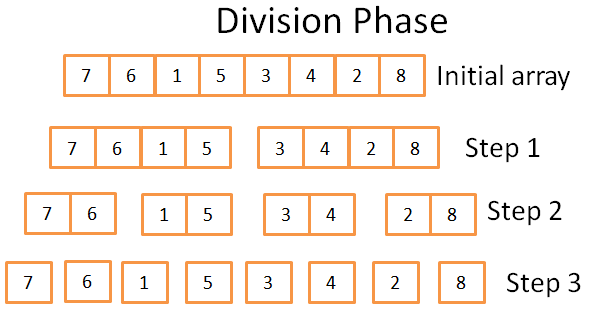
Dalīšanas posmā masīvs tiek sadalīts vienotajos masīvos 3 soļos. Formālais soļu skaits ir log(N) (jo N=8, log(N) = 3).
Kā es to zinu?
Es esmu ģēnijs! Vienā vārdā — matemātika. Ideja ir tāda, ka katrs solis samazina sākotnējā masīva lielumu uz pusi. Soļu skaits ir tas, cik reizes jūs varat sadalīt sākotnējo masīvu uz pusi. Tas ir precīzs logaritma definējums (ar pamatni 2).
Kārtošanas fāze
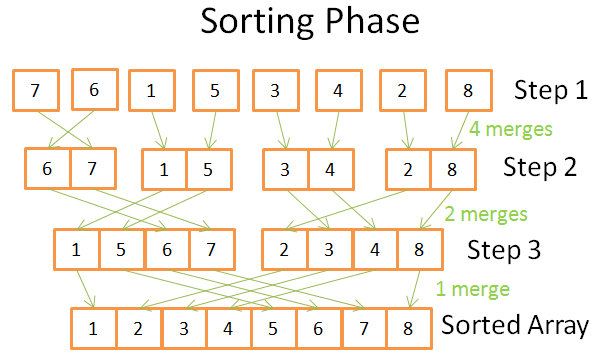
Kārtošanas posmā jūs sākāt ar vienotajiem (viena elementa) masīviem. Katrs posms jūs pielietojat vairākus apvienošanas darbības, un kopējās izmaksas sastāda N = 8 operācijas:
- Pirmajā posmā jums ir 4 apvienojumi, kas maksā 2 operācijas katrs
- Otrajā posmā jums ir 2 apvienojumi, kas maksā 4 operācijas katrs
- Trešajā posmā jums ir 1 apvienojums, kas maksā 8 operācijas
Kad ir log(N) soļi, kopējās izmaksas N * log(N) operāciju.
Apvienošanas kārtošanas priekšrocības
Kāpēc šis algoritms ir tik jaudīgs?
Jo:
- Jūs varat to mainīt, lai samazinātu atmiņas patēriņu, tādējādi palaidīsiet tieši esošo masīvu, nevis izveidosiet jaunus masīvus.
Piezīme: šī veida algoritmi tiek saukti par (saraksts bez papildu atmiņas).
- Jūs varat to pielāgot, lai vienlaikus izmantotu diska vietu un nelielu atmiņas daudzumu bez būtiskas ietekmes uz diska ievadi/izvadi. Ideja ir tāda, ka atmiņā tiek ielādētas tikai tās daļas, kas šobrīd tiek apstrādātas. Tas ir svarīgi, kad nepieciešams kārtot tabulu, kas izmēra vairākus gigabaitus, ar 100 megabaitiem bufera atmiņas.
Piezīme: šī veida algoritmi tiek saukti par .
- Jūs varat to mainīt, lai palaistu vairākos procesors / pavedienos / serveros.
Piemēram, izkliedētā apvienošanas kārtošana ir viens no galvenajiem komponentiem (kas ir struktūra lielajos datos).
- Šis algoritms var pārvērst svina zeltā (patiesi!).
Šis kārtošanas algoritms tiek izmantots lielākajā daļā (ja ne visās) datu bāzēs, taču tas nav vienīgais. Ja vēlaties uzzināt vairāk, varat izlasīt šo , kas apspriež vispārējo kārtošanas algoritmu plusus un mīnusus datu bāzēs.
Masīvs, Koks un Hesh- tabula
Tagad, kad saprotam laika sarežģītības un kārtošanas ideju, man jāsaka jums par 3 datu struktūrām. Tas ir svarīgi, jo tās ir mūsdienu datu bāzu pamats. Es arī iepazīstināšu ar jēdzienu datu bāzes indekss.
Masīvs
Divdimensiju masīvs ir visvienkāršākā datu struktūra. Tabulu var uzskatīt par masīvu. Piemēram:
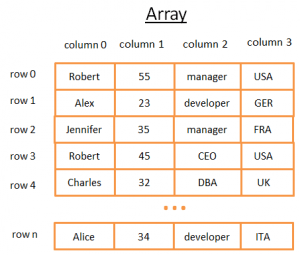
Šis 2-dimensionālais masīvs attēlo tabulu ar rindām un kolonnu:
- Katrs rinda attēlo entitāti
- Kolonnas glabā īpašības, kas apraksta entitāti.
- Katrs stabiņš uzglabā noteikta tipa datus (vesels skaitlis, virkne, datums …).
Tas ir ērti uzglabāt un vizualizēt datus, taču, kad jums ir jāatrod konkrēta vērtība, tas nav piemērots.
Piemēram, ja vēlaties atrast visus puišus, kas strādā Apvienotajā Karalistē, jums būs jāpārskata katra rinda, lai noteiktu, vai tā pieder Apvienotajai Karalistei. Tas jums izmaksās N operācijas, kur N — rindu skaits, kas nav slikti, bet vai var būt ātrāks ceļš? Tagad ir pienācis laiks iepazīties ar kokiem.
Piezīme: lielākā daļa mūsdienu datubāzu nodrošina paplašinātas masīvas efektīvai tabulu uzglabāšanai: kaudzes organizētas tabulas un indeksu organizētas tabulas. Taču tas nemaina ātras meklēšanas noteiktā nosacījumā kolonu grupā problēmu.
Datubāzes koks un indekss
Divkāršais meklēšanas koks ir divkāršais koks ar īpašu īpašību, kurā katra mezgla atslēga jābūt:
- lielāka par visām atslēgām, kas glabājas kreisajā apakškokā
- mazāka par visām atslēgām, kas glabājas labajā apakškokā
Apskatīsim, ko tas nozīmē vizuāli
Ideja
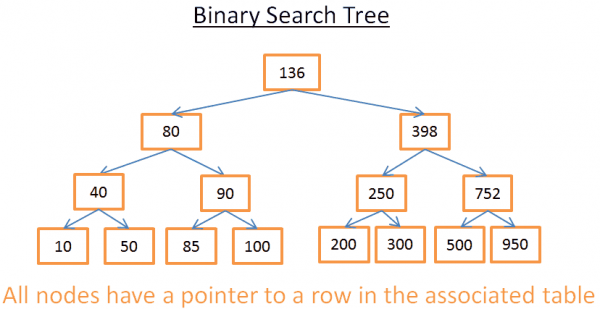
Šim kokam ir N = 15 elementi. Pieņemsim, ka meklēju 208:
- Es sāku ar sakni, kuras atslēga ir 136. Tā kā 136<208, es skatos uz mezglu 136 labo apakškoku.
- 398>208, tādēļ es skatos uz mezglu 398 kreiso apakškoku
- 250>208, tādēļ es skatos uz mezglu 250 kreiso apakškoku
- 200<208, tādēļ es skatos uz mezglu 200 labo apakškoku. Bet 200 nav labā apakškoka, vērtība neeksistē (jo, ja tā eksistētu, tā būtu 200 labajā apakškokā).
Tagad, pieņemsim, ka meklēju 40
- Es sāku ar sakni, kuras atslēga ir 136. Tā kā 136 > 40, es skatos uz mezglu 136 kreiso apakškoku.
- 80 > 40, tādēļ es skatos uz mezglu 80 kreiso apakškoku
- 40= 40, mezgls eksistē. Es iegūstu rindu identifikatoru iekš mezgla (tas nav attēlā) un meklēju tabulā attiecīgo rindu identifikatoru.
- Zinot rindu identifikatoru, varu uzzināt, kur tieši dati atrodas tabulā, un tādējādi varu tos iegūt acumirklī.
Tādējādi abi meklējumi man izmaksās līmeņu skaitu kokā. Ja jūs uzmanīgi izlasīsit daļu par saplūšanas kārtošanu, jūs jāredzat, ka šeit ir log (N) līmeņi. Tātad, meklēšanas izmaksas ir log(N), nav slikti!
Atgriežamies pie mūsu problēmas
Bet tas ir ļoti abstrakti, tādēļ atgriezīsimies pie mūsu problēmas. Tā vietā, lai izmantotu vienkāršu veselo skaitli, iedomājieties virkni, kas pārstāv kāda valsti iepriekšējā tabulā. Pieņemsim, ka jums ir koks, kas satur lauku "country" (3. kolonna) tabulā:
- Ja jūs vēlaties zināt, kas strādā Apvienotajā Karalistē
- jūs skatāties uz koku, lai iegūtu mezglu, kas pārstāv Apvienoto Karalisti
- mezglā "UKnode" jūs atradīsiet darbinieku ierakstu atrašanās vietu Apvienotajā Karalistē.
Šī meklēšana izmaksās log(N) operācijas, nevis N operācijas, ja jūs tieši izmantosiet masīvu. Tas, ko jūs tikko uzrādījāt, bija datubāzes indekss.
Jūs varat izveidot indeksu koku jebkurai lauku grupai (virkne, skaitlis, 2 virknes, skaitlis un virkne, datums...) tik ilgi, kamēr jums ir funkcija, lai salīdzinātu atslēgas (t.i., lauku grupas), lai jūs varētu noteikt kārtību starp atslēgām (kas attiecās uz jebkuriem pamatveidiem datubāzē).
B+KoksIndekss
Lai gan šis koks labi darbojas, lai iegūtu konkrētu vērtību, ir LIELA problēma, kad jums jā iegūst vairāku elementu starp divām vērtībām. Tas izmaksās O(N), jo jums būs jāpārbauda katrs koka mezgls un jāpārbauda, vai tas atrodas starp šīm divām vērtībām (piemēram, ar sakārtotu koka caursišanu). Turklāt šī darbība nav ērta diskā ievadei-izvadei, jo jums būs jāsasaista viss koks. Mums jāatrod veids, kā efektīvi veikt diapazona vaicājumu. Lai atrisinātu šo problēmu, mūsdienu datubāzes izmanto modificētu iepriekš minētā koka versiju, ko sauc par B+Koku. B+Kokā:
- tikai viszemākie mezgli (lapas) uzglabā informāciju (rindas atrašanās vietas saistītajā tabulā)
- pārējie mezgli ir šeit lai maršrutētu uz pareizo mezglu meklēšanas laikā.
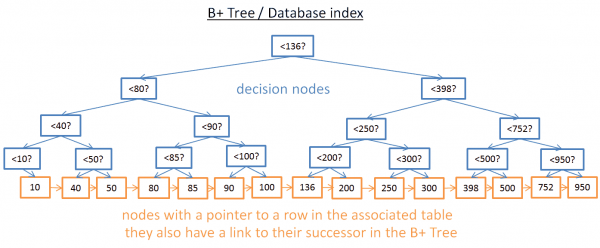
Kā jūs redzat, šeit ir vairāk mezglu (divreiz vairāk). Patiesi, jums ir papildu mezgli, "lēmumu pieņemšanas mezgli", kas palīdzēs jums atrast pareizo mezglu (kuru satur rindas atrašanās vietas saistītajā tabulā). Bet meklēšanas sarežģītība joprojām ir O(log(N)) (ir tikai viens papildu līmenis). Liela atšķirība ir tā, ka apakšējā līmeņa mezgli ir saistīti ar viņu pēctečiem.
Ar šo B+Koku, ja jūs meklējat vērtības no 40 līdz 100:
- Jums vienkārši jāsāk meklēt 40 (vai tuvāko vērtību pēc 40, ja 40 neeksistē), kā to darījāt iepriekšējā kokā.
- Pēc tam savāciet 40 pēctečus, izmantojot tiešās atsauces uz pēctečiem, līdz sasniedzat 100.
Pieņemsim, ka jūs atradāt M pēctečus un kokam ir N mezgli. Konkrēta mezgla meklēšana izmaksā log(N) tāpat kā iepriekšējā kokā. Bet, iegūstot šo mezglu, jūs saņemat M pēctečus M operācijās ar atsaucēm uz viņu pēctečiem. Šī meklēšana izmaksā tikai M+log(N) operācijas salīdzinājumā ar N operācijām ar iepriekšējo koku. Turklāt jums nav jālasa pilns koks (tikai M + log (N) mezgli), kas nozīmē mazāk diska izmantošanas. Ja M ir mazs (piemēram, 200 rindiņas) un N ir liels (1 000 000 rindiņu), tas būs LIELA atšķirība.
Bet te ir jaunas problēmas (atkal!). Ja pievienojat vai izdzēšat rindu datubāzē (un līdz ar to saistītajā B+Tree indeksā):
- jums jānodrošina kārtība starp mezgliem B+Tree kokā, citādi jūs nevarēsiet atrast mezglus nesakārtotā kokā.
- jums jāuztur minimāli iespējamais līmeņu skaits B+Tree, citādi laika sarežģītība O (log (N)) kļūs par O (N).
Citiem vārdiem sakot, B+Tree jābūt pašorganizētam un līdzsvarotam. Par laimi, to ir iespējams izdarīt ar gudrām dzēšanas un ievietošanas operācijām. Bet tas izmaksā dārgi: ievietošana un dzēšana B+ kokā maksā O (log (N)). Tāpēc daži no jums ir dzirdējuši, ka pārmērīga indeksu izmantošana nav īpaši laba ideja. Patiesībā, jūs palēnināt ātru rindu ievietošanu / atjaunināšanu / dzēšanu tabulā, jo datubāzei ir jāatjaunina tabulas indeksi ar dārgu operāciju O (log (N)) katram indeksam. Turklāt indeksu pievienošana nozīmē lielāku slodzi darījumu pārvaldniekam (tiks aprakstīts raksta beigās).
Lai iegūtu plašāku informāciju, varat apskatīt rakstu Vikipēdijā par . Ja vēlaties B+Tree realizācijas piemēru datubāzē, skatiet un no MySQL galvenā izstrādātāja. Abi koncentrējas uz to, kā InnoDB (MySQL dzinējs) apstrādā indeksus.
Piezīme: lasītājs teica man, ka zemu līmeņu optimizāciju dēļ B+ koks jābūt pilnīgi līdzsvarotam.
Hash tabula
Mūsu pēdējā svarīgā datu struktūra ir hash tabula. Tā ir ļoti noderīga, kad vēlaties ātri meklēt vērtības. Turklāt hash tabulas izpratne palīdzēs mums vēlāk saprast kopējo datubāzes apvienošanas operāciju, ko sauc par hash apvienošanu ( hash join). Šī datu struktūra arī tiek izmantota datubāzē, lai glabātu dažas iekšējas lietas (piemēram, bloķēšanas tabula vai bufera baseins, mēs vēlāk redzēsim abas šīs koncepcijas).
Heštabula ir datu struktūra, kas ātri atrod elementu pēc tā atslēgas. Lai izveidotu heštabulu, jums jādara sekojošais:
- atslēga jūsu elementiem
- hešfunkcija atslēgām. Aprēķinātās atslēgu hešvērtības sniedz elementu atrašanās vietu (sauktus par segmentiem ).
- funkcija, lai salīdzinātu atslēgas. Kad esat atradis pareizo segmentu, jums jāatrod elements, kuru meklējat segmentā, izmantojot šo salīdzināšanu.
Vienkāršs piemērs
Apskatīsim vizuālu piemēru:
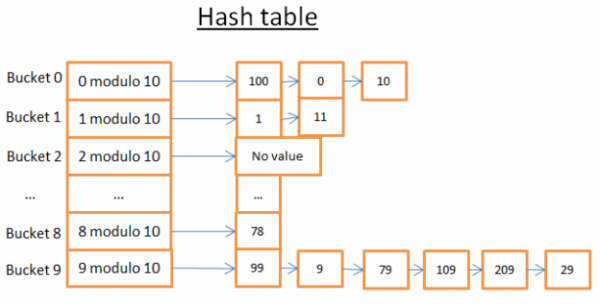
Šai heštabulai ir 10 segmenti. Tā kā es esmu slinks, es esmu attēlojis tikai 5 segmentus, bet zinu, ka jūs esat gudri, tāpēc ļaušu jums iedomāties vēl 5 patstāvīgi. Es izmantoju hešfunkciju ar moduli 10 atslēgai. Citiem vārdiem sakot, es saglabāju tikai elementa atslēgas pēdējo ciparu, lai atrastu tā segmentu:
- ja pēdējais cipars ir 0, elements nonāk segmentā 0,
- ja pēdējais cipars ir 1, elements nonāk segmentā 1,
- ja pēdējais cipars ir 2, elements nonāk segmentā 2,
- …
Salīdzinošā funkcija, ko es izmantoju, ir vienkārša vienādu veselu skaitļu salīdzināšana.
Pieņemsim, ka jūs vēlaties iegūt elementu 78:
- Heštabula aprēķina heškodu 78, kas ir 8.
- Heštabula skatās segmentā 8, un pirmais elements, kuru tā atrod, ir 78.
- T tā jums atgriež elementu 78
- Meklēšana izmaksā tikai 2 operācijas (viena hešfunkcijas vērtības aprēķināšanai un otra elementa meklēšanai segmentā).
Tagad, pieņemsim, ka jūs vēlaties iegūt elementu 59:
- Heštabula aprēķina heškodu 59, kas ir 9.
- Heštabula meklē 9. segmentā, pirmais atrastais elements ir 99. Tā kā 99!=59, 99 elements nav pareizais elements.
- Izmantojot šo pašu loģiku, tiek ņemts otrs elements (9), trešais (79), …, pēdējais (29).
- Elements nav atrasts.
- Meklēšanai bija vajadzīgas 7 operācijas.
Laba hešfunkcija
Kā redzat, atkarībā no meklētās vērtības, izmaksas nav vienādas!
Ja tagad es mainīšu hešfunkciju, izmantojot moduli 1 000 000 no atslēgas (t.i., ņemot pēdējos 6 ciparus), otra meklēšana izmaksās tikai 1 operāciju, jo segmentā 000059 nav elementu. Reālā uzdevums ir atrast labu hešfunkciju, kas veidos segmentus, kas satur ļoti maz elementu..
Manā piemērā būs viegli atrast labu haša funkciju. Bet tas ir vienkāršs piemērs, atrast labu haša funkciju ir grūtāk, kad atslēga:
- virkne (piemēram — uzvārds)
- 2 virknes (piemēram — uzvārds un vārds)
- 2 virknes un datums (piemēram — uzvārds, vārds un dzimšanas datums)
- …
Ar labu haša funkciju meklēšana haša tabulā izmaksā O(1).
Masīvs pret haša tabulu
Kāpēc gan neizmantot masīvu?
Hmm, laba jautājums.
- Haša tabula var būt daļēji ielādēta atmiņā, bet pārējie segmenti var palikt diskā.
- Izmantojot masīvu, jums ir jāizmanto nepārtraukta telpa atmiņā. Ja ielādējat lielu tabulu ļoti grūti atrast pietiekami nepārtrauktu telpu.
- Haša tabulā jūs varat izvēlēties nepieciešamo atslēgu (piemēram, valsti un personas uzvārdu).
Papildu informācijai jūs varat izlasīt rakstu par , kas ir efektīva haša tabulas realizācija; jums nav jāizprot Java, lai saprastu šajā rakstā izklāstītās koncepcijas.
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish