

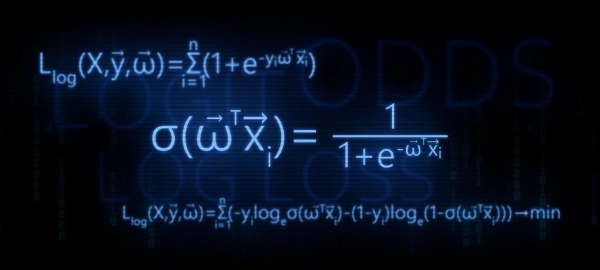
Šajā rakstā mēs apspriedīsim teorētiskos skaitļošanas aspektus lineārās regresijas funkcijas par apgrieztā logit pārvēršanas funkciju (cits to sauc par loģistiskās reakcijas funkciju). Pēc tam, izmantojot maksimālās iespējamības metodi, saskaņā ar loģistiskās regresijas modeli, mēs izstrādāsim zaudējumu funkciju Logistic Loss, citiem vārdiem sakot, mēs noteiksim funkciju, ar kuru loģistiskajā regresijas modelī tiek pielāgoti svaru vektora parametri  .
Raksta plāns:
- Atgādināsim par tiešo atkarību starp divām mainīgajām
- Noskaidrosim nepieciešamību pēc pārvēršanas lineārās regresijas funkcijas
 par loģistiskās reakcijas funkcijas
- Veiksim pārvēršanas un izstrādāsim loģistiskās reakcijas funkcijas
- Mēģināsim saprast, kādēļ vismazāko kvadrātu metode nav piemērota parametru pielāgošanai funkcijas Logistic Loss
- Izmantojam maksimālās iespējamības metode lai noteiktu parametru pielāgošanas funkcijas :
5.1. Gadījums 1: funkcija Logistic Loss klasificējamiem objektiem 0 un 1:
5.2. Gadījums 2: funkcija Logistic Loss klasificējamiem objektiem -1 un +1:
 par loģistiskās reakcijas funkcijas

 funkcijas Logistic Loss
 :


Raksts ir bagāts ar vienkāršiem piemēriem, kuros visus aprēķinus ir viegli veikt mutvārdu vai uz papīra, dažos gadījumos var būt nepieciešama kalkulatora ievietošanās. Tātad, sagatavojieties 🙂
Šis raksts ir galvenokārt paredzēts datu zinātniekiem ar pamatzināšanām par mašīnmācīšanās pamatiem.
Rakstā tiks sniegts arī kods grafiku uzzīmēšanai un aprēķiniem. Visi kodi ir rakstīti valodā python 2.7. Iepriekš paskaidrošu par izmantotās versijas "jaunumu" — tas ir viens no nosacījumiem, lai izietu slaveno kursu no Yandex kādā no pazīstamākajām tiešsaistes izglītības platformām Coursera, un, kā var nojaust, materiāls tika sagatavots, balstoties uz šo kursu.
01. Tiešā atkarība
Ir pilnīgi saprotami uzdot jautājumu — kāda sakara ir tiešajai atkarībai un loģistiskajai regresijai?
Viss ir vienkārši! Loģistiskā regresija ir viens no modeļiem, kas pieder pie lineārā klasifikatora. Vārdiem sakot, lineārā klasifikatora uzdevums ir prognozēt mērķa vērtības  no mainīgajiem (regresoriem)
 . Pieņemot, ka attiecības starp pazīmēm
 un mērķa vērtībām
 ir lineāras. No šejienes, protams, radies klasifikatora nosaukums — lineārs. Ja ļoti rupji vispārināsim, loģistiskās regresijas modeļa pamatā ir pieņēmums par lineārajām attiecībām starp pazīmēm.
 un mērķa vērtībām
 Šeit ir tā — saistība.
Studijā ir pirmais piemērs, un tas, pareizi, ir par tiešu atkarību starp pētītajām vērtībām. Raksta sagatavošanas procesā es uzdūros piemēram, kas daudziem jau ir nogurdinošs — atkarība starp strāvu un spriegumu. («Pielietojamā regresijas analīze», N.Dreiperis, G.Smita). Šeit mēs to arī apsvērsim.
Saskaņā ar Oma likums:
 , kur
 — strāva,
 — spriegums,
 — pretestība.
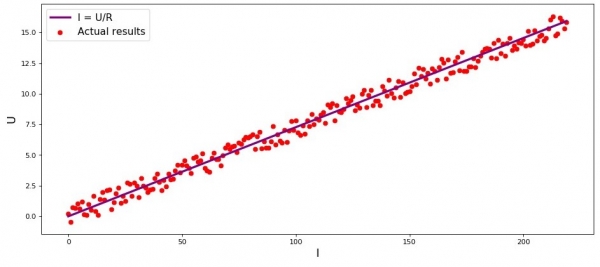
Ja mēs nezinātu Oma likumu, mēs varētu atrast atkarību empīriski, mainot  un mērījot
 , saglabājot
 fiksētu. Tad mēs redzētu, ka atkarības grafiks
 no
 dod vairāk vai mazāk taisnu līniju, kas iet cauri koordinātu sākumam. Mēs teicām «vairāk vai mazāk», jo, lai arī atkarība faktiski ir precīza, mūsu mērījumiem var būt nelielas kļūdas, tāpēc punkti grafikā, iespējams, nesanāks stingri uz līnijas, bet būs izkaisīti ap to gadījuma kārtībā.
Grafiks 1 «Atkarība  no
 »
Grafika uzzīmēšanas kods
import matplotlib.pyplot as plt
%matplotlib inline

import numpy as np

import random

R = 13.75

x_line = np.arange(0,220,1)
y_line = []
for i in x_line:
    y_line.append(i/R)

y_dot = []
for i in y_line:
    y_dot.append(i+random.uniform(-0.9,0.9))


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(x_line,y_line,color = 'purple',lw = 3, label = 'I = U/R')
plt.scatter(x_line,y_dot,color = 'red', label = 'Reālie rezultāti')
plt.xlabel('I', size = 16)
plt.ylabel('U', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
02. Nepieciešamība pārvērst vienādojuma lineāro regresiju
Apskatīsim nākamo piemēru. Pieņemsim, ka strādājam bankā un mums ir uzdevums noteikt aizdevuma atgūšanas iespējamību aizņēmējam atkarībā no dažādiem faktoriem. Lai uzdevumu vienkāršotu, apskatīsim tikai divus faktorus: aizņēmēja mēneša algu un mēneša maksājumu par aizdevuma atmaksu.
Uzdevums ir ļoti nosacīts, bet šajā piemērā mēs varam saprast, kāpēc šī uzdevuma risināšanai nepietiek ar lineārās regresijas funkcijas, kā arī uzzināsim, kādas pārvēršanas ar funkciju ir jāveic.
Atgriežamies pie piemēra. Ir skaidrs, ka jo augstāka ir alga, jo vairāk aizņēmējs varēs mēnesī novirzīt uz kredīta dzēšanu. Tomēr noteiktā algu diapazonā šai atkarībai būs diezgan lineāra forma. Piemēram, ņemsim algu diapazonu no 60.000R līdz 200.000R un pieņemsim, ka šajā diapazonā atkarība starp mēneša maksājumu un algu ir lineāra. Pieņemsim, ka tika noskaidrots, ka attiecība starp algu un maksājumu nedrīkst būt mazāka par 3 un aizņēmējam ir jāpaliek vēl 5.000R. Tikai šajā gadījumā mēs uzskatīsim, ka aizņēmējs atgriezīs kredītu bankā. Tādējādi lineārās regresijas vienādojums ņems šādu formu:

kur  ,
 ,
 ,
 — aizņēmēja alga,
 aizņēmēja maksājums
 — aizņēmēja maksājums.
 Ievietojot vienādojumā algu un kredīta maksājumu ar fiksētām parametru vērtībām
var pieņemt lēmumu par kredīta piešķiršanu vai noraidīšanu.  Pāragri atzīmēsim, ka, ņemot vērā dotos parametrus
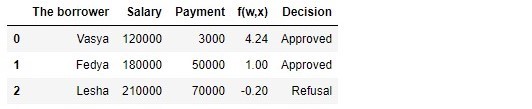
lineārās regresijas funkcija  , kas tiek pielietotaloģistiskās atbildes funkcijā , dos lielas vērtības, kas apgrūtinās kredīta atmaksas varbūtību aprēķinus. Tāpēc tiek piedāvāts samazināt mūsu koeficientus, teiksim, par 25.000 reizēm. No šīs transformācijas koeficientos lēmums par kredīta piešķiršanu nemainīsies. Atcerēsimies šo punktu nākotnē, bet šobrīd, lai būtu vēl skaidrāk, par ko ir runa, aplūkosim situāciju ar trim potenciālajiem aizņēmējiem. Tabula 1 „Potenciālie aizņēmēji”
Kods tabulas veidošanai
import pandas as pdr = 25000.0 w_0 = -5000.0/r w_1 = 1.0/r w_2 = -3.0/rdata = {'Aizņēmējs':np.array(['Vasja', 'Fedja', 'Leša']), 'Alga':np.array([120000,180000,210000]), 'Maksājums':np.array([3000,50000,70000])}df = pd.DataFrame(data)df['f(w,x)'] = w_0 + df['Alga']*w_1 + df['Maksājums']*w_2decision = [] for i in df['f(w,x)']: if i > 0: dec = 'Apstiprināts' decision.append(dec) else: dec = 'Noraidīts' decision.append(dec) df['Lēmums'] = decisiondf[['Aizņēmējs', 'Alga', 'Maksājums', 'f(w,x)', 'Lēmums']]
Atbilstoši tabulas datiem, Vasja ar algu 120.000R vēlas saņemt tādu kredītu, lai ik mēnesi spētu to dzēst ar 3.000R. Mēs esam noteikuši, ka kredīta apstiprināšanai Vasja alga jāpārsniedz trīs reizes maksājuma apmēram, un, lai vēl paliktu 5.000R. Šim nosacījumam Vasja atbilst:{  . Paliek pat 106.000R. Neskatoties uz to, ka mēs aprēķināšanā
 samazinājām koeficientus
 25.000 reizes, rezultāts palika tas pats — kredīts var tikt apstiprināts. Fedja arī saņems kredītu, bet Lešam, neskatoties uz to, ka viņš pelna visvairāk, būs jāsaprot savas vēlmes.
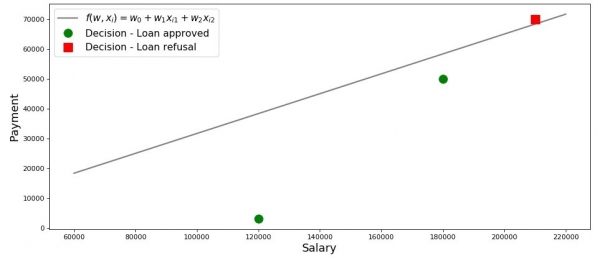
Uzzīmēsim grafiku šādā gadījumā.
Grafiks 2 «Aizņēmēju klasifikācija»
Kods grafika zīmēšanai
salary = np.arange(60000,240000,20000)
payment = (-w_0-w_1*salary)/w_2


fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(salary, payment, color = 'grey', lw = 2, label = '$f(w,x_i)=w_0 + w_1x_{i1} + w_2x_{i2}$')
plt.plot(df[df['Decision'] == 'Approved']['Salary'], df[df['Decision'] == 'Approved']['Payment'],
         'o', color ='green', markersize = 12, label = 'Lēmums - Kredīta apstiprināšana')
plt.plot(df[df['Decision'] == 'Refusal']['Salary'], df[df['Decision'] == 'Refusal']['Payment'],
         's', color = 'red', markersize = 12, label = 'Lēmums - Kredīta atteikšana')
plt.xlabel('Alga', size = 16)
plt.ylabel('Maksājums', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
Tātad, mūsu taisne, uzbūvēta saskaņā ar funkciju  , atdala «sliktos» aizņēmējus no «labajiem». Aizņēmēji, kuru vēlmes nesakrīt ar iespējām, atrodas virs taisnes (Leša), bet tie, kuri spēj atbilstoši mūsu modeļa parametriem atmaksāt kredītu, atrodas zem taisnes (Vasja un Fedja). Citiem vārdiem sakot — mūsu taisne dala aizņēmējus divās klasēs. Apzīmēsim tās šādi: kā klase
 iekļausim tos aizņēmējus, kuri, visticamāk, atgriezīs kredītu, bet kā klase
 vai
 iekļausim tos aizņēmējus, kuri, visticamāk, nespēs atgriezt kredītu.
Generalizēsim secinājumus no šī vienkāršā piemēra. Ņemsim punktu  un, aizvietojot punkta koordinātas attiecīgajā taisnes vienādojumā
 , izskatīsim trīs variantus:
- Ja punkts atrodas zem taisnes, un mēs to attiecinām uz klasi , tad funkcijas vērtība būs pozitīva no līdz . Tātad mēs varam uzskatīt, ka kredīta izpildes varbūtība atrodas robežās . Jo lielāka ir funkcijas vērtība, jo augstāka ir varbūtība.
- Ja punkts atrodas virs taisnes un mēs to attiecinām uz klasi vai , tad funkcijas vērtība būs negatīva no līdz . Tādā gadījumā mēs uzskatīsim, ka parādsaistību izpildes varbūtība atrodas robežās un, jo lielāka ir funkcijas vērtība pēc moduļa, jo lielāka ir mūsu pārliecība.
- Punkts atrodas uz taisnes, uz robežas starp abām klasēm. Šādā gadījumā funkcijas vērtība būs vienāda ar un kredīta izpildes varbūtība ir vienāda ar .
 , tad funkcijas vērtība
 būs pozitīva no
 līdz
 . Tātad mēs varam uzskatīt, ka kredīta izpildes varbūtība atrodas robežās
 . Jo lielāka ir funkcijas vērtība, jo augstāka ir varbūtība.
 vai
 , tad funkcijas vērtība būs negatīva no
 līdz
 . Tādā gadījumā mēs uzskatīsim, ka parādsaistību izpildes varbūtība atrodas robežās
 un, jo lielāka ir funkcijas vērtība pēc moduļa, jo lielāka ir mūsu pārliecība.
 būs vienāda ar
 un kredīta izpildes varbūtība ir vienāda ar
 .
Tagad, iedomāsimies, ka mums nav divu faktoru, bet desmitiem, aizņēmēju nav trīs, bet tūkstošiem. Tad vietā taisnes mums būs m-mēra plakne un koeficienti  mēs ņemsim ne no griestiem, bet izstrādāsim pēc visiem noteikumiem, balstoties uz uzkrātiem datiem par aizņēmējiem, kuri atgrieza vai neatgrieza kredītu. Un patiešām, ievērojiet, šobrīd mēs izvēlamies aizņēmējus, pamatojoties uz jau zināmiem koeficientiem
 . Patiesībā, loģistiskās regresijas modeļa uzdevums ir noteikt parametrus
 , pie kuriem zaudējumu funkcijas vērtība Logistic Loss tiks tendēta uz minimālo. Bet par to, kā tiek aprēķināts vektors
 , mēs vēl uzzināsim 5. nodaļā. Bet pagaidām atgriežamies solītajā zemē — pie mūsu bankiera un trim viņa klientiem.
Pateicoties funkcijai  mēs zinām, kam var dot kredītu, bet kam ir jāatsakās. Bet ar šādu informāciju pie direktora iet nevar, jo mēs gribējām saņemt katra aizņēmēja atgriešanās iespējamību. Ko darīt? Atbilde ir vienkārša — mums ir jāizdara kaut kāda transformācija funkcijai
 , kuras vērtības atrodas diapazonā
 uz funkciju, kuras vērtības būs diapazonā
 . Un tāda funkcija pastāv, to sauc par loģistiskās atbildes funkciju vai apgrieztā-logit transformāciju. Iepazīstieties:

Apskatīsim pa soli, kā iegūst loģistiskās atbildes funkciju. Piezīmēsim, ka mēs dosimies atpakaļ, t.i., mēs pieņemsim, ka zinām varbūtības vērtību, kas atrodas diapazonā no  līdz
 un tālāk mēs "izvēršam" šo vērtību uz visu skaitļu jomu no
 līdz
 .
03. Izvada loģistiskās atbildes funkciju
Step 1. Pārvēršam varbūtību vērtības diapazonā

Transfomācijas funkcijas laikā  par loģistiskās reakcijas funkcijas
 mēs atstās mūsu kredītu analītiķi mierā un tā vietā aplūkosim bukmeikeru kontus. Nē, protams, mēs neskatīsimies uz likmēm, viss, kas mūs tur interesē, ir izteikuma nozīme, piemēram, izredzes 4 pret 1. Izredzes, kas ir pazīstamas visiem, kas veic likmes, ir attiecība starp "panākumiem" un "nepanākumiem". Ievērojot varbūtības, izredzes ir notikuma iestāšanās varbūtība, dalīta ar to, ka notikums nenotiek. Pierakstīsim notikuma iestāšanās izredžu formulu
 :

, kur  — notikuma iestāšanās varbūtība,
 — notikuma NE-iestāšanās varbūtība
Piemēram, ja varbūtība, ka jauns, stiprs un dzīvotspējīgs zirdziņš ar nosaukumu "Vēteris" apsteigs sacensībās veco un vājo vecenīti ar vārdu "Matilda", ir  , tad veiksmes izredzes «Veterka» būs
 uz

 , un, zinot izredzes, nebūs grūti aprēķināt varbūtību
 :

Tādējādi mēs esam iemācījušies «tulkot» varbūtību izredzēs, kas pieņem vērtības no  līdz
 . Veiksim vēl vienu soli un iemācīsimies «tulkot» varbūtību visā skaitļu taisnē no
 līdz
 .
Sol 2. Tulkosim varbūtības vērtības diapazonā

Šis solis ir ļoti vienkāršs – mēs paņemam logaritmu no izredzēm, pamatojoties uz Eilera skaitli  un iegūsim:

Tagad mēs zinām, ka ja  , tad aprēķināt vērtību
 būs ļoti vienkārši un, turklāt, tādai jābūt pozitīvai:
 . Tā tam jābūt.
Savam ziņkārīgumam pārbaudīsim, ka ja  , tad mēs gaidām redzēt negatīvu vērtību
 . Pārbaudām:
 . Viss ir pareizi.
Tagad mēs zinām, kā pārveidot varbūtības vērtību no  līdz
 uz visu skaitļu taisni no
 līdz
 . Nākamajā solī darīsim visu pretēji.
Bet pagaidām, atzīmēsim, ka saskaņā ar logaritmēšanas noteikumiem, zinot funkcijas vērtību  , var aprēķināt izredzes:

Šī metode, kā noteikt izredzes, būs noderīga nākamajā solī.
Sol 3. Izveidosim formulu izredžu noteikšanai

Tātad, mēs esam iemācījušies, zinot  , atrast funkcijas vērtības
 . Tomēr, patiesībā mums nepieciešams viss tieši pretēji – zinot vērtību
 atrast
 . Tādēļ mēs pievērsīsimies tādam konceptam kā izredžu inversā funkcija, saskaņā ar kuru:

Šajā rakstā mēs neizstrādāsim iepriekš minēto formulu, bet pārbaudīsim ar cipariem no iepriekšējā piemēra. Mēs zinām, ka, ja izredzes ir 4 pret 1 ( ), tad notikuma varbūtība ir 0.8 (
 ). Veiksim aizvietojumu:
 . Tas sakrīt ar mūsu iepriekšējiem aprēķiniem. Turpināsim.
Iepriekšējā solī mēs izstrādājām, ka  , tādēļ mēs varam veikt aizvietojumu inversajā izredžu funkcijā. Iegūsim:

Sadalīsim gan skaitītāju, gan saucēju uz  , tad:

Par katru gadījumu, lai pārliecinātos, ka mēs neesam kļūdījušies, veiksim vēl vienu nelielu pārbaudi. 2. solī mēs noteicām, ka  . Tad, aizvietojot vērtību
 loģistiskās reakcijas funkcijā, mēs gaidām, ka iegūsim
 . Aizvietojam un iegūstam:
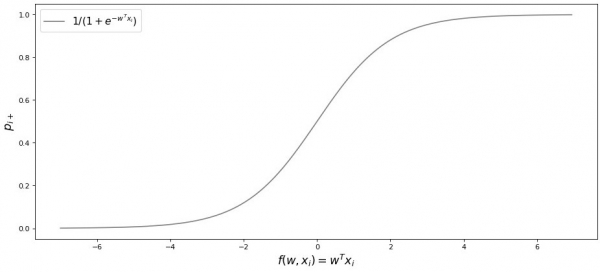
 Apsveicu jūs, cienījamais lasītāj, mēs tikko izstrādājām un pārbaudījām loģistiskās reakcijas funkciju. Apskatīsim funkcijas grafiku.

Grafiks 3 «Loģistiskās reakcijas funkcija»
Grafiks 3 „Loģistiskās atbildes funkcija“
Kods grafika zīmēšanai
import math

def logit (f):
    return 1/(1+math.exp(-f))

f = np.arange(-7,7,0.05)
p = []

for i in f:
    p.append(logit(i))

fig, axes = plt.subplots(figsize = (14,6), dpi = 80)
plt.plot(f, p, color = 'grey', label = '$ 1 / (1+e^{-w^Tx_i})$')
plt.xlabel('$f(w,x_i) = w^Tx_i$', size = 16)
plt.ylabel('$p_{i+}$', size = 16)
plt.legend(prop = {'size': 14})
plt.show()
Literatūrā šo funkciju dažkārt sauc arī par sigmoidālo funkciju. No diagrammas skaidri redzams, ka galvenās izmaiņas objekta piederības klasei varbūtība notiek relatīvi šaurā diapazonā  , aptuveni no
 līdz
 .
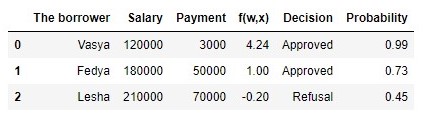
Piedāvāju atgriezties pie mūsu kredītu analītiķa un palīdzēt viņam aprēķināt kredītu atmaksas varbūtību, citādi viņš riskē palikt bez prēmijas 🙂
Tabula 2 "Potenciālie aizņēmēji"
import pandas as pdr = 25000.0 w_0 = -5000.0/r w_1 = 1.0/r w_2 = -3.0/rdata = {'Aizņēmējs':np.array(['Vasja', 'Fedja', 'Leša']), 'Alga':np.array([120000,180000,210000]), 'Maksājums':np.array([3000,50000,70000])}df = pd.DataFrame(data)df['f(w,x)'] = w_0 + df['Alga']*w_1 + df['Maksājums']*w_2decision = [] for i in df['f(w,x)']: if i > 0: dec = 'Apstiprināts' decision.append(dec) else: dec = 'Noraidīts' decision.append(dec) df['Lēmums'] = decisiondf[['Aizņēmējs', 'Alga', 'Maksājums', 'f(w,x)', 'Lēmums']]
proba = []
for i in df['f(w,x)']:
    proba.append(round(logit(i),2))

df['Probability'] = proba

df[['Aizņēmējs', 'Alga', 'Maksājums', 'f(w,x)', 'Lēmums', 'Varbūtība']]
Tātad, mēs esam noteikuši kredīta atgriešanas varbūtību. Kopumā tas izskatās ticami.
Patiesi, varbūtība, ka Vāsa ar 120.000 R algu spēs katru mēnesi atdot bankā 3.000 R, ir tuvu 100%. Starp citu, mums jāizprot, ka banka var izsniegt kredītu arī Lešai, ja bankas politika paredz, piemēram, kredītu izsniegšanu klientiem ar kredīta atgriešanas varbūtību virs 0.3. Vienkārši šādā gadījumā banka veidos lielāku rezervi, lai segtu iespējamos zaudējumus.
Tāpat ir jāatzīmē, ka algas attiecība pret maksājumu nav mazāka par 3 un ar rezervi 5.000 R tika ņemta no gaisa. Tāpēc mēs nevarējām izmantot sākotnējo svaru vektoru  . Mums bija nepieciešams ievērojami samazināt koeficientus, un šajā gadījumā mēs katru koeficientu dalījām ar 25.000, tādējādi, būtībā, mēs pielāgojām rezultātu. Bet tas tika darīts speciāli, lai atvieglotu materiāla sapratni sākumposmā. Reālajā dzīvē, mums nevajadzētu izdomāt un pielāgot koeficientus, bet gan atrast tos. Tieši nākamajās raksta daļās mēs izstrādāsim vienādojumus, ar kuru palīdzību tiek atlasīti parametri
 .
04. Mazāko kvadrātu metode svaru vektora noteikšanā loģistiskā atbildes funkcijā
 loģistiskā atbildes funkcijā
Mums jau ir zināma šāda svaru vektora saskaņošanas metode  , kā mazāko kvadrātu metode (MKM) un kāpēc gan mēs to neizmantotu binārās klasifikācijas uzdevumos? Patiesībā, nekas netraucē to izmantot MKM, tomēr šī pieeja klasifikācijas uzdevumos sniedz mazāk precīzus rezultātus nekā Logistic Loss. Tam ir teorētisks pamatojums. Sāksim ar vienkāršu piemēru.
Pieņemsim, ka mūsu modeļi (izmantojot MSE un Logistic Loss) jau ir uzsākuši svaru vektora meklēšanu  un mēs esam apstādinājuši aprēķinu kādā posmā. Nav svarīgi, vai tā ir vidū, beigās vai sākumā, galvenais ir tas, ka mums jau ir daži svaru vektora vērtības un pieņemsim, ka šajā posmā svaru vektori
 abiem modeļiem nav atšķirību. Tādējādi ņemsim iegūtos svarus un ievietosim tos loģistiskās reakcijas funkcijas (
 ) kādam objektam, kas pieder klasei
 . Izpētīsim divus gadījumus, kad atbilstoši izvēlētajam svaru vektoram mūsu modelis būtiski kļūdās un otrādi – modelis ir ļoti pārliecināts, ka objekts pieder klasei
 . Apskatīsim, kādi sodi tiks "izrakstīti" izmantojot MKM un Logistic Loss.
Kods sodu aprēķināšanai atkarībā no izmantotās zaudējumu funkcijas
# класс объекта
y = 1
# вероятность отнесения объекта к классу в соответствии с параметрами w
proba_1 = 0.01

MSE_1 = (y - proba_1)**2
print 'Штраф MSE при грубой ошибке =', MSE_1

# напишем функцию для вычисления f(w,x) при известной вероятности отнесения объекта к классу +1 (f(w,x)=ln(odds+))
def f_w_x(proba):
    return math.log(proba/(1-proba))

LogLoss_1 = math.log(1+math.exp(-y*f_w_x(proba_1)))
print 'Штраф Log Loss при грубой ошибке =', LogLoss_1

proba_2 = 0.99

MSE_2 = (y - proba_2)**2
LogLoss_2 = math.log(1+math.exp(-y*f_w_x(proba_2)))

print '**************************************************************'
print 'Штраф MSE при сильной уверенности =', MSE_2
print 'Штраф Log Loss при сильной уверенности =', LogLoss_2
Grozījuma kļūdas gadījums – modelis klasificē objektu kā piederīgu klasei  ar varbūtību 0,01
Sods, izmantojot MKM , būs:

Sods, izmantojot Logistic Loss , būs:

Skaidras pārliecības gadījums – modelis klasificē objektu kā piederīgu klasei  ar varbūtību 0,99
Sods, izmantojot MKM , būs:

Sods, izmantojot Logistic Loss , būs:

Šis piemērs labi ilustrē, ka pie rupjām kļūdām zaudējumu funkcija Log Loss soda modeli ievērojami spēcīgāk nekā MSE. Tagad izskatīsim teorētiskās priekšnoteikumu izmantošanas saistībā ar zaudējumu funkciju Log Loss klasifikācijas uzdevumos.
05. Maksimālās varbūtības metode un loģistiskā regresija
Kā tika solīts sākumā, raksts ir bagātināts ar vienkāršiem piemēriem. Studijā jauns piemērs un vecie viesi – bankas aizņēmēji: Vaša, Fēda un Leša.
Pirms attīstām piemēru, atgādināšu, ka reālajā dzīvē mēs saskaramies ar apmācību datu kopu no tūkstošiem vai miljoniem objektu ar desmitiem vai simtiem pazīmju. Tomēr šeit skaitļi ir ņemti tā, lai tie viegli iederētos sākuma datu zinātnieka prātā.
Atgriežamies pie piemēra. Iedomāsimies, ka bankas direktors nolēma izsniegt kredītu visiem, kam tas nepieciešams, neskatoties uz to, ka algoritms ieteica to neizsniegt Lešam. Un tā ir pagājusi pietiekami ilga laika, un mēs uzzinājām, kurš no trim varoņiem atgrieza kredītu, bet kurš ne. Kā arī bija gaidāms: Vasilijs un Fēlijs atgrieza kredītu, bet Leša - nē. Tagad iedomāsimies, ka šis rezultāts būs mums jauna mācību datu izlase, un, pie tam, kā būtu izzuduši visi dati par faktoriem, kas ietekmē kredīta atgriešanas iespēju (aizņēmēja alga, ikmēneša maksājuma apmērs). Tādējādi intuitīvi mēs varam uzskatīt, ka katrs trešais aizņēmējs neatzīst kredītu bankā, vai citiem vārdiem sakot, kredīta atgriešanas varbūtība nākamajam aizņēmējam  . Šim intuitīvajam pieņēmumam ir teorētisks apstiprinājums un tas balstās uz maksimālās varbūtības metodi, ko bieži literatūrā sauc par maksimālās varbūtības principu.
Sāksim ar jēdzienu izpēti.
Paraugu varbūtība — tā ir varbūtība, ka tiek iegūts tieši tāds paraugs, tieši tādi novērojumi / rezultāti, t.i., visu varbūtību reizinājums attiecībā uz katru no parauga rezultātiem (piemēram, kredīts, ko atgriež Vasilijs, Fēlijs un Leša vienlaikus).
Varbūtības funkcija saista parauga varbūtību ar sadalījuma parametru vērtībām.
Mūsu gadījumā mācību izlase ir vispārināta Bernuļa shēma, kurā nejaušā lieluma pieņem tikai divas vērtības:  vai
 . Tāpēc parauga varbūtību var izteikt kā varbūtības funkciju attiecībā uz parametru
 šeit:


Augstāk minētā ieraksta var interpretēt šādi. Kopējā varbūtība, ka Vasilijs un Fēlijs atgriezīs kredītu, ir  , varbūtība, ka Leša NEatgriezīs kredītu, ir
 (jo patiešām norisinājās tieši NEatgriešana), tāpēc visu triju notikumu kopējā varbūtība ir
 .
Maksimālās varbūtības metode — tā ir nezināma parametra novērtēšanas metode, maksimizējot varbūtības funkciju. Mūsu gadījumā ir jāatrod tāda vērtība  , pie kuras
 sasniedz maksimumu.
No no tā ideja – meklēt nezināmā parametra vērtību, pie kuras maksimālizējas varbūtības funkcija? Idejas saknes izriet no uzskata, ka izlase ir vienīgais pieejamais zināšanu avots par populāciju. Viss, ko mēs zinām par populāciju, ir atspoguļots izlasē. Tāpēc viss, ko mēs varam teikt, ir tas, ka izlase ir visprecīzākais populācijas atspoguļojums, kas mums pieejams. Tādējādi mums ir jāatrod tāds parametrs, pie kura esošā izlase kļūst visvarbūtīgāka.
Acīmredzot, mēs saskaramies ar optimizācijas uzdevumu, kurā ir jāatrod funkcijas ekstrema punkts. Lai atrastu ekstrema punktu, ir jāizskata pirmā kārtas nosacījums, proti, jāvienādina funkcijas atvasinājums ar nulli un jāatrisina vienādojums attiecībā uz meklējamo parametru. Tomēr meklējumi, kas saistīti ar atvasinājuma atrašanu daudzu faktoru reizinājuma kontekstā, var būt ilga, tālab, lai to izvairītos, pastāv īpaša pieeja — pāreja pie logaritma. varbūtības funkciju. Kāpēc šāda pāreja ir iespējama? Pievērsīsim uzmanību tam, ka mēs meklējam nevis pašu funkcijas ekstrema. , bet gan ekstrema punktu, proti, to nezināmā parametra vērtību.
 , pie kuras
 kas sasniedz maksimumu. Pārejot pie logaritma, ekstrema punkts nemainās (lai arī pats ekstrema var atšķirties), jo logaritms ir monotoniska funkcija.
Pamatojoties uz iepriekšminēto, turpināsim attīstīt mūsu piemēru ar kredītiem pie Vasi, Fēda un Lejas. Sāksim ar logaritma pāreju uz varbūtības funkciju.:

Tagad mēs varam viegli izdarīt atvasinājumu attiecībā uz  :

Un visbeidzot, apskatīsim pirmā kārtas nosacījumu — vienādīsim funkcijas atvasinājumu ar nulli:

Tādējādi mūsu intuitīvā novērtējuma par kredīta atmaksas varbūtību  bija teorētiski pamatota.
Lieliski, bet ko mums tagad darīt ar šādu informāciju? Ja mēs uzskatīsim, ka katrs trešais aizņēmējs neatdos naudu bankai, tad pēdējais neizbēgami bankrotēs. Tā tas ir, taču, izmantojot kredīta atmaksas varbūtības novērtējumu, kas ir vienāds ar  Mēs neesam ņēmuši vērā faktorus, kas ietekmē kredīta atmaksu: aizņēmēja alga un ikmēneša maksājuma apmērs. Atcerēsimies, ka iepriekš mēs aprēķinājām katra klienta kredīta atmaksas varbūtību, ņemot vērā šos faktorus. Ir loģiski, ka mūsu varbūtības izgaismojas savādāk nekā konstanta vērtība,
 .
Definēsim paraugļu ticamību:
Kods paraugļu ticamības aprēķiniem
from functools import reduce

def likelihood(y,p):
    line_true_proba = []
    for i in range(len(y)):
        ltp_i = p[i]**y[i]*(1-p[i])**(1-y[i])
        line_true_proba.append(ltp_i)
    likelihood = []
    return reduce(lambda a, b: a*b, line_true_proba)


y = [1.0,1.0,0.0]
p_log_response = df['Probability']
const = 2.0/3.0
p_const = [const, const, const]


print 'Parauga ticamība pie konstanta p=2/3:', round(likelihood(y,p_const),3)

print '****************************************************************************************************'

print 'Parauga ticamība pie aprēķināta p vērtības:', round(likelihood(y,p_log_response),3)
Parauga ticamība pie konstanta vērtības  :

Parauga ticamība, aprēķinot kredīta atmaksas varbūtību, ņemot vērā faktorus  :


Parauga ticamība ar varbūtību, kas aprēķināta atbilstoši faktoriem, izrādījās augstāka nekā ticamība pie konstantas varbūtības vērtības. Ko tas nozīmē? Tas nozīmē, ka zināšanas par faktoriem ļāva precīzāk noteikt kredīta atmaksas varbūtību katram klientam. Tāpēc, izsniedzot nākamo kredītu, pareizāk būtu izmantot modeli, kas piedāvāts 3. nodaļas beigās, lai novērtētu parādsaistību atmaksas varbūtību.
Bet tad, ja mums ir jāmaksimizē parauga ticamības funkcija, tad kāpēc neizmantot kādu algoritmu, kas dos varbūtības Vasijai, Fedijai un Lešai, piemēram, 0.99, 0.99 un 0.01 attiecīgi. Iespējams, šāds algoritms labi rādīs rezultātus mācību paraugā, jo tuvinās parauga ticamības vērtību.  , bet, vispirms, šādam algoritmam, visticamāk, būtu grūtības ar vispārināšanas spēju, otrkārt, šis algoritms noteikti nebūs lineārs. Un, ja metodes, kā cīnīties ar pārmācīšanos (t.i., vāja vispārināšanas spēja) acīmredzami nav šī raksta plānā, tad par otro punktu ļaujiet mums runāt sīkāk. Tam ir pietiekami atbildēt uz vienkāršu jautājumu. Vai varbūtība, ka kredītu atmaksās Vasiņš un Fēliks, var būt vienāda ņemot vērā mums zināmos faktorus? Veselā saprāta skatījumā, protams, nē, tas nav iespējams. Tātad kredīta atmaksai Vasiņš mēnesī atdos 2.5% no savas algas, bet Fēliks — gandrīz 27,8%. Arī 2. grafikā “Klientu klasifikācija” mēs redzam, ka Vasiņš ir ievērojami tālāk no līnijas, kas šķir klasus, nekā Fēliks. Un visbeidzot, mēs zinām, ka funkcija
 Vasiņam un Fēlikam pieņem dažādas vērtības: 4.24 Vasiņam un 1.0 Fēlikam. Ja, piemēram, Fēliks pelnītu daudz vairāk vai lūgtu mazāku kredītu, tad kredīta atmaksāšanas varbūtības Vasiņam un Fēlikam būtu līdzīgas. Citiem vārdiem sakot, lineāro atkarību nevar apmānīt. Un, ja mēs tiešām aprēķinātu koeficientus
 , nevis ņemtu tos no gaisa, tad varētu droši apgalvot, ka mūsu vērtības
 vislabāk novērtē kredīta atmaksāšanas varbūtību katram aizņēmējam, taču, tā kā mēs vienojāmies uzskatīt, ka koeficientu noteikšana
 tika veikta saskaņā ar visām prasībām, tad mēs tā arī uzskatīsim — mūsu koeficienti ļauj sniegt labāku novērtējumu par varbūtību 🙂
Tomēr mēs novirzījāmies no tēmas. Šajā nodaļā mums jāizpēta, kā tiek noteikts svaru vektors  , kas nepieciešams, lai novērtētu katra aizņēmēja kredīta atgriešanas varbūtību.
Īsi rezumējot, ar kādu arsenālu mēs dodamies meklēt koeficientus  :
1. Mēs pieņemam, ka atkarība starp mērķa mainīgo (prognozējamā vērtība) un faktoru, kas ietekmē rezultātu, ir lineāra. Šī iemesla dēļ tiek izmantots , kas tiek pielietota veids  , kuras līnija dalīja objektus (klientus) klasēs
 un
 vai
 (klienti, kas spēj atmaksāt kredītu, un ne spēj). Mūsu gadījumā vienādojumam ir šāda forma
 .
2. Mēs izmantojam atgriezeniskās logita transformācijas funkciju veids  lai noteiktu varbūtību, ka objekts pieder pie klases
 .
3. Mēs apsveram mūsu mācību paraugu kā ģeneralizētā Bernoulli shēmas, tas ir, katram objektam tiek ģenerēta nejauša mainīgā lieluma vērtība, kura ar iespējamību  (katram objektam tā ir sava) pieņem vērtību 1 un ar iespējamību
 – 0.
4. Mēs zinām, ka mums ir jāmaksimizē parauga ticamības funkcija ņemot vērā pieņemtos faktorus, lai esošā izlase būtu vispārliecinošākā. Citiem vārdiem sakot, mums jāizvēlas tādi parametri, pie kuriem izlase būs vispārliecinošākā. Mūsu gadījumā izvēlētais parameters ir kredīta dzēšanas iespējamība  , kas savukārt ir atkarīga no nezināmiem koeficientiem
 . Tādējādi mums ir jāatrod tāds svaru vektors
 , pie kā izlases iespējamība būs maksimāla.
5. Mēs zinām, ka, lai maksimizētu izlases iespējamības funkciju var izmantot maksimālās iespējamības metode. Un mēs zinām visus gudros paņēmienus, kā strādāt ar šo metodi.
Tāda daudzsolīga situācija sanāk 🙂
Un tagad atcerēsimies, ka raksta sākumā mēs vēlējāmies izvest divus zaudējumu funkciju veidus Logistic Loss atkarībā no tā, kā tiek apzīmēti objektu klasīši. Ir ierasts, ka klasifikācijas uzdevumos ar divām klasēm, klases tiek apzīmētas kā  un
 vai
 . Atkarībā no apzīmējuma, izejā būs atbilstošā zaudējumu funkcija.
Gadījums 1. Objektu klasifikācija uz un
 un

Iepriekš, nosakot izlases iespējamību, kurā kredīta dzēšanas iespējamība tika aprēķināta, pamatojoties uz faktoriem un dotajiem koeficientiem  , mēs izmantojām formulu:

Patiesībā  — tā ir loģistiskās atbildes funkcijas vērtība
 dotajā svaru vektorā

Tad nekas mūs neattur reģistrēt izlases iespējamības funkciju šādi:

Ir gadījumi, kad dažiem jaunajiem analītiķiem ir grūti uzreiz saprast, kā šī funkcija darbojas. Apskatīsim 4 īsus piemērus, kas viss izskaidros:
1. Ja  (t.i., atbilstoši mācību izlasei objekts pieder klasei +1), un mūsu algoritms
 nosaka objekta piederības iespējamību klasei
 kas ir 0.9, tad šī izlases iespējamības daļa tiks aprēķināta šādi:

2. Ja  , bet
 , tad aprēķins būs šāds:

3. Ja  , bet
 , tad aprēķins būs šāds:

4. Ja  , bet
 , tad aprēķins būs šāds:

Acīmredzot izlases iespējamības funkcija tiks maksimizēta gadījumos 1 un 3 vai vispārīgā gadījumā — pie pareizi uzminētām objekta piederības iespējamībām klasei  .
Tā kā pie iespējamības noteikšanas, ka objekts pieder klasei  mums nav zināmi tikai koeficienti
 , tāpēc mēs tos arī meklēsim. Kā tika minēts iepriekš, tas ir optimizācijas uzdevums, kuram vispirms mums ir nepieciešams atrast funkcijas ticamības atvasinājumu pēc svaru vektora
 . Tomēr pirms tam ir jēga atvieglot uzdevumu: atvasinājumu meklēsim no logaritma varbūtības funkciju.

Kāpēc pēc logaritmēšanas, loģistiskās kļūdas funkcijā, mēs nomainījām zīmi uz  uz
 . Viss ir vienkārši, jo modeļa kvalitātes novērtēšanas uzdevumos parasti tiek minimizēta funkcijas vērtība, tāpēc mēs reizinājām izteiksmes labo pusi ar
 un attiecīgi, tagad mēs minimizējam funkciju, nevis maksimizējam.
Faktiski, šobrīd, priekšā jūsu acīm, tika ilgstoši izveidota zaudējumu funkcija — Logistic Loss mācību datu kopa ar divām klasēm:  un
 .
Tagad, lai atrastu koeficientus, mums tikai jāatrod atvasinājums loģistiskās kļūdas funkcijā un pēc tam, izmantojot skaitliskās optimizācijas metodes, piemēram, gradienta nolaišanos vai stohastisko gradienta nolaišanos, jāizvēlas visoptimālākie koeficienti  . Taču ņemot vērā, ka raksts jau ir samērā garš, tiek ieteikts veikt diferencēšanu pašam vai varbūt tas būs nākamā raksta tēma ar daudz matemātikas un bez tik detalizētiem piemēriem.
Gadījums 2. Objektu klasifikācija un
 un

Pieeja būs tāda pati kā ar klasēm  un
 , bet pati ceļš uz zaudējumu funkcijas izrēķināšanu Logistic Loss, būs sarežģītāks. Sāksim. Mēs izmantosim operatoru „ja..., tad...”. Proti, ja
 -ais objekts pieder klasei
 , tad, lai aprēķinātu izlases ticamību, izmantojam varbūtību
 , ja objekts pieder klasei
 , tad ticamībā ievietojam
 . Šādi izskatās ticamības funkcija:

Ieskicēsim, kā tas darbojas. Apskatīsim 4 gadījumus:
1. Ja  un
 , tad ticamības izlasei „nāks”

2. Ja  un
 , tad ticamības izlasei „nāks”

3. Ja  un
 , tad ticamības izlasei „nāks”

4. Ja  un
 , tad ticamības izlasei „nāks”

Acīmredzami, ka 1. un 3. gadījumā, kad varbūtības tika pareizi noteiktas ar algoritmu, ticamības funkcija tiks maksimizēta, tātad tieši to mēs vēlējāmies iegūt. Tomēr šāda pieeja ir diezgan smagnēja un tālāk mēs izskatīsim kompaktāku pierakstu. Bet sākumā, logaritmēsim ticamības funkciju, aizvietojot zīmi, jo tagad mēs to minimizēsim.

Ievietosim vietā  izteiksmi
 :

Vienkāršosim logaritma labo papildinājumu, izmantojot vienkāršas aritmētiskas metodes, un iegūsim:

Tagad ir pienācis laiks atbrīvoties no operators „ja..., tad...”. Pamanām, ka, kad objekts  pieder klasei
 , tad izteiksmē zem logaritma, saucējā,
 tiek paaugstināts pakāpē
 , ja objekts pieder klasei
 , tad $e$ tiek paaugstināts pakāpē
 . Tādējādi pakāpes ierakstu var vienkāršot — apvienojot abus gadījumus vienā:
 . Tādējādi loģistiskās kļūdas funkcija iegūst šādu formu:

Saskaņā ar logaritmēšanas noteikumiem, apgriezīsim daļu un iznesīsim zīmi " " (mīnuss) ārā no logaritma, iegūstot:

Jums priekšā ir zaudējumu funkcija logistic Loss, kas tiek pielietota mācību paraugā ar objektiem, kas pieder klasēm:  un
 .
Nu, šajā brīdī es atvados un mēs noslēdzam rakstu.
Iepriekšējais autora darbs — "Pārvēršam lineārās regresijas vienādojumu matricas formā"
Palīgmateriāli
1. Literatūra
1) Lietišķā regresijas analīze / N. Dreiperis, G. Smits – 2. izdevums – M.: Finanses un statistika, 1986 (tulkojums no angļu valodas)
2) Iespēju teorija un matemātiskā statistika / V.E. Gmurmans — 9. izdevums — M.: Augstskola, 2003
3) Iespēju teorija / N.I. Černova — Novosibirska: Novosibirskas valsts universitāte, 2007
4) Biznesa analītika: no datiem uz zināšanām / Paklins N. B., Orekhovs V. I. — 2. izdevums — Sanktpēterburga: Piter, 2013
5) Data Science – Datu zinātne no nulles / Džoels Grāss — Sanktpēterburga: BHV Pēterburga, 2017
6) Praktiskā statistika datu zinātniekiem / P. Brūss, E. Brūss — Sanktpēterburga: BHV Pēterburga, 2018
2. Lekcijas, kursi (video)
1)
2)
3)
4)
5)
3. Interneta avoti
1)
2)
3)
4)
5)
6)
7)
8)
Avots: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 Finnish
 French
 Hungarian
 Latvian
 Lithuanian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish