

Google heeft de code van het Magika-project geopend, dat bedoeld is voor het bepalen van het type inhoud op basis van analyse van de beschikbare gegevens in een bestand. Magika kan nauwkeurig de programmeertalen, compressiemethoden, installatiepakketten, uitvoerbare codes, soorten markup, geluids-, video-, document- en afbeeldingsformaten in de inhoud identificeren. De bij het project behorende toolkit en het vooraf gebouwde machine learning-model zijn gepubliceerd onder de Apache 2.0-licentie.
In tegenstelling tot vergelijkbare projecten die de MIME-type op basis van inhoud bepalen, onderscheidt Magika zich door het gebruik van machine learning-methoden, hoge prestaties en uitstekende precisie in identificatie. Het model is getraind met behulp van het Keras-framework op 25 miljoen bestandsvoorbeelden en ondersteunt de herkenning van 116 datatypes met een precisie van ten minste 99%. Het model is gecompileerd in het ONNX-formaat en heeft een grootte van slechts 1 MB. Het toepassen van diepgaande machine learning-methoden heeft de precisie van de identificatie met 50% verhoogd in vergelijking met het eerder door Google gebruikte systeem op basis van handmatig ingestelde regels.
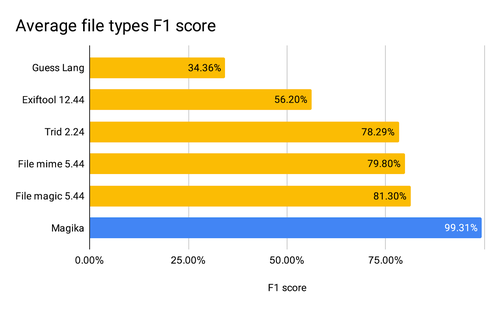
Binnen Google wordt het systeem gebruikt voor het classificeren van bestanden in de diensten Gmail, Drive, Code Insight en Safe Browsing tijdens het uitvoeren van veiligheidscontroles en naleving van de servicerichtlijnen. Er wordt gewerkt aan de integratie van Magika in het VirusTotal-platform als een schakel voor de eerste filtering van bestanden voordat specifieke analizers worden uitgevoerd. De in de Google-infrastructuur uitgerolde configuratie van Magika zorgt voor het scannen van enkele miljoenen bestanden per seconde en enkele honderden miljarden bestanden per week. Na het uploaden van het model bedraagt de tijd voor outputgeneratie 5-6 ms bij testen op één CPU-kern. De identificatietijd is bijna onafhankelijk van de bestandsgrootte.
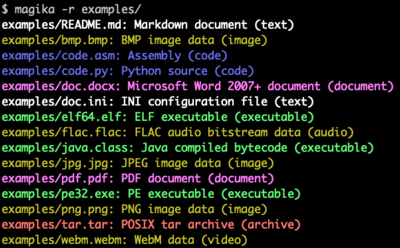
Voor de inzet van Magika in hun projecten zijn er een commandoregeltool, een pakket voor Python en een JavaScript-bibliotheek voorbereid die kan functioneren in een browser of in Node.js-gebaseerde projecten. De commandoregelinterface en API ondersteunen batchverwerkingen, wat betekent dat het mogelijk is om meerdere bestanden per aanvraag te controleren. Er is een modus voor het recursief scannen van de volledige inhoud van een map en drie prognosemodi voor het aanpassen van de fouttolerantie (hoge zekerheid, gemiddelde zekerheid en beste gok).
Bron: opennet.ru
