

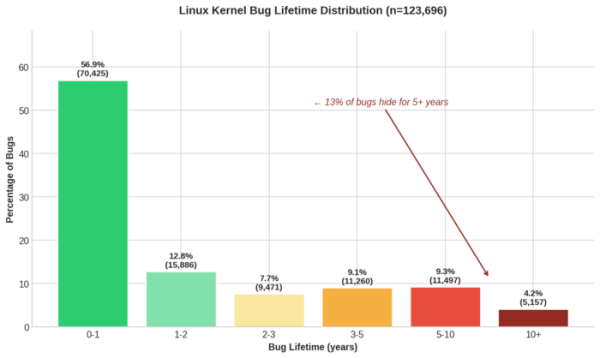
De resultaten van het onderzoek naar de tijd voor het ontdekken en oplossen van fouten in de Linux-kernel zijn gepubliceerd. De gegevens zijn verkregen door het analyseren van 125.000 fouten, gemarkeerd in de Git-repository met de tag "Fixes:", die verwijst naar de commit waar de fout is ontstaan. De gemiddelde tijd om fouten in de kernel te ontdekken was 2,1 jaar. Wanneer we alleen kijken naar de fouten die in 2025 zijn opgelost, was deze waarde 2,8 jaar.
30% van de fouten werd opgelost door dezelfde ontwikkelaars die de fouten hebben veroorzaakt. 56,9% van de fouten wordt binnen een jaar opgelost. 13,5% van de fouten bleef meer dan 5 jaar onopgemerkt (voor fouten die alleen in 2025 zijn opgelost is dit 19,4%). Vanwege de ongelijke verdeling van fouten was de mediaan tijd voor het bestaan van een fout in de kernelcode 8 maanden voor de steekproef van 2005 en 1 jaar voor de fouten die in 2025 zijn opgelost. De fout die het langst in de code aanwezig was, was een buffer overflow in ethtool, die na 20,7 jaar werd opgelost.
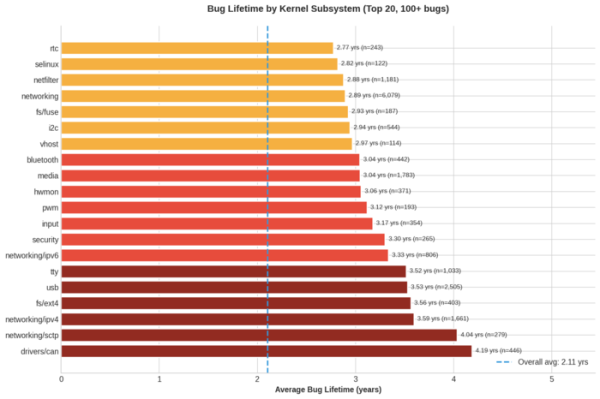
De dynamiek van het ontdekken van fouten verschilt aanzienlijk van het gemiddelde voor bepaalde subsysteem, bijvoorbeeld in de CAN-busd driver en de SCTP-stack duurt het gemiddeld zo'n 4 jaar om problemen te identificeren, in de IPv4-stack is dat 3,6 jaar, USB en TTY - 3,5, Netfilter en de netwerkstack - 2,9, VM - 1,8, GPU - 1,4, BPF - 1,1 jaar.
De tijd voor ontdekking correleert met de soorten fouten: de gemiddelde tijd voor het ontdekken van fouten gerelateerd aan racecondities was 5,1 jaar, integer overflow - 3,9, gebruik na vrijgave van geheugen - 3,2, buffer overflow en geheugenlek - 3,1, referentietelling - 2,8, dereferencen van een null pointer en deadlocks - 2,2 jaar.
In de verkregen statistieken is ook de invloed te zien van de invoering van nieuwe tools voor het automatisch opsporen van fouten, statische analyse en code-testing, zoals Syzkaller, KASAN, KMSAN en KCSAN. Bijvoorbeeld, in 2010 werden er geen foutoplossingen vastgelegd die binnen een jaar waren gevonden. In 2014 werd 31% van de fouten binnen een jaar ontdekt, in 2018 was dit 54%, en in 2022 zelfs 69% van de fouten.
De verkregen statistieken zijn gebruikt voor het creëren van het machine learning-model VulnBERT, dat in staat is om het voorkomen van kwetsbaarheden in commits te voorspellen. Bij het testen op commits van 2024 was de nauwkeurigheid van het detecteren van fouten 92,2% bij een valse positieven rate van 1,2% (ter vergelijking, het eerder beschikbare model CodeBERT vond 89,2% van de problemen bij een valse positieven rate van 48,1%).
Bron: opennet.ru
