

In het kader van het Qwenputer-project hebben onderzoekers een uitgebreide versie van het AI-model Qwen3.5-4B ontwikkeld, waarin een geïntegreerde simulator van een volledige 32-bits CPU op basis van de RISC-V-architectuur (RV32IM) is geïmplementeerd. Deze simulator ondersteunt de Zba-extensie en is uitgerust met een bignum-coprocessor voor wiskundige bewerkingen met grote getallen. De implementatie van de CPU-kern is geconsolideerd in een gewichtenpakket en geïntegreerd in een groter taalmodel met 11 extra transformerlagen die vóór de belangrijkste lagen van Qwen zijn toegevoegd. De berekeningen worden rechtstreeks uitgevoerd tijdens de vooruitgangsprocedure (forward pass) van het neuraal netwerk, zonder externe tools of plugins te gebruiken.
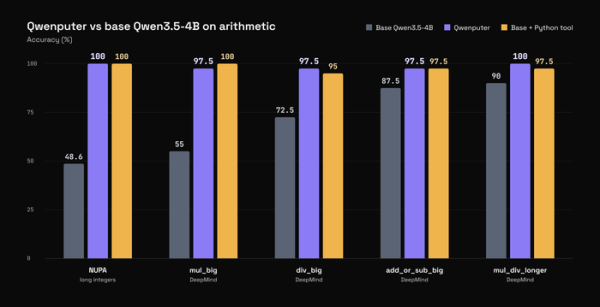
De implementatie slaagt met succes in alle tests van de officiële riscv-tests en kan gecompileerde code uitvoeren in C en MicroPython. Bij het uitvoeren van wiskundige berekeningen met grote getallen biedt Qwenputer een nauwkeurigheid van 97,5-100%, wat vergelijkbaar is met of zelfs beter is dan de basisversie van het Qwen3.5-model met een externe Python-interpreter.
Voor de simulatie van het werkgeheugen binnen het model worden aparte lagen Gated DeltaNet (lineaire RNN) gebruikt, die ook in het standaard AI-model Qwen worden toegepast om de gewijzigde staat vast te houden bij het werken met grote contextvensters. Door de toestand van de poort vast te leggen en een one-hot codering toe te passen, overschrijft elke schrijfopdracht exact één regel van de statusmatrix, waardoor DeltaNet als adresseerbaar geheugen met een vaste grootte kan worden gebruikt, waarbij lineaire groei van de KV-cache (Key-Value) bij toenemende contextlengte wordt vermeden. In dit type geheugen worden de CPU-registers, gegevens en de uitgevoerde machinetaalcode opgeslagen.
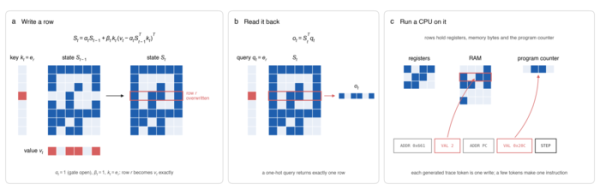
De processorinstructies, zoals het lezen van registers, wiskundige bewerkingen en voorwaardelijke sprongen, worden rechtstreeks in de gewichten van de transformerlagen gecompileerd. Aan elke instructie zijn speciale tokens (ADDR, VAL, STEP) gekoppeld, die door de AI-modellagen als de logica van de CPU worden geïnterpreteerd. Voor de initialisatie van de CPU en het laden van de firmware wordt een kleine externe driver RvChat gebruikt, maar de machinetaalcode wordt volledig intern binnen de gewichten van het model verwerkt.
De projectbeperkingen vermelden een ongeveer tweevoudige toename in grootte (18,8 GB) vergeleken met het oorspronkelijke Qwen-model bij het opslaan van status-slices (checkpoint), voornamelijk als gevolg van de extra lagen. Ook wordt een relatief lage rekensnelheid opgemerkt (ongeveer 3200 tokens per seconde op GPU L4), waardoor complexe berekeningen seconden in plaats van milliseconden kunnen duren.
Daarnaast is er een variant van het AI-model geïmplementeerd met een experimenteel bestandssysteem, dat in staat is om tot 512 bestanden met 53.000 tokens tekst binnen de gewichten van het AI-model te bewaren. Net als bij de implementatie van het RAM is de opslag georganiseerd in relatie tot DeltaNet-states, maar het verschilt doordat het bestandssysteem permanente opslag biedt, die de status tussen sessies niet verliest.
De ontwikkelingen van Qwenputer zijn ook de basis geworden van een onderzoek naar nieuwe potentiële beveiligingsproblemen in AI. Aan de hand van Qwenputer wordt aangetoond hoe een speciaal gemodificeerd AI-model zijn redeneringen kan verbergen in een RNN-status en de monitoringmechanismen van de modelredeneringen (CoT, Chain-of-Thought) kan omzeilen. Dit is ook gedemonstreerd.
de mogelijkheid om controle- en monitoringmechanismen voor beveiliging te creëren, ingebouwd in de gewichten van het AI-model, die zelf niet door het model kunnen worden uitgeschakeld of gewijzigd.
Bron: opennet.ru
