

Hallo, Habr!
In het najaar van vorig jaar vond er op Kaggle een wedstrijd plaats voor de classificatie van handgetekende afbeeldingen in Quick Draw Doodle Recognition, waaraan onder anderen een team van R-gebruikers deelnam bestaande uit , en . We zullen de wedstrijd niet uitgebreid beschrijven, dat is al gedaan in een .
. Het lukte deze keer niet om medailles te winnen, maar er is veel waardevolle ervaring opgedaan, daarom willen we het gemeenschappen hebben over enkele van de meest interessante en nuttige zaken op Kaggle en in dagelijks werk. Onder de besproken onderwerpen: het moeilijke leven zonder OpenCV, JSON-parsering (in deze voorbeelden worden de integraties van C++-code in scripts of pakketten op R via Rcpp), parameterisatie van scripts en dockerisatie van de uiteindelijke oplossing. De volledige code uit het bericht is beschikbaar in een uitvoerbare vorm in .
Inhoud:
1. Efficiënte gegevensladen van CSV naar de MonetDB-database
De gegevens in deze wedstrijd worden niet geleverd als kant-en-klare afbeeldingen, maar als 340 CSV-bestanden (één bestand per klasse), die JSON's met coördinaten voor de punten bevatten. Door deze punten met lijnen te verbinden, krijgen we de uiteindelijke afbeelding van 256x256 pixels. Voor elke opname wordt ook een label gegeven of de afbeelding correct werd herkend door de classificator die op het moment van het verzamelen van de dataset werd gebruikt, een tweecijferige landcode van de woonplaats van de auteur van de tekening, een unieke identificator, een tijdstempel en de klassennaam die overeenkomt met de bestandsnaam. De vereenvoudigde versie van de oorspronkelijke gegevens weegt 7,4 GB in archief en ongeveer 20 GB na decompressie, de volledige gegevens bij decompressie nemen 240 GB in beslag. De organisatoren hebben gegarandeerd dat beide versies dezelfde tekeningen reproduceren, wat betekent dat de volledige versie overbodig is. In ieder geval werd het opslaan van 50 miljoen afbeeldingen in grafische bestanden of in de vorm van arrays onmiddellijk als onrendabel beschouwd, en we besloten om alle CSV-bestanden uit het archief train_simplified.zip in een database te laden met daaropvolgende generatie van afbeeldingen van de juiste grootte 'on the fly' voor elke batch.
Als database is gekozen voor een goed presterende MonetDB, namelijk de implementatie voor R in de vorm van een pakket . Het pakket bevat een embedded versie van de database server en stelt ons in staat om de server direct vanuit de R-sessie op te starten en ermee te werken. Het aanmaken van een database en het verbinden daarmee kan met één commando:
con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))We moeten twee tabellen aanmaken: één voor alle gegevens en een andere voor de metadata van de geüploade bestanden (handig als er iets misgaat en we het proces moeten hervatten na het uploaden van enkele bestanden):
Tabellen aanmaken
if (!DBI::dbExistsTable(con, "doodles")) {
  DBI::dbCreateTable(
    con = con,
    name = "doodles",
    fields = c(
      "countrycode" = "char(2)",
      "drawing" = "text",
      "key_id" = "bigint",
      "recognized" = "bool",
      "timestamp" = "timestamp",
      "word" = "text"
    )
  )
}

if (!DBI::dbExistsTable(con, "upload_log")) {
  DBI::dbCreateTable(
    con = con,
    name = "upload_log",
    fields = c(
      "id" = "serial",
      "file_name" = "text UNIQUE",
      "uploaded" = "bool DEFAULT false"
    )
  )
}
De snelste manier om gegevens in de database te uploaden bleek de directe kopie van CSV-bestanden via SQL te zijn — de opdracht COPY OFFSET 2 INTO tablename FROM path USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT, waar tablename — de naam van de tabel en path — het pad naar het bestand. Tijdens het werken met het archief bleek dat de ingebouwde implementatie unzip in R niet correct werkt met een aantal bestanden uit het archief, dus hebben we het systeem gebruikt unzip (met de parameter getOption("unzip")).
De functie voor het schrijven naar de database
#' @title Извлечение и загрузка файлов
#'
#' @description
#' Извлечение CSV-файлов из ZIP-архива и загрузка их в базу данных
#'
#' @param con Объект подключения к базе данных (класс `MonetDBEmbeddedConnection`).
#' @param tablename Название таблицы в базе данных.
#' @oaram zipfile Путь к ZIP-архиву.
#' @oaram filename Имя файла внури ZIP-архива.
#' @param preprocess Функция предобработки, которая будет применена извлечённому файлу.
#'   Должна принимать один аргумент `data` (объект `data.table`).
#'
#' @return `TRUE`.
#'
upload_file <- function(con, tablename, zipfile, filename, preprocess = NULL) {
  # Проверка аргументов
  checkmate::assert_class(con, "MonetDBEmbeddedConnection")
  checkmate::assert_string(tablename)
  checkmate::assert_string(filename)
  checkmate::assert_true(DBI::dbExistsTable(con, tablename))
  checkmate::assert_file_exists(zipfile, access = "r", extension = "zip")
  checkmate::assert_function(preprocess, args = c("data"), null.ok = TRUE)

  # Извлечение файла
  path <- file.path(tempdir(), filename)
  unzip(zipfile, files = filename, exdir = tempdir(),
        junkpaths = TRUE, unzip = getOption("unzip"))
  on.exit(unlink(file.path(path)))

  # Применяем функция предобработки
  if (!is.null(preprocess)) {
    .data <- data.table::fread(file = path)
    .data <- preprocess(data = .data)
    data.table::fwrite(x = .data, file = path, append = FALSE)
    rm(.data)
  }

  # Запрос к БД на импорт CSV
  sql <- sprintf(
    "COPY OFFSET 2 INTO %s FROM '%s' USING DELIMITERS ',','n','"' NULL AS '' BEST EFFORT",
    tablename, path
  )
  # Выполнение запроса к БД
  DBI::dbExecute(con, sql)

  # Добавление записи об успешной загрузке в служебную таблицу
  DBI::dbExecute(con, sprintf("INSERT INTO upload_log(file_name, uploaded) VALUES('%s', true)",
                              filename))

  return(invisible(TRUE))
}
Als het nodig is om de tabel voor het schrijven naar de database om te zetten, volstaat het om de functie door te geven in de argument preprocess die de gegevens zal transformeren.
Code voor het sequentieel uploaden van gegevens naar de database:
Gegevens schrijven naar de database
# Список файлов для записи
files <- unzip(zipfile, list = TRUE)$Name

# Список исключений, если часть файлов уже была загружена
to_skip <- DBI::dbGetQuery(con, "SELECT file_name FROM upload_log")[[1L]]
files <- setdiff(files, to_skip)

if (length(files) > 0L) {
  # Запускаем таймер
  tictoc::tic()
  # Прогресс бар
  pb <- txtProgressBar(min = 0L, max = length(files), style = 3)
  for (i in seq_along(files)) {
    upload_file(con = con, tablename = "doodles",
                zipfile = zipfile, filename = files[i])
    setTxtProgressBar(pb, i)
  }
  close(pb)
  # Останавливаем таймер
  tictoc::toc()
}

# 526.141 sec elapsed - копирование SSD->SSD
# 558.879 sec elapsed - копирование USB->SSD
De tijd voor het uploaden van gegevens kan variëren afhankelijk van de snelheid van de gebruikte opslag. In ons geval duurt het lezen en schrijven binnen één SSD of van een flashdrive (oorspronkelijk bestand) naar SSD (DB) minder dan 10 minuten.
Nog enkele seconden zijn nodig om een kolom met een gehele klasse-label en een indexkolom (ORDERED INDEX) met de rijnummers aan te maken, waarmee observaties zullen worden geselecteerd bij het maken van batches:
Extra kolommen en index aanmaken
message("Genereer labels")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD label_int int"))
invisible(DBI::dbExecute(con, "UPDATE doodles SET label_int = dense_rank() OVER (ORDER BY word) - 1"))

message("Genereer rijnummers")
invisible(DBI::dbExecute(con, "ALTER TABLE doodles ADD id serial"))
invisible(DBI::dbExecute(con, "CREATE ORDERED INDEX doodles_id_ord_idx ON doodles(id)")).
Om de taak van het dynamisch genereren van batches op te lossen, moesten we de maximale snelheid bereiken voor het ophalen van willekeurige rijen uit de tabel. doodles. Hiervoor gebruikten we 3 trucs. De eerste was om de dimensionaliteit te verkleinen van het type waarin het ID van de observatie wordt opgeslagen. In de oorspronkelijke dataset is het type dat nodig is voor het opslaan van ID's bigint, maar het aantal observaties maakt het mogelijk om hun identificaties, die gelijk zijn aan hun volgnummer, in het type int. Hierdoor verloopt de zoektocht aanzienlijk sneller. De tweede truc was het gebruik van ORDERED INDEX — deze oplossing kwam empirisch tot stand, door alle beschikbare . De derde bestond uit het gebruik van geparameteriseerde queries. De essentie van de methode is dat de opdracht PREPARE eenmalig wordt uitgevoerd, waarna de voorbereide expressie wordt gebruikt bij het creëren van een hoop identieke queries, maar in de praktijk bleek de winst ten opzichte van een simpele SELECT ongeveer op het niveau van statistische foutmarge te liggen.
Het proces van het laden van gegevens verbruikt niet meer dan 450 MB RAM. Dit betekent dat de beschreven aanpak het mogelijk maakt om datasets van tientallen gigabytes te verwerken op vrijwel elke budgethardware, inclusief enkele single-board computers, wat behoorlijk indrukwekkend is.
Nu blijven we de snelheid van het ophalen van (willekeurige) gegevens meten en de schaalgrootte beoordelen bij het selecteren van batches van verschillende formaten:
Database benchmark
library(ggplot2)

set.seed(0)
# Verbinden met de database
con <- DBI::dbConnect(MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

# Functie voor het voorbereiden van een serveraanroep
prep_sql <- function(batch_size) {
  sql <- sprintf("PREPARE SELECT id FROM doodles WHERE id IN (%s)",
                 paste(rep("?", batch_size), collapse = ","))
  res <- DBI::dbSendQuery(con, sql)
  return(res)
}

# Functie voor het ophalen van gegevens
fetch_data <- function(rs, batch_size) {
  ids <- sample(seq_len(n), batch_size)
  res <- DBI::dbFetch(DBI::dbBind(rs, as.list(ids)))
  return(res)
}

# Uitvoeren van de benchmark
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    rs <- prep_sql(batch_size)
    bench::mark(
      fetch_data(rs, batch_size),
      min_iterations = 50L
    )
  }
)
# Benchmarkparameters
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16   23.6ms  54.02ms  93.43ms     18.8        2.6s    49
# 2         32     38ms  84.83ms 151.55ms     11.4       4.29s    49
# 3         64   63.3ms 175.54ms 248.94ms     5.85       8.54s    50
# 4        128   83.2ms 341.52ms 496.24ms     3.00      16.69s    50
# 5        256  232.8ms 653.21ms 847.44ms     1.58      31.66s    50
# 6        512  784.6ms    1.41s    1.98s     0.740       1.1m    49
# 7       1024  681.7ms    2.72s    4.06s     0.377      2.16m    49

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
  geom_point() +
  geom_line() +
  ylab("mediaan tijd, s") +
  theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 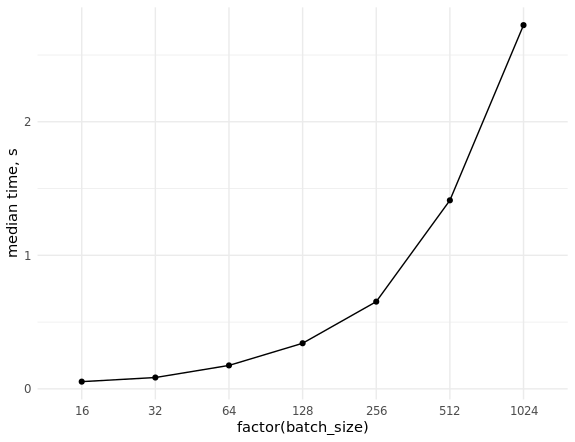
2. Voorbereiding van batches
Het hele proces van batchvoorbereiding bestaat uit de volgende stappen:
- Parseren van meerdere JSON's die vectoren van strings met coördinaten van punten bevatten.
- Tekenen van gekleurde lijnen op basis van de coördinaten van punten op een afbeelding van de juiste grootte (bijvoorbeeld 256×256 of 128×128).
- Omzetten van de verkregen afbeeldingen naar een tensor.
Tijdens de competitie van kernels op Python werd de taak voornamelijk opgelost met behulp van OpenCV. Een van de eenvoudigste en meest voor de hand liggende alternatieven in R zou er als volgt uitzien:
Implementatie van de omzetting van JSON naar tensor in R
r_process_json_str <- function(json, line.width = 3,
                               color = TRUE, scale = 1) {
  # JSON parser
  coords <- jsonlite::fromJSON(json, simplifyMatrix = FALSE)
  tmp <- tempfile()
  # Remove temporary file upon function completion
  on.exit(unlink(tmp))
  png(filename = tmp, width = 256 * scale, height = 256 * scale, pointsize = 1)
  # Empty plot
  plot.new()
  # Plot window size
  plot.window(xlim = c(256 * scale, 0), ylim = c(256 * scale, 0))
  # Line colors
  cols <- if (color) rainbow(length(coords)) else "#000000"
  for (i in seq_along(coords)) {
    lines(x = coords[[i]][[1]] * scale, y = coords[[i]][[2]] * scale,
          col = cols[i], lwd = line.width)
  }
  dev.off()
  # Transform image into a 3D array
  res <- png::readPNG(tmp)
  return(res)
}

r_process_json_vector <- function(x, ...) {
  res <- lapply(x, r_process_json_str, ...)
  # Combine 3D image arrays into a 4D tensor
  res <- do.call(abind::abind, c(res, along = 0))
  return(res)
}
De tekening wordt uitgevoerd met de standaardtools van R en opgeslagen in een tijdelijk PNG-bestand, dat in het RAM wordt opgeslagen (in Linux bevinden de tijdelijke R-directories zich in een directory /tmp, die in het RAM is gemonteerd). Vervolgens wordt dit bestand gelezen als een driedimensionale array met waarden van 0 tot 1. Dit is belangrijk, omdat het meer gangbare BMP-formaat zou worden gelezen in een raw-array met hex-kleurcodes.
Laten we het resultaat testen:
zip_file <- file.path("data", "train_simplified.zip")
csv_file <- "cat.csv"
unzip(zip_file, files = csv_file, exdir = tempdir(),
      junkpaths = TRUE, unzip = getOption("unzip"))
tmp_data <- data.table::fread(file.path(tempdir(), csv_file), sep = ",",
                              select = "drawing", nrows = 10000)
arr <- r_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 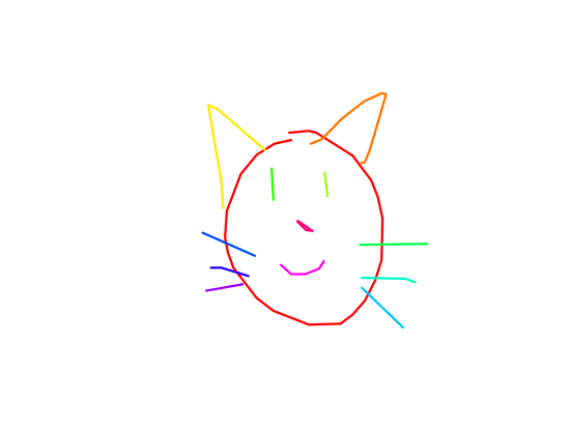
De batch zal als volgt worden samengesteld:
res <- r_process_json_vector(tmp_data[1:4, drawing], scale = 0.5)
str(res)
 # num [1:4, 1:128, 1:128, 1:3] 1 1 1 1 1 1 1 1 1 1 ...
 # - attr(*, "dimnames")=Lijst van 4
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
 #  ..$ : NULL
Deze implementatie lijkt ons suboptimaal, omdat het vormen van grote batches belachelijk veel tijd kost, en we hebben besloten de ervaringen van collega's te benutten door gebruik te maken van een krachtige bibliotheek OpenCV. Op dat moment was er geen kant-en-klaar pakket voor R (en dat is er nu ook niet), dus werd er een minimale implementatie van de benodigde functionaliteit in C++ geschreven en geïntegreerd in de R-code met behulp van Rcpp.
Voor het oplossen van de taak werden de volgende pakketten en bibliotheken gebruikt:
OpenCV voor het werken met afbeeldingen en het tekenen van lijnen. We gebruikten vooraf geïnstalleerde systeembibliotheken en header-bestanden, evenals dynamische linking.
xtensor voor het werken met multidimensionale arrays en tensoren. We hebben gebruikgemaakt van de headerbestanden die zijn opgenomen in het gelijknamige R-pakket. De bibliotheek maakt het mogelijk om met multidimensionale arrays te werken, zowel in rij-major als in kolom-major volgorde.
ndjson voor het parseren van JSON. Deze bibliotheek wordt gebruikt in xtensor automatisch als deze in het project aanwezig is.
RcppThread voor het organiseren van multithread-verwerking van een vector van JSON-gegevens. We hebben gebruikgemaakt van de headerbestanden die door dit pakket worden verstrekt. Het is populairder dan RcppParallel het pakket onderscheidt zich onder andere door een ingebouwd mechanisme voor het onderbreken van een lus (interrupt).
Het moet worden opgemerkt dat xtensor bleek een echte vondst te zijn: naast het feit dat het uitgebreide functionaliteit en hoge prestaties biedt, waren de ontwikkelaars behoorlijk responsief en gaven ze snel en uitgebreid antwoord op de vragen die opkwamen. Met hun hulp is het gelukt om OpenCV-matrixtransformities naar xtensor-tensoren te implementeren, evenals een manier om 3D-tensorbeelden samen te voegen tot een 4D-tensor met de juiste afmetingen (namelijk de batch).
Materialen voor het bestuderen van Rcpp, xtensor en RcppThread
Voor het compileren van bestanden die gebruik maken van systeembestanden en dynamische koppeling met geïnstalleerde bibliotheken in het systeem, hebben we gebruikgemaakt van het plug-in mechanisme dat is geïmplementeerd in het pakket Rcpp. Voor het automatisch vinden van paden en vlaggen hebben we de populaire Linux-tool pkg-config.
Implementatie van de Rcpp-plug-in voor het gebruik van de OpenCV-bibliotheek
Rcpp::registerPlugin("opencv", function() {
  # Mogelijke pakketnamen
  pkg_config_name <- c("opencv", "opencv4")
  # Binaire uitvoerbare bestand van de pkg-config-tool
  pkg_config_bin <- Sys.which("pkg-config")
  # Controleer of de tool in het systeem aanwezig is
  checkmate::assert_file_exists(pkg_config_bin, access = "x")
  # Controle van het bestaan van het OpenCV-configuratiebestand voor pkg-config
  check <- sapply(pkg_config_name,
                  function(pkg) system(paste(pkg_config_bin, pkg)))
  if (all(check != 0)) {
    stop("OpenCV-configuratie voor pkg-config niet gevonden", call. = FALSE)
  }

  pkg_config_name <- pkg_config_name[check == 0]
  list(env = list(
    PKG_CXXFLAGS = system(paste(pkg_config_bin, "--cflags", pkg_config_name),
                          intern = TRUE),
    PKG_LIBS = system(paste(pkg_config_bin, "--libs", pkg_config_name),
                      intern = TRUE)
  ))
})
Als resultaat van het gebruik van de plug-in zullen tijdens het compileren de volgende waarden worden ingevoegd:
Rcpp:::.plugins$opencv()$env

# $PKG_CXXFLAGS
# [1] "-I/usr/include/opencv"
#
# $PKG_LIBS
# [1] "-lopencv_shape -lopencv_stitching -lopencv_superres -lopencv_videostab -lopencv_aruco -lopencv_bgsegm -lopencv_bioinspired -lopencv_ccalib -lopencv_datasets -lopencv_dpm -lopencv_face -lopencv_freetype -lopencv_fuzzy -lopencv_hdf -lopencv_line_descriptor -lopencv_optflow -lopencv_video -lopencv_plot -lopencv_reg -lopencv_saliency -lopencv_stereo -lopencv_structured_light -lopencv_phase_unwrapping -lopencv_rgbd -lopencv_viz -lopencv_surface_matching -lopencv_text -lopencv_ximgproc -lopencv_calib3d -lopencv_features2d -lopencv_flann -lopencv_xobjdetect -lopencv_objdetect -lopencv_ml -lopencv_xphoto -lopencv_highgui -lopencv_videoio -lopencv_imgcodecs -lopencv_photo -lopencv_imgproc -lopencv_core"
De code voor het parseren van JSON en het vormen van een batch voor verzending naar het model is onder de spoiler gegeven. Voeg eerst de lokale projectdirectory toe voor het zoeken naar headerbestanden (nodig voor ndjson):
Sys.setenv("PKG_CXXFLAGS" = paste0("-I", normalizePath(file.path("src"))))Implementatie van de conversie van JSON naar tensor in C++
// [[Rcpp::plugins(cpp14)]]
// [[Rcpp::plugins(opencv)]]
// [[Rcpp::depends(xtensor)]]
// [[Rcpp::depends(RcppThread)]]

#include <xtensor/xjson.hpp>
#include <xtensor/xadapt.hpp>
#include <xtensor/xview.hpp>
#include <xtensor-r/rtensor.hpp>
#include <opencv2/core/core.hpp>
#include <opencv2/highgui/highgui.hpp>
#include <opencv2/imgproc/imgproc.hpp>
#include <Rcpp.h>
#include <RcppThread.h>

// Синонимы для типов
using RcppThread::parallelFor;
using json = nlohmann::json;
using points = xt::xtensor<double,2>;     // Извлечённые из JSON координаты точек
using strokes = std::vector<points>;      // Извлечённые из JSON координаты точек
using xtensor3d = xt::xtensor<double, 3>; // Тензор для хранения матрицы изоображения
using xtensor4d = xt::xtensor<double, 4>; // Тензор для хранения множества изображений
using rtensor3d = xt::rtensor<double, 3>; // Обёртка для экспорта в R
using rtensor4d = xt::rtensor<double, 4>; // Обёртка для экспорта в R

// Статические константы
// Размер изображения в пикселях
const static int SIZE = 256;
// Тип линии
// См. https://en.wikipedia.org/wiki/Pixel_connectivity#2-dimensional
const static int LINE_TYPE = cv::LINE_4;
// Толщина линии в пикселях
const static int LINE_WIDTH = 3;
// Алгоритм ресайза
// https://docs.opencv.org/3.1.0/da/d54/group__imgproc__transform.html#ga5bb5a1fea74ea38e1a5445ca803ff121
const static int RESIZE_TYPE = cv::INTER_LINEAR;

// Шаблон для конвертирования OpenCV-матрицы в тензор
template <typename T, int NCH, typename XT=xt::xtensor<T,3,xt::layout_type::column_major>>
XT to_xt(const cv::Mat_<cv::Vec<T, NCH>>& src) {
  // Размерность целевого тензора
  std::vector<int> shape = {src.rows, src.cols, NCH};
  // Общее количество элементов в массиве
  size_t size = src.total() * NCH;
  // Преобразование cv::Mat в xt::xtensor
  XT res = xt::adapt((T*) src.data, size, xt::no_ownership(), shape);
  return res;
}

// Преобразование JSON в список координат точек
strokes parse_json(const std::string& x) {
  auto j = json::parse(x);
  // Результат парсинга должен быть массивом
  if (!j.is_array()) {
    throw std::runtime_error("'x' must be JSON array.");
  }
  strokes res;
  res.reserve(j.size());
  for (const auto& a: j) {
    // Каждый элемент массива должен быть 2-мерным массивом
    if (!a.is_array() || a.size() != 2) {
      throw std::runtime_error("'x' must include only 2d arrays.");
    }
    // Извлечение вектора точек
    auto p = a.get<points>();
    res.push_back(p);
  }
  return res;
}

// Отрисовка линий
// Цвета HSV
cv::Mat ocv_draw_lines(const strokes& x, bool color = true) {
  // Исходный тип матрицы
  auto stype = color ? CV_8UC3 : CV_8UC1;
  // Итоговый тип матрицы
  auto dtype = color ? CV_32FC3 : CV_32FC1;
  auto bg = color ? cv::Scalar(0, 0, 255) : cv::Scalar(255);
  auto col = color ? cv::Scalar(0, 255, 220) : cv::Scalar(0);
  cv::Mat img = cv::Mat(SIZE, SIZE, stype, bg);
  // Количество линий
  size_t n = x.size();
  for (const auto& s: x) {
    // Количество точек в линии
    size_t n_points = s.shape()[1];
    for (size_t i = 0; i < n_points - 1; ++i) {
      // Точка начала штриха
      cv::Point from(s(0, i), s(1, i));
      // Точка окончания штриха
      cv::Point to(s(0, i + 1), s(1, i + 1));
      // Отрисовка линии
      cv::line(img, from, to, col, LINE_WIDTH, LINE_TYPE);
    }
    if (color) {
      // Меняем цвет линии
      col[0] += 180 / n;
    }
  }
  if (color) {
    // Меняем цветовое представление на RGB
    cv::cvtColor(img, img, cv::COLOR_HSV2RGB);
  }
  // Меняем формат представления на float32 с диапазоном [0, 1]
  img.convertTo(img, dtype, 1 / 255.0);
  return img;
}

// Обработка JSON и получение тензора с данными изображения
xtensor3d process(const std::string& x, double scale = 1.0, bool color = true) {
  auto p = parse_json(x);
  auto img = ocv_draw_lines(p, color);
  if (scale != 1) {
    cv::Mat out;
    cv::resize(img, out, cv::Size(), scale, scale, RESIZE_TYPE);
    cv::swap(img, out);
    out.release();
  }
  xtensor3d arr = color ? to_xt<double,3>(img) : to_xt<double,1>(img);
  return arr;
}

// [[Rcpp::export]]
rtensor3d cpp_process_json_str(const std::string& x,
                               double scale = 1.0,
                               bool color = true) {
  xtensor3d res = process(x, scale, color);
  return res;
}

// [[Rcpp::export]]
rtensor4d cpp_process_json_vector(const std::vector<std::string>& x,
                                  double scale = 1.0,
                                  bool color = false) {
  size_t n = x.size();
  size_t dim = floor(SIZE * scale);
  size_t channels = color ? 3 : 1;
  xtensor4d res({n, dim, dim, channels});
  parallelFor(0, n, [&x, &res, scale, color](int i) {
    xtensor3d tmp = process(x[i], scale, color);
    auto view = xt::view(res, i, xt::all(), xt::all(), xt::all());
    view = tmp;
  });
  return res;
}
Deze code moet in een bestand geplaatst worden src/cv_xt.cpp en gecompileerd worden met het commando Rcpp::sourceCpp(file = "src/cv_xt.cpp", env = .GlobalEnv); tevens is voor werking nodig nlohmann/json.hpp uit . De code is verdeeld in verschillende functies:
to_xt— ein templated functie voor het converteren van een afbeeldingsmatrix (cv::Mat) naar een tensorxt::xtensor;parse_json— functie die een JSON-string parseert, de coördinaten van punten extrahert en deze in een vector verpakt;ocv_draw_lines— tekent kleurrijke lijnen uit de verkregen vector van punten;process— combineert de bovengenoemde functies en voegt de mogelijkheid toe om de verkregen afbeelding te schalen;cpp_process_json_str— een wrapper om de functieprocess, die het resultaat exporteert naar een R-object (meerdimensionale array);cpp_process_json_vector— een wrapper om de functiecpp_process_json_str, die het mogelijk maakt om een stringvector in multithread-modus te verwerken.
Voor het tekenen van kleurrijke lijnen werd het HSV-kleurmodel gebruikt met daaropvolgende conversie naar RGB. Laten we het resultaat testen:
arr <- cpp_process_json_str(tmp_data[4, drawing])
dim(arr)
# [1] 256 256   3
plot(magick::image_read(arr)) 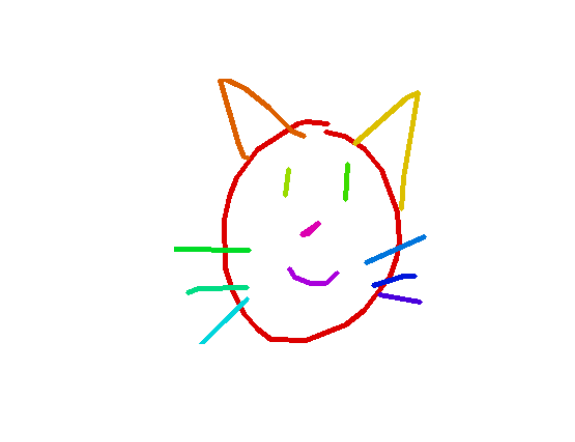
Vergelijking van de snelheid van de implementaties in R en C++
res_bench <- bench::mark(
  r_process_json_str(tmp_data[4, drawing], scale = 0.5),
  cpp_process_json_str(tmp_data[4, drawing], scale = 0.5),
  check = FALSE,
  min_iterations = 100
)
# Benchmarkparameters
cols <- c("expression", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   expression                min     median       max `itr/sec` total_time  n_itr
#
# 1 r_process_json_str     3.49ms     3.55ms    4.47ms      273.      490ms    134
# 2 cpp_process_json_str   1.94ms     2.02ms    5.32ms      489.      497ms    243

library(ggplot2)
# Uitvoeren van meting
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    .data <- tmp_data[sample(seq_len(.N), batch_size), drawing]
    bench::mark(
      r_process_json_vector(.data, scale = 0.5),
      cpp_process_json_vector(.data,  scale = 0.5),
      min_iterations = 50,
      check = FALSE
    )
  }
)

res_bench[, cols]

#    expression   batch_size      min   median      max `itr/sec` total_time n_itr
#                  <bch:tm> <bch:tm> <bch:tm>     <dbl>   <bch:tm> <int>
#  1 r                   16   50.61ms  53.34ms  54.82ms    19.1     471.13ms     9
#  2 cpp                 16    4.46ms   5.39ms   7.78ms   192.      474.09ms    91
#  3 r                   32   105.7ms 109.74ms 212.26ms     7.69        6.5s    50
#  4 cpp                 32    7.76ms  10.97ms  15.23ms    95.6     522.78ms    50
#  5 r                   64  211.41ms 226.18ms 332.65ms     3.85      12.99s    50
#  6 cpp                 64   25.09ms  27.34ms  32.04ms    36.0        1.39s    50
#  7 r                  128   534.5ms 627.92ms 659.08ms     1.61      31.03s    50
#  8 cpp                128   56.37ms  58.46ms  66.03ms    16.9        2.95s    50
#  9 r                  256     1.15s    1.18s    1.29s     0.851     58.78s    50
# 10 cpp                256  114.97ms 117.39ms 130.09ms     8.45       5.92s    50
# 11 r                  512     2.09s    2.15s    2.32s     0.463       1.8m    50
# 12 cpp                512  230.81ms  235.6ms 261.99ms     4.18      11.97s    50
# 13 r                 1024        4s    4.22s     4.4s     0.238       3.5m    50
# 14 cpp               1024  410.48ms 431.43ms 462.44ms     2.33      21.45s    50

ggplot(res_bench, aes(x = factor(batch_size), y = median,
                      group =  expression, color = expression)) +
  geom_point() +
  geom_line() +
  ylab("gemiddelde tijd, s") +
  theme_minimal() +
  scale_color_discrete(name = "", labels = c("cpp", "r")) +
theme(legend.position = "bottom") 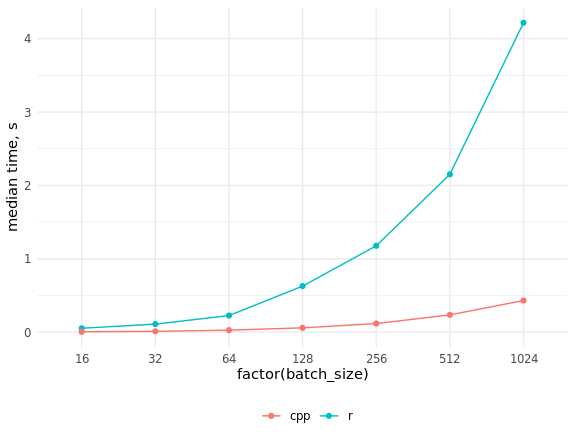
Zoals we zien, is de snelheidstoename aanzienlijk, en het is niet mogelijk om de C++-code in te halen door de R-code te paralleliseren.
3. Iterators voor het extraheren van batches uit de database
R heeft een verdiende reputatie als taal voor het verwerken van gegevens die in het RAM passen, terwijl Python meer gekenmerkt wordt door iteratieve gegevensverwerking, die het gemakkelijk maakt om out-of-core berekeningen (berekeningen met behulp van externe geheugen) te implementeren. Een klassiek en relevant voorbeeld voor ons in de context van de beschreven taak zijn diepe neurale netwerken die worden getraind met de gradient descent-methode, met een benadering van de gradient bij elke stap op een kleine hoeveelheid waarnemingen, of mini-batch.
Deep learning-frameworks geschreven in Python hebben speciale klassen die iterators voor gegevens implementeren: tabellen, beelden in mappen, binaire indelingen, enz. Je kunt kant-en-klare opties gebruiken of je eigen iterators schrijven voor specifieke taken. In R kunnen we profiteren van alle mogelijkheden van de Python-bibliotheek keras met zijn verschillende backends met behulp van het gelijknamige pakket dat op zijn beurt bovenop het pakket werkt reticulate. Dit laatste verdient een aparte uitgebreide discussie; het maakt niet alleen het uitvoeren van Python-code vanuit R mogelijk, maar zorgt ook voor de overdracht van objecten tussen R- en Python-sessies, waarbij automatisch alle noodzakelijke typeconversies worden uitgevoerd.
We hebben de noodzaak om alle gegevens in het RAM te bewaren geëlimineerd door gebruik te maken van MonetDBLite; al het 'neuraal netwerk' werk zal worden uitgevoerd met de oorspronkelijke Python-code, we moeten alleen een gegevensiterator schrijven, aangezien er geen kant-en-klare oplossing voor deze situatie is, noch in R, noch in Python. Er zijn in wezen maar twee eisen aan deze iterator: hij moet batches in een oneindige lus retourneren en zijn toestand tussen iteraties behouden (het laatste wordt in R op een eenvoudige manier gerealiseerd met behulp van closures). Voorheen was het nodig om expliciet arrays van R naar numpy-arrays om te zetten binnen de iterator, maar de actuele versie van het pakket keras doet dit automatisch.
De iterator voor trainings- en validatiegegevens ziet er als volgt uit:
Iterator voor trainings- en validatiegegevens
train_generator <- function(db_connection = con,
                            samples_index,
                            num_classes = 340,
                            batch_size = 32,
                            scale = 1,
                            color = FALSE,
                            imagenet_preproc = FALSE) {
  # Проверка аргументов
  checkmate::assert_class(con, "DBIConnection")
  checkmate::assert_integerish(samples_index)
  checkmate::assert_count(num_classes)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Перемешиваем, чтобы брать и удалять использованные индексы батчей по порядку
  dt <- data.table::data.table(id = sample(samples_index))
  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  # Оставляем только полные батчи и индексируем
  dt <- dt[, if (.N == batch_size) .SD, keyby = batch]
  # Устанавливаем счётчик
  i <- 1
  # Количество батчей
  max_i <- dt[, max(batch)]

  # Подготовка выражения для выгрузки
  sql <- sprintf(
    "PREPARE SELECT drawing, label_int FROM doodles WHERE id IN (%s)",
    paste(rep("?", batch_size), collapse = ",")
  )
  res <- DBI::dbSendQuery(con, sql)

  # Аналог keras::to_categorical
  to_categorical <- function(x, num) {
    n <- length(x)
    m <- numeric(n * num)
    m[x * n + seq_len(n)] <- 1
    dim(m) <- c(n, num)
    return(m)
  }

  # Замыкание
  function() {
    # Начинаем новую эпоху
    if (i > max_i) {
      dt[, id := sample(id)]
      data.table::setkey(dt, batch)
      # Сбрасываем счётчик
      i <<- 1
      max_i <<- dt[, max(batch)]
    }

    # ID для выгрузки данных
    batch_ind <- dt[batch == i, id]
    # Выгрузка данных
    batch <- DBI::dbFetch(DBI::dbBind(res, as.list(batch_ind)), n = -1)

    # Увеличиваем счётчик
    i <<- i + 1

    # Парсинг JSON и подготовка массива
    batch_x <- cpp_process_json_vector(batch$drawing, scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }

    batch_y <- to_categorical(batch$label_int, num_classes)
    result <- list(batch_x, batch_y)
    return(result)
  }
}
De functie neemt een variabele met een verbinding met de database, de gebruikte rij-indices, het aantal klassen, de batchgrootte, de schaal (scale = 1 komt overeen met het weergeven van afbeeldingen van 256x256 pixels, scale = 0.5 - 128x128 pixels), kleurindicator (color = FALSE geeft de weergave in grijstinten aan, bij gebruik kleur = WAAR elke streek wordt getekend in een nieuwe kleur) en een preprocessing-indicator voor netwerken die zijn voorgetraind op imagenet. De laatste is nodig om de pixelwaarden van het bereik [0, 1] naar het bereik [-1, 1] te schalen, dat werd gebruikt tijdens de training van de meegeleverde keras modellen.
De externe functie bevat een typecontrole van de argumenten, een tabel data.table met willekeurig geschudde regelnummer uit samples_index en batchnummers, een teller en het maximum aantal batches, evenals een SQL-expressie voor het ophalen van gegevens uit de database. Bovendien hebben we intern een snelle analogie van de functie gedefinieerd keras::to_categorical(). We hebben vrijwel alle gegevens gebruikt voor training, met een halve procent gereserveerd voor validatie, daarom was de grootte van de epoch beperkt door de parameter steps_per_epoch bij de oproep, dus alle keras::fit_generator(), en de voorwaarde if (i > max_i) werd alleen geactiveerd voor de validatie-iterator.
In de interne functie vindt selectie van de regelindexen voor de volgende batch plaats, het ophalen van records uit de database met incrementele batchtellers, het parseren van JSON's (de functie cpp_process_json_vector(), geschreven in C++) en het creëren van arrays die overeenkomen met de beelden. Vervolgens worden one-hot vectoren met klasse-etiketten gemaakt, en de arrays met pixelwaarden en labels worden samengevoegd in een lijst, die de teruggegeven waarde is. Voor een snellere uitvoering werd het maken van indexen in de tabellen gebruikt data.table en een referentie-modificatie - zonder deze "snufjes" van het pakket is het vrij moeilijk om een efficiënte verwerking van enigszins significante datavolumes in R voor te stellen. data.table De resultaten van de snelheidsmetingen op een notebook met een Core i5 zien er als volgt uit:
Benchmark van de iterator
Benchmark van de iterator
library(Rcpp)
library(keras)
library(ggplot2)

source("utils/rcpp.R")
source("utils/keras_iterator.R")

con <- DBI::dbConnect(drv = MonetDBLite::MonetDBLite(), Sys.getenv("DBDIR"))

ind <- seq_len(DBI::dbGetQuery(con, "SELECT count(*) FROM doodles")[[1L]])
num_classes <- DBI::dbGetQuery(con, "SELECT max(label_int) + 1 FROM doodles")[[1L]]

# Indexes for the training set
train_ind <- sample(ind, floor(length(ind) * 0.995))
# Indexes for the validation set
val_ind <- ind[-train_ind]
rm(ind)
# Scale factor
scale <- 0.5

# Benchmark measurement
res_bench <- bench::press(
  batch_size = 2^(4:10),
  {
    it1 <- train_generator(
      db_connection = con,
      samples_index = train_ind,
      num_classes = num_classes,
      batch_size = batch_size,
      scale = scale
    )
    bench::mark(
      it1(),
      min_iterations = 50L
    )
  }
)
# Benchmark parameters
cols <- c("batch_size", "min", "median", "max", "itr/sec", "total_time", "n_itr")
res_bench[, cols]

#   batch_size      min   median      max `itr/sec` total_time n_itr
#
# 1         16     25ms  64.36ms   92.2ms     15.9       3.09s    49
# 2         32   48.4ms 118.13ms 197.24ms     8.17       5.88s    48
# 3         64   69.3ms 117.93ms 181.14ms     8.57       5.83s    50
# 4        128  157.2ms 240.74ms 503.87ms     3.85      12.71s    49
# 5        256  359.3ms 613.52ms 988.73ms     1.54       30.5s    47
# 6        512  884.7ms    1.53s    2.07s     0.674      1.11m    45
# 7       1024     2.7s    3.83s    5.47s     0.261      2.81m    44

ggplot(res_bench, aes(x = factor(batch_size), y = median, group = 1)) +
    geom_point() +
    geom_line() +
    ylab("median time, s") +
    theme_minimal()

DBI::dbDisconnect(con, shutdown = TRUE) 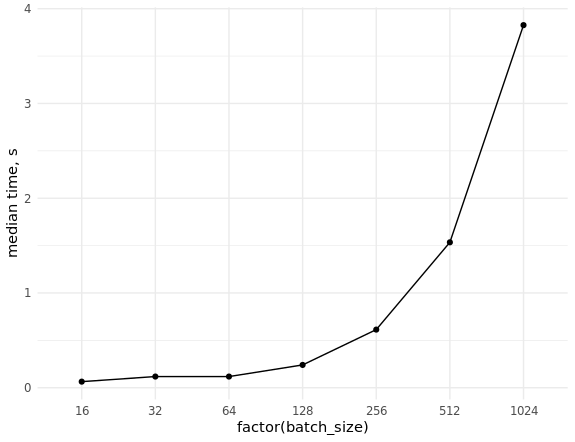
Als er voldoende RAM beschikbaar is, kan de database aanzienlijk worden versneld door deze in datzelfde RAM te plaatsen (voor onze taak is 32 GB voldoende). In Linux wordt standaard een partitie gemonteerd /dev/shm, die tot de helft van het RAM beslaat. Je kunt zelfs meer toewijzen door het aan te passen /etc/fstab, zodat het de vorm krijgt van tmpfs /dev/shm tmpfs defaults,size=25g 0 0. Zorg ervoor dat je opnieuw opstart en het resultaat controleert door het commando uit te voeren df -h.
De iterator voor testgegevens ziet er veel eenvoudiger uit, omdat de testdataset volledig in het RAM past:
Iterator voor testgegevens
test_generator <- function(dt,
                           batch_size = 32,
                           scale = 1,
                           color = FALSE,
                           imagenet_preproc = FALSE) {

  # Проверка аргументов
  checkmate::assert_data_table(dt)
  checkmate::assert_count(batch_size)
  checkmate::assert_number(scale, lower = 0.001, upper = 5)
  checkmate::assert_flag(color)
  checkmate::assert_flag(imagenet_preproc)

  # Проставляем номера батчей
  dt[, batch := (.I - 1L) %/% batch_size + 1L]
  data.table::setkey(dt, batch)
  i <- 1
  max_i <- dt[, max(batch)]

  # Замыкание
  function() {
    batch_x <- cpp_process_json_vector(dt[batch == i, drawing],
                                       scale = scale, color = color)
    if (imagenet_preproc) {
      # Шкалирование c интервала [0, 1] на интервал [-1, 1]
      batch_x <- (batch_x - 0.5) * 2
    }
    result <- list(batch_x)
    i <<- i + 1
    return(result)
  }
}
4. Modelarchitectuur kiezen
De eerste van de gebruikte architecturen was , waarvan de kenmerken zijn behandeld in de mededeling. Het is opgenomen in de standaardlevering keras en dus beschikbaar in het gelijknamige pakket voor R. Maar bij het proberen deze te gebruiken met eenkanaals afbeeldingen bleek iets vreemds: de ingangstensor moet altijd een dimensie hebben van (batch, hoogte, breedte, 3), dat wil zeggen dat het aantal kanalen niet kan worden gewijzigd. In Python is er geen dergelijke beperking, dus hebben we ons gehaast en onze eigen implementatie van deze architectuur geschreven, volgens het originele artikel (zonder dropout, zoals in de Keras-versie):
Architectuur mobilenet v1
library(keras)

top_3_categorical_accuracy <- custom_metric(
    name = "top_3_categorical_accuracy",
    metric_fn = function(y_true, y_pred) {
         metric_top_k_categorical_accuracy(y_true, y_pred, k = 3)
    }
)

layer_sep_conv_bn %
  layer_batch_normalization() %>%
  layer_activation_relu() %>%
  layer_conv_2d(
    filters = filters * alpha,
    kernel_size = c(1, 1),
    strides = c(1, 1)
  ) %>%
  layer_batch_normalization() %>%
  layer_activation_relu()
}

get_mobilenet_v1 <- function(input_shape = c(224, 224, 1),
                             num_classes = 340,
                             alpha = 1,
                             depth_multiplier = 1,
                             optimizer = optimizer_adam(lr = 0.002),
                             loss = "categorical_crossentropy",
                             metrics = c("categorical_crossentropy",
                                         top_3_categorical_accuracy)) {

  inputs <- layer_input(shape = input_shape)

  outputs %
    layer_conv_2d(filters = 32, kernel_size = c(3, 3), strides = c(2, 2), padding = "same") %>%
    layer_batch_normalization() %>%
    layer_activation_relu() %>%
    layer_sep_conv_bn(filters = 64, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 128, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 256, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 512, strides = c(1, 1)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(2, 2)) %>%
    layer_sep_conv_bn(filters = 1024, strides = c(1, 1)) %>%
    layer_global_average_pooling_2d() %>%
    layer_dense(units = num_classes) %>%
    layer_activation_softmax()

    model % compile(
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )

    return(model)
}
De nadelen van deze benadering zijn duidelijk. We willen veel modellen testen, maar we willen niet elke architectuur handmatig herschrijven. Ook hadden we geen toegang tot de gewichten van modellen die vooraf waren getraind op Imagenet. Zoals gewoonlijk hielp het bestuderen van de documentatie. get_config() maakt het mogelijk om een beschrijving van het model in een bewerkbaar formaat te krijgen (base_model_conf$layers — een gewone R-lijst), en de functie from_config() voert de omgekeerde conversie uit naar een modelobject:
base_model_conf <- get_config(base_model)
base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
base_model <- from_config(base_model_conf)
Het is nu eenvoudig om een universele functie te schrijven voor het verkrijgen van een van de modellen die worden geleverd met keras modellen met voorgetrainde gewichten op imagenet of zonder:
Een functie om kant-en-klare architecturen te laden
get_model <- function(name = "mobilenet_v2",
                      input_shape = NULL,
                      weights = "imagenet",
                      pooling = "avg",
                      num_classes = NULL,
                      optimizer = keras::optimizer_adam(lr = 0.002),
                      loss = "categorical_crossentropy",
                      metrics = NULL,
                      color = TRUE,
                      compile = FALSE) {
  # Argumenten controleren
  checkmate::assert_string(name)
  checkmate::assert_integerish(input_shape, lower = 1, upper = 256, len = 3)
  checkmate::assert_count(num_classes)
  checkmate::assert_flag(color)
  checkmate::assert_flag(compile)

  # Verkrijg object uit het keras-pakket
  model_fun <- get0(paste0("application_", name), envir = asNamespace("keras"))
  # Controle van de aanwezigheid van het object in het pakket
  if (is.null(model_fun)) {
    stop("Model ", shQuote(name), " niet gevonden.", call. = FALSE)
  }

  base_model <- model_fun(
    input_shape = input_shape,
    include_top = FALSE,
    weights = weights,
    pooling = pooling
  )

  # Als het beeld niet in kleur is, wijzig de dimensie van de invoer
  if (!color) {
    base_model_conf <- keras::get_config(base_model)
    base_model_conf$layers[[1]]$config$batch_input_shape[[4]] <- 1L
    base_model <- keras::from_config(base_model_conf)
  }

  predictions <- keras::get_layer(base_model, "global_average_pooling2d_1")$output
  predictions <- keras::layer_dense(predictions, units = num_classes, activation = "softmax")
  model <- keras::keras_model(
    inputs = base_model$input,
    outputs = predictions
  )

  if (compile) {
    keras::compile(
      object = model,
      optimizer = optimizer,
      loss = loss,
      metrics = metrics
    )
  }

  return(model)
}
Bij gebruik van eentonige afbeeldingen worden de voorgetrainde gewichten niet gebruikt. Dit kon worden opgelost: met de functie get_weights() om de gewichten van het model als een lijst van R-arrays te verkrijgen, de dimensie van het eerste element van deze lijst te veranderen (door een kleurkanaal te nemen of gemiddeld over alle drie), en vervolgens de gewichten weer in het model te laden met de functie set_weights(). We hebben deze functionaliteit niet toegevoegd, omdat het al duidelijk was dat het productiever was om met kleurafbeeldingen te werken.
De meeste experimenten hebben we uitgevoerd met behulp van mobilenet versie 1 en 2, evenals resnet34. In deze competitie presteerden modernere architecturen, zoals SE-ResNeXt, goed. Helaas hadden we geen kant-en-klare implementaties tot onze beschikking, en onze eigen hebben we nog niet geschreven (maar dat zullen we zeker doen).
5. Scriptparameterisatie
Voor het gemak is alle code voor het starten van de training in de vorm van een enkel script gepresenteerd, geparameteriseerd met behulp van het als volgt:
doc <- '
Usage:
  train_nn.R --help
  train_nn.R --list-models
  train_nn.R [options]

Options:
  -h --help                   Toon dit bericht.
  -l --list-models            Lijst beschikbare modellen.
  -m --model=          Naam van het neuraal netwerkmodel [default: mobilenet_v2].
  -b --batch-size=      Batchgrootte [default: 32].
  -s --scale-factor=   Schaalfactor [default: 0.5].
  -c --color                  Gebruik kleur lijnen [default: FALSE].
  -d --db-dir=          Pad naar database-directory [default: Sys.getenv("db_dir")].
  -r --validate-ratio= Validatie monsterverhouding [default: 0.995].
  -n --n-gpu=         Aantal GPU's [default: 1].
'
args <- docopt::docopt(doc)
Package docopt is een implementatie voor R. Hiermee worden scripts gestart met eenvoudige opdrachten zoals Rscript bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db of ./bin/train_nn.R -m resnet50 -c -d /home/andrey/doodle_db, als het bestand train_nn.R uitvoerbaar is (dit commando start de training van het model resnet50 op kleurafbeeldingen van 128x128 pixels, de database moet zich in de map bevinden /home/andrey/doodle_db). In de lijst kunnen leersnelheid, type optimizer en overige aanpasbare parameters worden toegevoegd. Tijdens de voorbereiding van de publicatie bleek dat de architectuur mobilenet_v2 uit de actuele versie keras in R kan niet wegens wijzigingen die niet in het R-pakket zijn meegenomen - we wachten tot ze het oplossen.
Deze aanpak heeft het mogelijk gemaakt om experimenten met verschillende modellen aanzienlijk te versnellen in vergelijking met de meer traditionele manier van het starten van scripts in RStudio (als mogelijke alternatieven noemen we het pakket ). Maar het grootste voordeel is de mogelijkheid om eenvoudig scripts uit te voeren in Docker of gewoon op de server, zonder RStudio te installeren.
6. Dockerisatie van scripts
We hebben Docker gebruikt om de overdraagbaarheid van de leeromgeving tussen teamleden te waarborgen en voor snelle implementatie in de cloud. Je kunt kennismaken met deze relatief ongebruikelijke tool voor de R-programmeur via een reeks publicaties of met .
Docker maakt het mogelijk om zowel eigen afbeeldingen "from scratch" te maken als andere afbeeldingen als basis te gebruiken voor het creëren van eigen afbeeldingen. Bij het analyseren van de beschikbare opties kwamen we tot de conclusie dat de installatie van NVIDIA-drivers, CUDA+cuDNN en Python-bibliotheken een vrij omvangrijk deel van de afbeelding vormt, en we besloten om de officiële afbeelding als basis te nemen. tensorflow/tensorflow:1.12.0-gpu, waarbij de benodigde R-pakketten zijn toegevoegd.
Het uiteindelijke Docker-bestand is als volgt:
Dockerfile
FROM tensorflow/tensorflow:1.12.0-gpu

MAINTAINER Artem Klevtsov

SHELL ["/bin/bash", "-c"]

ARG LOCALE="en_US.UTF-8"
ARG APT_PKG="libopencv-dev r-base r-base-dev littler"
ARG R_BIN_PKG="futile.logger checkmate data.table rcpp rapidjsonr dbi keras jsonlite curl digest remotes"
ARG R_SRC_PKG="xtensor RcppThread docopt MonetDBLite"
ARG PY_PIP_PKG="keras"
ARG DIRS="/db /app /app/data /app/models /app/logs"

RUN source /etc/os-release &&
    echo "deb https://cloud.r-project.org/bin/linux/ubuntu ${UBUNTU_CODENAME}-cran35/" > /etc/apt/sources.list.d/cran35.list &&
    apt-key adv --keyserver keyserver.ubuntu.com --recv-keys E084DAB9 &&
    add-apt-repository -y ppa:marutter/c2d4u3.5 &&
    add-apt-repository -y ppa:timsc/opencv-3.4 &&
    apt-get update &&
    apt-get install -y locales &&
    locale-gen ${LOCALE} &&
    apt-get install -y --no-install-recommends ${APT_PKG} &&
    ln -s /usr/lib/R/site-library/littler/examples/install.r /usr/local/bin/install.r &&
    ln -s /usr/lib/R/site-library/littler/examples/install2.r /usr/local/bin/install2.r &&
    ln -s /usr/lib/R/site-library/littler/examples/installGithub.r /usr/local/bin/installGithub.r &&
    echo 'options(Ncpus = parallel::detectCores())' >> /etc/R/Rprofile.site &&
    echo 'options(repos = c(CRAN = "https://cloud.r-project.org"))' >> /etc/R/Rprofile.site &&
    apt-get install -y $(printf "r-cran-%s " ${R_BIN_PKG}) &&
    install.r ${R_SRC_PKG} &&
    pip install ${PY_PIP_PKG} &&
    mkdir -p ${DIRS} &&
    chmod 777 ${DIRS} &&
    rm -rf /tmp/downloaded_packages/ /tmp/*.rds &&
    rm -rf /var/lib/apt/lists/*

COPY utils /app/utils
COPY src /app/src
COPY tests /app/tests
COPY bin/*.R /app/

ENV DBDIR="/db"
ENV CUDA_HOME="/usr/local/cuda"
ENV PATH="/app:${PATH}"

WORKDIR /app

VOLUME /db
VOLUME /app

CMD bash
Voor het gebruiksgemak zijn de gebruikte pakketten in variabelen geplaatst; het grootste deel van de geschreven scripts wordt tijdens de bouw in de containers gekopieerd. We hebben ook de commandoregel gewijzigd naar /bin/bash voor gebruiksgemak van de inhoud /etc/os-release. Dit maakte het mogelijk om de versies van het besturingssysteem niet in de code op te geven.
Daarnaast is er een klein bash-script geschreven waarmee de container met verschillende commando's kan worden uitgevoerd. Dit kunnen bijvoorbeeld scripts zijn voor het trainen van neurale netwerken, eerder in de container geplaatst, of de commandoregel voor foutopsporing en monitoring van de werking van de container:
Script om de container te starten
#!/bin/sh

DBDIR=${PWD}/db
LOGSDIR=${PWD}/logs
MODELDIR=${PWD}/models
DATADIR=${PWD}/data
ARGS="--runtime=nvidia --rm -v ${DBDIR}:/db -v ${LOGSDIR}:/app/logs -v ${MODELDIR}:/app/models -v ${DATADIR}:/app/data"

if [ -z "$1" ]; then
    CMD="Rscript /app/train_nn.R"
elif [ "$1" = "bash" ]; then
    ARGS="${ARGS} -ti"
else
    CMD="Rscript /app/train_nn.R $@"
fi

docker run ${ARGS} doodles-tf ${CMD}
Als dit bash-script zonder parameters wordt uitgevoerd, wordt er binnen de container een script aangeroepen train_nn.R met standaardwaarden; als het eerste positiekargument 'bash' is, wordt de container in interactieve modus gestart met een commandoregel. In alle andere gevallen worden de waarden van de positiekargumenten geplaatst: CMD="Rscript /app/train_nn.R $@".
Het is belangrijk op te merken dat de directories met de uitgangsgegevens en de database, evenals de directory voor het opslaan van getrainde modellen, vanuit het host-systeem in de container worden gemonteerd, waardoor toegang tot de resultaten van de scripts zonder extra handelingen mogelijk is.
7. Gebruik van meerdere GPU’s in Google Cloud
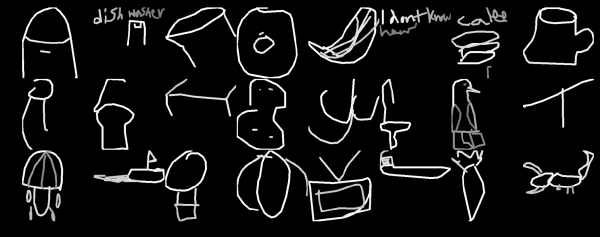
Een van de kenmerken van de competitie waren de behoorlijk rommelige gegevens (zie de titelafbeelding, ontleend aan @Leigh.plt uit ODS-slack). Grote batchgroottes helpen hierbij en na experimenten op een pc met 1 GPU besloten we om te leren modellen te trainen op meerdere GPU's in de cloud. We gebruikten Google Cloud () vanwege de grote keuze aan beschikbare configuraties, acceptabele prijzen en een bonus van $300. Uit hebzucht werd er een instantie besteld met 4xV100 met SSD en veel RAM, en dat was een grote fout. Zo'n machine verbruikt snel geld, je kunt jezelf failliet maken met experimenten zonder een goed werkende pipeline. Voor leerdoeleinden is het beter om een K80 te nemen. Maar de grote hoeveelheid RAM kwam goed van pas — de cloud-SSD viel tegen qua snelheid, dus de database werd bij elke instantie-activatie overgezet naar dev/shm.
Het meest interessante is het codefragment dat verantwoordelijk is voor het gebruik van meerdere GPU's. Eerst wordt het model aangemaakt op de CPU met behulp van een contextmanager, net als in Python:
with(tensorflow::tf$device("/cpu:0"), {
  model_cpu <- get_model(
    name = model_name,
    input_shape = input_shape,
    weights = weights,
    metrics = (top_3_categorical_accuracy,
    compile = FALSE
  )
})
Vervolgens wordt het niet-gecompileerde (dit is belangrijk) model gekopieerd naar het opgegeven aantal beschikbare GPU's, en pas daarna wordt het gecompileerd:
model <- keras::multi_gpu_model(model_cpu, gpus = n_gpu)
keras::compile(
  object = model,
  optimizer = keras::optimizer_adam(lr = 0.0004),
  loss = "categorical_crossentropy",
  metrics = c(top_3_categorical_accuracy)
)
Het klassieke idee om alle lagen te bevriezen, behalve de laatste, de laatste laag te trainen, deze te ontdooien en het model als geheel verder te trainen, kon niet worden gerealiseerd voor meerdere GPU’s.
Het training werd gevolgd zonder gebruik te maken van tensorboard, door alleen logboeken bij te houden en modellen met informatieve namen na elke epoch op te slaan:
Callbacks
# Шаблон имени файла лога
log_file_tmpl <- file.path("logs", sprintf(
  "%s_%d_%dch_%s.csv",
  model_name,
  dim_size,
  channels,
  format(Sys.time(), "%Y%m%d%H%M%OS")
))
# Шаблон имени файла модели
model_file_tmpl <- file.path("models", sprintf(
  "%s_%d_%dch_{epoch:02d}_{val_loss:.2f}.h5",
  model_name,
  dim_size,
  channels
))

callbacks_list <- list(
  keras::callback_csv_logger(
    filename = log_file_tmpl
  ),
  keras::callback_early_stopping(
    monitor = "val_loss",
    min_delta = 1e-4,
    patience = 8,
    verbose = 1,
    mode = "min"
  ),
  keras::callback_reduce_lr_on_plateau(
    monitor = "val_loss",
    factor = 0.5, # уменьшаем lr в 2 раза
    patience = 4,
    verbose = 1,
    min_delta = 1e-4,
    mode = "min"
  ),
  keras::callback_model_checkpoint(
    filepath = model_file_tmpl,
    monitor = "val_loss",
    save_best_only = FALSE,
    save_weights_only = FALSE,
    mode = "min"
  )
)
8. In plaats van een conclusie
Een aantal problemen waarmee we te maken hebben gehad, zijn tot nu toe niet opgelost:
- in keras er is geen kant-en-klare functie voor het automatisch zoeken naar de optimale leersnelheid (analogon van
lr_finderin de bibliotheek fast.ai); met enige inspanning kunnen externe implementaties naar R geport worden, zoals ; - als gevolg van het vorige punt, is het niet gelukt om de juiste leersnelheid te vinden bij het gebruik van meerdere GPU's;
- het ontbreekt aan moderne architecturen voor neurale netwerken, vooral die voorgetraind op imagenet;
- er is geen one cycle policy en discriminative learning rates (cosine annealing op ons verzoek was , bedankt ).
Wat nuttig is gebleken uit deze competitie:
- Op relatief bescheiden hardware is het mogelijk om zonder problemen te werken met aanzienlijke (ver uit het bereik van RAM) datavolumes. Het pakket data.table bespaart geheugen door in-place modificatie van tabellen, wat het mogelijk maakt om duplicatie te vermijden, en bij correct gebruik van zijn mogelijkheden toont het vrijwel altijd de hoogste snelheid van alle bekende tools voor script-talen. Het opslaan van data in een database zorgt er in veel gevallen voor dat je helemaal niet hoeft na te denken over de noodzaak om de hele dataset in het RAM te proppen.
- Langzame functies in R kunnen worden vervangen door snelle in C++ met behulp van het pakket Rcpp. Bovendien, als je RcppThread of RcppParallelgebruikt, krijg je cross-platform multi-threaded implementaties, zodat de R-code niet hoeft te worden geparelleliseerd.
- Met het pakket Rcpp kan je werken zonder uitgebreide kennis van C++, de nodige basis is uitgelegd . Headerbestanden voor een aantal geweldige C-bibliotheken, zoals xtensor zijn beschikbaar op CRAN, wat betekent dat er een infrastructuur wordt opgebouwd voor het integreren van kant-en-klare, high-performance C++-code in R-projecten. Een extra gemak is de syntax-highlighting en de statische code-analyzer voor C++ in RStudio.
- docopt maakt het mogelijk om zelfvoorzienende scripts met parameters uit te voeren. Dit is handig voor gebruik op een externe server, inclusief onder Docker. Het is onhandig om in RStudio vele uren experimenten met het trainen van neurale netwerken uit te voeren, en de installatie van de IDE op de server is niet altijd gerechtvaardigd.
- Docker zorgt voor code-portabiliteit en reproduceerbaarheid van resultaten tussen ontwikkelaars met verschillende versies van besturingssystemen en bibliotheken, evenals eenvoud in het starten op servers. Je kunt de hele pipeline voor training starten met slechts één commando.
- Google Cloud is een budgetvriendelijke manier om te experimenteren op dure hardware, maar het is belangrijk om de configuraties zorgvuldig te kiezen.
- Het meten van de snelheid van afzonderlijke codefragmenten is erg nuttig, vooral bij het combineren van R en C++, en met het pakket bench is het bovendien heel eenvoudig.
Over het algemeen was deze ervaring zeer nuttig, en we blijven werken aan het oplossen van enkele van de genoemde problemen.
Bron: habr.com
