

Inleiding
In dit artikel zal ik het bekende Huffman-algoritme uitleggen en hoe het wordt toegepast voor gegevenscompressie.
Uiteindelijk zullen we een eenvoudige archiver maken. Hierover was al een , maar zonder praktische implementatie. Het theoretische materiaal van deze post is afkomstig uit schoollessen informatica en uit het boek van Robert Lafore "Data Structures and Algorithms in Java". Dus, laten we beginnen!
Een paar overpeinzingen
In een gewone tekstbestand wordt één teken gecodeerd met 8 bits (ASCII-codering) of 16 (Unicode-codering). We zullen de ASCII-codering beschouwen. Als voorbeeld nemen we de string s1 = "SUSIE SAYS IT IS EASYn". De string bevat in totaal 22 tekens, inclusief spaties en het teken voor een nieuwe regel – 'n'. Het bestand met deze string heeft een grootte van 22*8 = 176 bits. De vraag rijst meteen: is het rationeel om alle 8 bits te gebruiken voor de codering van 1 teken? We gebruiken immers niet alle tekens van de ASCII-codering. Zelfs als we dat deden, zou het rationeler zijn om de meest voorkomende letter — S — de kortst mogelijke code te geven, en voor de minst voorkomende letter — T (of U, of 'n') — een langere code. Dat is de essentie van het Huffman-algoritme: het vinden van de optimale codering waarbij het bestand de kleinste grootte heeft. Het is volkomen normaal dat verschillende tekens verschillende code-lengtes hebben — dat is de basis van het algoritme.
Codering
Waarom zou de letter 'S' niet de code krijgen, bijvoorbeeld, met een lengte van 1 bit: 0 of 1. Laten we zeggen dat het 1 is. Dan geven we de tweede meest voorkomende letter — ' ' (spatie) — 0. Stel je voor dat je je bericht begint te decoderen — de gecodeerde string s1 — en je ziet dat de code begint met 1. Wat te doen: is dit letter S, of is het een ander teken, bijvoorbeeld A? Daarom is er een belangrijke regel:
Geen enkele code mag een prefix van een andere zijn
Deze regel is cruciaal in het algoritme. Daarom begint het maken van de code met een frequentietabel, waarin de frequentie (het aantal voorkomens) van elk teken is aangegeven:
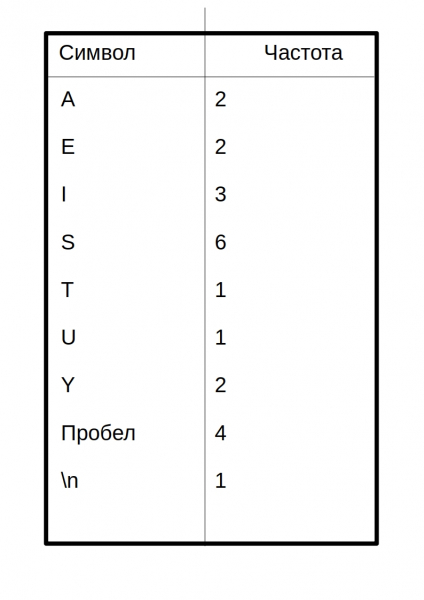 Tekens met de meeste voorkomens moeten worden gecodeerd met het kleinste mogelijke aantal bits. Ik geef een voorbeeld van een mogelijke code-tabel:
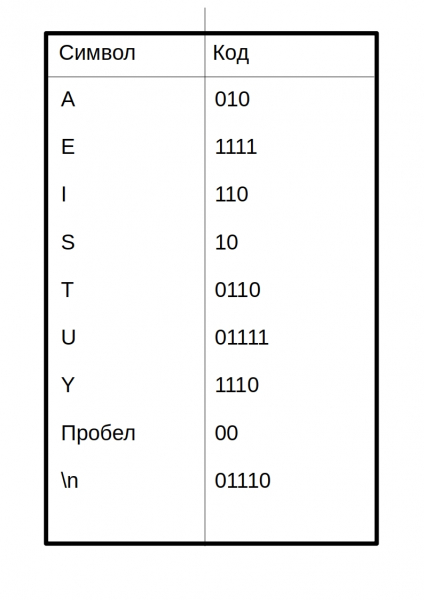 Daarom ziet het gecodeerde bericht er als volgt uit:
10 01111 10 110 1111 00 10 010 1110 10 00 110 0110 00 110 10 00 1111 010 10 1110 01110 Ik heb de code van elk teken gescheiden met een spatie. Eigenlijk zal dit in het gecomprimeerde bestand niet zo zijn!
Hieruit volgt de vraag: hoe heeft deze beginner de code verzonnen om een codeertabel te maken? Dit wordt verderop besproken.
Opbouw van de Huffman-boom
Hier komen binaire zoekbomen van pas. Maak je geen zorgen, hier zijn zoek-, invoeg- en verwijdermethoden niet nodig. Hier is de boomstructuur in java:
public class Node {
    private int frequentie;
    private char letter;
    private Node linkerKind;
    private Node rechterKind;
    ...
}
class BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }
    public BinaryTree(Node root) {
        this.root = root;
    }
    ...
}
Dit is niet de volledige code, de volledige code komt hieronder.
Hier is het algoritme voor het opbouwen van de boom:
- Maak een Node-object voor elk teken uit het bericht (string s1). In ons geval zullen er 9 knooppunten (Node-objecten) zijn. Elk knooppunt bestaat uit twee datavelden: teken en frequentie.
- Maak een Boom-object (BinaryTree) voor elk van de Node-knooppunten. Het knooppunt wordt de wortel van de boom.
- Plaats deze bomen in een prioriteitswachtrij. Hoe lager de frequentie, hoe hoger de prioriteit. Bij het extraheren wordt altijd de boom met de laagste frequentie gekozen.
Vervolgens moet je herhaaldelijk het volgende doen:
- Trek twee bomen uit de prioriteitswachtrij en maak ze de kinderen van een nieuw knooppunt (net gecreëerd knooppunt zonder letter). De frequentie van het nieuwe knooppunt is de som van de frequenties van de twee kinder-bomen.
- Maak voor dit knooppunt een boom met de wortel in dit knooppunt. Plaats deze boom terug in de prioriteitswachtrij. (Aangezien de boom een nieuwe frequentie heeft, zal deze waarschijnlijk een nieuwe plek in de wachtrij innemen.)
- Ga door met het uitvoeren van stappen 1 en 2 totdat er nog maar één boom in de wachtrij overblijft - de Huffman-boom.
Laten we dit algoritme bekijken op de string s1:
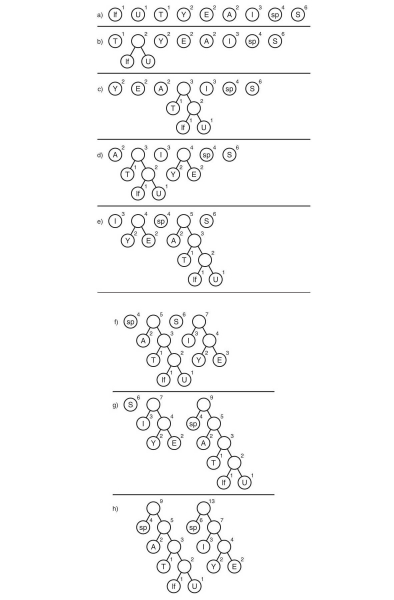
Hier staat het teken "lf" (linefeed) voor een nieuwe regel, "sp" (space) is een spatie.
En wat nu?
We hebben de Huffman-boom verkregen. Oké, en wat nu? Je krijgt het niet eens gratis. Verder moet je alle mogelijke paden van de wortel naar de bladeren van de boom volgen. Laten we overeenkomen dat een rand 0 is als deze naar het linker kind leidt en 1 als deze naar het rechter kind leidt. Strikt genomen is in deze aanduidingen de code van een teken het pad van de wortel van de boom naar het blad dat dat teken bevat.
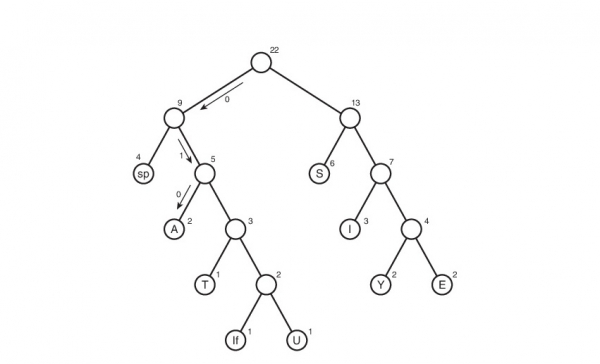
Op deze manier is de code tabel tot stand gekomen. Laten we opmerken dat als we deze tabel bekijken, we een conclusie kunnen trekken over het 'gewicht' van elk teken — dit is de lengte van zijn code. Dan zal het oorspronkelijke bestand in gecomprimeerde vorm wegen: 2 * 3 + 2*4 + 3 * 3 + 6 * 2 + 1 * 4 + 1 * 5 + 2 * 4 + 4 * 2 + 1 * 5 = 65 bits. Aanvankelijk woog het 176 bits. Daarom hebben we het met maar liefst 176/65 = 2,7 keer verminderd! Maar dat is een utopie. Zo'n coefficient zal waarschijnlijk niet worden bereikt. Waarom? Daarover meer later.
Decoderen
Nou, waarschijnlijk is het meest eenvoudige nu aan de beurt — decoderen. Ik denk dat velen van jullie al hebben geraden dat je gewoon geen gecomprimeerd bestand kunt maken zonder enige aanwijzing over hoe het gecodeerd is — we kunnen het niet decoderen! Ja, ik vond het moeilijk om dat te beseffen, maar we moeten een tekstbestand table.txt maken met de compressietabel:
01110
 00
A010
E1111
I110
S10
T0110
U01111
Y1110
De tabel opschrijven in de vorm van 'symbool' "code van het symbool". Waarom 01110 zonder symbool? Eigenlijk heeft het een symbool, maar de java-tools die ik heb gebruikt voor het afdrukken naar het bestand converteren het newline-teken — 'n' — naar een nieuwe regel (hoe dwaas dat ook mag klinken). Daarom is de lege regel boven het symbool voor de code 01110. Voor de code 00 is het symbool een spatie aan het begin van de regel. Ik zal meteen zeggen dat deze manier van opslaan van de tabel de minst efficiënte kan zijn. Maar hij is gemakkelijk te begrijpen en te implementeren. Ik hoor graag jullie aanbevelingen in de opmerkingen over optimalisatie.
Met deze tabel is het heel eenvoudig om te decoderen. Laten we herinneren aan de regel die we volgden bij het creëren van de codering:
Geen enkele code mag een prefix van een andere zijn.
Hier speelt het zijn verlichtende rol. We lezen de bits één voor één en zodra de verkregen string d, die bestaat uit de gelezen bits, overeenkomt met de codering die overeenkomt met het symbool character, weten we meteen dat het symbool character is gecodeerd (en alleen dat!). Daarna schrijven we character in de decodering string (de string die de gedecodeerde boodschap bevat), resetten we de string d, en lezen verder in het gecomprimeerde bestand.
Implementatie
Het is tijd om mijn code te vernederen en een archiver te schrijven. Laten we het Compressor noemen.
Laten we bij het begin beginnen. Als eerste schrijven we de klasse Node:
public class Node {
    private int frequence; // frequentie
    private char letter; // letter
    private Node leftChild; // linker kind
    private Node rightChild; // rechter kind

    public Node(char letter, int frequence) { // constructor
        this.letter = letter;
        this.frequence = frequence;
    }

    public Node() {} // constructor voor naamloze knopen (zie hierboven bij de opbouw van de Huffman-boom)
    public void addChild(Node newNode) { // voeg kind toe
        if (leftChild == null) // als links leeg is => rechts ook leeg => voeg toe aan links
            leftChild = newNode;
        else {
            if (leftChild.getFrequence() <= newNode.getFrequence()) // als de frequentie van de linker kind kleiner of gelijk is
                rightChild = newNode; // wordt de rechter kind, die minder frequentie heeft
            else {
                rightChild = leftChild;
                leftChild = newNode;
            }
        }

        frequence += newNode.getFrequence(); // totale frequentie
    }

    public Node getLeftChild() {
        return leftChild;
    }

    public Node getRightChild() {
        return rightChild;
    }

    public int getFrequence() {
        return frequence;
    }

    public char getLetter() {
        return letter;
    }

    public boolean isLeaf() { // controleer of het een blad is
        return leftChild == null && rightChild == null;
    }
}
Nu de boom:
class BinaryTree {
    private Node root;

    public BinaryTree() {
        root = new Node();
    }

    public BinaryTree(Node root) {
        this.root = root;
    }

    public int getFrequence() {
        return root.getFrequence();
    }

    public Node getRoot() {
        return root;
    }
}
Prioriteitswachtrij:
import java.util.ArrayList; // ja ja, de wachtrij is gebaseerd op een lijst

class PriorityQueue {
    private ArrayList data; // lijst van de wachtrij
    private int nElems; // aantal elementen in de wachtrij

    public PriorityQueue() {
        data = new ArrayList();
        nElems = 0;
    }

    public void insert(BinaryTree newTree) { // invoegen
        if (nElems == 0)
            data.add(newTree);
        else {
            for (int i = 0; i  newTree.getFrequence()) { // als de frequentie van de nieuwe boom kleiner is
                    data.add(i, newTree); // dan verschuif alle bomen rechts met 1 positie
                    break; // plaats de nieuwe boom op de positie van de huidige
                }
                if (i == nElems - 1)
                    data.add(newTree);
            }
        }
        nElems++; // verhoog het aantal elementen met 1
    }

    public BinaryTree remove() { // verwijder uit de wachtrij
        BinaryTree tmp = data.get(0); // kopieer het te verwijderen element
        data.remove(0); // verwijder het element
        nElems--; // verlaag het aantal elementen met 1
        return tmp; // retourneer het verwijderde element (element met de laagste frequentie)
    }
}
Klasse die de Huffman-boom aanmaakt:
public class HuffmanTree {
    private final byte ENCODING_TABLE_SIZE = 127; // de lengte van de coderingstabel
    private String myString; // bericht
    private BinaryTree huffmanTree; // Huffman-boom
    private int[] freqArray; // frequentietabel
    private String[] encodingArray; // coderingstabel


    //----------------constructor----------------------
    public HuffmanTree(String newString) {
        myString = newString;

        freqArray = new int[ENCODING_TABLE_SIZE];
        fillFrequenceArray();

        huffmanTree = getHuffmanTree();

        encodingArray = new String[ENCODING_TABLE_SIZE];
        fillEncodingArray(huffmanTree.getRoot(), "", "");
    }

    //--------------------frequence array------------------------
    private void fillFrequenceArray() {
        for (int i = 0; i < myString.length(); i++) {
            freqArray[(int)myString.charAt(i)]++;
        }
    }

    public int[] getFrequenceArray() {
        return freqArray;
    }

    //------------------------huffman tree creation------------------
    private BinaryTree getHuffmanTree() {
        PriorityQueue pq = new PriorityQueue();
        // het algoritme is hierboven beschreven
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) { // als het symbool bestaat in de string
                Node newNode = new Node((char) i, freqArray[i]); // maak een Node voor hem
                BinaryTree newTree = new BinaryTree(newNode); // en maak een BinaryTree voor de Node
                pq.insert(newTree); // voeg toe aan de wachtrij
            }
        }

        while (true) {
            BinaryTree tree1 = pq.remove(); // haal de eerste boom uit de wachtrij.

            try {
                BinaryTree tree2 = pq.remove(); // haal de tweede boom uit de wachtrij

                Node newNode = new Node(); // maak een nieuwe Node
                newNode.addChild(tree1.getRoot()); // maak de twee geëxtraheerde bomen kinderen
                newNode.addChild(tree2.getRoot());

                pq.insert(new BinaryTree(newNode);
            } catch (IndexOutOfBoundsException e) { // er is nog maar één boom in de wachtrij
                return tree1;
            }
        }
    }

    public BinaryTree getTree() {
        return huffmanTree;
    }

    //-------------------encoding array------------------
    void fillEncodingArray(Node node, String codeBefore, String direction) { // vul de coderingstabel
        if (node.isLeaf()) {
            encodingArray[(int)node.getLetter()] = codeBefore + direction;
        } else {
            fillEncodingArray(node.getLeftChild(), codeBefore + direction, "0");
            fillEncodingArray(node.getRightChild(), codeBefore + direction, "1");
        }
    }

    String[] getEncodingArray() {
        return encodingArray;
    }

    public void displayEncodingArray() { // voor debugging
        fillEncodingArray(huffmanTree.getRoot(), "", "");

        System.out.println("======================Coderingstabel====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            }
        }
        System.out.println("========================================================");
    }
    //-----------------------------------------------------
    String getOriginalString() {
        return myString;
    }
}
De klasse die codeert/decodeert:
public class HuffmanOperator {
    private final byte ENCODING_TABLE_SIZE = 127; // lengte van de tabel
    private HuffmanTree mainHuffmanTree; // Huffman-boom (gebruikt alleen voor compressie)
    private String myString; // oorspronkelijke boodschap
    private int[] freqArray; // frequentietabel
    private String[] encodingArray; // codeertabel
    private double ratio; // compressieverhouding


    public HuffmanOperator(HuffmanTree MainHuffmanTree) { // voor compressie
        this.mainHuffmanTree = MainHuffmanTree;

        myString = mainHuffmanTree.getOriginalString();

        encodingArray = mainHuffmanTree.getEncodingArray();

        freqArray = mainHuffmanTree.getFrequenceArray();
    }

    public HuffmanOperator() {} // voor extractie;

    // ---------------------------------------compressie-----------------------------------------------------------
    private String getCompressedString() {
        String compressed = "";
        String intermidiate = ""; // tussenliggende string (zonder toegevoegde nullen)
        // System.out.println("=============================Compressie=======================");
        // displayEncodingArray();
        for (int i = 0; i
        // we moeten nullen aan het einde toevoegen (kan 1 zijn, geen verschil)
        byte counter = 0; // aantal toegevoegde nullen aan het einde (byte is voldoende: 0 <= counter < 8 < 127)
        for (int length = intermidiate.length(), delta = 8 - length % 8;
                counter < delta ; counter++) { // delta - aantal toegevoegde nullen
            intermidiate += "0";
        }

        // voeg het aantal toegevoegde nullen in binaire weergave samen met de tussenliggende string
        compressed = String.format("%8s", Integer.toBinaryString(counter & 0xff)).replace(" ", "0") + intermidiate;

        // geïdealiseerde verhouding
        setCompressionRatio();
        // System.out.println("===============================================================");
        return compressed;
    }

    private void setCompressionRatio() { // bereken de geïdealiseerde verhouding
        double sumA = 0, sumB = 0; // A - de oorspronkelijke som
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            if (freqArray[i] != 0) {
                sumA += 8 * freqArray[i];
                sumB += encodingArray[i].length() * freqArray[i];
            }
        }
        ratio = sumA / sumB;
    }

    public byte[] getBytedMsg() { // finale compressie
        StringBuilder compressedString = new StringBuilder(getCompressedString());
        byte[] compressedBytes = new byte[compressedString.length() / 8];
        for (int i = 0; i < compressedBytes.length; i++) {
                compressedBytes[i] = (byte) Integer.parseInt(compressedString.substring(i * 8, (i + 1) * 8), 2);
        }
        return compressedBytes;
    }
    // ---------------------------------------einde van compressie----------------------------------------------------------------
    // ------------------------------------------------------------extract-----------------------------------------------------
    public String extract(String compressed, String[] newEncodingArray) {
        String decompressed = "";
        String current = "";
        String delta = "";
        encodingArray = newEncodingArray;

        // displayEncodingArray();
        // krijg het aantal toegevoegde nullen
        for (int i = 0; i < 8; i++)
            delta += compressed.charAt(i);
        int ADDED_ZEROES = Integer.parseInt(delta, 2);

        for (int i = 8, l = compressed.length() - ADDED_ZEROES; i < l; i++) {
            // i = 8, omdat de eerste byte het aantal toegevoegde nullen bevat
            current += compressed.charAt(i);
            for (int j = 0; j < ENCODING_TABLE_SIZE; j++) {
                if (current.equals(encodingArray[j])) { // als het overeenkomt
                    decompressed += (char)j; // voeg element toe
                    current = ""; // en reset de huidige string
                }
            }
        }

        return decompressed;
    }

    public String getEncodingTable() {
        String enc = "";
        for (int i = 0; i < encodingArray.length; i++) {
            if (freqArray[i] != 0)
                enc += (char)i + encodingArray[i] + 'n';
        }
        return enc;
    }

    public double getCompressionRatio() {
        return ratio;
    }


    public void displayEncodingArray() { // voor debugging
        System.out.println("======================Codeertabel====================");
        for (int i = 0; i < ENCODING_TABLE_SIZE; i++) {
            // if (freqArray[i] != 0) {
                System.out.print((char)i + " ");
                System.out.println(encodingArray[i]);
            // }
        }
        System.out.println("========================================================");
    }
}
Klasse die het schrijven naar een bestand vergemakkelijkt:
import java.io.File;
import java.io.PrintWriter;
import java.io.FileNotFoundException;
import java.io.FileOutputStream;
import java.io.IOException;
import java.io.Closeable;

public class FileOutputHelper implements Closeable {
    private File outputFile;
    private FileOutputStream fileOutputStream;

    public FileOutputHelper(File file) throws FileNotFoundException {
        outputFile = file;
        fileOutputStream = new FileOutputStream(outputFile);
    }

    public void writeByte(byte msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeBytes(byte[] msg) throws IOException {
        fileOutputStream.write(msg);
    }

    public void writeString(String msg) {
    	try (PrintWriter pw = new PrintWriter(outputFile)) {
    		pw.write(msg);
    	} catch (FileNotFoundException e) {
    		System.out.println("Ongeldig pad of bestand bestaat niet!");
    	}
    }

    @Override
    public void close() throws IOException {
        fileOutputStream.close();
    }

    public void finalize() throws IOException {
        close();
    }
}
Klasse die het lezen uit een bestand vergemakkelijkt:
import java.io.FileInputStream;
import java.io.EOFException;
import java.io.BufferedReader;
import java.io.InputStreamReader;
import java.io.Closeable;
import java.io.File;
import java.io.IOException;

public class FileInputHelper implements Closeable {
	private FileInputStream fileInputStream;
	private BufferedReader fileBufferedReader;

	public FileInputHelper(File file) throws IOException {
		fileInputStream = new FileInputStream(file);
		fileBufferedReader = new BufferedReader(new InputStreamReader(fileInputStream));
	}


    public byte readByte() throws IOException {
    	int cur = fileInputStream.read();
    	if (cur == -1) // als het bestand is afgelopen
    		throw new EOFException();
    	return (byte)cur;
    }

    public String readLine() throws IOException {
    	return fileBufferedReader.readLine();
    }

    @Override
    public void close() throws IOException{
    	fileInputStream.close();
    }
}
En de hoofdklasse:
import java.io.File;
import java.nio.charset.MalformedInputException;
import java.io.FileNotFoundException;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.NoSuchFileException;
import java.nio.file.Paths;
import java.util.List;
import java.io.EOFException;
public class Main {
	private static final byte ENCODING_TABLE_SIZE = 127;

    public static void main(String[] args) throws IOException {
        try { // geven we de instructie door middel van commandoregelargumenten
            if (args[0].equals("--compress") || args[0].equals("-c"))
                compress(args[1]);
            else if ((args[0].equals("--extract") || args[0].equals("-x"))
            		&& (args[2].equals("--table") || args[2].equals("-t"))) {
            	extract(args[1], args[3]);
            }
            else
                throw new IllegalArgumentException();
        } catch (ArrayIndexOutOfBoundsException | IllegalArgumentException e) {
            System.out.println("Ongeldig formaat voor invoerargumenten ");
            System.out.println("Lees Readme.txt");
            e.printStackTrace();
        }
    }

	public static void compress(String stringPath) throws IOException {
        List stringList;
        File inputFile = new File(stringPath);
        String s = "";
        File compressedFile, table;

        try {
            stringList = Files.readAllLines(Paths.get(inputFile.getAbsolutePath()));
        } catch (NoSuchFileException e) {
            System.out.println("Ongeldig pad of bestand bestaat niet!");
            return;
        } catch (MalformedInputException e) {
        	System.out.println("De huidige codering van het bestand wordt niet ondersteund");
        	return;
        }

        for (String item : stringList) {
            s += item;
            s += 'n';
        }

        HuffmanOperator operator = new HuffmanOperator(new HuffmanTree(s));

        compressedFile = new File(inputFile.getAbsolutePath() + ".cpr");
        compressedFile.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(compressedFile)) {
        	fo.writeBytes(operator.getBytedMsg());
        }
        // maak bestand met coderingstabel:

        table = new File(inputFile.getAbsolutePath() + ".table.txt");
        table.createNewFile();
        try (FileOutputHelper fo = new FileOutputHelper(table)) {
        	fo.writeString(operator.getEncodingTable());
        }

        System.out.println("Pad naar gecomprimeerd bestand: " + compressedFile.getAbsolutePath());
        System.out.println("Pad naar coderingstabel " + table.getAbsolutePath());
        System.out.println("Zonder tabel kan het bestand niet worden uitgepakt!");

        double idealRatio = Math.round(operator.getCompressionRatio() * 100) / (double) 100; // geidealiseerde ratio
        double realRatio = Math.round((double) inputFile.length()
        		/ ((double) compressedFile.length() + (double) table.length()) * 100) / (double)100; // echte ratio

        System.out.println("De geidealiseerde compressieverhouding is " + idealRatio);
        System.out.println("De compressieverhouding met de coderingstabel is " + realRatio);
    }

    public static void extract(String filePath, String tablePath) throws FileNotFoundException, IOException {
        HuffmanOperator operator = new HuffmanOperator();
        File compressedFile = new File(filePath),
        	 tableFile = new File(tablePath),
        	 extractedFile = new File(filePath + ".xtr");
        String compressed = "";
        String[] encodingArray = new String[ENCODING_TABLE_SIZE];
        // lees gecomprimeerd bestand
        // !!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!!! check hier:
        try (FileInputHelper fi = new FileInputHelper(compressedFile)) {
        	byte b;
        	while (true) {
        		b = fi.readByte(); // methode retourneert EOFException
        		compressed += String.format("%8s", Integer.toBinaryString(b & 0xff)).replace(" ", "0");
        	}
        } catch (EOFException e) {

        }

        // --------------------

        // lees coderingstabel:
        try (FileInputHelper fi = new FileInputHelper(tableFile)) {
        	fi.readLine(); // sla eerste lege regel over
        	encodingArray[(byte)'n'] = fi.readLine(); // lees code voor 'n'
        	while (true) {
        		String s = fi.readLine();
        		if (s == null)
        			throw new EOFException();
        		encodingArray[(byte)s.charAt(0)] = s.substring(1, s.length());
        	}
        } catch (EOFException ignore) {}

        extractedFile.createNewFile();
        // extract:
		try (FileOutputHelper fo = new FileOutputHelper(extractedFile)) {
			fo.writeString(operator.extract(compressed, encodingArray));
		}

		System.out.println("Pad naar uitgepakt bestand " + extractedFile.getAbsolutePath());
    }
}
Het bestand met instructies readme.txt moet je zelf schrijven 🙂
Conclusie
Dat is waarschijnlijk alles wat ik wilde zeggen. Als je iets wilt zeggen over mijn incompetentie met betrekking tot verbeteringen in de code, het algoritme, of enige optimalisatie, aarzel dan niet om te schrijven. Ook als ik iets niet goed heb uitgelegd, laat het me weten. Ik kijk ernaar uit om je in de reacties te horen!
P.S.
Ja, ja, ik ben nog steeds hier, want ik ben de factor niet vergeten. Voor de string s1 is de coderingsmatrix 48 bytes groot — veel groter dan het oorspronkelijke bestand, en vergeet de toegevoegde nullen niet (het aantal toegevoegde nullen is 7) => de compressiefactor zal minder dan één zijn: 176/(65 + 48*8 + 7)=0.38. Als je dat ook hebt opgemerkt, dan ben je goed bezig. Ja, deze implementatie zal erg ineffectief zijn voor kleine bestanden. Maar wat gebeurt er met grote bestanden? De bestandsgrootte overschrijdt de grootte van de coderingsmatrix aanzienlijk. Hier werkt het algoritme zoals het hoort! Bijvoorbeeld, voor geeft de archiveringssoftware een werkelijke (niet-geïdealiseerde) factor van 1.46 — bijna anderhalf keer! En ja, het was de bedoeling dat het bestand in het Engels zou zijn.
Bron: habr.com
