

Filosofische inleiding
Zoals bekend zijn er maar twee methoden om problemen op te lossen:
- Analyse methode of deductieve methode, van algemeen naar specifiek.
- Synthese methode of inductieve methode, van specifiek naar algemeen.
Voor het probleem 'de prestaties van de database verbeteren' kan dit er als volgt uitzien.
Analyse — we ontleden het probleem in afzonderlijke delen en proberen door deze op te lossen de prestaties van de database als geheel te verbeteren.
In de praktijk ziet analyse er ongeveer zo uit:
- Er verschijnt een probleem (prestatie-incident)
- We verzamelen statistische informatie over de status van de database
- We zoeken naar knelpunten (bottlenecks)
- We lossen de problemen met de knelpunten op
Knelpunten van de database — infrastructuur (CPU, Geheugen, Schijven, Netwerk, OS), instellingen (postgresql.conf), queries:
Infrastructuur: mogelijkheden voor invloed en veranderingen voor de engineer — bijna nul.
Database-instellingen: mogelijkheden voor wijzigingen zijn iets groter dan in de vorige geval, maar zijn meestal toch behoorlijk moeilijk, vooral in de cloud.
Queries naar de database: de enige ruimte voor manoeuvre.
Synthese — we verbeteren de prestaties van afzonderlijke delen, in de verwachting dat de prestaties van de database als geheel zullen verbeteren.
Lyrische inleiding of waarom is dit allemaal nodig
Hoe verloopt het proces van het oplossen van prestatie-incidenten als de prestaties van de database niet worden gemonitord:
Klant - “het gaat slecht, het is traag, maak het goed voor ons”
Engineer - “wat bedoelt u met slecht?”
Klant – “zo als het nu is (een uur geleden, gisteren, tijdens de laatste keer), langzaam”
Engineer – “en wanneer was het goed?”
Klant – “een week (twee weken) geleden was het niet slecht.” (Dat was geluk)
Klant – “en ik herinner me niet wanneer het goed was, maar het is nu slecht” (Gewoonlijk antwoord)
Uiteindelijk krijgen we een klassiek beeld:
Wie is verantwoordelijk en wat te doen?
De eerste vraag is het gemakkelijkst te beantwoorden — de engineer DBA is altijd verantwoordelijk.
De tweede vraag is ook niet te complex te beantwoorden — er moet een systeem voor prestatiemonitoring van de database worden ingevoerd.
De eerste vraag rijst — wat te monitoren?
Pad 1. We zullen ALLES monitoren
De CPU-belasting, het aantal schijflees- en schrijfoperaties, de toegewezen geheugengrootte en nog een megaton aan verschillende statistieken die elk redelijk werkend monitoringssysteem kan bieden.
Dit resulteert in een berg grafieken, samenvattende tabellen en continue meldingen per e-mail, en 100% bezetheid van de ingenieur met het oplossen van een hoop identieke tickets, maar meestal met de standaardzin – “Tijdelijk probleem. Geen actie nodig.” Maar iedereen is druk, en er is altijd iets om aan de klant te tonen – het werk gaat door.
Methode 2. Alleen monitoren wat nodig is, en wat niet nodig is, hoeft niet gemonitord te worden.
Je kunt het iets anders monitoren - alleen entiteiten en gebeurtenissen:
- waar de DBA-ingenieur invloed op kan uitoefenen.
- Voor welke er een actie-algoritme bestaat bij het optreden van een gebeurtenis of wijziging van een entiteit.
Vanuit deze veronderstelling en in herinnering aan “Filosofische inleiding” om regelmatig herhaling van “Lyrische inleiding of waarom is dit allemaal nodig” te vermijden, is het zinvol om de prestaties van afzonderlijke queries te monitoren, om optimalisatie en analyse mogelijk te maken, wat uiteindelijk moet leiden tot een verbetering van de algehele prestaties van de database.
Maar om een zware query die invloed heeft op de algehele databaseprestaties te verbeteren, moet je deze eerst vinden.
Dus ontstaan er twee onderling verbonden vragen:
- wat wordt als een zware query beschouwd?
- hoe zoek je naar zware queries.
Het is duidelijk dat een zware query een query is die veel middelen van het besturingssysteem gebruikt om een resultaat te verkrijgen.
Laten we overgaan naar de tweede vraag – hoe zoek je en monitor je vervolgens zware queries?
Welke mogelijkheden zijn er voor het monitoren van queries in PostgreSQL?
In vergelijking met Oracle zijn er niet veel mogelijkheden, maar toch kan er iets gedaan worden.
PG_STAT_STATEMENTS
Voor het zoeken naar en monitoren van zware queries in PostgreSQL is de standaard extensie pg_stat_statements bedoeld.
Na installatie van de extensie verschijnt er een gelijknamig view in de doeldatabase die gebruikt moet worden voor monitoringsdoeleinden.
Doelkolommen van pg_stat_statements voor het opzetten van een monitoringsysteem:
- queryid Interne hashcode, berekend op basis van de parse-boom van de operator.
- max_time Maximale tijd, besteed aan de operator, in milliseconden.
Door de statistieken van deze twee kolommen te verzamelen en te gebruiken, kan een monitoringsysteem worden opgebouwd.
Hoe pg_stat_statements wordt gebruikt voor het monitoren van de prestaties van PostgreSQL.
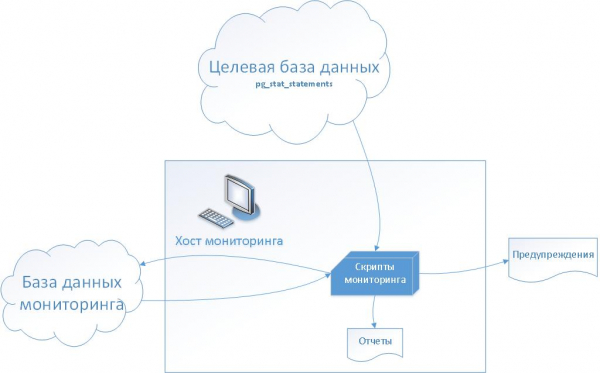
Voor het monitoren van de prestaties van verzoeken wordt gebruikt:
Aan de kant van de doel-database — het weergave pg_stat_statements
Aan de kant van de server en de database monitoring — een set bash-scripts en service-tabellen.
Fase 1 — het verzamelen van statistische gegevens
Op de host voor monitoring wordt regelmatig een script uitgevoerd via cron dat de inhoud van de weergave pg_stat_statements van de doel-database kopieert naar de tabel pg_stat_history in de monitoring-database.
Op deze manier wordt een geschiedenis van de uitvoering van afzonderlijke verzoeken gevormd, die kan worden gebruikt voor het genereren van prestatierapporten en het instellen van metrics.
Fase 2 — het instellen van prestatiemetrics
Gebaseerd op de verzamelde gegevens selecteren we de verzoeken waarvan de uitvoering het kritischst/belangrijkst is voor de klant (applicatie). In overleg met de opdrachtgever stellen we de waarden van de prestatiemetrics in met behulp van de velden queryid en max_time.
Resultaat — start van de prestatiemonitoring
- Het monitoring-script controleert bij de start de geconfigureerde prestatiemetrics door de waarde van de max_time metric te vergelijken met de waarde uit de weergave pg_stat_statements in de doel-database.
- Als de waarde in de doel-database de waarde van de metric overschrijdt, wordt er een waarschuwing gegenereerd (incident in het ticketsysteem)
Extra mogelijkheid 1
Geschiedenis van uitvoeringsplannen van verzoeken
Voor het oplossen van prestatietincidenten is het zeer nuttig om een geschiedenis te hebben van de wijzigingen in de uitvoeringsplannen van verzoeken.
Voor het opslaan van de geschiedenis wordt de service-tabel log_query gebruikt. De tabel wordt gevuld tijdens de analyse van het geüploade logbestand van PostgreSQL. Aangezien het logbestand, in tegenstelling tot de weergave pg_stat_statements, de volledige tekst met uitvoeringsparameters bevat, in plaats van de genormaliseerde tekst, is het mogelijk om niet alleen de tijd en duur van verzoeken te loggen, maar ook de uitvoeringsplannen op dat moment op te slaan.
Extra mogelijkheid 2
Doorlopend proces van prestatieverbetering
Monitoring van individuele aanvragen is in het algemeen niet bedoeld voor het continu verbeteren van de prestaties van de database als geheel, omdat het zich alleen richt op de prestaties van individuele aanvragen. Het is echter mogelijk om de methode uit te breiden en monitoring in te stellen voor alle databases.
Hiervoor moeten extra prestatiestatistieken worden ingevoerd:
- In de afgelopen dagen
- Voor de basisperiode
Het script selecteert aanvragen uit de weergave pg_stat_statements in de doel-database en vergelijkt de waarde van max_time met de gemiddelde waarde van max_time; in het eerste geval voor de afgelopen dagen of voor de gekozen periode (baseline), in het tweede geval.
Dus in geval van prestatievermindering voor een willekeurige aanvraag, wordt er automatisch een waarschuwing gegenereerd, zonder handmatige analyse van rapporten.
Wat heeft synthese hiermee te maken?
In de beschreven benadering, zoals de synthese-methode impliceert, verbeteren we het systeem als geheel door de afzonderlijke delen van het systeem te verbeteren.
- De aanvraag die door de database wordt uitgevoerd – these
- De gewijzigde aanvraag – antithese
- Verandering van de staat van het systeem — synthese
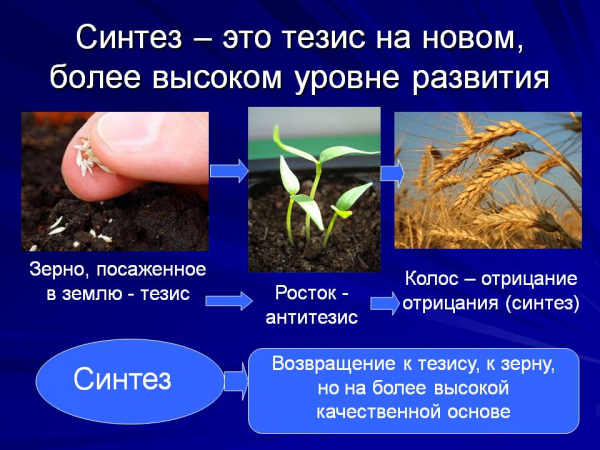
Ontwikkeling van het systeem
- Uitbreiding van de verzamelde statistieken door geschiedenis toe te voegen aan de systeembweergave pg_stat_activity
- Uitbreiding van de verzamelde statistieken door geschiedenis toe te voegen voor de statistieken van individuele tabellen die betrokken zijn bij de aanvragen
- Integratie met het monitoring systeem in de AWS cloud
- En verder, we kunnen nog iets verzinnen…
Bron: habr.com
