

Sommige bedrijven, waaronder onze klant, ontwikkelen hun product via een partnernetwerk. Bijvoorbeeld, grote webwinkels zijn geïntegreerd met een bezorgdienst — je bestelt een product en ontvangt al snel een trackingnummer voor je pakket. Een ander voorbeeld is dat je bij het kopen van een vliegticket ook een verzekering of een ticket voor de luchtexpress aanschaft.
Hiervoor wordt één API gebruikt, die aan partners moet worden verstrekt via API Gateway. Deze taak hebben wij opgelost. In dit artikel vertellen we de details.
Gegeven: ecosysteem en API-portaal met een interface, waar gebruikers zijn geregistreerd, informatie ontvangen enzovoort. Wij moeten een gebruiksvriendelijke en betrouwbare API Gateway maken. Tijdens dit proces moesten we zorgen voor
- registratie,
- controle van de verbinding met de API,
- monitoring van hoe gebruikers het eindproduct gebruiken,
- het bijhouden van bedrijfsindicatoren.
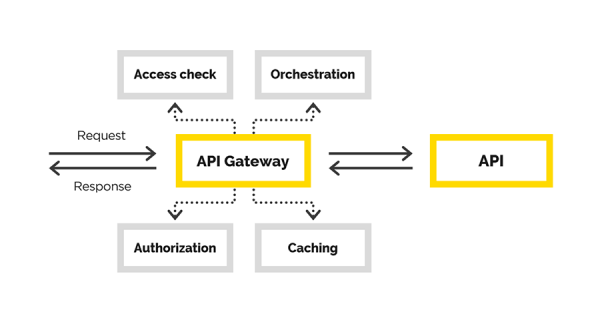
In dit artikel zullen we onze ervaring met het creëren van een API Gateway delen, waarbij we de volgende taken hebben opgelost:
- gebruikerauthenticatie,
- gebruikersautorisatie,
- wijziging van de oorspronkelijke aanvraag,
- proxy voor de aanvraag,
- nabewerking van het antwoord.
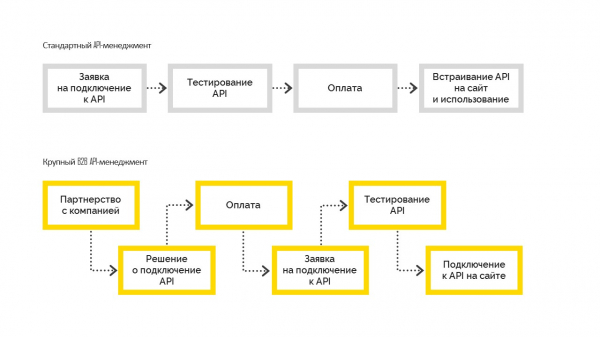
Er zijn twee soorten API-beheer:
1. Standaard, die als volgt werkt. Voor de verbinding test de gebruiker de mogelijkheden, betaalt vervolgens en integreert deze op zijn website. Dit wordt vaak gebruikt in het klein- en middenbedrijf.
2. Grootschalig B2B API Management, waarbij het bedrijf eerst een zakelijke beslissing neemt over de aansluiting, partner wordt van het bedrijf met een contractuele verplichting, en daarna verbindt met de API. Pas na het regelen van alle formaliteiten ontvangt het bedrijf toegang voor testen, doorloopt de test en gaat de productie in. Maar dit is onmogelijk zonder een managementbeslissing over de aansluiting.
Onze oplossing
In dit gedeelte zullen we het creëren van de API Gateway bespreken.
De eindgebruikers van de te creëren API-gateway zijn de partners van onze klant. Voor elk van hen hebben we al de benodigde contracten. We moeten alleen de functionaliteit uitbreiden door de geboden toegang tot de gateway te markeren. Hierbij is een gecontroleerd proces van verbinding en beheer vereist.
Zonder twijfel hadden we een kant-en-klare oplossing voor API Management en het creëren van een API Gateway kunnen gebruiken. Bijvoorbeeld, dat zou kunnen zijn. Het paste niet bij ons, omdat we al een API-portaal hadden en een enorme ecosysteem eromheen. Alle gebruikers waren al geregistreerd en wisten al waar en hoe ze de benodigde informatie konden krijgen. In het API-portaal bestonden de benodigde interfaces al, we hadden alleen een API Gateway nodig. Eigenlijk zijn we daarmee aan de slag gegaan.
Wat we API Gateway noemen, is in feite een soort proxy. Hier hadden we opnieuw de keuze — we kunnen onze eigen proxy schrijven, of iets kiezen wat al beschikbaar is. In dit geval hebben we voor de tweede optie gekozen en hebben we een nginx+Lua-combinatie gekozen. Waarom? We hadden betrouwbare, geteste software nodig die schaalbaarheid ondersteunt. We wilden na de implementatie niet zowel de businesslogica als de werking van de proxy controleren.
Elke webserver heeft een verzoekverwerkingspijplijn. In het geval van nginx ziet het er als volgt uit:
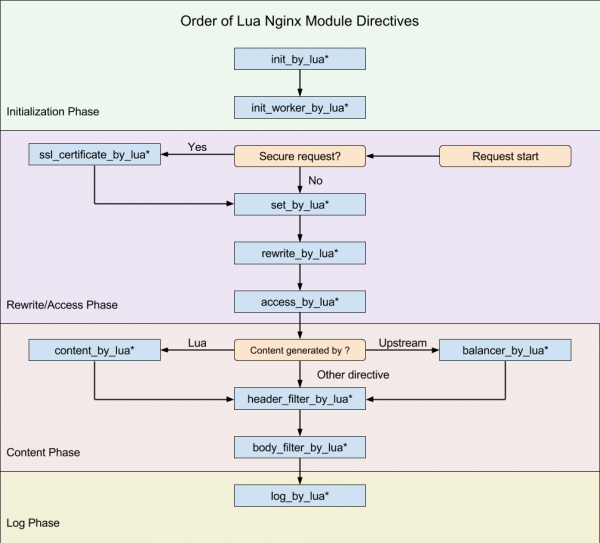
(schema van )
Ons doel was om in deze pijplijn in te haken op het moment dat we het originele verzoek konden aanpassen.
We willen een transparante proxy creëren, zodat het verzoek functioneel blijft zoals het kwam. We controleren alleen de toegang tot de eind-API en helpen het verzoek om er te komen. In het geval dat het verzoek onjuist was, moet de eind-API de fout melden, niet wij. De enige reden waarom we een verzoek kunnen weigeren, is vanwege een gebrek aan toegang voor de klant.
Voor nginx bestaat er al en een werkende opdracht krijgen. . Lua is een scripttaal, het is zeer lichtgewicht en gemakkelijk te leren. Zo hebben we de benodigde logica geïmplementeerd met Lua.
De configuratie van nginx (vergelijkbaar met de route van de applicatie), waar al het werk wordt uitgevoerd, is vrij begrijpelijk. Opmerkelijk is hier de laatste directive — post_action.
location /middleware {
      more_clear_input_headers Accept-Encoding;
      lua_need_request_body on;
      rewrite_by_lua_file 'middleware/rewrite.lua';
      access_by_lua_file 'middleware/access.lua';
      proxy_pass https://someurl.com;
      body_filter_by_lua_file 'middleware/body_filter.lua';
      post_action /process_session;
}
Laten we eens kijken naar wat er in deze configuratie gebeurt:
more_clear_input_headers — verwijdert de waarde van de header die achter de directive is opgegeven.
lua_need_request_body — bepaalt of het originele verzoekbody gelezen moet worden voordat de directives rewrite/access/access_by_lua worden uitgevoerd of niet. Standaard leest nginx de body van het verzoek van de client niet, en als je toegang tot deze body nodig hebt, moet deze directive op on staan.
rewrite_by_lua_file — pad naar het script waarin de logica voor het modificeren van de aanvraag is beschreven
access_by_lua_file — pad naar het script waarin de logica is beschreven die controleert of er toegang is tot de bron.
proxy_pass — url waarop de aanvraag zal worden geproxied.
body_filter_by_lua_file — pad naar het script waarin de logica voor het filteren van de aanvraag voordat deze aan de klant wordt teruggegeven is beschreven.
En tot slot, post_action — officieel niet gedocumenteerde richtlijn waarmee nog andere acties kunnen worden uitgevoerd nadat het antwoord aan de klant is gegeven.
Hierna zullen we stap voor stap uitleggen hoe we onze taken hebben opgelost.
Autorisatie/authenticatie en aanvraagmodificatie
Autorisatie
We hebben autorisatie en authenticatie gebouwd met behulp van certificaat toegang. Er is een root certificaat. Voor elke nieuwe klant van de opdrachtgever wordt een persoonlijk certificaat gegenereerd, waarmee ze toegang tot de API kunnen krijgen. Dit certificaat wordt ingesteld in de serversectie van de nginx instellingen.
ssl on;
ssl_certificate /usr/local/openresty/nginx/ssl/cert.pem;
ssl_certificate_key /usr/local/openresty/nginx/ssl/cert.pem;
ssl_client_certificate /usr/local/openresty/nginx/ssl/ca.crt;
ssl_verify_client on;
Modificatie
Er kan een terechte vraag rijzen: wat moeten we doen met een gecertificeerde klant als we er plotseling voor kiezen om deze van het systeem los te koppelen? We kunnen immers niet alle andere klanten hun certificaten opnieuw laten uitgeven.
Zo zijn we soepel naar de volgende taak gegaan — het modificeren van de oorspronkelijke aanvraag. De oorspronkelijke aanvraag van de klant is over het algemeen niet geldig voor het einddoel. Een van de taken is om de ontbrekende delen in de aanvraag aan te vullen om deze geldig te maken. Het probleem is dat de ontbrekende gegevens voor elke klant verschillend zijn. We weten dat de klant met ons samenwerkt met een certificaat waarvan we een vingerafdruk kunnen nemen en de benodigde klantgegevens uit de database kunnen halen.
Als op een bepaald moment de klant van onze service moet worden afgesloten, zullen hun gegevens uit de database verdwijnen en kan hij niets meer doen.
Werken met klantgegevens
We moesten zorgen voor een hoge beschikbaarheid van de oplossing, vooral hoe we de klantgegevens verkrijgen. De uitdaging is dat de oorspronkelijke bron van deze gegevens een externe service is die geen ononderbroken en voldoende hoge snelheid garandeert.
Daarom moesten we zorgen voor een hoge beschikbaarheid van klantgegevens. Als hulpmiddel hebben we gekozen voor , dat ons biedt:
- snelle toegang tot de gegevens,
- de mogelijkheid om een cluster van meerdere knooppunten met gerepliceerde gegevens op verschillende knooppunten te organiseren.
We zijn de eenvoudigste strategie voor het leveren van gegevens naar de cache gevolgd:
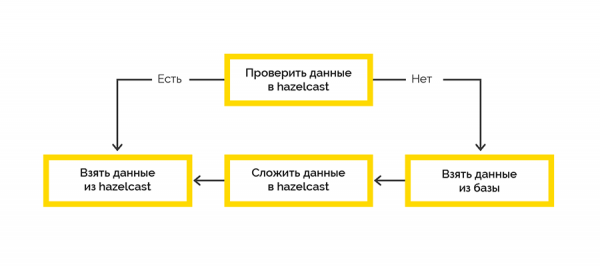
Het werken met het eind systeem vindt plaats binnen sessies en er is een limiet op het maximale aantal. Als de klant de sessie niet sluit, moeten wij dat doen.
Gegevens over een open sessie komen van het eind systeem en worden in eerste instantie aan de Lua-zijkant verwerkt. We hebben ervoor gekozen om Hazelcast te gebruiken voor het opslaan van deze gegevens met een job geschreven in .NET. Daarna controleren we periodiek de levensduur van open sessies en sluiten we de verouderde sessies.
Toegang tot Hazelcast vanuit zowel Lua als .NET
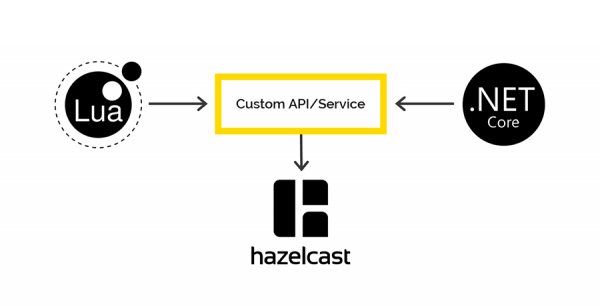
Er zijn geen klanten voor Lua om met Hazelcast te werken, maar Hazelcast heeft een REST API die we besloten hebben te gebruiken. Voor .NET is er , waardoor we toegang tot de gegevens van Hazelcast aan de .NET-zijde wilden verkrijgen. Maar dat ging niet op deze manier.
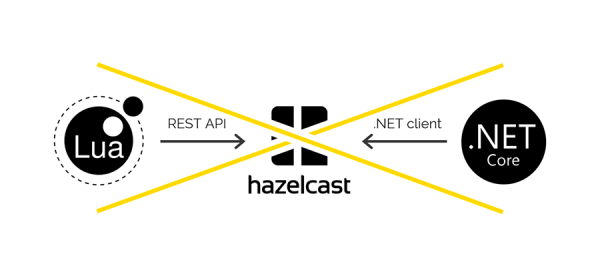
Bij het opslaan van gegevens via REST en het ophalen via de .NET-client worden verschillende serialisators/deserialisators gebruikt. Daarom is het niet mogelijk om gegevens via REST te plaatsen en deze via de .NET-client op te halen, en vice versa.
Als er geïnteresseerden zijn, vertellen we graag meer over dit probleem in een apart artikel. Spoiler - op de diagram.
Logging en monitoring
Onze bedrijfsstandaard voor logging via .NET is Serilog; alle logs komen uiteindelijk in Elasticsearch terecht, en we analyseren ze via Kibana. Iets soortgelijks wilden we ook in dit geval doen. De enige die gevonden werd om met Elastic op Lua te werken, crashte al bij de eerste require. Daarom hebben we Fluentd gebruikt.
— een open-source oplossing voor het bieden van een uniforme laag voor applicatielogging. Hiermee kunnen logs van verschillende lagen van de applicatie worden verzameld en vervolgens naar één bron worden getransleerd.
API Gateway draait in K8S, dus besloten we om een container met Fluentd aan dezelfde pod toe te voegen, zodat we logs konden schrijven naar de bestaande open tcp-poort van Fluentd.
We hebben ook onderzocht hoe Fluentd zou presteren als het geen verbinding heeft met Elasticsearch. Gedurende twee dagen stroomden er continu aanvragen naar de gateway, er werden logs naar Fluentd gestuurd, maar de IP van Elastic was geblokkeerd voor Fluentd. Na het herstellen van de verbinding stuurde Fluentd alle logs perfect door naar Elastic.
Conclusie
De gekozen implementatiestrategie stelde ons in staat om binnen slechts 2,5 maanden een werkend product in productie te brengen.
Als u ooit met dergelijke zaken te maken krijgt, is het raadzaam om eerst duidelijk te begrijpen welke taak u wilt oplossen en welke middelen u al heeft. Wees aandachtig voor de complexiteit van de integratie met bestaande API-beheersystemen.
Begrijp voor uzelf wat precies u van plan bent te ontwikkelen — alleen de zakelijke logica voor het verwerken van verzoeken of, zoals in ons geval, de proxy in zijn geheel. Vergeet niet dat alles wat u zelf doet, grondig getest moet worden.
Bron: habr.com
