

Hallo, Habr!
Vandaag gaan we de vaardigheid ontwikkelen om gegevens te groeperen en visualiseren in Python. In de beschikbare analyseren we verschillende kenmerken en bouwen we een set visualisaties.
Traditioneel beginnen we met het definiëren van de doelstellingen:
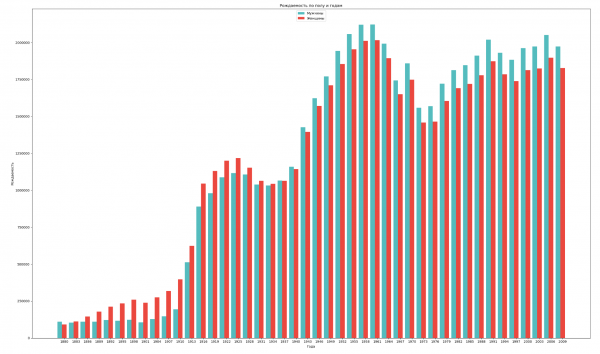
- De gegevens groeperen op geslacht en jaar en de algemene geboortedynamiek van beide geslachten visualiseren;
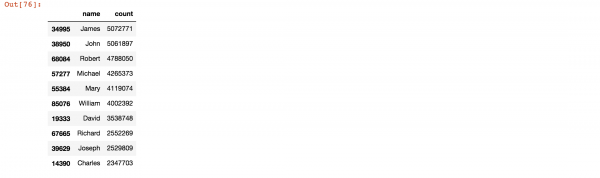
- De populairste namen in de geschiedenis vinden;
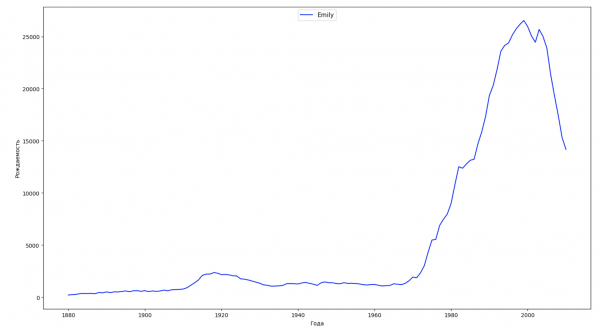
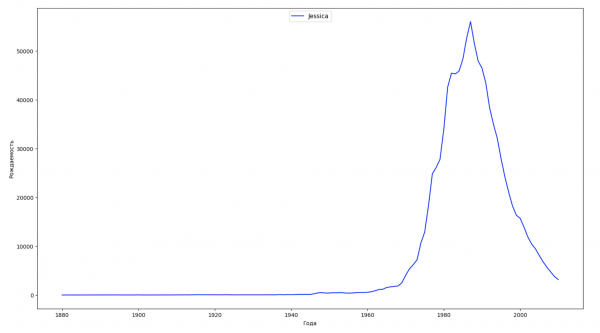
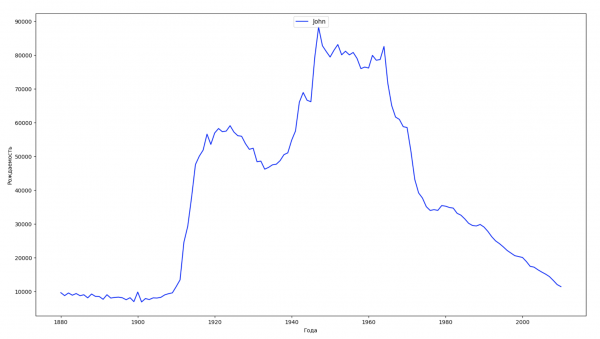
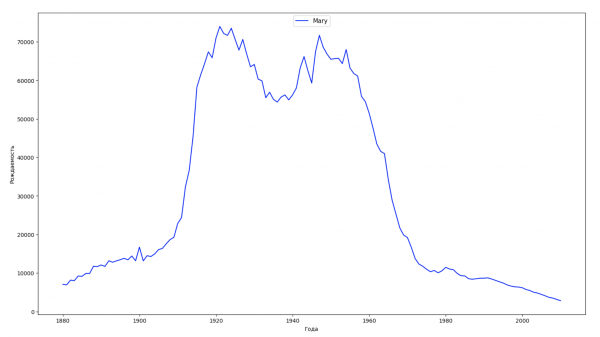
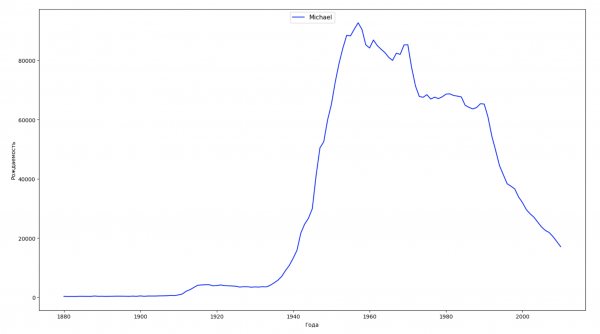
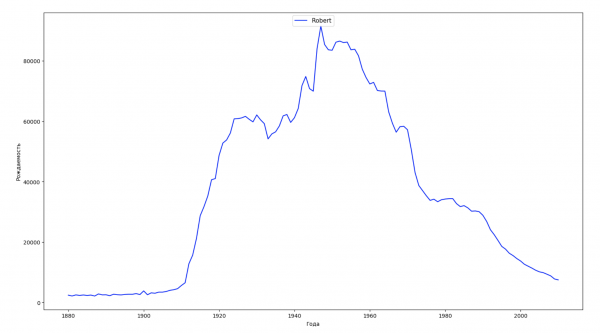
- De gehele tijdspanne in de gegevens opdelen in 10 delen en voor elk deel de populairste naam van elk geslacht vinden. Voor elke gevonden naam visualiseren we de dynamiek door de tijd heen;
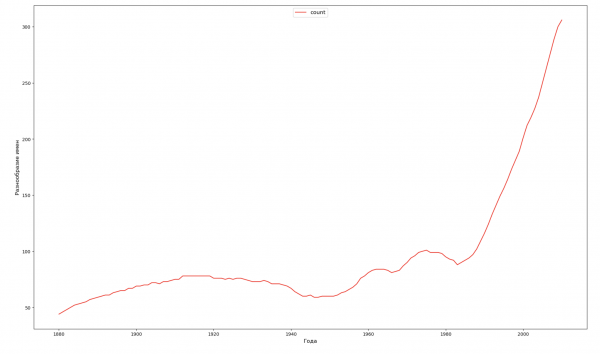
- Voor elk jaar berekenen hoeveel namen 50% van de mensen dekken en visualiseren (we zullen de diversiteit van namen voor elk jaar zien);
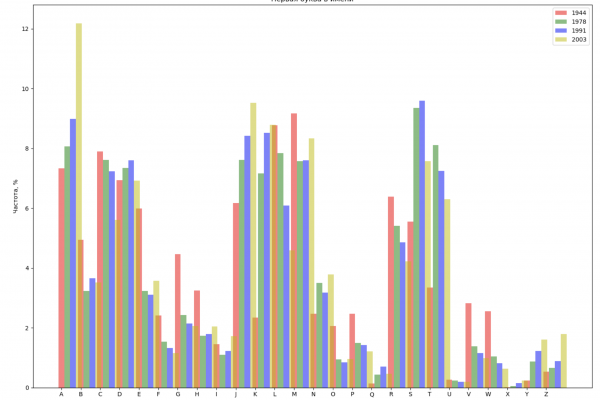
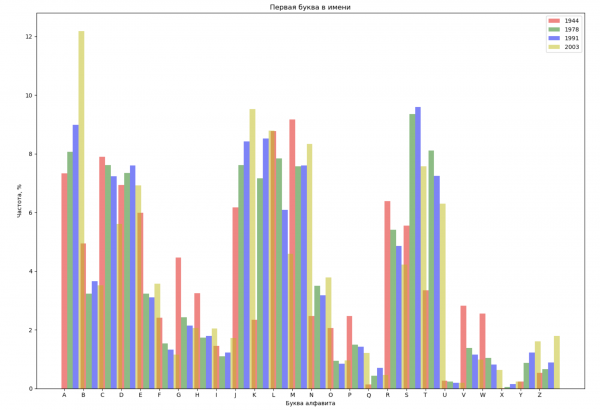
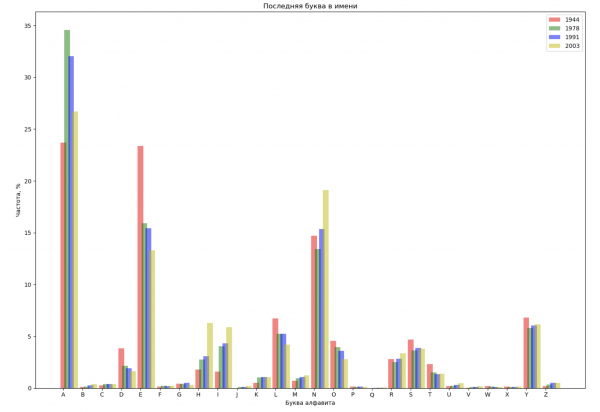
- Vier jaren uit de hele periode kiezen en voor elk jaar de spreiding op basis van de eerste letter van de naam en de laatste letter van de naam weergeven;
- Een lijst opstellen van enkele bekende mensen (presidenten, zangers, acteurs, filmhelden) en hun invloed op de dynamiek van namen beoordelen. Een duidelijke visualisatie bouwen.
Minder woorden, meer code!
En laten we beginnen.
We groeperen de gegevens op geslacht en jaar en visualiseren de algemene geboortedynamiek van beide geslachten:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

years = np.arange(1880, 2011, 3)
datalist = 'https://raw.githubusercontent.com/wesm/pydata-book/2nd-edition/datasets/babynames/yob{year}.txt'
dataframes = []
for year in years:
    dataset = datalist.format(year=year)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframes.append(dataframe.assign(year=year))

result = pd.concat(dataframes)
sex = result.groupby('sex')
births_men = sex.get_group('M').groupby('year', as_index=False)
births_women = sex.get_group('F').groupby('year', as_index=False)
births_men_list = births_men.aggregate(np.sum)['count'].tolist()
births_women_list = births_women.aggregate(np.sum)['count'].tolist()

fig, ax = plt.subplots()
fig.set_size_inches(25,15)

index = np.arange(len(years))
stolb1 = ax.bar(index, births_men_list, 0.4, color='c', label='Mannen')
stolb2 = ax.bar(index + 0.4, births_women_list, 0.4, alpha=0.8, color='r', label='Vrouwen')

ax.set_title('Geboorte per geslacht en jaar')
ax.set_xlabel('Jaren')
ax.set_ylabel('Geboorte')
ax.set_xticklabels(years)
ax.set_xticks(index + 0.4)
ax.legend(loc=9)

fig.tight_layout()
plt.show()
Laten we de populairste namen in de geschiedenis vinden:
years = np.arange(1880, 2011)

dataframes = []
for year in years:
    dataset = datalist.format(year=year)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframes.append(dataframe)

result = pd.concat(dataframes)
names = result.groupby('name', as_index=False).sum().sort_values('count', ascending=False)
names.head(10)
We zullen de gehele tijdsperiode in de gegevens opdelen in 10 delen en voor elk deel de populairste naam van elk geslacht bepalen. Voor elke gevonden naam visualiseren we de dynamiek over de gehele periode:
years = np.arange(1880, 2011)
part_size = int((years[years.size - 1] - years[0]) / 10) + 1
parts = {}
def GetPart(year):
    return int((year - years[0]) / part_size)
for year in years:
    index = GetPart(year)
    r = years[0] + part_size * index, min(years[years.size - 1], years[0] + part_size * (index + 1))
    parts[index] = str(r[0]) + '-' + str(r[1])

dataframe_parts = []
dataframes = []
for year in years:
    dataset = datalist.format(year=year)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframe_parts.append(dataframe.assign(years=parts[GetPart(year)]))
    dataframes.append(dataframe.assign(year=year))

result_parts = pd.concat(dataframe_parts)
result = pd.concat(dataframes)

result_parts_sums = result_parts.groupby(['years', 'sex', 'name'], as_index=False).sum()
result_parts_names = result_parts_sums.iloc[result_parts_sums.groupby(['years', 'sex'], as_index=False).apply(lambda x: x['count'].idxmax())]
result_sums = result.groupby(['year', 'sex', 'name'], as_index=False).sum()

for groupName, groupLabels in result_parts_names.groupby(['name', 'sex']).groups.items():
    group = result_sums.groupby(['name', 'sex']).get_group(groupName)
    fig, ax = plt.subplots(1, 1, figsize=(18,10))

    ax.set_xlabel('Jaren')
    ax.set_ylabel('Geboortes')
    label = group['name']
    ax.plot(group['year'], group['count'], label=label.aggregate(np.max), color='b', ls='-')
    ax.legend(loc=9, fontsize=11)

    plt.show()
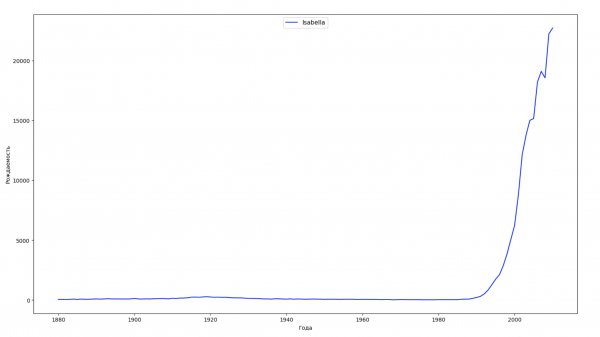
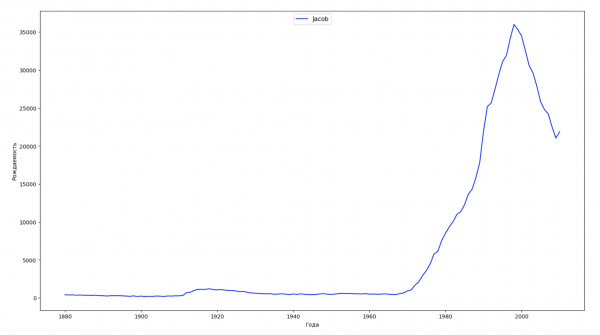
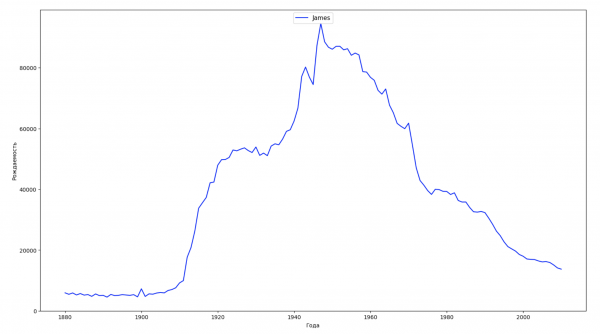
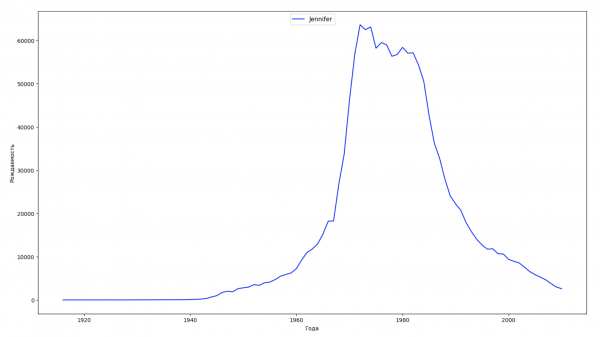
Voor elk jaar berekenen we hoeveel namen 50% van de mensen dekt en visualiseren we deze gegevens:
dataframe = pd.DataFrame({'year': [], 'count': []})
years = np.arange(1880, 2011)
for year in years:
    dataset = datalist.format(year=year)
    csv = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    names = csv.groupby('name', as_index=False).aggregate(np.sum)
    names['sum'] = names.sum()['count']
    names['percent'] = names['count'] / names['sum'] * 100
    names = names.sort_values(['percent'], ascending=False)
    names['cum_perc'] = names['percent'].cumsum()
    names_filtered = names[names['cum_perc'] <= 50]
    dataframe = dataframe.append(pd.DataFrame({'year': [year], 'count': [names_filtered.shape[0]]}))

fig, ax1 = plt.subplots(1, 1, figsize=(22,13))
ax1.set_xlabel('Jaren', fontsize = 12)
ax1.set_ylabel('Diversiteit van namen', fontsize = 12)
ax1.plot(dataframe['year'], dataframe['count'], color='r', ls='-')
ax1.legend(loc=9, fontsize=12)

plt.show()
Laten we 4 jaren uit de gehele periode kiezen en voor elk jaar de verdeling op basis van de eerste letter van de naam en de laatste letter van de naam weergeven:
van string import ascii_lowercase, ascii_uppercase

fig_first, ax_first = plt.subplots(1, 1, figsize=(14,10))
fig_last, ax_last = plt.subplots(1, 1, figsize=(14,10))

index = np.arange(len(ascii_uppercase))
jaren = [1944, 1978, 1991, 2003]
kleurs = ['r', 'g', 'b', 'y']
n = 0
voor jaar in jaren:
    dataset = datalist.format(year=jaar)
    csv = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    namen = csv.groupby('name', as_index=False).aggregate(np.sum)
    aantal = namen.shape[0]

    dataframe = pd.DataFrame({'letter': [], 'frequency_first': [], 'frequency_last': []})
    voor letter in ascii_uppercase:
        countFirst = (namen[namen.name.str.startswith(letter)].count()['count'])
        countLast = (namen[namen.name.str.endswith(letter.lower())].count()['count'])

        dataframe = dataframe.append(pd.DataFrame({
            'letter': [letter],
            'frequency_first': [countFirst / aantal * 100],
            'frequency_last': [countLast / aantal * 100]}))

    ax_first.bar(index + 0.3 * n, dataframe['frequency_first'], 0.3, alpha=0.5, color=kleurs[n], label=jaar)
    ax_last.bar(index + bar_width * n, dataframe['frequency_last'], 0.3, alpha=0.5, color=kleurs[n], label=jaar)
    n += 1

ax_first.set_xlabel('Letter van het alfabet')
ax_first.set_ylabel('Frequentie, %')
ax_first.set_title('Eerste letter in naam')
ax_first.set_xticks(index)
ax_first.set_xticklabels(ascii_uppercase)
ax_first.legend()

ax_last.set_xlabel('Letter van het alfabet')
ax_last.set_ylabel('Frequentie, %')
ax_last.set_title('Laatste letter in naam')
ax_last.set_xticks(index)
ax_last.set_xticklabels(ascii_uppercase)
ax_last.legend()

fig_first.tight_layout()
fig_last.tight_layout()

plt.show()
Laten we een lijst samenstellen van enkele bekende mensen (presidenten, zangers, acteurs, filmhelden) en hun impact op de dynamiek van namen beoordelen:
celebrities = {'Frank': 'M', 'Britney': 'F', 'Madonna': 'F', 'Bob': 'M'}
dataframes = []
voor jaar in jaren:
    dataset = datalist.format(year=jaar)
    dataframe = pd.read_csv(dataset, names=['name', 'sex', 'count'])
    dataframes.append(dataframe.assign(year=jaar))

result = pd.concat(dataframes)

voor celebrity, sex in celebrities.items():
    namen = result[result.name == celebrity]
    dataframe = namen[namen.sex == sex]
    fig, ax = plt.subplots(1, 1, figsize=(16,8))

    ax.set_xlabel('Jaren', fontsize = 10)
    ax.set_ylabel('Geboortecijfers', fontsize = 10)
    ax.plot(dataframe['year'], dataframe['count'], label=celebrity, color='r', ls='-')
    ax.legend(loc=9, fontsize=12)

    plt.show()
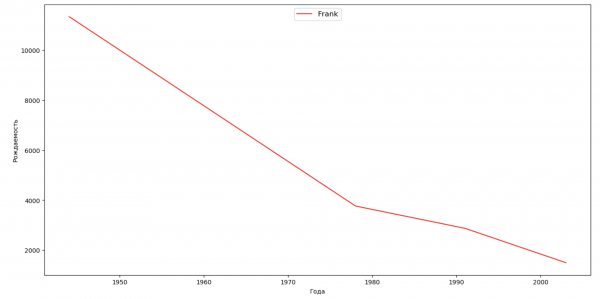
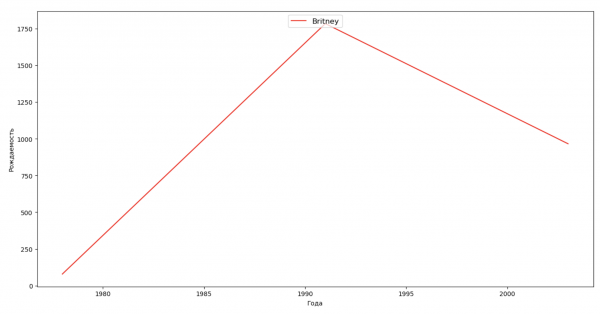
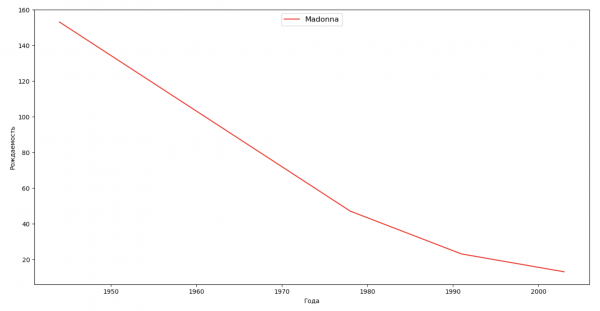
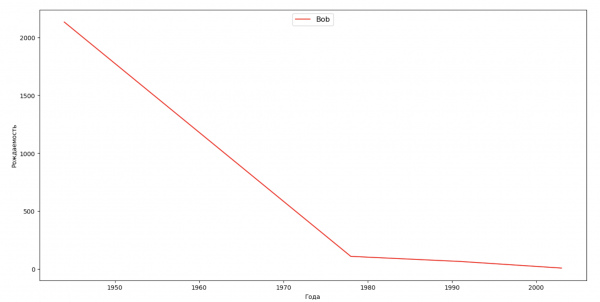
Voor oefening kun je uit het laatste voorbeeld een visualisatie toevoegen van de levensperiode van de celebrity, zodat je hun impact op de dynamiek van namen visueel kunt beoordelen.
Dit zijn onze doelen, die zijn bereikt en volbracht. We hebben de vaardigheid ontwikkeld om gebruik te maken van groeperings- en visualisatietechnieken in Python, en we zullen verder met data werken. Iedereen kan zelf conclusies trekken op basis van de al geproduceerde, gevisualiseerde data.
Veel kennis toegewenst!
Bron: habr.com
