

Tegenwoordig worden de meeste softwareproducten ontwikkeld in teams. De voorwaarden voor succes in teamontwikkeling kunnen worden weergegeven in een eenvoudig schema.
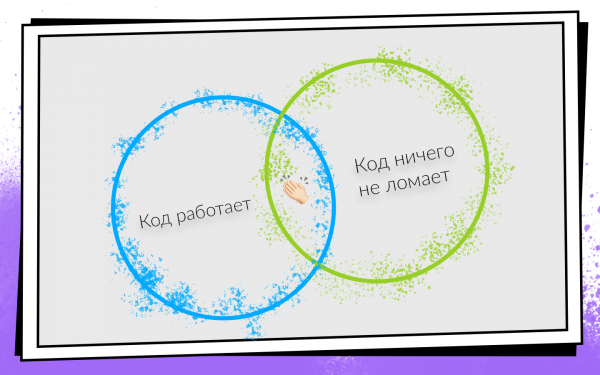
Als je code hebt geschreven, moet je ervoor zorgen dat deze:
- Werkt.
- Niets kapotmaakt, inclusief de code die door je collega's is geschreven.
Als aan beide voorwaarden is voldaan, ben je op weg naar succes. Om deze voorwaarden gemakkelijk te kunnen controleren en niet van het winstgevende pad af te dwalen, is Continuous Integration bedacht.
CI is een werkproces waarbij je je code zo vaak mogelijk in de gezamenlijke productcode integreert. En niet alleen integreert, maar ook constant controleert of alles werkt. Aangezien er veel en vaak gecontroleerd moet worden, is het de moeite waard om over automatisering na te denken. Je kunt alles handmatig controleren, maar dat zou je niet moeten doen, en hier is waarom.
- Mensen zijn duur.Een uur werk van elke programmeur kost meer dan een uur werk van welke server dan ook.
- Mensen maken fouten.Daarom kunnen er situaties ontstaan waarin tests niet op de juiste tak zijn uitgevoerd of de verkeerde commit is verzameld voor de testers.
- Mensen zijn lui.Af en toe, wanneer ik een taak afrond, heb ik de gedachte: "Wat is hier te controleren? Ik heb twee regels geschreven — dat werkt vast!" Ik denk dat sommigen van jullie zulke gedachten ook wel eens hebben. Maar je moet altijd controleren.
Hoe Continuous Integration werd geïmplementeerd en ontwikkeld in het mobiele ontwikkelteam van Avito, hoe ze van 0 naar 450 builds per dag zijn gegaan en hoe de buildmachines 200 uur per dag verzamelen, verteld door Nikolay Nesterov () — deelnemer aan alle evolutionaire veranderingen in CI/CD van de Android-app.
Het verhaal is gebaseerd op het voorbeeld van het Android-team, maar de meeste benaderingen zijn ook toepasbaar op iOS.
Vroeger werkte er één persoon in het Android-team van Avito. Hem was vanuit het oogpunt van Continuous Integration per definitie niets nodig: hij had niemand om mee te integreren.
Maar de applicatie groeide, er kwamen steeds meer nieuwe taken bij, en dus groeide het team. Op een gegeven moment werd het tijd om het proces van code-integratie formeler in te richten. Er werd besloten om Git flow te gebruiken.
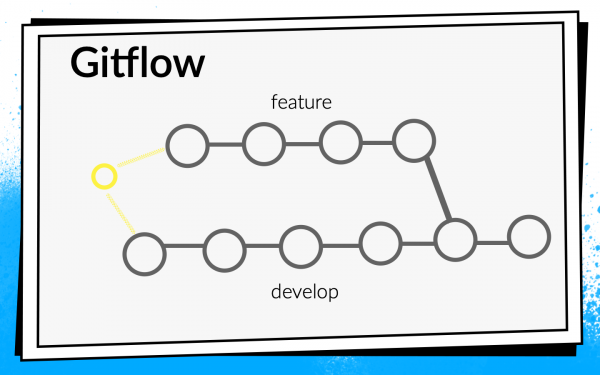
Het Git flow-concept is bekend: in het project is er één gemeenschappelijke branch, develop, en voor elke nieuwe feature maken ontwikkelaars een aparte branch aan, committen hierin, pushen, en wanneer ze hun code in de develop-branch willen samenvoegen, openen ze een pull request. Voor kennisdeling en bespreking van benaderingen hebben we code review geïntroduceerd, wat betekent dat collega's elkaars code moeten controleren en goedkeuren.
Controles
De code door de ogen van anderen bekijken is geweldig, maar niet genoeg. Daarom worden automatische controles ingevoerd.
- Eerst controleren we de ARC-bouwwerken.
- Veel Junit-tests.
- We berekenen de code coverage, nu we de tests uitvoeren.
Om te begrijpen hoe we deze controles moeten uitvoeren, kijken we naar het ontwikkelingsproces bij Avito.
Schematisch kan dit als volgt worden weergegeven:
- De ontwikkelaar schrijft code op zijn laptop. De integratietests kunnen hier direct worden uitgevoerd - ofwel via een commit-hook, of gewoon op de achtergrond.
- Nadat de ontwikkelaar de code heeft gepusht, opent hij een pull request. Om zijn code in de develop-branch te krijgen, moet hij door de code review heen en het vereiste aantal goedkeuringen verzamelen. Hier kunnen we controles en builds inschakelen: zolang niet alle builds succesvol zijn, kan de pull request niet worden samengevoegd.
- Nadat de pull request is samengevoegd en de code in develop staat, kan een geschikt moment worden gekozen: bijvoorbeeld 's nachts, wanneer alle servers vrij zijn, en dan kunnen we zo veel mogelijk controles uitvoeren.
Niemand vond het leuk om controles op zijn laptop uit te voeren. Wanneer de ontwikkelaar de feature heeft afgerond, wil hij deze zo snel mogelijk pushen en een pull request openen. Als er op dat moment langdurige controles worden uitgevoerd, is dat niet alleen ongemakkelijk, maar vertraagt het ook de ontwikkeling: terwijl de laptop iets controleert, kan je er niet normaal op werken.
We vonden het geweldig om de controles 's nachts uit te voeren, omdat er genoeg tijd en servers zijn, en je kan er geheel op los gaan. Maar helaas, zodra de feature code in develop is, heeft de ontwikkelaar veel minder motivatie om de fouten te verhelpen die door CI zijn gevonden. Ik betrapte mezelf er regelmatig op dat ik, toen ik in het ochtendrapport keek naar alle gevonden fouten, dacht dat ik ze later wel zou repareren, omdat er op dit moment een geweldige nieuwe taak in Jira lag die ik zo graag wilde starten.
Als controles de pull request blokkeren, is de motivatie genoeg, omdat de code niet in develop komt zolang de builds niet groen zijn, wat betekent dat de taak niet zal worden voltooid.
Uiteindelijk hebben we zo'n strategie gekozen: 's nachts draaien we zoveel mogelijk checks, en de meest kritische en vooral snelle checks starten we bij de pull request. Maar we stoppen daar niet; we optimaliseren tegelijkertijd de snelheid van de checks, zodat we ze van de nachtmodus naar checks bij de pull request kunnen verplaatsen.
Op dat moment gingen al onze builds vrij snel, dus we hebben gewoon de ARC-build, Junit-tests en de berekening van de code coverage als blocker voor de pull request ingeschakeld. We schakelden het in, dachten erover na — en verwierpen de code coverage omdat we vonden dat we dat niet nodig hadden.
Voor de hele configuratie van de basis CI hebben we twee dagen nodig gehad (hierna is de tijdsindicatie ruw, bedoeld voor schaalvergroting).
Daarna gingen we verder nadenken — controleren we eigenlijk goed? Starten we builds bij de pull request correct?
We startten de build op de laatste commit van de branch waarvan de pull request werd gemaakt. Maar de checks van deze commit kunnen alleen laten zien dat de code die de ontwikkelaar heeft geschreven werkt. Ze bewijzen echter niet dat hij niets heeft kapotgemaakt. Eigenlijk moeten we de staat van de develop-branch controleren nadat de feature erin is gemerged.
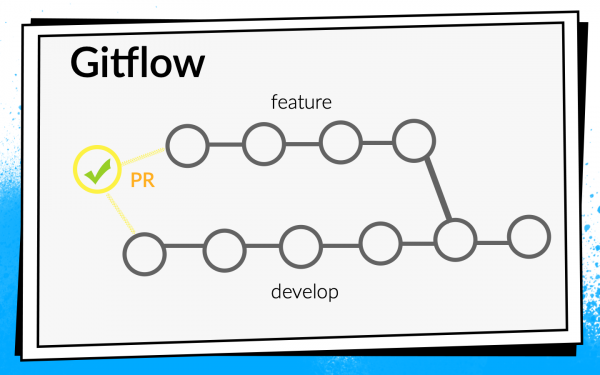
Hiervoor hebben we een eenvoudig bash-script geschreven. premerge.sh:
#!/usr/bin/env bash

set -e

git fetch origin develop

git merge origin/develop
Hier worden gewoon alle nieuwste wijzigingen uit develop gehaald en samengevoegd met de huidige branch. We hebben het script premerge.sh als eerste stap in alle builds toegevoegd en zijn toen precies gaan controleren wat we wilden, namelijk integratie.
Voor de lokalisatie van de problemen, het zoeken naar oplossingen en het schrijven van dit script waren we drie dagen bezig.
De applicatie ontwikkelde zich, er kwamen steeds meer taken, het team groeide, en premerge.sh begon ons soms in de steek te laten. In develop drongen conflicterende wijzigingen door die de build kapotmaakten.
Een voorbeeld van hoe dit gebeurt:
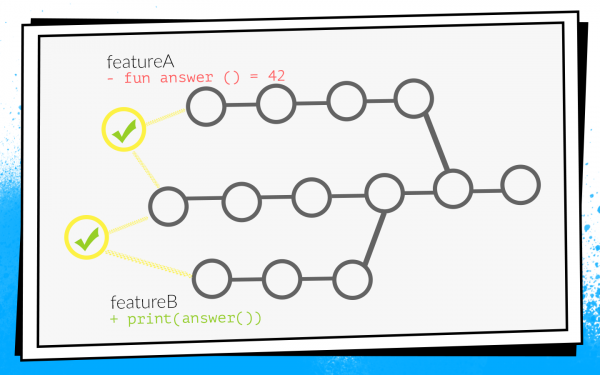
Twee ontwikkelaars beginnen tegelijkertijd aan de features A en B. De ontwikkelaar van feature A ontdekt een ongebruikte functie in het project. answer() en, als een goede scout, verwijdert hij deze. Ondertussen voegt de ontwikkelaar van feature B in zijn branch een nieuwe aanroep van deze functie toe.
De ontwikkelaars beëindigen hun werk en openen tegelijkertijd de pull request. De builds worden gestart, premerge.sh controleert beide pull requests ten opzichte van de recente staat van develop — alle checks zijn groen. Daarna wordt de pull request van feature A samengevoegd, de pull request van feature B… Boom! Develop breekt, omdat in de code van develop een aanroep naar een niet-bestaande functie staat.
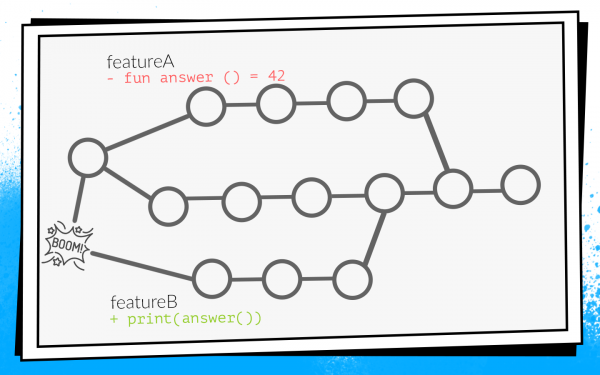
Wanneer develop niet kan worden gebouwd, is dat lokale catastrofe. Het hele team kan niets samenstellen en aan testen geven.
Het gebeurde dat ik me het vaakst bezighield met infrastructuurwerkzaamheden: analyses, netwerken, databases. Met andere woorden, ik schreef de functies en klassen die andere ontwikkelaars gebruiken. Dit leidde er vaak toe dat ik in soortgelijke situaties terechtkwam. Op een gegeven moment had ik zelfs zo'n afbeelding hangen.
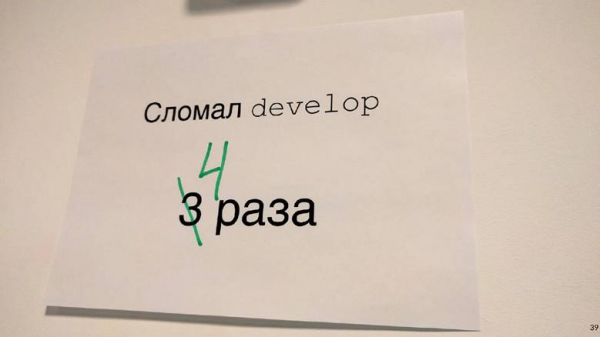
Omdat dit ons niet beviel, begonnen we na te denken over manieren om dit te voorkomen.
Hoe ontwikkel je niet kapot?
Eerste optie: alle pull requests opnieuw opbouwen bij een update van develop. Als in ons voorbeeld de pull request met functie A als eerste in develop komt, zal de pull request van functie B opnieuw opgebouwd worden, en als resultaat zullen de controles falen vanwege een compilatiefout.
Om te begrijpen hoeveel tijd dit kost, bekijken we een voorbeeld met twee PR. We openen twee PR: twee builds, twee controles. Nadat de eerste PR in develop is samengevoegd, moet de tweede opnieuw worden opgebouwd. In totaal kost het voor twee PR's drie controles: 2 + 1 = 3.
In principe is dat redelijk. Maar we bekeken de statistieken, en de typische situatie in ons team was 10 open PR's, en dan is het aantal controles de som van de progressie: 10 + 9 + … + 1 = 55. Dat betekent dat je 55 keer moet heropbouwen om 10 PR's goed te keuren. En dat is in een ideale situatie, waarin alle controles de eerste keer slagen, en niemand een extra pull request opent terwijl deze tien worden verwerkt.
Stel je voor dat je een ontwikkelaar bent die de knop ‘merge’ als eerste moet indrukken, want als je buurman dat doet, moet je wachten totdat alle builds opnieuw doorlopen zijn... Nee, dat gaat niet werken, dat vertraagt de ontwikkeling ernstig.
Tweede mogelijke manier: pull request bouwen na de code review. Dat wil zeggen, je opent een pull request, verzamelt het benodigde aantal goedkeuringen van collega’s, maakt wat nodig is in orde, en daarna start je de builds. Als die succesvol zijn, wordt de pull request samengevoegd met develop. In dit geval zijn er geen extra heropbouwen, maar de feedback vertraagt aanzienlijk. Als ontwikkelaar wil ik bij het openen van een pull request meteen zien of deze gebouwd wordt. Bijvoorbeeld, als er een test is gefaald, moet ik dat snel kunnen verhelpen. Bij een uitgestelde build vertraagt de feedback, en dus de gehele ontwikkeling. Dit beviel ons ook niet.
Uiteindelijk bleef alleen de derde optie over - fietsen. Al onze code en al onze bronbestanden worden opgeslagen in een repository op de Bitbucket-server. We moesten dus een plugin voor Bitbucket ontwikkelen.
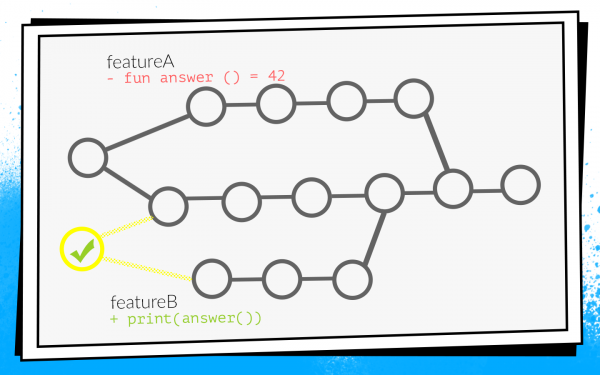
Deze plugin overschrijft de mechaniek van het mergen van pull requests. Het begint standaard: er wordt een PR geopend, alle builds worden gestart en er volgt een code review. Maar nadat de code review is doorlopen en de ontwikkelaar besluit om op 'merge' te drukken, controleert de plugin naar welke staat van develop de tests zijn uitgevoerd. Als develop na de builds is bijgewerkt, laat de plugin niet toe dat zo'n pull request in de hoofdbranch wordt samengevoegd. Het zal de builds eenvoudig opnieuw starten ten opzichte van het recente develop.
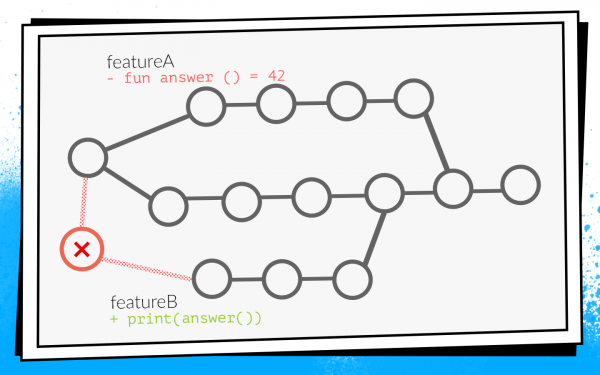
In ons voorbeeld met conflicterende wijzigingen zullen dergelijke builds falen vanwege een compilatiefout. De ontwikkelaar van functie B moet de code dus aanpassen, de tests opnieuw starten, waarna de plugin automatisch de pull request zal toepassen.
Voor de implementatie van deze plugin hadden we gemiddeld 2,7 teststarts per pull request. Met de plugin is dat 3,6 starts geworden. Dit beviel ons.
Het is vermeldenswaard dat deze plugin een nadeel heeft: hij start de build slechts één keer opnieuw. Dat betekent dat er nog steeds een klein venster is waarbinnen conflicterende wijzigingen in develop kunnen komen. Maar de kans hierop is klein, en we gingen akkoord met dit compromis tussen het aantal uitvoeringen en de kans op een breuk. In twee jaar tijd is het slechts één keer misgegaan, dus waarschijnlijk niet voor niets.
Het kostte ons twee weken om de eerste versie van de plugin voor Bitbucket te schrijven.
Nieuwe controles
Ondertussen bleef ons team groeien. Nieuwe controles werden toegevoegd.
We dachten: waarom fouten repareren als we ze kunnen voorkomen? Daarom hebben we geïmplementeerd statische code-analyse. We begonnen met lint, dat deel uitmaakt van de Android SDK. Maar het kon in die tijd helemaal niet met Kotlin-code omgaan, en al 75% van onze applicatie was in Kotlin geschreven. Daarom zijn we lint gaan aanvullen met ingebouwde checks van Android Studio.
Daarvoor moesten we behoorlijk creatief zijn: Android Studio inpakken in Docker en deze op CI draaien met een virtueel scherm, zodat het dacht dat het op een echte laptop draaide. Maar het werkte.
Tegelijkertijd begonnen we veel instrumentation tests te schrijven en implementeerden we screenshot testingDit is wanneer een referentiescreenshot wordt gegenereerd voor een afzonderlijke kleine weergave, en de test bestaat eruit dat er een screenshot van de weergave wordt genomen en pixel voor pixel met de referentie wordt vergeleken. Als er een afwijking is, betekent dit dat de opmaak ergens is verstoord of dat er iets mis is met de stijlen.
Maar instrumentation tests en screenshot tests moeten op apparaten worden uitgevoerd: op emulatoren of op echte apparaten. Aangezien er veel tests zijn die vaak worden uitgevoerd, is er een hele farm nodig. Een eigen farm opzetten kost te veel moeite, daarom hebben we een kant-en-klare optie gevonden: Firebase Test Lab.
Firebase Test Lab
Het werd gekozen omdat Firebase een product van Google is, wat betekent dat het betrouwbaar moet zijn en waarschijnlijk nooit zal verdwijnen. De prijzen zijn redelijk: $5 per uur gebruik van een echt apparaat, $1 per uur gebruik van een emulator.
De implementatie van Firebase Test Lab in onze CI kostte ongeveer drie weken.
Maar het team bleef groeien en helaas begon Firebase ons teleur te stellen. Op dat moment had het geen SLA. Soms moest je wachten totdat er voldoende apparaten beschikbaar waren voor de tests, in plaats van dat ze meteen werden uitgevoerd, zoals we wilden. De wachttijd in de rij kon oplopen tot een half uur, wat erg lang was. Instrumentation tests werden bij elk PR uitgevoerd, de vertragingen vertraagden de ontwikkeling aanzienlijk, en toen ontvingen we ook nog een rekening voor de maand met een aanzienlijk bedrag. Kortom, we besloten om Firebase te laten vallen en in-house te bouwen, aangezien het team groot genoeg was geworden.
Docker + Python + bash
We hebben Docker genomen, emulators erin gestopt en een eenvoudig programma geschreven in Python dat op het juiste moment het benodigde aantal emulators in de juiste versie opstart en ze stopt wanneer nodig. En natuurlijk een paar bash-scripts — wat kunnen we zonder die?
Het kostte vijf weken om onze eigen testomgeving te creëren.
Bijgevolg had elke pull request een uitgebreide, blokkering van de samensmelting, lijst van controles:
- Bouw ARC;
- Junit-tests;
- Lint;
- Android Studio-controles;
- Instrumentation tests;
- Screenshot tests.
Dit voorkwam veel mogelijke defecten. Technisch werkte alles, maar de ontwikkelaars klaagden dat het te lang duurde om de resultaten te ontvangen.
Te lang — dat is hoeveel? We hebben gegevens van Bitbucket en TeamCity geëxporteerd naar een analysesysteem en begrepen dat de gemiddelde wachttijd 45 minuten. Dat betekent dat een ontwikkelaar gemiddeld 45 minuten wacht op de resultaten van de builds bij het openen van een pull request. Naar mijn mening is dit veel te lang, en zo kan je niet werken.
Natuurlijk besloten we om al onze builds te versnellen.
Versnellen
Toen we zagen dat builds vaak in de rij stonden, hebben we als eerste extra hardware aangeschaft — extensieve ontwikkeling is het eenvoudigst. Builds stopten met in de rij staan, maar de wachttijd verminderde maar een beetje, omdat sommige controles zelf erg lang duurden.
We verwijderen te lange controles
Onze Continuous Integration kon dit soort fouten en problemen opvangen.
- Compileert niet. CI kan een compileerfout opvangen wanneer iets niet compileert door conflicterende wijzigingen. Zoals ik al zei, dan kan niemand iets compileren, staat de ontwikkeling stil en is iedereen nerveus.
- Bug in gedrag. Bijvoorbeeld, wanneer de applicatie compileert, maar crasht bij het klikken op een knop, of de knop helemaal niet werkt. Dit is slecht, omdat zo'n bug bij de gebruiker kan komen.
- Bug in layout. Bijvoorbeeld, de knop werkt, maar is 10 pixels naar links verschoven.
- Verhoging van technische schuld.
Toen we naar deze lijst keken, begrepen we dat alleen de eerste twee punten kritisch zijn. Dit soort problemen willen we als eerste opvangen. Bugs in de layout worden ontdekt tijdens de design-review en zijn dan gemakkelijk te corrigeren. Werken aan technische schuld vereist een apart proces en planning, daarom besloten we deze niet te controleren tijdens pull requests.
Op basis van deze classificatie hebben we de hele lijst met controles doorzocht. We hebben Lint doorgestreept en zijn de uitvoering ervan naar de nacht verplaatst: gewoon om rapport uit te geven over hoeveel problemen er in het project zijn. We hebben afgesproken om afzonderlijk met technische schuld te werken, en hebben helemaal afstand gedaan van de checks van Android Studio. Android Studio in Docker om inspecties uit te voeren klinkt interessant, maar zorgt voor veel ongemak bij het onderhoud. Elke versie-upgrade van Android Studio is een strijd met onbegrijpelijke bugs. Het was ook moeilijk om screenshot-tests te onderhouden, omdat de bibliotheek niet erg stabiel werkte, er waren valse positiviteiten. We hebben screenshot-tests uit de lijst met controles verwijderd.
Uiteindelijk hebben we overgehouden:
- Bouw ARC;
- Junit-tests;
- Instrumentation tests.
Gradle remote cache
Zonder zware controles is alles beter geworden. Maar er is geen limiet aan perfectie!
Onze applicatie was al op ongeveer 150 gradle-modules verdeeld. Gewoonlijk werkt Gradle remote cache goed in zo'n geval, en we hebben besloten het te proberen.
Gradle remote cache is een service die build-artifacts voor afzonderlijke taken in afzonderlijke modules kan cachen. In plaats van de code daadwerkelijk te compileren, maakt Gradle via HTTP contact met de remote cache om te vragen of iemand deze taak al heeft uitgevoerd. Als dat zo is, downloadt het gewoon het resultaat.
Het opzetten van Gradle remote cache is eenvoudig, omdat Gradle een Docker-image biedt. We hebben dit in drie uur voor elkaar gekregen.
Het enige wat je hoeft te doen is Docker op te starten en één regel in je project te plaatsen. Maar hoewel het snel op te zetten is, kost het tijd om alles goed te laten werken.
Hieronder is een grafiek van cache misses.
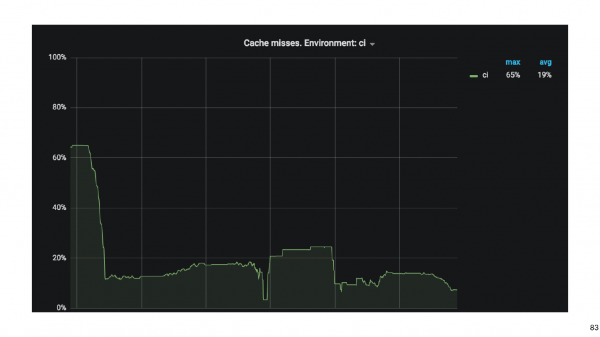
Aan het begin was het percentage missers ongeveer 65. Na drie weken konden we dit percentage terugbrengen tot 20%. Het bleek dat de taken die de Android-applicatie verzamelt, vreemde transitieve afhankelijkheden hebben, waardoor Gradle de cache miste.
Door de cache in te schakelen, hebben we de build aanzienlijk versneld. Maar naast de build draaien ook de instrumentation tests, en dat kost veel tijd. Het is misschien niet nodig om alle tests bij elke pull request uit te voeren. Om dit te achterhalen, gebruiken we impactanalyse.
Impactanalyse
Bij de pull request verzamelen we de git diff en vinden we de gewijzigde Gradle-modules.
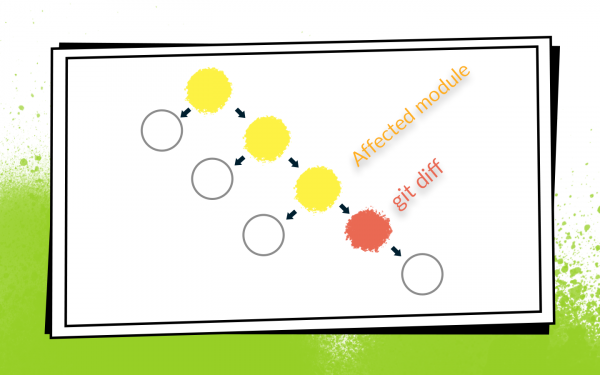
Het heeft zin om alleen die instrumentation tests uit te voeren die de gewijzigde modules en alle modules die daarvan afhankelijk zijn, controleren. Het heeft geen zin om tests voor aangrenzende modules uit te voeren: de code is daar niet gewijzigd, dus er kan niets kapotgaan.
Met instrumentation tests is het niet zo eenvoudig, omdat ze zich in de hoogste module van de Application moeten bevinden. We hebben een heuristiek met bytecode-analyse toegepast om te begrijpen bij welke module elke test hoort.
Het moderniseren van de werking van instrumentation tests, zodat ze alleen betrokken modules controleren, kostte ongeveer acht weken.
De maatregelen om de controles te versnellen hebben succesvol gewerkt. We zijn van 45 minuten naar ongeveer 15 minuten gegaan. Een kwartier wachten op de build is nu al acceptabel.
Maar nu beginnen ontwikkelaars te klagen dat ze niet begrijpen welke builds worden uitgevoerd, waar ze de log kunnen bekijken, waarom de build rood is, welke test is mislukt, enz.
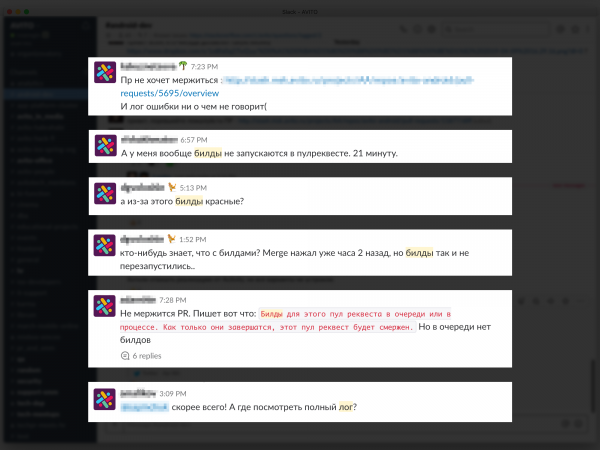
Problemen met feedback vertragen de ontwikkeling, dus we hebben geprobeerd zo duidelijk en gedetailleerd mogelijke informatie over elke PR en build te bieden. We zijn begonnen met opmerkingen in Bitbucket bij de PR waarin we aangaven welke build is mislukt en waarom, en we hebben gerichte berichten in Slack geschreven. Uiteindelijk hebben we een dashboardpagina voor de PR gemaakt met een lijst van alle builds die nu worden uitgevoerd en hun status: in de wachtrij, wordt uitgevoerd, mislukt of voltooid. Je kunt op de build klikken en naar de log gaan.
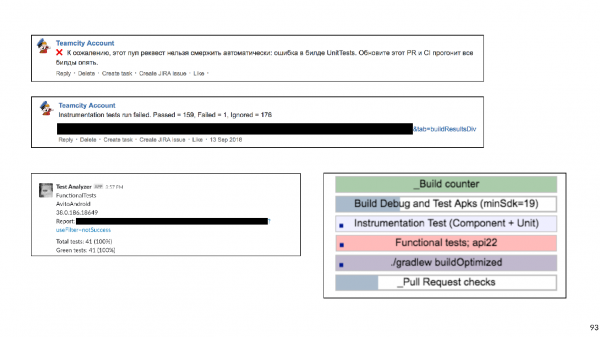
Er zijn zes weken besteed aan gedetailleerde feedback.
Plannen
Laten we overstappen naar het nieuwste verhaal. Nadat we het feedbackprobleem hebben opgelost, hebben we een nieuw niveau bereikt - we hebben besloten onze eigen emulatorfarm op te bouwen. Wanneer er veel tests en emulators zijn, is het moeilijk om ze te beheren. Uiteindelijk zijn al onze emulators verhuisd naar een k8s-cluster met flexibele resourcebeheer.
Daarnaast zijn er ook andere plannen.
- Lint terugbrengen (en andere statische analyse). We zijn hier al mee aan de slag.
- Alle end-to-end tests op alle versies van de SDK uitvoeren.
Dus, we hebben de ontwikkeling van Continuous Integration bij Avito gevolgd. Nu wil ik enkele tips geven vanuit het perspectief van een ervaren persoon.
Tips
Als ik maar één advies kon geven, zou het dit zijn:
Wees alsjeblieft voorzichtig met shell-scripts!
Bash is een zeer flexibele en krachtige tool, en het is heel handig en snel om scripts te schrijven. Maar je kunt in de val trappen, en helaas zijn wij daarin gevallen.
Alles begon met eenvoudige scripts die op onze build-machines werden uitgevoerd:
#!/usr/bin/env bash
./gradlew assembleDebug
Maar zoals bekend, ontwikkelt en complicert alles in de loop der tijd - laten we een script vanuit een ander script uitvoeren, laten we er een paar parameters aan doorgeven - uiteindelijk moesten we een functie schrijven die bepaalt op welk niveau van nesting bash we nu bevinden, zodat we de juiste aanhalingstekens kunnen invoegen om alles te laten draaien.
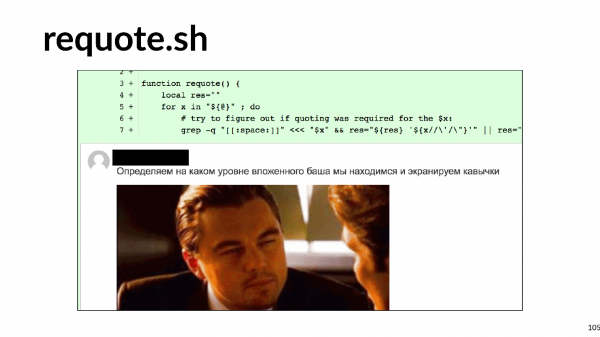
Kun je je de arbeidsinspanningen voorstellen die nodig zijn om dergelijke scripts te ontwikkelen? Ik raad je aan niet in deze val te trappen.
Waarmee kan dit vervangen worden?
- Met elke script-taal. Het is handiger om te schrijven in Python of Kotlin Script, omdat dit programmeren is, geen scripts.
- Of beschrijf de gehele logica van builds in de vorm van Custom gradle-taken voor jouw project.
We hebben besloten om voor de tweede optie te kiezen, en nu verwijderen we geleidelijk alle bash-scripts en schrijven we veel aangepaste gradle-taken.
Tip nummer 2: houd infrastructuur als code.
Het is handig om de configuratie voor Continuous Integration niet in de UI-interface van Jenkins of TeamCity enzovoort op te slaan, maar als tekstbestanden direct in de projectrepository. Dit biedt versiebeheer. Het zal niet moeilijk zijn om terug te draaien of de code op een andere tak te bouwen.
Scripten kunnen in het project worden opgeslagen. Maar wat te doen met de omgeving?
Tip #3: Docker kan helpen met de omgeving.
Het zal Android-ontwikkelaars zeker helpen, iOS helaas nog niet.
Dit is een voorbeeld van een eenvoudige docker-file die JDK en Android SDK bevat:
FROM openjdk:8

ENV SDK_URL="https://dl.google.com/android/repository/sdk-tools-linux-3859397.zip"
    ANDROID_HOME="/usr/local/android-sdk"
    ANDROID_VERSION=26
    ANDROID_BUILD_TOOLS_VERSION=26.0.2

# Download Android SDK
RUN mkdir "$ANDROID_HOME" .android
    && cd "$ANDROID_HOME"
    && curl -o sdk.zip $SDK_URL
    && unzip sdk.zip
    && rm sdk.zip
    && yes | $ANDROID_HOME/tools/bin/sdkmanager --licenses

# Installeer Android Build Tool en bibliotheken
RUN $ANDROID_HOME/tools/bin/sdkmanager --update
RUN $ANDROID_HOME/tools/bin/sdkmanager "build-tools;${ANDROID_BUILD_TOOLS_VERSION}"
    "platforms;android-${ANDROID_VERSION}"
    "platform-tools"

RUN mkdir /application
WORKDIR /application
Door deze docker-file te schrijven (ter informatie, je kunt ook een kant-en-klare versie van GitHub downloaden) en het beeld te bouwen, krijg je een virtuele machine waarop je de applicatie kunt bouwen en Junit-tests kunt uitvoeren.
Twee belangrijkste argumenten waarom dit zinvol is: schaalbaarheid en herhaalbaarheid. Met Docker kun je snel een tiental build-agents opzetten die exact dezelfde omgeving hebben als de vorige. Dit maakt het leven van CI-engineers veel eenvoudiger. Het is heel eenvoudig om de android-sdk in Docker te plaatsen, met emulators is het iets ingewikkelder: je moet wat meer moeite doen (of opnieuw een kant-en-klare versie van GitHub downloaden).
Tip #4: Vergeet niet dat controles niet alleen voor de controles zijn, maar voor mensen.
Ontwikkelaars hebben snelle en, het belangrijkste, duidelijke feedback nodig: wat is er stuk, welke test is mislukt, waar kunnen ze de buildlog bekijken.
Tip #5: Wees pragmatisch bij het ontwikkelen van Continuous Integration.
Begrijp duidelijk welke soorten fouten je wilt voorkomen, hoeveel resource, tijd en machine tijd je bereid bent te investeren. Te lange controles kunnen bijvoorbeeld 's nachts worden verplaatst. En van die controles die niet zo belangrijke fouten opsporen, kun je helemaal afzien.
Tip #6: Maak gebruik van kant-en-klare tools.
Er zijn tegenwoordig veel bedrijven die cloud CI aanbieden.
Voor kleine teams is dit een goede oplossing. Je hoeft niets te onderhouden, je betaalt gewoon een beetje geld, stelt je applicatie samen en voert zelfs instrumentatietests uit.
Tip #7: in een groot team zijn in-house oplossingen voordeliger.
Maar vroeg of laat, met de groei van het team, worden in-house oplossingen voordeliger. Er is één aspect aan deze oplossingen. In de economie geldt de wet van de afnemende meeropbrengst: in elk project worden verbeteringen steeds moeilijker en vereisen ze steeds meer investeringen.
De economie beschrijft ons hele leven, inclusief Continuous Integration. Ik heb een grafiek gemaakt van de arbeidsinspanningen voor elke fase in de ontwikkeling van onze Continuous Integration.
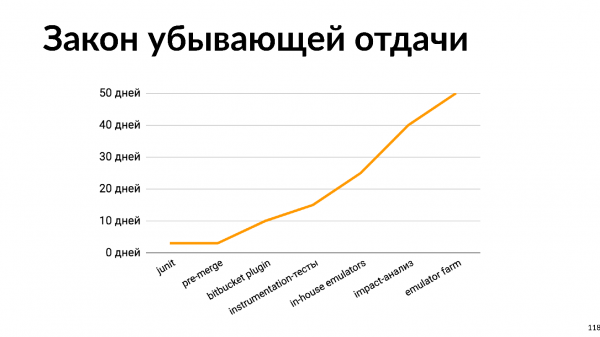
Het is duidelijk dat elke verbetering steeds moeilijker wordt. Kijkend naar deze grafiek, kan je begrijpen dat de ontwikkeling van Continuous Integration in overeenstemming moet zijn met de groei van de teamgrootte. Voor een team van twee mensen is het een slecht idee om 50 dagen te besteden aan de ontwikkeling van een interne emulatorfarm. Maar om helemaal niets te doen aan Continuous Integration voor een groot team is ook een slecht idee, omdat er dan nog meer tijd verloren gaat aan integratieproblemen, communicatieherstel, enz.
We begonnen met het idee dat automatisering nodig is, omdat mensen duur zijn, ze maken fouten en zijn lui. Maar automatiseren zijn ook mensen. Daarom gelden al deze problemen ook voor de automatisering.
- Automatiseren is duur. Denk aan de grafiek van de arbeidsbelasting.
- Bij automatisering maken mensen fouten.
- Soms is het erg lastig om te automatiseren, omdat alles al werkt. Waarom nog iets verbeteren, waarom al die Continuous Integration?
Maar ik heb statistieken: in 20% van de builds worden fouten gevonden. En dit gebeurt niet omdat onze ontwikkelaars slecht code schrijven. Het komt omdat ontwikkelaars geloven dat als ze een fout maken, deze niet in de develop komt; de geautomatiseerde controles zullen het oppikken. Als gevolg daarvan kunnen ontwikkelaars meer tijd besteden aan het schrijven van code en leuke dingen in plaats van lokaal iets uit te voeren en te controleren.
Doe aan Continuous Integration. Maar met mate.
Trouwens, Nikolay Nesterov maakt niet alleen zelf geweldige presentaties, maar zit ook in de programmacommissie en helpt anderen om waardevolle lezingen voor jullie voor te bereiden. De volledigheid en nuttigheid van het programma van de komende conferentie kan worden beoordeeld aan de hand van de onderwerpen in . Voor meer details kun je op 22-23 april terecht in het Infoprospace.
Bron: habr.com
