

Hallo allemaal, we delen de tweede deel van de publicatie ‘Virtuele bestandssystemen in Linux: waarom zijn ze nodig en hoe werken ze?’ Het eerste deel is hier te lezen . Ter herinnering, deze publicatiereeks is gelanceerd ter gelegenheid van de nieuwe editie van de cursus , die binnenkort van start gaat.
Hoe VFS te observeren met eBPF- en bcc-tools
De eenvoudigste manier om te begrijpen hoe de kernel met bestanden omgaat sysfs is door dit in de praktijk te bekijken, en de eenvoudigste manier om ARM64 te observeren is door gebruik te maken van eBPF. eBPF (afkorting van Berkeley Packet Filter) bestaat uit een virtuele machine die draait in , die door geprivilegieerde gebruikers kan worden opgevraagd (query) vanuit de opdrachtregel. De kernelbronnen informeren de lezer over wat de kernel kan doen; het uitvoeren van eBPF-tools in een draaiend systeem laat zien wat de kernel daadwerkelijk doet.
Gelukkig is het vrij eenvoudig om eBPF te gebruiken met de tools , die beschikbaar zijn als pakketten uit de algemene distributie en die uitgebreid zijn gedocumenteerd De tools bcc zijn scripts in Python met kleine stukjes code in C, wat betekent dat iedereen die bekend is met beide talen deze gemakkelijk kan aanpassen. In bcc/tools zijn er 80 Python-scripts, wat betekent dat het waarschijnlijk is dat een ontwikkelaar of systeembeheerder iets kan vinden dat geschikt is voor hun taak.
Om een oppervlakkig begrip te krijgen van welke werkzaamheden VFS in een draaiend systeem uitvoert, probeer vfscount of vfsstat.Dit toont bijvoorbeeld aan dat tientallen aanroepen van vfs_open() en 'zijn vrienden' letterlijk elke seconde plaatsvinden.
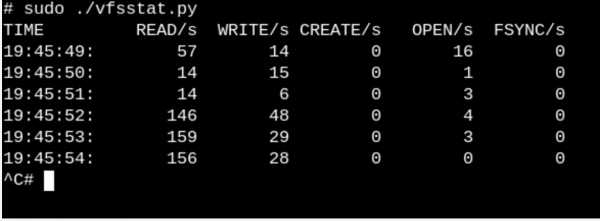
vfsstat.pyis een Python-script, met C-code-invoegingen, dat eenvoudigweg het aantal aanroepen van VFS-functies telt.
Laten we een eenvoudiger voorbeeld geven en kijken wat er gebeurt wanneer we een USB-stick in de computer steken en het systeem deze detecteert.
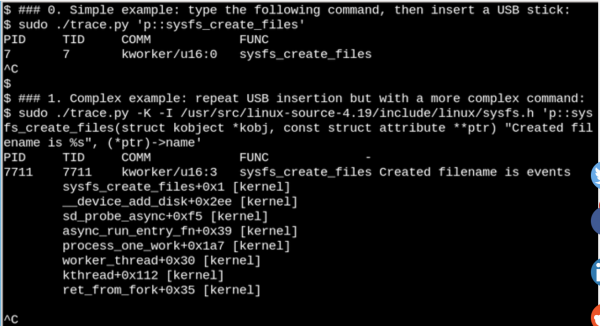
Met eBPF kunnen we zien wat er gebeurt in
/sys, wanneer een USB-stick is ingevoegd. Hier is een eenvoudig en een complex voorbeeld.
In het voorbeeld hierboven, bcc de tool geeft een bericht weer wanneer het commando wordt uitgevoerd sysfs_create_files(). We zien dat sysfs_create_files() is uitgevoerd met behulp van kworker een thread in reactie op het feit dat de stick is ingevoerd, maar welk bestand is er op dat moment aangemaakt? Het tweede voorbeeld toont de volledige kracht van eBPF. Hier trace.py geeft een reverse kernel backtrace weer (optie -K) en de naam van het bestand dat is gemaakt sysfs_create_files(). Invoegen in enkele citaten is code in C die een herkenbare formatteerstring bevat, geleverd door een Python-script dat LLVM aanroept just-in-time compiler. Deze string compileert hij en voert deze uit in een virtuele machine binnen de kernel. De volledige functiehandtekening sysfs_create_files () moet worden gereproduceerd in de tweede opdracht, zodat de formatteerstring naar een van de parameters kan verwijzen. Fouten in dit C-codefragment leiden tot herkenbare fouten van de C-compiler. Bijvoorbeeld, als de parameter -l ontbreekt, zie je "Failed to compile BPF text." Ontwikkelaars die goed bekend zijn met C en Python zullen de tools bcc eenvoudig uitbreidbaar en aanpasbaar vinden.
Wanneer een USB-stick wordt ingevoegd, toont de kernel backtrace aan dat PID 7711 de thread is kworker, die het bestand heeft aangemaakt "events" in sysfs. Dienovereenkomstig zal de aanroep met sysfs_remove_files() laten zien dat het verwijderen van de stick heeft geleid tot het verwijderen van het bestand events, wat overeenkomt met het algemene concept van referentietelling. Hierbij zal het bekijken van sysfs_create_link () met eBPF tijdens het invoegen van de USB-stick laten zien dat er minstens 48 symbolische links zijn aangemaakt.
Wat is dus de betekenis van het bestand events? Het gebruik van om te zoeken naar , toont aan dat deze aanroept disk_add_events (), en dat ofwel "media_change", ofwel "eject_request" in het evenementbestand kunnen worden geschreven. Hier informeert de bloklaag van de kernel userspace over het inserten en ejecten van de "schijf". Let op hoe informatief deze onderzoeksmethode is bij het invoegen van de USB-stick vergeleken met pogingen om te begrijpen hoe alles werkt puur vanuit de broncodes.
Alleen-lezen wortelbesturingssystemen maken ingebouwde apparaten mogelijk
Natuurlijk schakelt niemand de server of zijn computer uit door de stekker uit het stopcontact te trekken. Maar waarom? Omdat ingeladen bestandssystemen op fysieke opslagapparaten uitgestelde schrijvers kunnen hebben, en de datastructuren die hun status opslaan mogelijk niet synchroniseren met de records in de opslag. Wanneer dit gebeurt, moeten systeembeheerders wachten op de volgende herstart om het hulpprogramma fsck filesystem-recovery uit te voeren en in het slechtste geval gegevens te verliezen.
Toch weten we allemaal dat veel IoT-apparaten, evenals routers, thermostaten en auto's, nu op Linux draaien. Veel van deze apparaten hebben praktisch geen gebruikersinterface, en er is geen manier om ze "schoon" uit te schakelen. Stel je voor dat je een auto met een lege accu opstart, terwijl de voeding van de controller aan constant op en neer fluctueert. Hoe gebeurt het dat het systeem opstart zonder een lange fsckwanneer de motor eindelijk begint te draaien? Het antwoord is eenvoudig. Ingebouwde apparaten vertrouwen op het rootbestandssysteem (afgekort ro-rootfs (read-only root filesystem).
ro-rootfs bieden veel voordelen die minder voor de hand liggend zijn dan onveranderlijkheid. Een van de voordelen is dat malware niet kan schrijven naar /usr of /lib, mits geen enkel Linux-proces daar kan schrijven. Een ander voordeel is dat een grotendeels onveranderlijk bestandssysteem cruciaal is voor de veldondersteuning van apparaten op afstand, aangezien het ondersteunend personeel gebruikmaakt van lokale systemen die nominieel identiek zijn aan de systemen ter plaatse. Misschien is het belangrijkste (maar ook het meest verraderlijke) voordeel dat ro-rootfs ontwikkelaars dwingt na te denken over welke systeemelementen onveranderlijk zullen zijn, al in de ontwerpfase van het systeem. Werken met ro-rootfs kan onhandig en pijnlijk zijn, zoals vaak het geval is met const-variabelen in programmeertalen, maar de voordelen wegen ruimschoots op tegen de bijkomende kosten.
Creëren rootfs readonly vereist enige extra inspanning van ontwikkelaars van ingebedde systemen, en hier komt de VFS in het spel. Linux vereist dat bestanden in /var schrijfrechten hebben, en bovendien zullen veel populaire applicaties die ingebedde systemen draaien, proberen configuratie- dot-bestanden in $HOME. Een van de oplossingen voor configuratiebestanden in de thuisdirectory is meestal hun voorafgaande generatie en verzameling in rootfsin te stellen. Voor /var een van de mogelijke benaderingen is om het in een aparte partitie te monteren die schrijfbaar is, terwijl de root zelf / alleen-lezen is. Een andere populaire alternatieve is het gebruik van bind of overlay mounts.
Gekoppelde en overliggende mounts, gebruikt door containers
Uitvoeren van het commando man mount is de beste manier om te leren over gekoppelde en overliggende mounts, die ontwikkelaars en systeembeheerders in staat stellen om een bestandssysteem op één pad te creëren en het vervolgens aan applicaties op een ander pad beschikbaar te stellen. Voor embedded systemen betekent dit de mogelijkheid om bestanden op te slaan in /var een alleen-lezen flash-geheugen, maar een overliggend of gekoppeld gemonteerd pad vanaf tmpfs in /var bij het opstarten stelt applicaties in staat om daar notities (scrawl) te schrijven. Bij de volgende opstart zullen de wijzigingen in /var verloren gaan. Overliggend mounten creëert een samenvoeging tussen tmpfs en het onderliggende bestandssysteem, en maakt het mogelijk om zogenaamd wijzigingen aan te brengen in bestaande bestanden in ro-tootf terwijl gekoppeld mounten nieuwe lege tmpfs mappen zichtbaar kan maken als schrijfbare in ro-rootfs paden. Terwijl overlayfs is het juiste (proper) type bestandssysteem, gekoppeld mounten is geïmplementeerd in .
Gebaseerd op de beschrijving van overliggend en gekoppeld mounten, is het geen verrassing dat ze actief gebruiken. Laten we eens kijken wat er gebeurt wanneer we gebruiken om een container te starten, met het hulpmiddel mountsnoop van bcc.
Aanroep system-nspawn start de container tijdens de uitvoering mountsnoop.py.
Laten we kijken naar het resultaat:
Start mountsnoop tijdens het 'opstarten' van de container toont aan dat de runtime-omgeving van de container sterk afhankelijk is van gekoppeld mounten (alleen het begin van een lange uitvoer wordt weergegeven).
Hier systemd-nspawn levert geselecteerde bestanden van . Functies en sysfs de host naar de container als paden in zijn rootfs. Naast de MS_BIND vlag, die het gekoppeld mounten instelt, bepalen enkele andere vlaggen in het gemonteerde systeem de relatie tussen wijzigingen in de namespace van de host en de container. Bijvoorbeeld, gekoppeld mounten kan ofwel wijzigingen in /proc en /sys naar de container doorlaten of verbergen, afhankelijk van de aanroep.
Conclusie
De interne werking van Linux begrijpen kan een onmogelijke taak lijken, aangezien de kernel zelf een enorme hoeveelheid code bevat, om nog maar te zwijgen van de toepassingen van de gebruikersruimte in Linux en de systeemaanroepinterfaces in C-bibliotheken, zoals glibc. Een van de manieren om vooruitgang te boeken, is door de broncode van een subsysteem van de kernel te lezen, met de nadruk op het begrijpen van systeemeisen en headers die naar de gebruikersruimte verwijzen, evenals de belangrijkste interne interfaces van de kernel, zoals de tabel file_operations. Bestandsbewerkingen volgen het principe 'alles is een bestand', waardoor het beheer ervan bijzonder prettig is. De bronbestanden van de kernel in de bovenliggende map fs/ vertegenwoordigen de implementatie van virtuele bestandssystemen, die een laag van een schil bieden, waardoor een brede en relatief eenvoudige compatibiliteit van populaire bestandssystemen en opslagapparaten mogelijk is. Koppelen met bindmounts en overlappen via Linux-namespaces is de magie van VFS, die het mogelijk maakt om containers en alleen-lezen rootbestandenystemen te creëren. In combinatie met het bestuderen van de broncode, maakt de kern eBPF en zijn interface bcc
het onderzoeken van de kernel gemakkelijker dan ooit.
Vrienden, laat ons weten of deze artikel nuttig voor jullie was. Misschien hebben jullie opmerkingen of suggesties? En voor degenen die geïnteresseerd zijn in de cursus 'Linux Administrator', nodigen we jullie uit voor , die op 18 april plaatsvindt.
Bron: habr.com
