

Bij True Engineering hebben we het proces van continue levering van updates naar de servers van de klant opgezet en willen we deze ervaring delen.
Om te beginnen hebben we een online systeem voor de klant ontwikkeld en deze in ons eigen Kubernetes-cluster geïmplementeerd. Nu is onze high-load oplossing verhuisd naar het platform van de klant, waarvoor we een volledig geautomatiseerd Continuous Deployment-proces hebben opgezet. Hierdoor hebben we de time-to-market versneld – de levering van wijzigingen in de productomgeving.
In dit artikel vertellen we over alle fasen van het Continuous Deployment (CD) proces of het afleveren van updates op het platform van de klant:
- hoe dit proces begint,
- synchronisatie met de Git-repository van de klant,
- assemblage van de backend en frontend,
- automatische uitrol van de applicatie in de testomgeving,
- automatische uitrol naar Prod.
Tijdens het proces delen we de details van de configuratie.
1. Start CD
Continuous Deployment begint wanneer de ontwikkelaar wijzigingen in de release-tak van onze Git-repository aanbrengt.
Onze applicatie werkt op basis van een microservices-architectuur en alle componenten worden in één repository opgeslagen. Hierdoor worden alle microservices gebouwd en geïnstalleerd, zelfs als er slechts één is gewijzigd.
We hebben het werk georganiseerd via één repository om verschillende redenen:
- Gemak van ontwikkeling – de applicatie ontwikkelt zich continu, dus we kunnen direct met de volledige code werken.
- Eén CI/CD-pijplijn die garandeert dat de applicatie als één systeem alle tests doorloopt en wordt afgeleverd in de prod-omgeving van de klant.
- Verwarring in versies uitsluiten – we hoeven geen versiekaart van microservices te onderhouden en voor elke microservice zijn eigen configuratie in Helm-scripts te beschrijven.
2. Synchronisatie met de Git-repository van de klant
De aangebrachte wijzigingen worden automatisch gesynchroniseerd met de Git-repository van de klant. Daar is een build van de applicatie ingesteld die wordt uitgevoerd na een update van de tak, en de uitrol naar prod. Beide processen vinden plaats in hun omgeving vanuit de Git-repository.
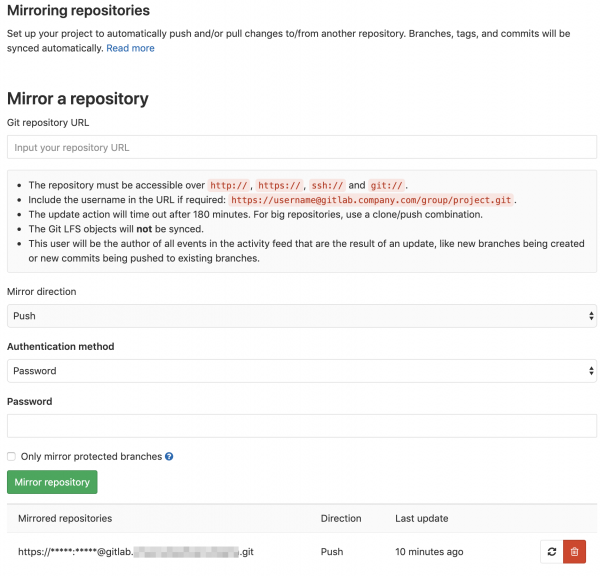
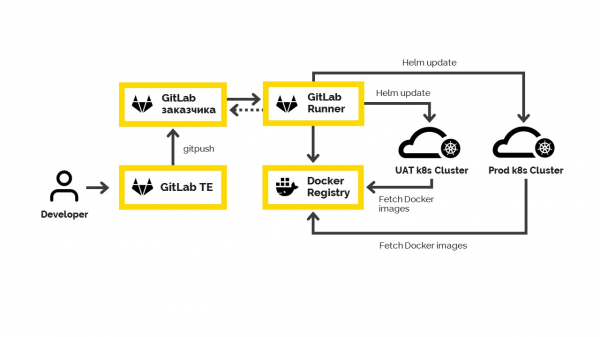
We kunnen niet direct met de repository van de klant werken, omdat we onze eigen omgevingen voor ontwikkeling en testen nodig hebben. Voor deze doeleinden gebruiken we onze eigen Git-repository - deze is gesynchroniseerd met hun Git-repository. Zodra de ontwikkelaar wijzigingen aanbrengt in de betreffende tak van onze repository, verzendt GitLab deze wijzigingen onmiddellijk naar de klant.
Daarna moeten we een build maken. Dit bestaat uit verschillende fasen: de bouw van de backend en de frontend, testen en levering naar productie.
3. Bouw van de backend en frontend
De bouw van de backend en frontend zijn twee parallelle taken die worden uitgevoerd in het GitLab Runner-systeem. De configuratie van de oorspronkelijke build bevindt zich in dezelfde repository.
.
GitLab Runner haalt de code uit de vereiste repository, bouwt het Java-toepassing met behulp van het gebouwcommando en verstuurt het naar de Docker registry. Hier bouwen we de backend en de frontend, verkrijgen Docker-images die we in de repository aan de klantzijde opslaan. Voor het beheer van Docker-images gebruiken we .
We synchroniseren de versies van onze afbeeldingen met de versie van de release die in Docker zal worden gepubliceerd. Voor een soepele werking hebben we een aantal instellingen aangebracht:
1. Containers worden niet opnieuw gebouwd tussen de testomgeving en de productie. We hebben parameterisatie gedaan zodat dezelfde container zonder opnieuw bouwen kan werken met alle instellingen, omgevingsvariabelen en services in zowel de testomgeving als in productie.
2. Om de applicatie via Helm bij te werken, moet de versie ervan worden opgegeven. Voor ons zijn de bouw van de backend, de frontend en de update van de applicatie drie verschillende taken, daarom is het belangrijk om overal dezelfde versie van de applicatie te gebruiken. Voor deze taak gebruiken we gegevens uit de Git-historie, aangezien onze K8S-cluster- en applicatieconfiguratie zich in dezelfde Git-repository bevindt.
We verkrijgen de versie van de applicatie uit de resultaten van de uitvoering van het commando
git describe --tags --abbrev=7.
4. Automatische uitrol van alle wijzigingen in de testomgeving (UAT)
De volgende fase in dit buildscript is het automatische bijwerken van de K8S-cluster. Dit gebeurt op voorwaarde dat de applicatie volledig is gebouwd en alle artefacten in de Docker Registry zijn gepubliceerd. Daarna wordt de testomgeving bijgewerkt.
De update van de cluster wordt gestart met behulp van . Als er iets misgaat, zorgt Helm ervoor dat het al zijn wijzigingen automatisch en zelfstandig terugdraait. Het is niet nodig om zijn werking te controleren.
We leveren bij de build de configuratie van de K8S-cluster. De volgende stap is het updaten daarvan: configMaps, deployments, services, secrets en alle andere K8S-configuraties die we hebben gewijzigd.
Daarna start Helm de RollOut van de applicatie-update in de testomgeving. Voordat de applicatie in productie wordt uitgerold. Dit is gedaan zodat gebruikers handmatig de business-functies kunnen controleren die we in de testomgeving hebben geplaatst.
5. Automatische implementatie van alle wijzigingen naar Prod
Om de update naar de productieomgeving uit te rollen, hoef je alleen nog maar één knop in GitLab in te drukken — en de containers worden onmiddellijk naar de productieomgeving geleverd.
Dezelfde applicatie kan zonder opnieuw bouwen in verschillende omgevingen werken — de test- en productieomgeving. We gebruiken dezelfde artefacten en veranderen niets aan de applicatie, terwijl we de parameters extern instellen.
Flexibele parameterisatie van de applicatie-instellingen is afhankelijk van de omgeving waarin de applicatie wordt uitgevoerd. We hebben alle omgevingsinstellingen extern gemaakt: alles wordt geparametriseerd via K8S-configuratie en Helm-parameters. Wanneer Helm de build in de testomgeving uitrolt, worden testparameters toegepast, en in de productieomgeving productparameters.
Het meest uitdagende was het parametriseren van alle gebruikte services en variabelen die afhankelijk zijn van de omgeving, en deze om te zetten naar omgevingsvariabelen en een beschrijving-configuratie voor de Helm-parameters.
In de applicatieparameters worden omgevingsvariabelen gebruikt. De waarden daarvan worden in containers ingesteld via K8S configmap, die wordt gemodelleerd met behulp van Go-sjablonen. Bijvoorbeeld, het instellen van een omgevingsvariabele voor de domeinnaam kan zo worden gedaan:
APP_EXTERNAL_DOMAIN: {{ (pluck .Values.global.env .Values.app.properties.app_external_domain | first) }}
.Values.global.env – in deze variabele staat de naam van de omgeving (prod, stage, UAT).
.Values.app.properties.app_external_domain – in deze variabele geven we in het bestand .Values.yaml het gewenste domein op
Bij het updaten van de applicatie maakt Helm configmap.yaml-bestanden aan op basis van sjablonen en vult het de waarde APP_EXTERNAL_DOMAIN in met de juiste waarde, afhankelijk van de omgeving waarin de applicatie wordt bijgewerkt. Deze variabele wordt al in de container ingesteld. Toegang tot deze variabele is mogelijk vanuit de applicatie, wat betekent dat in elke omgeving van de applicatie deze variabele een andere waarde zal hebben.
Relatief recent werd er in Spring Cloud ondersteuning voor K8S toegevoegd, inclusief werk met configMaps: . Terwijl het project actief in ontwikkeling is en fundamenteel verandert, kunnen we het nog niet in productie gebruiken. Maar we houden de status nauwlettend in de gaten en gebruiken het in DEV-configuraties. Zodra het stabiliseert, zullen we overschakelen van het gebruik van omgevingsvariabelen naar deze oplossing.
Total
Dus, Continuous Deployment is ingesteld en werkt. Alle updates gebeuren met één druk op de knop. Het leveren van wijzigingen naar de productieomgeving is automatisch. En, belangrijker nog, updates stoppen de werking van het systeem niet.
Toekomstplannen: automatische database-migratie
We hebben nagedacht over een upgrade van de database en de mogelijkheid om deze wijzigingen terug te draaien. Er draaien immers tegelijkertijd twee verschillende versies van de applicatie: de oude versie draait, terwijl de nieuwe wordt opgestart. We schakelen de oude pas uit als we zeker weten dat de nieuwe versie goed functioneert. De database-migratie moet het mogelijk maken om met beide versies van de applicatie te werken.
Daarom kunnen we niet zomaar de naam van een kolom of andere gegevens wijzigen. Maar we kunnen een nieuwe kolom aanmaken, gegevens uit de oude kolom kopiëren en triggers schrijven die bij het bijwerken van gegevens deze tegelijkertijd in de andere kolom kopiëren en bijwerken. En na een succesvolle uitrol van de nieuwe versie van de applicatie, na een periode van post-launch support, kunnen we de oude kolom en de niet meer benodigde trigger verwijderen.
Als de nieuwe versie van de applicatie niet correct werkt, kunnen we terugschakelen naar de vorige versie, inclusief de vorige versie van de database. Kortom, onze wijzigingen maken het mogelijk om tegelijkertijd met meerdere versies van de applicatie te werken.
We zijn van plan de migratie van de database te automatiseren via een K8S-taak, en deze in het CD-proces in te voegen. We zullen deze ervaring zeker op Habra delen.
Bron: habr.com
