

19 september in Moskou de eerste thematische meetup HUG (Highload++ User Group), die gewijd was aan microservices. Hier werd de lezing "Exploiteren van microservices: de grootte doet er toe, zelfs als je Kubernetes hebt" gepresenteerd, waarin we onze uitgebreide ervaring van het bedrijf "Flant" deelden op het gebied van het exploiteren van projecten met microservice-architectuur. Deze lezing is vooral nuttig voor alle ontwikkelaars die overwegen deze aanpak toe te passen in hun huidige of toekomstige project.
Voorstellen (50 minuten, veel informatiever dan een artikel), evenals de belangrijkste samenvatting in tekstvorm.
NB: Video en presentatie zijn ook aan het einde van deze publicatie beschikbaar.
Inleiding
Een goed verhaal heeft meestal een inleiding, een hoofdverhaal en een conclusie. Deze lezing lijkt meer op een inleiding, en dan nog een tragische. Het is ook belangrijk op te merken dat hierin een blik op microservices wordt gepresenteerd vanuit uitbuiting.
Ik begin met deze grafiek, waarvan de auteur (in 2015) Martin Fowler:
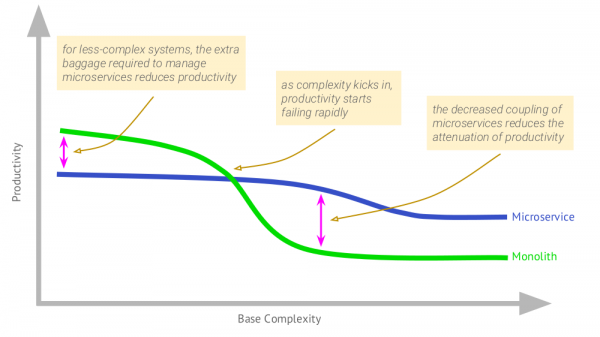
Hierop is te zien dat in het geval van een monolithische applicatie, zodra deze een bepaalde grootte heeft bereikt, de productiviteit begint te dalen. Microservices onderscheiden zich doordat de initiële productiviteit lager is, maar naarmate de complexiteit toeneemt, is de degradatie van de effectiviteit minder merkbaar.
Ik zal deze grafiek aanvullen voor het geval van gebruik van Kubernetes:
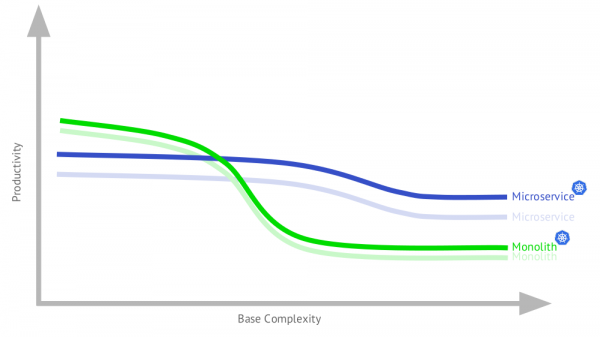
Waarom is de microservices-app beter geworden? Omdat zo'n architectuur serieuze eisen stelt aan de architectuur, die op hun beurt uitstekend worden gedekt door de mogelijkheden van Kubernetes. Aan de andere kant zal een deel van deze functionaliteit ook nuttig zijn voor de monolith, vooral omdat de typische monolith van vandaag de dag niet helemaal een monolith is (details zullen later in de lezing worden besproken).
Zoals te zien is, verschilt de uiteindelijke grafiek (wanneer zowel monolithische als microservices-applicaties in een infrastructuur met Kubernetes worden gebruikt) niet veel van de oorspronkelijke. Vervolgens zal het gaan over applicaties die worden geëxploiteerd met behulp van Kubernetes.
Nuttige en schadelijke microservices
En hier is de belangrijkste gedachte:
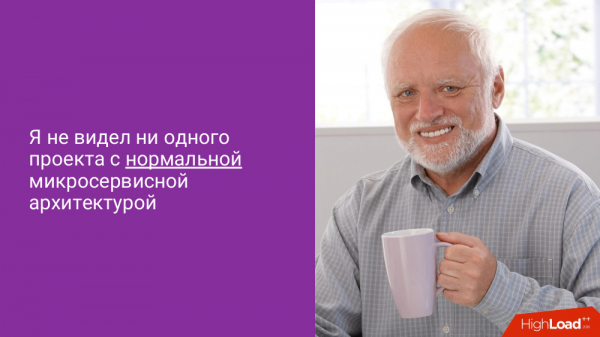
Wat is een normale microservice-architectuur? Het moet u echte voordelen bieden door de efficiëntie van het werk te verhogen. Als we terugkijken naar de grafiek, dan is dit het:
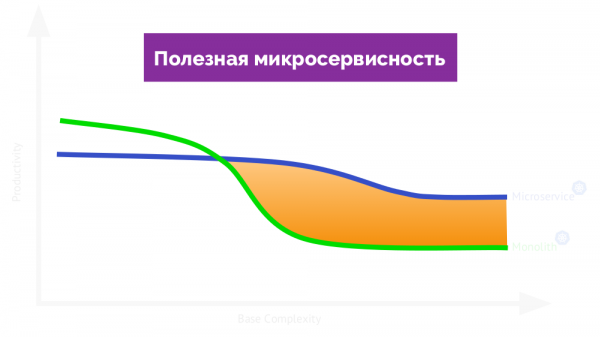
Als je het een nuttigenoemt, dan staat aan de andere kant van de grafiek schadelijke microservices (belemmert het werk):
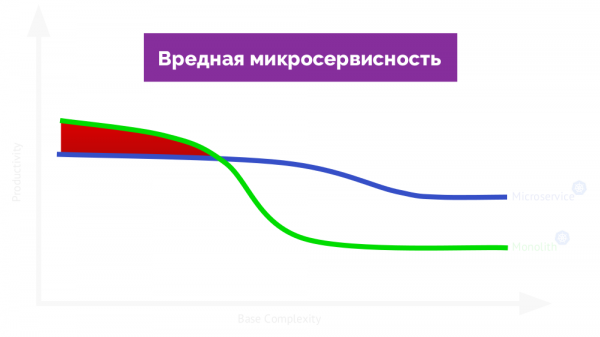
Terugkomend op de 'hoofdgedachte': is het überhaupt de moeite waard om mijn ervaring te vertrouwen? Sinds het begin van dit jaar heb ik gekeken 85 projecten. Niet allemaal waren ze microservices (ongeveer een derde tot de helft had deze architectuur), maar het is nog steeds een groot aantal. Wij (bedrijf 'Flant') als outsourcers krijgen de kans om een breed scala aan applicaties te zien, ontwikkeld in zowel kleine bedrijven (met 5 ontwikkelaars) als in grote (~500 ontwikkelaars). Een extra pluspunt is dat we kunnen zien hoe deze applicaties zich door de jaren heen ontwikkelen en evolueren.
Waarom microservices?
Op de vraag naar de voordelen van microservices is er van de eerder genoemde Martin Fowler:
- duidelijke grenzen van modulariteit;
- onafhankelijk deployen;
- vrijheid om technologieën te kiezen.
Ik heb veel gesproken met softwarearchitecten en ontwikkelaars en hen gevraagd waarom ze microservices nodig hebben. En ik heb mijn lijst van hun verwachtingen samengesteld. Dit is het resultaat:
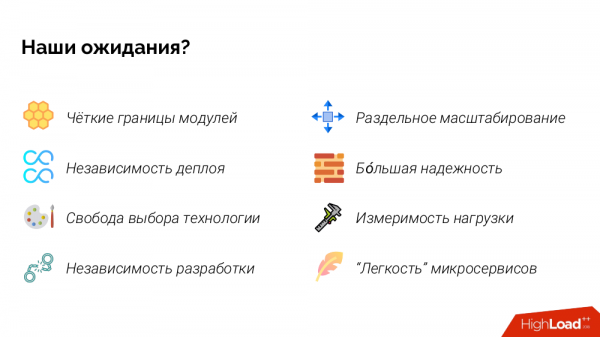
Als ik sommige punten 'in gevoelens' zou beschrijven, dan:
- duidelijke grenzen van modules: hier hebben we een verschrikkelijke monoliet, en nu zal alles netjes worden verdeeld over Git-repositories, waarin alles 'op de planken' ligt, niet gemengd warm met zacht;
- onafhankelijkheid van deployment: we kunnen services onafhankelijk uitrollen, zodat de ontwikkeling sneller kan verlopen (parallell publiceren van nieuwe functies);
- onafhankelijkheid van ontwikkeling: we kunnen deze microservice aan het ene team/ontwikkelaar toewijzen, en dat team aan een ander, zodat we sneller kunnen ontwikkelen;
- bgroter publiek.grotere betrouwbaarheid: als er zich een gedeeltelijke degradatie voordoet (één microservice uit 20 valt weg), dan stopt alleen één knop met werken, terwijl het systeem als geheel blijft functioneren.
Typische (schadelijke) microservicesarchitectuur
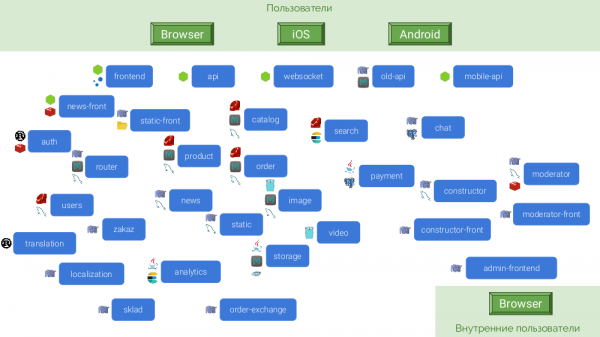
Om uit te leggen waarom in de praktijk alles niet zo is als we verwachten, zal ik een gecombineerd beeld van Microservices-architectuur presenteren, gebaseerd op ervaring uit vele verschillende projecten.
Een voorbeeld is een abstracte online winkel die in de competitie wil gaan met Amazon of in ieder geval met OZON. De microservicesarchitectuur ziet er als volgt uit:
Om verschillende redenen zijn deze microservices op verschillende platforms geschreven:

Aangezien elke microservice autonomie moet hebben, hebben velen hun eigen database en cache nodig. De uiteindelijke architectuur ziet er als volgt uit:
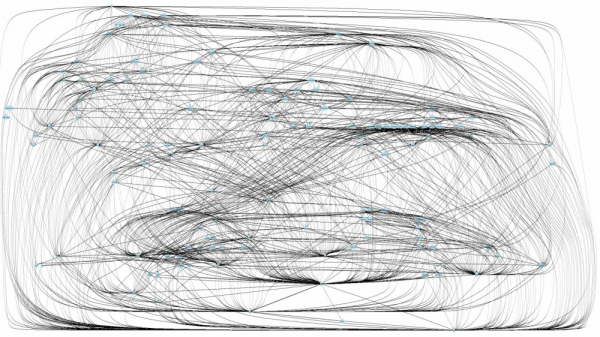
Wat zijn de gevolgen?
Fowler heeft daar ook een artikel over Laten we zien of onze verwachtingen zijn waargemaakt.
Duidelijke grenzen tussen modules...
hoeveel microservices moeten we in feite aanpassen
Maar , om de wijziging door te voeren? Kunnen we eigenlijk begrijpen hoe alles werkt zonder een gedistribueerde tracer (immers, elke aanvraag wordt door de helft van de microservices verwerkt)?Er bestaat een patroon van '
een grote klomp vuilOnafhankelijkheid van deployen...
Technisch gezien is dat bereikt: we kunnen elke microservice afzonderlijk opnieuw uitrollen. Maar in de praktijk moeten we in gedachten houden dat altijd
meerdere microservices worden uitgerold , en we moeten rekening houden metde volgorde van hun uitrol . Voornamelijk zouden we in feite in een afzonderlijke keten moeten testen of we de release in de juiste volgorde uitrollen.Vrijheid van technologiekeuze...
Die is er. Maar we moeten ons realiseren dat vrijheid vaak aan de rand van chaos ligt. Het is erg belangrijk om technologieën niet te kiezen alleen om er 'mee te spelen'.
Onafhankelijkheid van ontwikkeling...
Hoe maak je een testomgeving voor de hele applicatie (uit zoveel componenten)? En bovendien moet deze actueel worden gehouden. Dit leidt ertoe dat
het werkelijke aantal testomgevingen , dat we in principe kunnen onderhouden,minimaal blijkt te zijn. En om dit alles lokaal te implementeren?.. Het blijkt dat de ontwikkelaar vaak onafhankelijk werkt, maar 'op goed geluk', omdat hij geduldig moet wachten tot er ruimte komt voor het testen..
Gescheiden schaalbaarheid...
Ja, maar het is beperkt in de gebruikt databasesystemen. In het gegeven architectuurvoorbeeld zal Cassandra geen problemen ondervinden, maar MySQL en PostgreSQL zullen dat wel.
B
etere betrouwbaarheid...groter publiek.Het is niet alleen zo dat een storing van één microservice vaak het correcte functioneren van het hele systeem verstoort, maar er is ook een nieuw probleem:
elke microservice uitvallen is erg moeilijk . Omdat er verschillende technologieën (memcache, Redis, enz.) in microservices worden gebruikt, moet voor elk alles goed doordacht en geïmplementeerd worden, wat natuurlijk mogelijk is, maar enorme middelen vereist.. Omdat in microservices verschillende technologieën worden gebruikt (memcache, Redis, enz.), moet voor elk alles goed worden doordacht en uitgevoerd, wat natuurlijk mogelijk is, maar enorme middelen vereist.
Meetbaarheid van belasting…
Hier is echt alles in orde.
De 'lichtheid' van microservices…
We hebben niet alleen enorme netto overheadkosten (door een toename van DNS-verzoeken, enz.), maar door de vele subverzoeken zijn we begonnen met databases te repliceren (caches op te slaan), wat leidde tot aanzienlijke opslagvolumes.
En dit is de uitkomst in overeenstemming met onze verwachtingen:
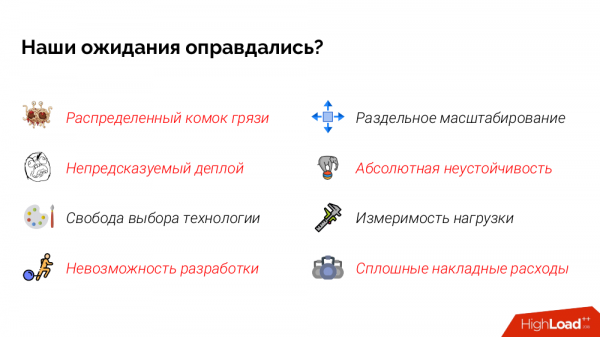
Maar dat is nog niet alles!
Omdat:
- Waarschijnlijk hebben we een berichtenbus nodig.
- Hoe maak je een consistente back-up op het juiste moment? De enige reële optie is om het verkeer daarvoor uit te schakelen. Maar hoe doe je dat in productie?
- Als we het hebben over ondersteuning van meerdere regio's, dan is het organiseren van veerkracht in elk van hen een zeer arbeidsintensie taak.
- Er ontstaat een probleem met het aanbrengen van gecentraliseerde wijzigingen. Bijvoorbeeld, als we de PHP-versie moeten bijwerken, dan is het nodig om een commit te maken in elke repository (en dat zijn er tientallen).
- De groei van operationele complexiteit lijkt exponentieel.
Wat moeten we hiermee doen?
Begin met een monolithische applicatie. Fowler's ervaring dat vrijwel alle succesvolle microservice-applicaties zijn begonnen als een monoliet die te groot werd en vervolgens werd opgesplitst. Tegelijkertijd hebben vrijwel alle systemen die vanaf het begin als microservices zijn gebouwd, vroeg of laat ernstige problemen ervaren.
Een andere waardevolle gedachte is dat, om een project met microservice-architectuur succesvol te maken, je zowel de domeinexpertise als de kennis van het maken van microservices goed moet begrijpen. En de beste manier om de domeinexpertise te leren, is door een monolith te maken.Maar wat te doen als we al in zo'n situatie zijn beland?
De eerste stap naar het oplossen van elk probleem is het erkennen en begrijpen dat dit een probleem is, dat we niet langer willen lijden.
Als we in het geval van een gegroeide monolith (wanneer we niet meer in staat zijn om middelen voor hem te kopen) deze snijden, is het in dit geval anders: wanneer overmatige microservice-structuur al niet meer helpt, maar zelfs in de weg zit —
snijd het overbodige weg en vergroot Bijvoorbeeld, voor de hierboven besproken verzamelbeeld…!
Verlies de meest twijfelachtige microservices:
Combineer alle microservices die verantwoordelijk zijn voor de frontend-generatie:
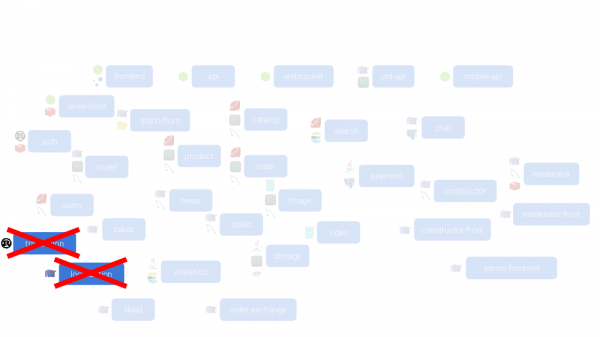
Combineer alle microservices die verantwoordelijk zijn voor de frontend-generatie:
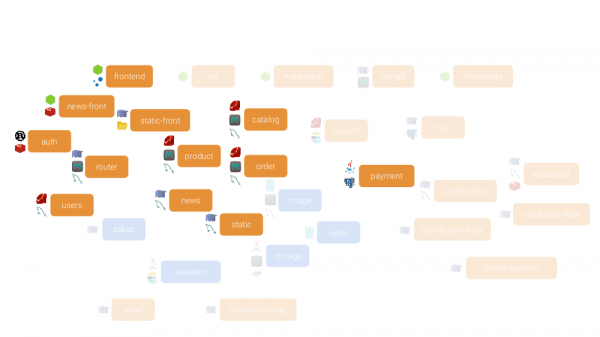
… in één microservice, geschreven in één (moderne en goede, zoals u zelf denkt) taal/framework:
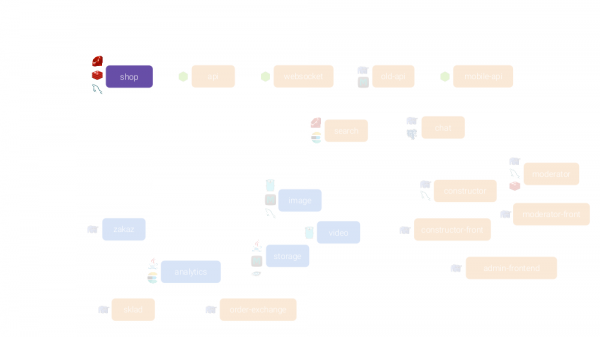
Het zal een ORM (één databasesysteem) hebben en in eerste instantie een paar applicaties:
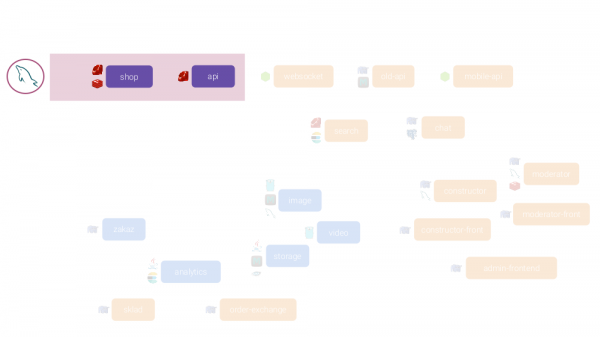
… maar het is mogelijk om veel meer te verplaatsen, wat het volgende resultaat oplevert:
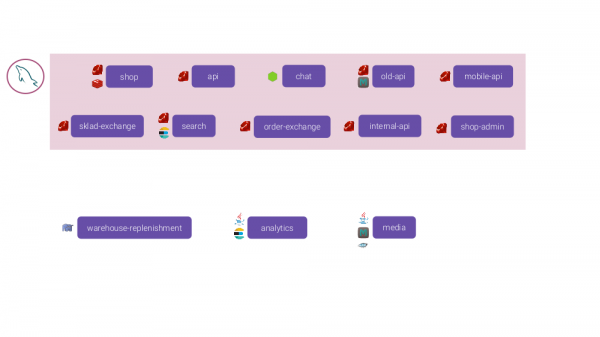
In Kubernetes starten we dit allemaal als afzonderlijke instanties, wat betekent dat we nog steeds de belasting kunnen meten en ze apart kunnen schalen.
Samenvattend
Kijk breder naar het plaatje. Vaak ontstaan al deze problemen met microservices omdat iemand zijn taak nam, maar 'een spelletje met microservices wilde spelen'.
In het woord 'microservices' is het gedeelte 'micro' overbodig.. Ze zijn 'micro' alleen maar omdat ze kleiner zijn dan een enorme monoliet. Maar denk niet aan hen als iets kleins.
En voor de laatste gedachte keer terug naar het oorspronkelijke schema:
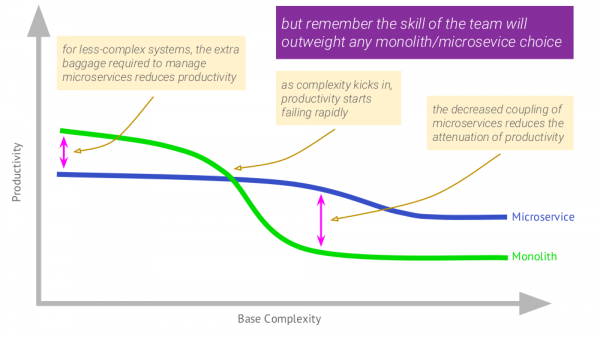
De opmerking die erbij is geschreven (rechtsboven) komt neer op het feit dat de vaardigheden van het team dat uw project maakt, altijd primair zijn — zij zullen een sleutelrol spelen in uw keuze tussen microservices en monoliet. Als het team niet genoeg vaardigheden heeft, maar begint met microservices, zal het verhaal zeker fataal zijn.
Video en slides
Video van de presentatie (~50 minuten; helaas kan het de vele emoties van de bezoekers niet overbrengen, die voor een groot deel de sfeer van de lezing bepaalden, maar zo is het):
Presentatie van het verslag:
P.S.
Andere lezingen op onze blog:
- «» (Dmitry Stolyarov; 28 mei 2018 op RootConf);
- «» (Dmitry Stolyarov; 7 november 2017 op HighLoad++);
- «» (Dmitry Stolyarov; 6 juni 2017 op RootConf);
- «» (Dmitriy Stolyarov; 8 november 2016 op HighLoad++);
- «» (Dmitriy Stolyarov; 31 mei 2016 op RootConf).
Waarschijnlijk zijn de volgende publicaties ook interessant voor u:
- «»;
- «»;
- «».
Bron: habr.com
