

SciPy (uitgesproken als 'sigh pie') is een pakket voor toegepaste wiskundige procedures, gebaseerd op de Numpy-uitbreiding van Python. Met SciPy wordt een interactieve Python-sessie omgevormd tot een volwaardige omgeving voor gegevensverwerking en prototyping van complexe systemen, zoals MATLAB, IDL, Octave, R-Lab en SciLab. Vandaag wil ik kort uitleggen hoe enkele bekende optimalisatie-algoritmen in het scipy.optimize-pakket kunnen worden toegepast. Meer gedetailleerde en actuele documentatie over het gebruik van functies kan altijd worden verkregen met het commando help() of met Shift+Tab.
Inleiding
Om mezelf en de lezers de zoektocht naar en het lezen van primaire bronnen te besparen, zullen de verwijzingen naar de methoden voornamelijk naar Wikipedia gaan. Over het algemeen is deze informatie voldoende voor een algemeen begrip van de methoden en de voorwaarden voor hun toepassing. Voor een dieper begrip van de wiskundige methoden volgen we de links naar meer gezaghebbende publicaties, die aan het einde van elk artikel of in de favoriete zoekmachine te vinden zijn.
Het module scipy.optimize omvat de implementatie van de volgende procedures:
- Conditie- en onvoorwaardelijke minimalisatie van scalairen functies van meerdere variabelen (minim) met behulp van verschillende algoritmes (Nelder-Mead simplex, BFGS, geconjugeerde gradienten van Newton, en )
- Globale optimalisatie (bijvoorbeeld: , )
- Minimalisatie van residuen (least_squares) en algoritmes voor curve-fitting met niet-lineaire OLS (curve_fit)
- Minimalisatie van scalairen functies van één variabele (minim_scalar) en het zoeken naar wortels (root_scalar)
- Multidimensionale oplosser van vergelijkingen (root) met behulp van verschillende algoritmes (hybride Powell, of grootschalige methoden zoals ).
In dit artikel zullen we alleen het eerste punt van deze lijst bekijken.
Onvoorwaardelijke minimalisatie van een scalair functie van meerdere variabelen
De functie minim uit het scipy.optimize-pakket biedt een algemene interface voor het oplossen van problemen van conditie- en onvoorwaardelijke minimalisatie van scalairen functies van meerdere variabelen. Om de werking ervan te demonstreren, hebben we een geschikte functie van meerdere variabelen nodig die we op verschillende manieren zullen minimaliseren.
Voor deze doeleinden is de Rosenbrock-functie van N variabelen, die de volgende vorm heeft, zeer geschikt:

Hoewel de Rosenbrock-functie en haar Jacobimatrices en Hessiaan (respectievelijk de eerste en tweede afgeleide) al zijn gedefinieerd in het pakket scipy.optimize, definiëren we deze zelf.
import numpy as np

def rosen(x):
    """De Rosenbrock-functie"""
    return np.sum(100.0*(x[1:]-x[:-1]**2.0)**2.0 + (1-x[:-1])**2.0, axis=0)
Voor de duidelijkheid visualiseren we de waarden van de Rosenbrock-functie voor twee variabelen in 3D.
Code voor de visualisatie
from mpl_toolkits.mplot3d import Axes3D
import matplotlib.pyplot as plt
from matplotlib import cm
from matplotlib.ticker import LinearLocator, FormatStrFormatter

# Stel de 3D-grafiek in
fig = plt.figure(figsize=[15, 10])
ax = fig.gca(projection='3d')

# Stel de kijkhoek in
ax.view_init(45, 30)

# Maak gegevens voor de grafiek aan
X = np.arange(-2, 2, 0.1)
Y = np.arange(-1, 3, 0.1)
X, Y = np.meshgrid(X, Y)
Z = rosen(np.array([X,Y]))

# Teken het oppervlak
surf = ax.plot_surface(X, Y, Z, cmap=cm.coolwarm)
plt.show()
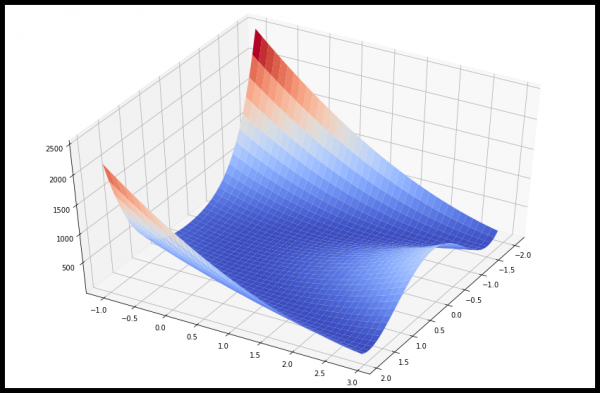
Wetende dat het minimum gelijk is aan 0 bij  , bekijken we voorbeelden van hoe we het minimum van de Rosenbrock-functie kunnen bepalen met behulp van verschillende procedures van scipy.optimize.
Nelder-Mead simplex-methode
Laten we een startpunt x0 in een 5-dimensionale ruimte hebben. We zullen het dichtstbijzijnde punt naar het minimum van de Rosenbrock-functie vinden met behulp van het (het algoritme is opgegeven als de waarde van de parameter method):
from scipy.optimize import minimize
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='nelder-mead',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimalisatie is succesvol beëindigd.
Huidige functiewaarde: 0.000000
Iteraties: 339
Functie-evaluaties: 571
[1. 1. 1. 1. 1.]De simplex-methode is de eenvoudigste manier om een expliciet gedefinieerde en vrij gladde functie te minimaliseren. Het vereist geen berekening van de afgeleiden van de functie; het is voldoende om alleen de waarden in te voeren. De Nelder-Mead-methode is een goede keuze voor eenvoudige minimaliseringsproblemen. Omdat het echter geen schattingen van de gradiënt gebruikt, kan het langer duren om het minimum te vinden.
Powell-methode
Een andere optimalisatie-algoritme dat alleen de functiewaarden berekent, is de . Om deze te gebruiken, moet je method = 'powell' instellen in de minim-functie.
x0 = np.array([1.3, 0.7, 0.8, 1.9, 1.2])
res = minimize(rosen, x0, method='powell',
    options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimalisatie is succesvol beëindigd.
Huidige functiewaarde: 0.000000
Iteraties: 19
Functie-evaluaties: 1622
[1. 1. 1. 1. 1.]Broyden-Fletcher-Goldfarb-Shanno-algoritme (BFGS)
Voor snellere convergentie naar de oplossing, behandelt de procedure maakt gebruik van de gradient van de doelfunctie. De gradient kan worden opgegeven als een functie of worden berekend met behulp van de eerste-orde verschillen. In ieder geval vereist de BFGS-methode meestal minder functie-aanroepen dan de simplex-methode.
Laten we de afgeleide van de Rosenbrock-functie analytisch vinden:


Deze uitdrukking is geldig voor de afgeleiden van alle variabelen, behalve de eerste en de laatste, die worden gedefinieerd als:


Laten we kijken naar de Python-functie die deze gradient berekent:
def rosen_der (x):
    xm = x [1: -1]
    xm_m1 = x [: - 2]
    xm_p1 = x [2:]
    der = np.zeros_like (x)
    der [1: -1] = 200 * (xm-xm_m1 ** 2) - 400 * (xm_p1 - xm ** 2) * xm - 2 * (1-xm)
    der [0] = -400 * x [0] * (x [1] -x [0] ** 2) - 2 * (1-x [0])
    der [-1] = 200 * (x [-1] -x [-2] ** 2)
    return der
De functie voor het berekenen van de gradient wordt opgegeven als de waarde van de parameter jac van de functie minim, zoals hieronder weergegeven.
res = minimize(rosen, x0, method='BFGS', jac=rosen_der, options={'disp': True})
print(res.x)
Optimalisatie is succesvol beëindigd.
Huidige functie waarde: 0.000000
Iteraties: 25
Functie-evaluaties: 30
Gradient-evaluaties: 30
[1.00000004 1.0000001 1.00000021 1.00000044 1.00000092]Het conjugate gradient-algoritme (Newton)
Algoritme is een gemodificeerde methode van Newton.
De methode van Newton is gebaseerd op het approximaat maken van de functie in een lokaal gebied met een tweede-graadspolynoom:

waar  is de matrix van tweede afgeleiden (Hesse-matrix, hessian).
Als de hessian positief gedefinieerd is, kan het lokale minimum van deze functie worden gevonden door de nulgradient van de kwadratische vorm gelijk aan nul te stellen. Dit resulteert in de uitdrukking:

De inverse hessian wordt berekend met behulp van de conjugate gradient-methode. Hieronder is een voorbeeld van het gebruik van deze methode voor het minimaliseren van de Rosenbrock-functie. Om de Newton-CG-methode te gebruiken, moet je een functie opgeven die de hessian berekent.
De hessian van de Rosenbrock-functie in analytische vorm is gelijk aan:


waar  en
 , bepaalt de matrix
 .
De overige niet-nul elementen van de matrix zijn gelijk aan:


Bijvoorbeeld, in een vijfdimensionale ruimte N = 5, heeft de Hesse-matrix voor de Rosenbrock-functie een bandvorm:

De code die deze hessian berekent, samen met de code voor het minimaliseren van de Rosenbrock-functie met behulp van de conjugate gradient-methode (Newton):
def rosen_hess(x):
    x = np.asarray(x)
    H = np.diag(-400*x[:-1],1) - np.diag(400*x[:-1],-1)
    diagonal = np.zeros_like(x)
    diagonal[0] = 1200*x[0]**2-400*x[1]+2
    diagonal[-1] = 200
    diagonal[1:-1] = 202 + 1200*x[1:-1]**2 - 400*x[2:]
    H = H + np.diag(diagonal)
    return H

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hess=rosen_hess,
               options={'xtol': 1e-8, 'disp': True})
print(res.x)
Optimalisatie succesvol beëindigd.
Huidige functiewaarde: 0.000000
Iteraties: 24
Functie-evaluaties: 33
Gradiënt-evaluaties: 56
Hessian-evaluaties: 24
[1. 1. 1. 0.99999999 0.99999999]Voorbeeld van de definitie van de functie voor het product van de hessian en een willekeurige vector
In echte situaties kan het berekenen en opslaan van de volledige hessiaanmatrix aanzienlijke tijd- en geheugenbronnen vereisen. Het is echter niet nodig om de hessiaanmatrix zelf vast te stellen, omdat voor de optimalisatieprocedure slechts de vector nodig is die gelijk is aan het product van de hessian met een andere willekeurige vector. Vanuit computatiedimensionaal perspectief is het daarom veel preferabel om direct de functie te definiëren die het resultaat van het product van de hessian met een willekeurige vector retourneert.
Laten we de functie hess bekijken, die de vector voor minimalisatie als eerste argument accepteert, en een willekeurige vector als tweede argument (naast andere argumenten van de te minimaliseren functie). In ons geval is het niet erg moeilijk om het product van de hessian van de Rosenbrok-functie met een willekeurige vector te berekenen. Als Het commando geeft een lijst van onze huidige partities weer. In mijn geval één partitie van 30 GB en nog 20 GB in vrije ruimte, als ik dat zo mag zeggen. — een willekeurige vector, dan is het product  van de volgende vorm:

De functie die het product van de hessian en een willekeurige vector berekent, wordt doorgegeven als de waarde van het argument hessp aan de functie minimize:
def rosen_hess_p(x, p):
    x = np.asarray(x)
    Hp = np.zeros_like(x)
    Hp[0] = (1200*x[0]**2 - 400*x[1] + 2)*p[0] - 400*x[0]*p[1]
    Hp[1:-1] = -400*x[:-2]*p[:-2]+(202+1200*x[1:-1]**2-400*x[2:])*p[1:-1]
    -400*x[1:-1]*p[2:]
    Hp[-1] = -400*x[-2]*p[-2] + 200*p[-1]
    return Hp

res = minimize(rosen, x0, method='Newton-CG',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'xtol': 1e-8, 'disp': True})
Optimalisatie succesvol beëindigd.
         Huidige functiewaarde: 0.000000
         Iteraties: 24
         Functie-evaluaties: 33
         Gradiënt-evaluaties: 56
         Hessian-evaluaties: 66
Het algoritme voor de vertrouwensregio (trust region) van de geconjugeerde gradiënten (Newton)
Slechte conditionering van de hessiaanmatrix en verkeerde zoekrichtingen kunnen ervoor zorgen dat het algoritme van de geconjugeerde gradiënten van Newton inefficiënt is. In zulke gevallen wordt de voorkeur gegeven aan (trust-region) van de geconjugeerde gradiënten van Newton.
Voorbeeld van de definitie van de hessiaanmatrix:
res = minimize(rosen, x0, method='trust-ncg',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
print(res.x)
Optimalisatie succesvol beëindigd.
Huidige functiewaarde: 0.000000
Iteraties: 20
Functiewaarderingen: 21
Gradiëntwaarderingen: 20
Hessiaanwaarderingen: 19
[1. 1. 1. 1. 1.]Voorbeeld met de functie van het product van de hessiaan en een willekeurig vector:
res = minimize(rosen, x0, method='trust-ncg',
                jac=rosen_der, hessp=rosen_hess_p,
                options={'gtol': 1e-8, 'disp': True})
print(res.x)
Optimalisatie succesvol beëindigd.
Huidige functiewaarde: 0.000000
Iteraties: 20
Functiewaarderingen: 21
Gradiëntwaarderingen: 20
Hessiaanwaarderingen: 0
[1. 1. 1. 1. 1.]Krylov-type methoden
Net als de trust-ncg-methode zijn Krylov-type methoden goed geschikt voor het oplossen van grootschalige problemen, omdat ze alleen matrix-vector producten gebruiken. Hun essentie ligt in het oplossen van een probleem binnen een vertrouwensgebied, begrensd door een afgekapt Krylov-subruimte. Voor onbepaalde problemen is het beter om deze methode te gebruiken, omdat het minder niet-lineaire iteraties vereist door het kleinere aantal matrix-vector producten per subtaak in vergelijking met de trust-ncg-methode. Bovendien is de oplossing van de kwadratische subtaak nauwkeuriger dan met de trust-ncg-methode.
Voorbeeld van de definitie van de hessiaanmatrix:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})

Optimalisatie succesvol beëindigd.
         Huidige functiewaarde: 0.000000
         Iteraties: 19
         Functiewaarderingen: 20
         Gradiëntwaarderingen: 20
         Hessiaanwaarderingen: 18

print(res.x)

    [1. 1. 1. 1. 1.]
Voorbeeld met de functie van het product van de hessiaan en een willekeurig vector:
res = minimize(rosen, x0, method='trust-krylov',
               jac=rosen_der, hessp=rosen_hess_p,
               options={'gtol': 1e-8, 'disp': True})

Optimalisatie succesvol beëindigd.
         Huidige functiewaarde: 0.000000
         Iteraties: 19
         Functiewaarderingen: 20
         Gradiëntwaarderingen: 20
         Hessiaanwaarderingen: 0

print(res.x)

    [1. 1. 1. 1. 1.]
Algoritme voor het benaderend oplossen in een vertrouwensgebied
Alle methoden (Newton-CG, trust-ncg en trust-krylov) zijn goed geschikt voor het oplossen van grootschalige problemen (met duizenden variabelen). Dit komt doordat het onderliggende algoritme van geconjugeerde gradiënten een benaderende bepaling van de inverse Hessiaanmatrix impliceert. De oplossing wordt iteratief gevonden, zonder een expliciete ontbinding van de hessiaan. Aangezien alleen de functie voor het product van de hessiaan en een willekeurig vector hoeft te worden bepaald, is dit algoritme bijzonder goed voor het werken met spaarzame (band-diagonale) matrices. Dit zorgt voor lage geheugenkosten en aanzienlijke tijdsbesparing.
Bij taken van gemiddelde grootte zijn de kosten voor opslag en het ontbinden van de Hessian niet cruciaal. Dit betekent dat een oplossing kan worden verkregen met minder iteraties door de deelproblemen van het vertrouwen bijna exact op te lossen. Hiervoor worden enkele niet-lineaire vergelijkingen iteratief opgelost voor elk kwadratisch deelprobleem. Een dergelijke oplossing vereist doorgaans 3 of 4 Cholesky-decomposities van de Hessiaanse matrix. Dit resulteert in een snellere convergentie met minder iteraties en minder berekeningen van de doelfunctie dan andere geïmplementeerde methoden voor de vertrouwensgebied. Dit algoritme gaat alleen uit van de volledige Hessiaanse matrix en ondersteunt niet de mogelijkheid om de functie van het product van de Hessiaan en een willekeurige vector te gebruiken.
Voorbeeld van de minimalisatie van de Rosenbrock-functie:
res = minimize(rosen, x0, method='trust-exact',
               jac=rosen_der, hess=rosen_hess,
               options={'gtol': 1e-8, 'disp': True})
res.x
Optimalisatie succesvol beëindigd.
Huidige functie waarde: 0.000000
Iteraties: 13
Functieberekeningen: 14
Gradiëntberekeningen: 13
Hessian evaluaties: 14
array([1., 1., 1., 1., 1.])Laten we hier maar bij stoppen. In het volgende artikel zal ik proberen het meest interessante te vertellen over voorwaardelijke minimalisatie, de toepassing van minimalisatie bij het oplossen van approximatieproblemen, minimalisatie van een functie van één variabele, willekeurige minimalisatoren en het vinden van de wortels van een systeem van vergelijkingen met behulp van het pakket scipy.optimize.
Bron:
Bron: habr.com
