

Hallo, ik ben Sergey Ylantsev, ik ontwikkel in Yandex Cloud. Eerder leidde ik de ontwikkeling van de L7-balancer voor het Yandex-portaal — collega’s grappen dat alles wat ik doe, een balancer wordt. Ik zal de lezers van Habr vertellen hoe je de belasting op een cloudplatform moet beheren, hoe wij het ideale hulpmiddel voor deze taak visualiseren en hoe we werken aan de bouw van dit hulpmiddel.
Laten we beginnen met enkele termen:
- VIP (Virtual IP) — het IP-adres van de balancer
- Server, backend, instance — een virtuele machine met een draaiende applicatie
- RIP (Real IP) — het IP-adres van de server
- Healthcheck — een controle van de gereedheid van de server
- Beschikbaarheidszone, Availability Zone, AZ — geïsoleerde infrastructuur in een datacenter
- Regio — een verzameling verschillende AZ's
Laatstbalancers hebben drie hoofdtaken: ze voeren de balancering uit, verbeteren de fouttolerantie van de service en vereenvoudigen de schaalbaarheid. Fouttolerantie wordt bereikt door automatische verkeersbeheer: de balancer controleert de status van de applicatie en sluit instances die de gezondheidscontrole niet doorstaan uit de balancering. Schaalbaarheid wordt bereikt door een gelijkmatige verdeling van de belasting over instances, evenals door het dynamisch vernieuwen van de lijst met instances. Als de balancering niet voldoende gelijkmatig is, zullen sommige instances worden belast met meer dan hun operationele limiet kan aan, waardoor de service minder betrouwbaar wordt.
Laatstbalancers worden vaak gecategoriseerd op basis van het niveau van het protocol uit het OSI-model waarop ze werken. De Cloud-balancer werkt op het TCP-niveau, dat overeenkomt met niveau vier, L4.
Laten we overgaan tot een overzicht van de architectuur van de Cloud-balancer. We zullen geleidelijk het detailniveau verhogen. We verdelen de componenten van de balancer in drie klassen. De config plane-klasse zorgt voor interactie met de gebruiker en bevat de doeltoestand van het systeem. De control plane bevat de actuele toestand van het systeem en beheert systemen uit de data plane-klasse, die verantwoordelijk zijn voor het leveren van verkeer van klanten naar uw instances.
Data plane
Verkeer komt terecht op dure apparaten die border routers worden genoemd. Voor verhoogde fouttolerantie werken meerdere van dergelijke apparaten tegelijkertijd in één datacenter. Vervolgens komt het verkeer terecht bij load balancers, die voor klanten een anycast IP-adres aankondigen naar alle AZ's via BGP.
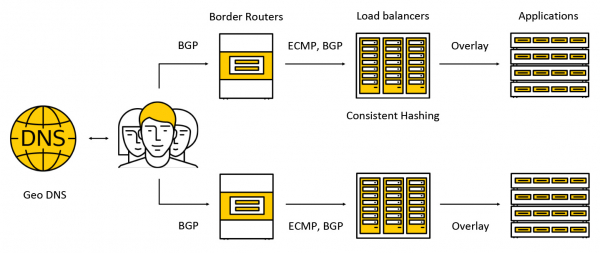
Verkeer wordt verzonden via ECMP — een routeringsstrategie waarbij er meerdere even goede routes naar het doel kunnen zijn (in ons geval het destination IP-adres), en pakketten kunnen over elk van deze routes worden verzonden. We ondersteunen ook het werken in meerdere beschikbaarheidszones volgens het volgende schema: we kondigen het adres aan in elke zone, het verkeer komt in de dichtstbijzijnde zone terecht en gaat daarbuiten niet meer. Verder in deze post zullen we dieper ingaan op wat er met het verkeer gebeurt.
Config plane
Een sleutelcomponent van het config plane is de API, waarmee de belangrijkste bewerkingen op de load balancers worden uitgevoerd: het creëren, verwijderen, wijzigen van de samenstelling van instanties, het verkrijgen van resultaten van healthchecks, enzovoort. Aan de ene kant is dit een REST API, aan de andere kant gebruiken we in de Cloud heel vaak het gRPC-framework, daarom 'vertalen' we REST naar gRPC en gebruiken we vervolgens alleen gRPC. Elke aanvraag leidt tot het creëren van een reeks asynchrone idempotente taken die worden uitgevoerd op een gedeelde pool van werkers in Yandex.Cloud. Taken worden zo geschreven dat ze op elk moment kunnen worden gepauzeerd en later opnieuw gestart. Dit zorgt voor schaalbaarheid, herhaalbaarheid en logbaarheid van operaties.
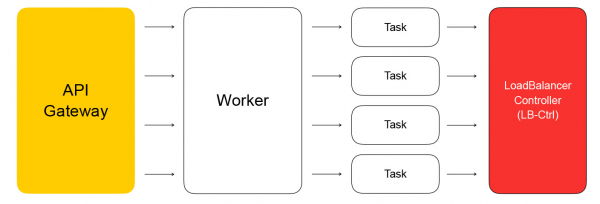
Uiteindelijk doet de taak vanuit de API een verzoek aan de servicecontroller van load balancers, die is geschreven in Go. Hiermee kan hij load balancers toevoegen en verwijderen, de samenstelling van backends en instellingen wijzigen.
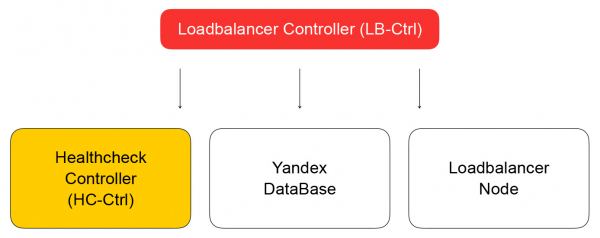
De service slaat zijn toestand op in Yandex Database — een gedistribueerde beheerde database die u binnenkort ook zult kunnen gebruiken. In Yandex.Cloud, zoals we al hebben , is het concept van dog food van toepassing: als wij zelf onze diensten gebruiken, zullen onze klanten er ook met plezier gebruik van maken. Yandex Database is een voorbeeld van de concretisering van dit concept. We slaan al onze gegevens op in YDB, en we hoeven ons geen zorgen te maken over het onderhouden en schalen van de database: deze problemen zijn al voor ons opgelost, we gebruiken de database als een service.
Laten we terugkeren naar de load balancer controller. Zijn taak is om informatie over de load balancer te behouden, de taak voor de gezondheidscontrole van de virtuele machine naar de healthcheck controller te sturen.
Healthcheck controller
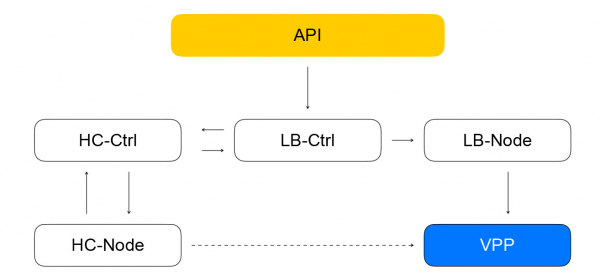
Deze ontvangt verzoeken om de controleregels te wijzigen, slaat ze op in YDB, distribueert de taken naar healthcheck nodes en aggregeert de resultaten, die vervolgens in de database worden opgeslagen en naar de loadbalancer controller worden gestuurd. Deze laatste stuurt op zijn beurt een wijzigingsverzoek voor de clusterconfiguratie naar het data plane op de loadbalancer-node, waar ik hieronder verder op in zal gaan.
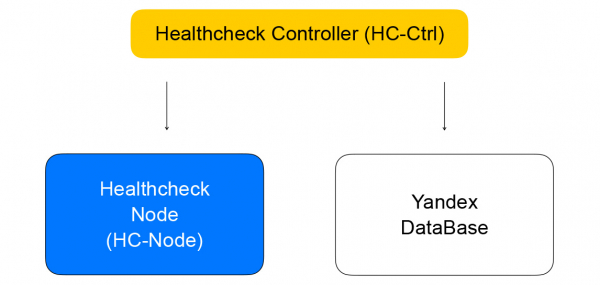
Laten we wat dieper ingaan op healthchecks. Deze kunnen in verschillende klassen worden verdeeld. De checks hebben verschillende succescriteria. TCP-checks moeten binnen een bepaalde tijd een verbinding tot stand brengen. HTTP-checks vereisen zowel een succesvolle verbinding als een antwoord met statuscode 200.
Ook verschillen de checks naar actieklasse - ze kunnen actief of passief zijn. Passieve checks houden simpelweg in de gaten wat er met het verkeer gebeurt, zonder speciale acties te ondernemen. Dit werkt niet goed op L4, omdat het afhankelijk is van de logica van hogere protocollen: op L4 is er geen informatie over hoe lang een operatie duurde en of de verbinding succesvol of ongunstig beëindigd werd. Actieve checks vereisen dat de load balancer verzoeken naar elke serverinstance stuurt.
De meeste load balancers voeren zelf de 'levendigheid' checks uit. Wij in de cloud hebben besloten om deze delen van het systeem te splitsen ter verhoging van de schaalbaarheid. Deze aanpak stelt ons in staat om het aantal load balancers te vergroten, terwijl we het aantal healthcheck-verzoeken naar de service behouden. De checks worden uitgevoerd door afzonderlijke healthcheck nodes, waarop de doelwitten voor checks zijn geschard en gerepliceerd. Het is niet mogelijk om checks vanaf één host uit te voeren, aangezien deze kan falen. Dan krijgen we de status van de door deze gecontroleerde instances niet. We voeren checks van elke instance uit op minimaal drie healthcheck nodes. We scharden de doelwitten van de checks tussen de nodes met behulp van consistente hashing-algoritmen.
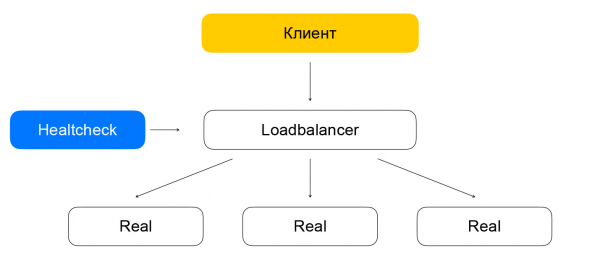
Het scheiden van de load balancing en healthcheck kan problemen veroorzaken. Als de healthcheck node verzoeken naar de instantie verstuurt, terwijl de load balancer (die op dat moment geen verkeer afhandelt) hierover heen gaat, ontstaat er een vreemde situatie: de bron lijkt actief, maar het verkeer komt er niet. We lossen dit probleem op door gezondheidscontroleverkeer gegarandeerd via load balancers te laten lopen. Met andere woorden, het schema voor het verplaatsen van pakketten met klantverkeer en healthchecks verschilt minimaal: in beide gevallen komen de pakketten bij de load balancers aan, die ze naar de doelbronnen zullen afleveren.
Het verschil is dat klanten verzoeken naar de VIP indienen, terwijl healthchecks zich tot elke afzonderlijke RIP richten. Hier doet zich een interessant probleem voor: we bieden onze gebruikers de mogelijkheid om bronnen te creëren in grijze IP-netwerken. Stel je voor dat er twee verschillende cloud-eigenaren zijn die hun diensten achter load balancers hebben verborgen. Elk van hen heeft bronnen in het subnet 10.0.0.1/24, met dezelfde adressen. Er moet op de een of andere manier onderscheid gemaakt worden, en daarvoor moeten we dieper ingaan op de opzet van het virtuele netwerk van Yandex.Cloud. Meer details zijn te vinden in , het is nu belangrijk dat het netwerk gelaagd is en tunnels bevat die te onderscheiden zijn op basis van het subnet-id.
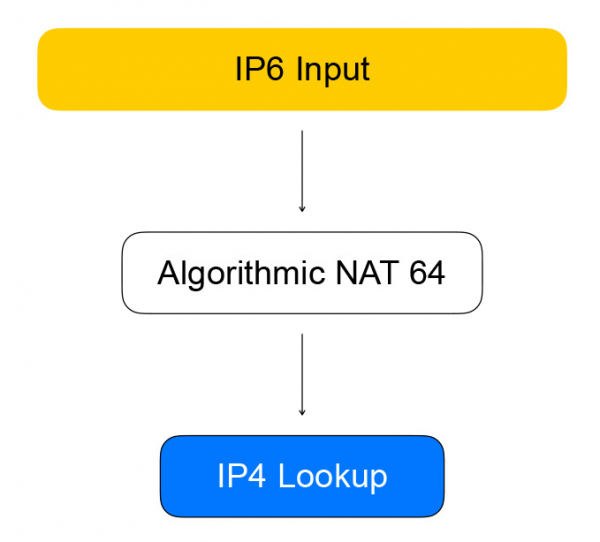
Healthcheck nodes maken gebruik van zogenaamde quasi-IPv6-adressen om de load balancers te benaderen. Een quasi-adres is een IPv6-adres dat een IPv4-adres en het gebruiker subnet-id omvat. Het verkeer komt bij de load balancer aan, deze haalt het IPv4-adres van de bron eruit, vervangt IPv6 door IPv4 en stuurt het pakket naar het netwerk van de gebruiker.
Het terugkerende verkeer verloopt op dezelfde manier: de load balancer ziet dat de bestemming een grijs netwerk van healthcheckers is, en converteert IPv4 naar IPv6.
VPP is het hart van het data plane
De load balancer is geïmplementeerd met Vector Packet Processing (VPP) - een framework van Cisco voor het verwerken van netwerkverkeer. In ons geval werkt het framework bovenop de user-space bibliotheek voor het beheren van netwerkinrichtingen - Data Plane Development Kit (DPDK). Dit garandeert een hoge prestatie bij het verwerken van pakketten: er zijn veel minder onderbrekingen in de kernel en er zijn geen contextwisselingen tussen kernel space en user space.
VPP gaat nog een stap verder en haalt nog meer prestaties uit het systeem door pakketten te groeperen in batches. De prestatieverbetering gebeurt door agressief gebruik van de caches van moderne processoren. Zowel gegevenscaches (waarbij pakketten worden verwerkt met "vectoren", waarbij de gegevens dicht bij elkaar liggen) als instructiecaches worden gebruikt: in VPP volgt de verwerking van pakketten een grafiek, waarin de knooppunten functies bevatten die één taak uitvoeren.
Bijvoorbeeld, de verwerking van IP-pakketten in VPP verloopt in de volgende volgorde: eerst vindt in de parsingsnode de parsing van de pakketheaders plaats, waarna ze worden verzonden naar de node die de pakketten verder doorstuurt volgens de routeringstabellen.
Een beetje hardcode. De auteurs van VPP maken geen compromissen in het gebruik van de processor caches, dus de typische code voor het verwerken van vectorpakketten bevat handmatige vectorisatie: er is een verwerkingslus waarin een situatie wordt behandeld zoals "we hebben vier pakketten in de wachtrij", daarna hetzelfde voor twee, en vervolgens voor één. Er worden vaak prefetch-instructies gebruikt, die gegevens in de caches laden om de toegang tijdens de volgende iteraties te versnellen.
n_left_from = frame->n_vectors;
while (n_left_from > 0)
{
    vlib_get_next_frame (vm, node, next_index, to_next, n_left_to_next);
    // ...
    while (n_left_from >= 4 && n_left_to_next >= 2)
    {
        // meerdere pakketten tegelijk verwerken
        u32 next0 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        u32 next1 = SAMPLE_NEXT_INTERFACE_OUTPUT;
        // ...
        /* Prefetch volgende iteratie. */
        {
            vlib_buffer_t *p2, *p3;

            p2 = vlib_get_buffer (vm, from[2]);
            p3 = vlib_get_buffer (vm, from[3]);

            vlib_prefetch_buffer_header (p2, LOAD);
            vlib_prefetch_buffer_header (p3, LOAD);

            CLIB_PREFETCH (p2->data, CLIB_CACHE_LINE_BYTES, STORE);
            CLIB_PREFETCH (p3->data, CLIB_CACHE_LINE_BYTES, STORE);
        }
        // verwerk daadwerkelijk de gegevens
        /* verifieer speculatieve enqueue, misschien schakel de huidige volgende frame om */
        vlib_validate_buffer_enqueue_x2 (vm, node, next_index,
                to_next, n_left_to_next,
                bi0, bi1, next0, next1);
    }

    while (n_left_from > 0 && n_left_to_next > 0)
    {
        // verwerk pakketten één voor één
    }

    // verwerkte batch
    vlib_put_next_frame (vm, node, next_index, n_left_to_next);
}
Dus, Healthchecks doen een IPv6-aanroep naar VPP, dat ze omzet naar IPv4. Dit wordt verzorgd door de graf-node die we het algorithmische NAT noemen. Voor het terugverkeer (en de omzetting van IPv6 naar IPv4) is er dezelfde algorithmische NAT-node.
Direct verkeer van clients naar de load balancer gaat via de graf-nodes, die de eigenlijke balans uitvoeren.
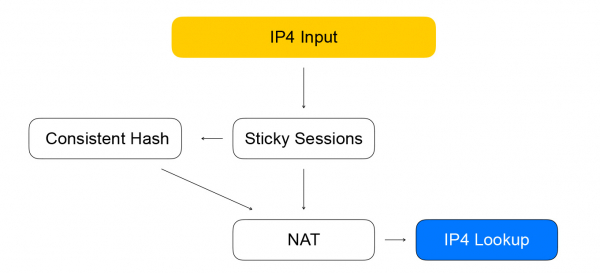
De eerste node — sticky sessions. Hier wordt de hash van voor ingestelde sessies. Een 5-tuple bevat het adres en de poort van de cliënt van waaruit informatie wordt verzonden, het adres en de poorten van bronnen die beschikbaar zijn voor het ontvangen van verkeer, evenals het netwerprotocol.
De hash van het 5-tuple helpt ons om minder berekeningen uit te voeren in de volgende consistent hashing-knoop, en maakt het ook beter mogelijk om de wijziging van de lijst met bronnen achter de load balancer te verwerken. Wanneer er een pakket bij de load balancer komt waarvoor geen sessie bestaat, wordt het naar de knoop voor consistente hashing gestuurd. Daar vindt de balans plaats met behulp van consistente hashing: we kiezen een bron uit de lijst van beschikbare 'levende' bronnen. Vervolgens worden de pakketten naar de NAT-knoop gestuurd, die de feitelijke vervangingen van de bestemmingsadressen en de herberekening van de checksums uitvoert. Zoals je kunt zien, volgen we de VPP-regels - soort gelijk aan soort, en groeperen vergelijkbare berekeningen om de efficiëntie van de CPU-caches te verhogen.
Consistente hashing
Waarom hebben we precies hiervoor gekozen en wat is het eigenlijk? Laten we eerst de vorige taak bekijken - het kiezen van een bron uit de lijst.
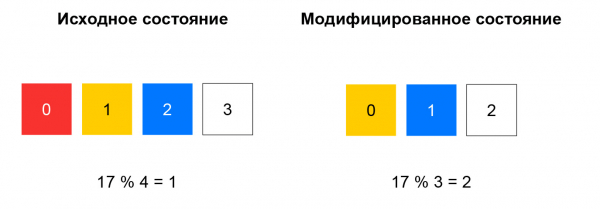
Bij inconsistente hashing wordt de hash van het inkomende pakket berekend, en de bron wordt gekozen uit de lijst op basis van de restwaarde van deze hash gedeeld door het aantal bronnen. Zolang de lijst ongelijk blijft, werkt deze methode goed: we sturen altijd pakketten met hetzelfde 5-tuple naar dezelfde instantie. Als bijvoorbeeld een bepaalde bron stopt met reageren op healthchecks, zal de keuze voor een aanzienlijk deel van de hashes veranderen. De TCP-verbindingen van de cliënt zullen worden verbroken: een pakket dat eerder naar instantie A ging, kan nu naar instantie B gaan, die onbekend is met de sessie voor dit pakket.
Consistente hashing lost het beschreven probleem op. Het eenvoudigste is om dit concept als volgt uit te leggen: stel je voor dat je een ring hebt waarop je bronnen verdeelt op basis van de hash (bijvoorbeeld op IP:port). Het kiezen van een bron is als het draaien van het wiel onder een hoek die wordt bepaald door de hash van het pakket.
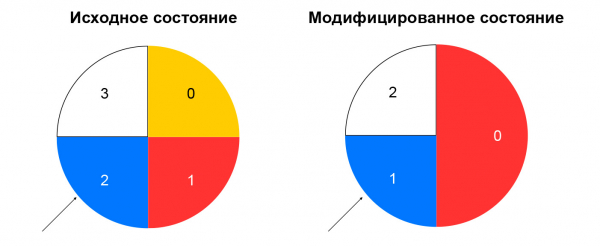
Hierdoor wordt de herverdeling van verkeer bij wijziging van de bronnen geminimaliseerd. Het verwijderen van een bron heeft alleen invloed op dat deel van de consistente hashing-ring waar deze bron zich bevond. Het toevoegen van een bron verandert ook de verdeling, maar we hebben een knoop voor sticky sessions, die het mogelijk maakt om reeds ingestelde sessies niet over te schakelen naar nieuwe bronnen.
We have examined what happens with direct traffic between the load balancer and resources. Now let's discuss reverse traffic. It follows the same pattern as the health check traffic—through algorithmic NAT, meaning through reverse NAT 44 for client traffic and through NAT 46 for health check traffic. We adhere to our own scheme: we unify health check traffic and the actual traffic of users.
Loadbalancer-node and components in the assembly
The composition of load balancers and resources in VPP is reported by the local service—loadbalancer-node. It subscribes to the event stream from the loadbalancer-controller, is capable of constructing the difference between the current state of VPP and the target state obtained from the controller. We obtain a closed system: events from the API come to the load balancer controller, which sets tasks for the health check controller to check the 'liveness' of resources. The latter, in turn, sets tasks in healthcheck-node and aggregates the results, after which it returns them back to the load balancer controller. Loadbalancer-node subscribes to events from the controller and changes the state of VPP. In such a system, each service knows only what is necessary about neighboring services. The number of connections is limited, and we have the opportunity to independently operate and scale various segments.
Questions we managed to avoid
All our services in the control plane are written in Go and exhibit good characteristics in terms of scalability and reliability. There are many open-source libraries in Go for building distributed systems. We actively use GRPC; all components contain an open-source implementation of service discovery—our services monitor each other's functionality, can dynamically change their composition, and we have integrated this with GRPC balancing. We also use an open-source solution for metrics. In the data plane, we achieved respectable performance and a large resource margin: it proved to be quite difficult to assemble a stand where one could rely on the performance of VPP, rather than on the hardware network card.
Problems and solutions
Wat werkte niet zo goed? In Go is het geheugenbeheer automatisch, maar er kunnen toch geheugenlekken optreden. De eenvoudigste manier om hiermee om te gaan, is door goroutines te starten en deze niet te vergeten af te sluiten. Conclusie: let op het geheugengebruik van Go-programma's. Een goed indicator kan het aantal goroutines zijn. Een pluspunt is dat je in Go eenvoudig gegevens kunt verkrijgen over runtime — over geheugengebruik, het aantal actieve goroutines en veel andere parameters.
Bovendien is Go misschien niet de beste keuze voor functionele tests. Ze zijn behoorlijk omslachtig en de standaardbenadering "alles in CI batchgewijs uitvoeren" past niet goed bij hen. Functionele tests zijn namelijk veeleisender qua middelen en kunnen echte time-outs ondervinden. Hierdoor kunnen tests mislukken omdat de CPU bezig is met unit tests. Conclusie: voer zware tests indien mogelijk apart uit van unit tests.
Een microservices event-driven architectuur is complexer dan een monoliet: logboeken doorzoeken op tientallen verschillende machines is niet erg handig. Conclusie: als je microservices maakt, denk dan meteen aan tracing.
Onze plannen
We zullen een interne load balancer lanceren, een IPv6 load balancer toevoegen, ondersteuning voor Kubernetes-scripts implementeren, onze diensten verder sharden (momenteel zijn alleen healthcheck-node en healthcheck-ctrl ge shard), nieuwe healthchecks toevoegen en slimme aggregatie van controles realiseren. We overwegen om onze diensten nog onafhankelijker te maken, zodat ze niet rechtstreeks met elkaar communiceren, maar via een berichtenqueuing. Onlangs is er een SQS-compatibele service in de Cloud gekomen. .
Onlangs vond de openbare release van Yandex Load Balancer plaats. Ontdek het beheer je load balancers op een voor jou handige manier en verhoog de fouttolerantie van je projecten!
Bron: habr.com
