

Voorwoord of hoe het idee van partitionering is ontstaan
Het begin van het verhaal hier: Nadat bijna alle bronnen voor het optimaliseren van de aanvraag op dat moment uitgeput waren, werd de vraag gesteld — wat nu? En zo ontstond het idee van partitionering.
Lyrische omleiding:
Juist 'op dat moment', omdat . Dank je en Habr!
Dus, hoe kunnen we de klant nog gelukkiger maken en tegelijk onze vaardigheden verbeteren?
Als we alles tot het uiterste vereenvoudigen, zijn er eigenlijk maar twee radicale manieren om de prestaties van de database te verbeteren:
1) Extensiepad — we verhogen de middelen, veranderen de configuratie;
2) Intensief pad — optimalisatie van aanvragen
Aangezien, herhaal ik, op dat moment al niet duidelijk was wat er nog meer veranderd kon worden in de aanvraag voor versnelling, werd de keuze gemaakt voor het pad — wijzigingen aan het ontwerp van tabellen.
Dus — de belangrijkste vraag ontstaat — wat en hoe gaan we veranderen?
Beginvoorwaarden
Ten eerste, hier is een ERD (in vereenvoudigde vorm weergegeven):
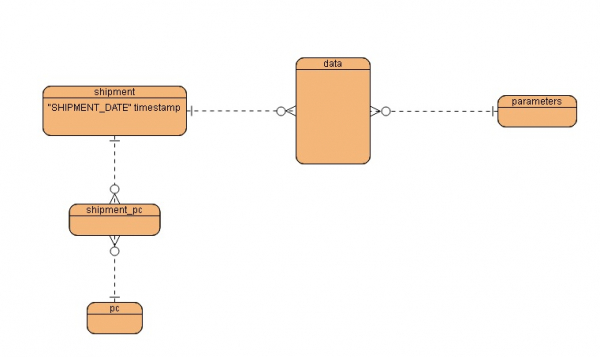
Belangrijkste kenmerken:
- relaties 'veel-op-veel'
- de tabel heeft al een potentiële sleutel voor partitionering
Oorspronkelijke aanvraag:
SELECT
            p."PARAMETER_ID" as  parameter_id,
            pc."PC_NAME" AS pc_name,
            pc."CUSTOMER_PARTNUMBER" AS customer_partnumber,
            w."LASERMARK" AS lasermark,
            w."LOTID" AS lotid,
            w."REPORTED_VALUE" AS reported_value,
            w."LOWER_SPEC_LIMIT" AS lower_spec_limit,
            w."UPPER_SPEC_LIMIT" AS upper_spec_limit,
            p."TYPE_CALCUL" AS type_calcul,
            s."SHIPMENT_NAME" AS shipment_name,
            s."SHIPMENT_DATE" AS shipment_date,
            extract(year from s."SHIPMENT_DATE") AS year,
            extract(month from s."SHIPMENT_DATE") as month,
            s."REPORT_NAME" AS report_name,
            p."SPARAM_NAME" AS SPARAM_name,
            p."CUSTOMERPARAM_NAME" AS customerparam_name
        FROM data w INNER JOIN shipment s ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
             INNER JOIN parameters p ON p."PARAMETER_ID" = w."PARAMETER_ID"
             INNER JOIN shipment_pc sp ON s."SHIPMENT_ID" = sp."SHIPMENT_ID"
             INNER JOIN pc pc ON pc."PC_ID" = sp."PC_ID"
             INNER JOIN ( SELECT w2."LASERMARK" , MAX(s2."SHIPMENT_DATE") AS "SHIPMENT_DATE"
                          FROM shipment s2 INNER JOIN data w2 ON s2."SHIPMENT_ID" = w2."SHIPMENT_ID"
                          GROUP BY w2."LASERMARK"
                         ) md ON md."SHIPMENT_DATE" = s."SHIPMENT_DATE" AND md."LASERMARK" = w."LASERMARK"
        WHERE
             s."SHIPMENT_DATE" >= '2018-07-01' AND s."SHIPMENT_DATE" <= '2018-09-30' ;
Resultaten van de uitvoering op de testdatabase:
Kosten : 502 997.55
Uitvoertijd: 505 seconden.
Wat zien we? Een normale aanvraag, per tijdsinterval.
We make a simple logical assumption: if there is a sample of a time slice, will it help us? Correct — partitioning.
What to partition?
At first glance, the choice seems obvious — declarative partitioning of the 'shipment' table by the 'SHIPMENT_DATE' key (putting it mildly — in the end it turned out a bit differently in production).
How to partition?
This question isn't too complicated either. Fortunately, in PostgreSQL 10, there is now a human-readable partitioning mechanism.
Dus:
- We save a dump of the original table — pg_dump source_table
- We delete the original table — drop table source_table
- We create a parent table with range partitioning — create table source_table
- We create partitions — create table source_table, create index
- We import the dump created in step 1 — pg_restore
Scripts for partitioning
For simplicity and convenience, steps 2, 3, and 4 have been combined into a single script.
Dus:
We save a dump of the original table
pg_dump postgres --file=\/dump\/shipment.dmp --format=c --table=shipment --verbose > \/dump\/shipment.log 2>&1We delete the original table + create a parent table with range partitioning + create partitions
--create_partition_shipment.sql
do language plpgsql $$
declare
rec_shipment_date RECORD ;
partition_name varchar;
index_name varchar;
current_year varchar ;
current_month varchar ;
begin_year varchar ;
begin_month varchar ;
next_year varchar ;
next_month varchar ;
first_flag boolean ;
i integer ;
begin
  RAISE NOTICE 'CREËER TÉMPORÆRE TABEL VOOR SHIPMENT_DATE';
  CREATE TEMP TABLE tmp_shipment_date as select distinct "SHIPMENT_DATE" from shipment order by "SHIPMENT_DATE" ;

  RAISE NOTICE 'VERWIJDER TABEL shipment';
  drop table shipment cascade ;

  CREATE TABLE public.shipment
  (
    "SHIPMENT_ID" integer NOT NULL DEFAULT nextval('shipment_shipment_id_seq'::regclass),
    "SHIPMENT_NAME" character varying(30) COLLATE pg_catalog."default",
    "SHIPMENT_DATE" timestamp without time zone,
    "REPORT_NAME" character varying(40) COLLATE pg_catalog."default"
  )
  PARTITION BY RANGE ("SHIPMENT_DATE")
  WITH (
      OIDS = FALSE
  )
  TABLESPACE pg_default;

  RAISE NOTICE 'CREËER PARTITIES VOOR TABEL shipment';

  current_year:='0';
  current_month:='0';

  begin_year := '0' ;
  begin_month := '0'  ;
  next_year := '0' ;
  next_month := '0'  ;

  FOR rec_shipment_date IN SELECT * FROM tmp_shipment_date LOOP

      RAISE NOTICE 'SHIPMENT_DATE=%',rec_shipment_date."SHIPMENT_DATE";

      current_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE");
      current_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE") ;

      IF to_number(current_month,'99') = to_date( begin_year||'.'||begin_month, 'YYYY.MM') AND
         to_date( current_year||'.'||current_month, 'YYYY.MM') < to_date( next_year||'.'||next_month, 'YYYY.MM') AND
         NOT first_flag
      THEN
         CONTINUE ;
      ELSE
       --NIEUWE grenzen alleen voor tweede en volgende keren
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;

      END IF;

      partition_name := 'shipment_shipment_date_'||begin_year||'-'||begin_month||'-01-'|| next_year||'-'||next_month||'-01'  ;

     EXECUTE format('CREËER TABEL ' || quote_ident(partition_name) || ' PARTITION OF shipment FOR VALUES FROM ( %L ) TO ( %L )  ' , current_year||'-'||current_month||'-01' , next_year||'-'||next_month||'-01'  ) ;

      index_name := partition_name||'_shipment_id_idx';
      RAISE NOTICE 'INDEX NAAM =%',index_name;
      EXECUTE format('CREËER INDEX ' || quote_ident(index_name) || ' ON '|| quote_ident(partition_name) ||' USING btree ("SHIPMENT_ID") TABLESPACE pg_default ' ) ;

      --Verwijder vlag voor eerste keer
      first_flag := false ;

  END LOOP;

end
$$;
Importeer dump
pg_restore -d postgres --data-only --format=c --table=shipment --verbose shipment.dmp > /tmp/data_dump/shipment_restore.log 2>&1Controleer de resultaten van partitie
Wat hebben we uiteindelijk? De volledige uitvoeringsplan is groot en saai, dus we kunnen ons beperken tot de eindcijfers.
Was
Kosten: 502 997.55
Uitvoeringstijd: 505 seconden.
Is
Kosten: 77 872.36
Uitvoeringstijd: 79 seconden.
Een heel goed resultaat. We hebben zowel de kosten als de uitvoeringstijd verlaagd. Het gebruik van partitionering geeft dus het verwachte effect en over het geheel genomen — zonder verrassingen.
De klant tevreden stellen
De testresultaten werden aan de klant gepresenteerd ter overweging. En na kennisneming werd een behoorlijk onverwacht oordeel gegeven: 'Uitstekend, partitioneer de tabel "data"'.
Ja, maar we hebben een totaal andere tabel "shipment" onderzocht, de tabel "data" heeft geen veld "SHIPMENT_DATE".
Geen probleem, voeg toe, wijzig. Het belangrijkste is dat de klant tevreden is met wat er uit voortkomt; de details van de uitvoering zijn niet zo belangrijk.
We partitioneren de hoofdtafel "data"
Er zijn in feite geen bijzondere complicaties ontstaan. Hoewel het algoritme voor partitionering natuurlijk enigszins is veranderd.
Voeg de kolom "SHIPMENT_DATA" toe aan de tabel "data"
psql -h host -U database -d gebruiker
=> ALTER TABLE data ADD COLUMN "SHIPMENT_DATE" timestamp without time zone ;
Vul de waarden van de kolom "SHIPMENT_DATA" in de tabel "data" met de overeenkomende waarden uit de tafel "shipment"
-----------------------------
--update_data.sql
--bijwerken voor de gewijzigde tabel "data" met waarden van "shipment_data" uit de tabel "shipment"
--versie 1.0
do language plpgsql $$
declare
rec_shipment_data RECORD ;
shipment_date timestamp without time zone ;
row_count integer ;
total_rows integer ;
begin

  select count(*) into total_rows from shipment ;
  RAISE NOTICE 'Totaal %',total_rows;
  row_count:= 0 ;

  FOR rec_shipment_data IN SELECT * FROM shipment LOOP

   update data set "SHIPMENT_DATE" = rec_shipment_data."SHIPMENT_DATE" where "SHIPMENT_ID" = rec_shipment_data."SHIPMENT_ID";

   row_count:=  row_count +1 ;
   RAISE NOTICE 'aantal rijen = % , van %',row_count,total_rows;
  END LOOP;

end
$$;
Bewaar de dump van de tabel "data"
pg_dump postgres --file=\/dump\/data.dmp --format=c --table=data --verbose > \/dump\/data.log 2>&1<\/sourceHercreëer de gepartitioneerde tabel "data"
--create_partition_data.sql
--maak partities voor de tabel "wafer data" op basis van de kolom "shipment_data" met een looptijd van één maand
--versie 1.0
do language plpgsql $$
declare
rec_shipment_date RECORD ;
partition_name varchar;
index_name varchar;
current_year varchar ;
current_month varchar ;
begin_year varchar ;
begin_month varchar ;
next_year varchar ;
next_month varchar ;
first_flag boolean ;
i integer ;

begin

  RAISE NOTICE 'CREËER TICKETTABEL VOOR SHIPMENT_DATE';
  CREATE TEMP TABLE tmp_shipment_date as select distinct "SHIPMENT_DATE" from shipment order by "SHIPMENT_DATE" ;


  RAISE NOTICE 'VERWIJDER TABEL data';
  drop table data cascade ;


  RAISE NOTICE 'CREËER GEDEELDE TABEL data';

  CREATE TABLE public.data
  (
    "RUN_ID" integer,
    "LASERMARK" character varying(20) COLLATE pg_catalog."default" NOT NULL,
    "LOTID" character varying(80) COLLATE pg_catalog."default",
    "SHIPMENT_ID" integer NOT NULL,
    "PARAMETER_ID" integer NOT NULL,
    "INTERNAL_VALUE" character varying(75) COLLATE pg_catalog."default",
    "REPORTED_VALUE" character varying(75) COLLATE pg_catalog."default",
    "LOWER_SPEC_LIMIT" numeric,
    "UPPER_SPEC_LIMIT" numeric ,
    "SHIPMENT_DATE" timestamp without time zone
  )
  PARTITION BY RANGE ("SHIPMENT_DATE")
  WITH (
    OIDS = FALSE
  )
  TABLESPACE pg_default ;


  RAISE NOTICE 'CREËER PARTITIES VOOR DE TABEL data';

  current_year:='0';
  current_month:='0';

  begin_year := '0' ;
  begin_month := '0'  ;
  next_year := '0' ;
  next_month := '0'  ;
  i := 1;

  FOR rec_shipment_date IN SELECT * FROM tmp_shipment_date LOOP

      RAISE NOTICE 'SHIPMENT_DATE=%',rec_shipment_date."SHIPMENT_DATE";

      current_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE");
      current_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE") ;

      --Init grenzen
      IF   begin_year = '0' THEN
       RAISE NOTICE '***Init grenzen';
       first_flag := true ; --eerste keer vlag
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;

      END IF;

--      RAISE NOTICE 'current_year=% , current_month=% ',current_year,current_month;
--      RAISE NOTICE 'begin_year=% , begin_month=% ',begin_year,begin_month;
--      RAISE NOTICE 'next_year=% , next_month=% ',next_year,next_month;

      -- Controleer de huidige datum binnen de grenzen NIET voor de eerste keer

      RAISE NOTICE 'Huidige data = %',to_char( to_date( current_year||'.'||current_month, 'YYYY.MM'), 'YYYY.MM');
      RAISE NOTICE 'Begin data = %',to_char( to_date( begin_year||'.'||begin_month, 'YYYY.MM'), 'YYYY.MM');
      RAISE NOTICE 'Volgende data = %',to_char( to_date( next_year||'.'||next_month, 'YYYY.MM'), 'YYYY.MM');

      IF to_date( current_year||'.'||current_month, 'YYYY.MM') >= to_date( begin_year||'.'||begin_month, 'YYYY.MM') AND
         to_date( current_year||'.'||current_month, 'YYYY.MM') < to_date( next_year||'.'||next_month, 'YYYY.MM') AND
         NOT first_flag
      THEN
         RAISE NOTICE '***GA DOOR';
         CONTINUE ;
      ELSE
       --NIEUWE grenzen alleen voor de tweede en daaropvolgende keren
       RAISE NOTICE '***NIEUWE GRENZEN';
       begin_year := current_year ;
       begin_month := current_month ;

        IF current_month = '12' THEN
          next_year := date_part('year' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 year') ;
        ELSE
          next_year := current_year ;
        END IF;

       next_month := date_part('month' ,rec_shipment_date."SHIPMENT_DATE" + interval '1 month') ;


      END IF;

      IF to_number(current_month,'99') < 10 THEN
        current_month := '0'||current_month ;
      END IF ;

      IF to_number(begin_month,'99') < 10 THEN
        begin_month := '0'||begin_month ;
      END IF ;

      IF to_number(next_month,'99') < 10 THEN
        next_month := '0'||next_month ;
      END IF ;

      RAISE NOTICE 'current_year=% , current_month=% ',current_year,current_month;
      RAISE NOTICE 'begin_year=% , begin_month=% ',begin_year,begin_month;
      RAISE NOTICE 'next_year=% , next_month=% ',next_year,next_month;

      partition_name := 'data_'||begin_year||begin_month||'01_'||next_year||next_month||'01'  ;

      RAISE NOTICE 'PARTITIE NUMMER % , TAFELNAAM =%',i , partition_name;

      EXECUTE format('CREËER TABEL ' || quote_ident(partition_name) || ' PARTITION VAN data VOOR WAARDEN VAN ( %L ) TOT ( %L )  ' , begin_year||'-'||begin_month||'-01' , next_year||'-'||next_month||'-01'  ) ;

      index_name := partition_name||'_shipment_id_parameter_id_idx';
      RAISE NOTICE 'INDEX NAAM =%',index_name;
      EXECUTE format('CREËER INDEX ' || quote_ident(index_name) || ' OP '|| quote_ident(partition_name) ||' MET b-tree ("SHIPMENT_ID", "PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_lasermark_idx';
      RAISE NOTICE 'INDEX NAAM =%',index_name;
      EXECUTE format('CREËER INDEX ' || quote_ident(index_name) || ' OP '|| quote_ident(partition_name) ||' MET b-tree ("LASERMARK" COLLATE pg_catalog."default") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_id_idx';
      RAISE NOTICE 'INDEX NAAM =%',index_name;
      EXECUTE format('CREËER INDEX ' || quote_ident(index_name) || ' OP '|| quote_ident(partition_name) ||' MET b-tree ("SHIPMENT_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_parameter_id_idx';
      RAISE NOTICE 'INDEX NAAM =%',index_name;
      EXECUTE format('CREËER INDEX ' || quote_ident(index_name) || ' OP '|| quote_ident(partition_name) ||' MET b-tree ("PARAMETER_ID") TABLESPACE pg_default ' ) ;

      index_name := partition_name||'_shipment_date_idx';
      RAISE NOTICE 'INDEX NAAM =%',index_name;
      EXECUTE format('CREËER INDEX ' || quote_ident(index_name) || ' OP '|| quote_ident(partition_name) ||' MET b-tree ("SHIPMENT_DATE") TABLESPACE pg_default ' ) ;

      --Verwijder eerste keer vlag
      first_flag := false ;

  END LOOP;
end
$$;
We laden de dump die in stap 3 is gemaakt.
pg_restore -h host -user -d database --data-only --format=c --table=data --verbose data.dmp > data_restore.log 2>&1We creëren een aparte sectie voor oude gegevens
---------------------------------------------------
--create_partition_for_old_dates.sql
--maak partities om oude data te behouden
--versie 1.0
do language plpgsql $$
declare
rec_shipment_date RECORD;
partition_name varchar;
index_name varchar;

begin

      SELECT min("SHIPMENT_DATE") AS min_date INTO rec_shipment_date from data;

      RAISE NOTICE 'Oude datum is %', rec_shipment_date.min_date;

      partition_name := 'data_old_dates';

      RAISE NOTICE 'PARTITIE NAAM IS %', partition_name;

      EXECUTE format('CREATE TABLE ' || quote_ident(partition_name) || ' PARTITION OF data FOR VALUES FROM ( %L ) TO ( %L )', '1900-01-01',
              to_char(rec_shipment_date.min_date, 'YYYY') || '-' || to_char(rec_shipment_date.min_date, 'MM') || '-01');

      index_name := partition_name||'_shipment_id_parameter_id_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("SHIPMENT_ID", "PARAMETER_ID") TABLESPACE pg_default');

      index_name := partition_name||'_lasermark_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("LASERMARK" COLLATE pg_catalog."default") TABLESPACE pg_default');

      index_name := partition_name||'_shipment_id_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("SHIPMENT_ID") TABLESPACE pg_default');

      index_name := partition_name||'_parameter_id_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("PARAMETER_ID") TABLESPACE pg_default');

      index_name := partition_name||'_shipment_date_idx';
      EXECUTE format('CREATE INDEX ' || quote_ident(index_name) || ' ON ' || quote_ident(partition_name) || ' USING btree ("SHIPMENT_DATE") TABLESPACE pg_default');

end
$$;
Eindresultaten:
Was
Kosten: 502 997.55
Uitvoertijd: 505 seconden.
Is
Kosten: 68 533.70
Uitvoeringstijd: 69 seconden
Verdiend, heel verdienstelijk. En gezien het feit dat we enigszins de mechanica van partitionering in PostgreSQL 10 onder de knie hebben weten te krijgen - Geweldig resultaat.
Lyrische uitweiding
Is het mogelijk om het nog beter te doen - JA, DAT KAN!Hiervoor moet je MATERIALIZED VIEW gebruiken.
CREATE MATERIALIZED VIEW LASERMARK_VIEW
CREATE MATERIALIZED VIEW LASERMARK_VIEW
AS
SELECT w."LASERMARK", MAX(s."SHIPMENT_DATE") AS "SHIPMENT_DATE"
FROM shipment s INNER JOIN data w ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
GROUP BY w."LASERMARK";

CREATE INDEX lasermark_vw_shipment_date_ind on lasermark_view USING btree ("SHIPMENT_DATE") TABLESPACE pg_default;
analyze lasermark_view;
We herschrijven de query opnieuw:
Query met behulp van materialized view
SELECT
            p."PARAMETER_ID" as  parameter_id,
            pc."PC_NAME" AS pc_name,
            pc."CUSTOMER_PARTNUMBER" AS customer_partnumber,
            w."LASERMARK" AS lasermark,
            w."LOTID" AS lotid,
            w."REPORTED_VALUE" AS reported_value,
            w."LOWER_SPEC_LIMIT" AS lower_spec_limit,
            w."UPPER_SPEC_LIMIT" AS upper_spec_limit,
            p."TYPE_CALCUL" AS type_calcul,
            s."SHIPMENT_NAME" AS shipment_name,
            s."SHIPMENT_DATE" AS shipment_date,
            extract(year from s."SHIPMENT_DATE") AS year,
            extract(month from s."SHIPMENT_DATE") as month,
            s."REPORT_NAME" AS report_name,
            p."STC_NAME" AS STC_name,
            p."CUSTOMERPARAM_NAME" AS customerparam_name
        FROM data w INNER JOIN shipment s ON s."SHIPMENT_ID" = w."SHIPMENT_ID"
             INNER JOIN parameters p ON p."PARAMETER_ID" = w."PARAMETER_ID"
             INNER JOIN shipment_pc sp ON s."SHIPMENT_ID" = sp."SHIPMENT_ID"
             INNER JOIN pc pc ON pc."PC_ID" = sp."PC_ID"
             INNER JOIN LASERMARK_VIEW md ON md."SHIPMENT_DATE" = s."SHIPMENT_DATE" AND md."LASERMARK" = w."LASERMARK"
        WHERE
              s."SHIPMENT_DATE" >= '2018-07-01' AND s."SHIPMENT_DATE" <= '2018-09-30';
En we krijgen nog een resultaat:
Was
Kosten: 502 997.55
Uitvoertijd: 505 seconden
Is
Kosten: 42 481.16
Uitvoeringstijd: 43 seconden.
Hoewel dit veelbelovende resultaat misleidend is, moeten de weergaven worden ververst. Dus de uiteindelijke tijd om gegevens te verkrijgen zal niet veel helpen. Maar als experiment is het zeker interessant.
In feite, zoals het bleek, nogmaals bedankt en Habr! -
Naschrift
Dus, de klant is tevreden. En moet gebruik maken van de situatie.
Nieuwe taak: Wat moeten we bedenken om te verdiepen en uit te breiden?
En dan herinnert men zich - jongens, we hebben geen monitoring van onze PostgreSQL-databases.
Eerlijk gezegd is er wel een soort monitoring in de vorm van Cloud Watch op AWS. Maar wat heeft deze monitoring voor DBA eigenlijk voor zin? Bijna niets.
Als er een kans is om iets nuttigs en interessants voor jezelf te doen, kun je zo'n kans niet laten liggen ...
OMDAT
Zo zijn we aangekomen bij het meest interessante:
3 december 2018.
Besluit over de start van het werk voor het onderzoeken van de beschikbare mogelijkheden voor het monitoren van de prestaties van PostgreSQL-queries.
Maar dit is al een heel ander verhaal.
Vervolg volgt…
Bron: habr.com
