

Het onderwerp van failover in datasystemen is altijd relevant, aangezien in ons tijdperk van wijdverspreide virtualisatie en consolidatie van middelen, SANs het schakelstuk zijn waarvan de uitval niet alleen leidt tot een gewone storing, maar tot langdurige stilstand van services. Daarom bevatten moderne SANs een groot aantal gedupliceerde componenten (zelfs tot aan de controllers). Maar is deze bescherming voldoende?
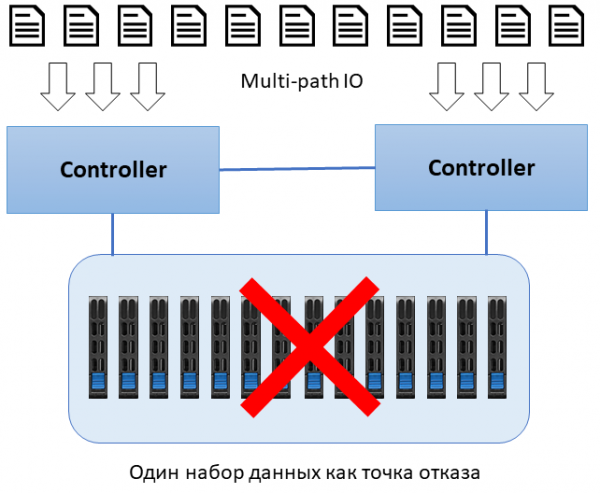
Alle leveranciers vermelden bij het opsommen van de kenmerken van SANs onvermijdelijk de hoge beschikbaarheid van hun oplossingen, waarbij ze altijd de term "geen enkele single point of failure" toevoegen. Laten we eens beter kijken naar een typisch datasysteem. Om stilstand tijdens onderhoud te voorkomen, worden in SANs voedingen, koelingsmodules, invoer-/uitvoerpoorten, opslagmedia (we bedoelen RAID) en natuurlijk controllers gedupliceerd. Als je goed naar deze architectuur kijkt, zie je minimaal twee potentiële falingspunten, die schaamteloos onder de pet worden gehouden:
- De aanwezigheid van een enkele backplane
- De aanwezigheid van één kopie van data
Een backplane is een technisch geavanceerd apparaat dat altijd subject is aan strenge tests tijdens de productie. Daarom komen er zelden gevallen voor waarin het volledig defect raakt. Maar zelfs bij gedeeltelijke storingen, zoals een defecte opslagslot, zal het moeten worden vervangen met volledige uitschakeling van de SAN.
Het maken van meerdere kopieën van gegevens lijkt op het eerste gezicht ook geen probleem te zijn. Zo is de Clone-functionaliteit in SANs, die in staat is een volledige kopie van gegevens met enige regelmaat te actualiseren, vrij wijdverbreid. Maar in het geval van problemen met de backplane zal de kopie net zo onbereikbaar zijn als het origineel.
Een voor de hand liggende oplossing om deze tekortkomingen te overwinnen is replicatie naar een andere opslagoplossing. Als we de verwachte verdubbeling van de kosten voor hardware negeren (we veronderstellen immers dat degenen die voor deze oplossing kiezen dit realistisch begrijpen en dit feit van tevoren accepteren), blijven er nog potentiële kosten over voor het opzetten van de replicatie in de vorm van licenties, extra software en hardware. En het belangrijkste is dat we op de een of andere manier de consistentie van de gerepliceerde gegevens moeten waarborgen. Dat wil zeggen, het opbouwen van een virtualisatieoplossing voor opslag / vSAN / enz., wat ook financiële en tijdsbronnen vereist.
Bij het creëren van hun High Availability-systemen was het doel om de hierboven genoemde tekortkomingen te elimineren. Zo ontstond de interpretatie van de technologie Shared Nothing, wat vrij vertaald betekent "zonder gebruik van gedeelde apparaten".
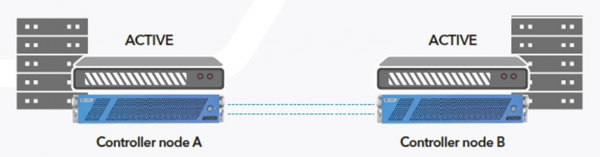
Concept De architectuur benadrukt het gebruik van twee onafhankelijke nodes (controllers), elk met zijn eigen set gegevens. Tussen de nodes vindt synchrone replicatie plaats via een InfiniBand 56G-interface die volledig transparant is voor de software die bovenop het opslagsysteem draait. Als gevolg hiervan is er geen noodzaak om virtuele opslagoplossingen, software-agenten enz. toe te passen.
Fysiek kan de tweenodige oplossing van AccelStor in twee modellen worden uitgevoerd:
- — gebaseerd op Twin-servers in een 2U-behuizing, als er een gematigde prestatie en een capaciteit tot 22TB vereist zijn;
- — gebaseerd op afzonderlijke 2U-servers, als hoge prestaties en een grotere capaciteit (tot 57TB) vereist zijn.
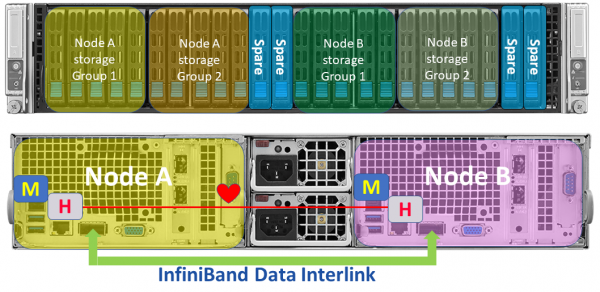
Het H510-model op basis van de Twin-server
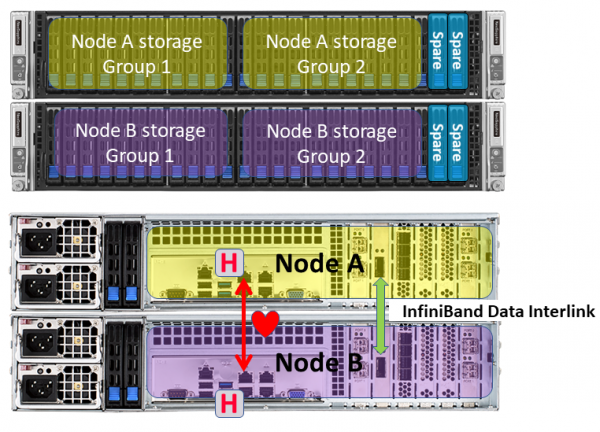
Het H710-model op basis van afzonderlijke servers
Het gebruik van verschillende formfactoren is te wijten aan de noodzaak voor een verschillend aantal SSD's om het vereiste volume en de prestaties te bereiken. Bovendien is het Twin-platform goedkoper en biedt het toegankelijkere oplossingen, hoewel met een bepaalde условной "tekortkoming" in de vorm van een enkele backplane. Verder zijn alle overige aspecten, inclusief de werkprincipes, volledig identiek voor beide modellen.
Elke node heeft een dataset met twee groepen , plus 2 hot spares. Elke groep kan de uitval van één SSD aan. Alle inkomende schrijfbewerkingen worden door de node behandeld conform de FlexiRemap reorganiseert in opeenvolgende ketens met blokken van 4KB, die vervolgens op SSD worden geschreven in de meest comfortabele modus voor hen (sequentieel schrijven). Het host-systeem ontvangt de bevestiging van de schrijfoperatie pas na de fysieke locatie van de gegevens op de SSD, dat wil zeggen zonder caching in RAM. Hierdoor wordt een indrukwekkende prestatie bereikt tot 600K IOPS bij schrijven en 1M+ IOPS bij lezen (model H710).
Zoals eerder vermeld, vindt de synchronisatie van datasets plaats in real-time via de InfiniBand 56G-interface, die een hoge bandbreedte en lage latentie biedt. Om de communicatiekanaal maximaal effectief te gebruiken bij het verzenden van kleine pakketten. Aangezien het communicatiekanaal één is, wordt een aparte 1GbE-link gebruikt voor extra pulscontrole. Via deze link wordt alleen de heartbeat verzonden, waardoor er geen specifieke eisen aan de snelheidskenmerken worden gesteld.
In het geval van een toename van de systeemcapaciteit (tot meer dan 400 TB) door middel van worden ze ook in paren aangesloten om de conceptie van 'geen enkel punt van falen' te waarborgen.
Voor extra databeveiliging (naast het feit dat AccelStor al twee kopieën heeft) wordt er een speciaal algoritme gebruikt voor het geval een SSD uitvalt. Als een SSD defect raakt, begint de node met het rebuilden van de gegevens op een van de hot spare-opslagmedia. De FlexiRemap-groep die in de degraded status verkeert, schakelt over naar de alleen-lezen modus. Dit wordt gedaan om interferentie van schrijfoperaties en rebuild naar de reserve-schijf te voorkomen, wat uiteindelijk het herstelproces versnelt en de tijd verkort waarbij het systeem potentieel kwetsbaar is. Na voltooiing van de rebuild schakelt de node terug naar de normale read-write modus.
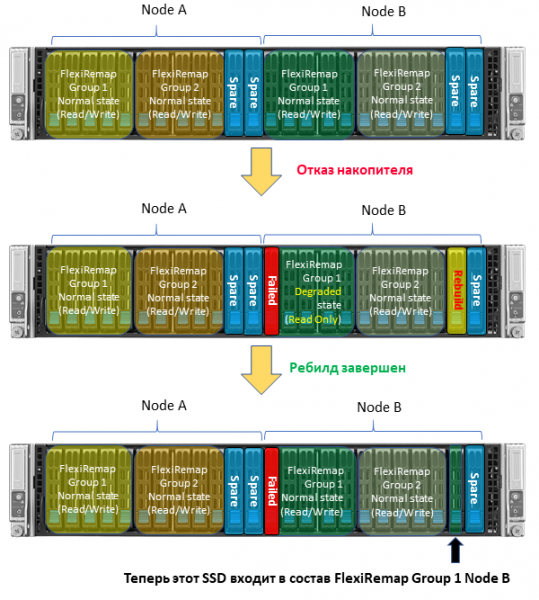
Uiteraard, net als bij andere systemen, daalt de algehele prestaties tijdens de rebuild (aangezien een van de FlexiRemap-groepen niet beschikbaar is voor schrijven). Maar het herstelproces zelf verloopt zo snel mogelijk, wat de systemen van AccelStor onderscheidt van oplossingen van andere leveranciers.
Een ander nuttig kenmerk van de Nothing Shared-technologie is de werking van de nodes in de zogenaamde true active-active modus. In tegenstelling tot de 'klassieke' architectuur, waarbij een specifieke volume/pool alleen door één controller wordt beheerd en de tweede simpelweg invoer-/uitvoertaken uitvoert, in systemen Elke node werkt met zijn eigen dataset en geeft geen verzoeken door aan de 'buur'. Dit verhoogt de algehele prestaties van het systeem door parallelle verwerking van invoer-/uitvoerverzoeken door de nodes en toegang tot de opslagmedia. Ook bestaat er eigenlijk niet zoiets als failover, omdat het simpelweg niet nodig is om het beheer van volumes over te dragen aan een andere node in geval van een storing.
Als we de Nothing Shared-technologie van de architectuur vergelijken met echte duplicatie van opslag systemen, lijkt deze op het eerste gezicht iets minder flexibel dan een volledige uitvoering van disaster recovery. Dit geldt in het bijzonder voor het opzetten van de communicatielijn tussen de opslagsystemen. In het H710-model kunnen nodes op een afstand van tot 100 meter worden geplaatst door gebruik te maken van niet echt goedkope actieve optische InfiniBand-kabels. Maar zelfs als we dit vergelijken met een gebruikelijke uitvoering van synchrone replicatie bij andere leveranciers via beschikbaar FibreChannel, zelfs op grotere afstanden, zal de oplossing van AccelStor goedkoper en eenvoudiger zijn in installatie/onderhoud, omdat er geen behoefte is om virtualisators voor opslagsystemen te installeren en/of integratie met software uit te voeren (wat niet altijd mogelijk is). Bovendien, laten we niet vergeten dat de oplossingen van AccelStor All Flash-array's zijn met een betere prestatie dan de 'klassieke' opslagsystemen met alleen SSD's.
Met de Nothing Shared-technologie van AccelStor is het mogelijk om een beschikbaarheid van het opslagsysteem van 99,9999% te bereiken tegen een redelijke prijs. Samen met de hoge betrouwbaarheid van de oplossing, mede door het gebruik van twee kopieën van gegevens, en indrukwekkende prestaties dankzij de gepatenteerde algoritmen. , oplossingen van zijn uitstekende kandidaten voor sleutelposities bij de opbouw van een modern datacenter.
Bron: habr.com
