

Vele Enterprise-applicaties en virtualisatiesystemen hebben hun eigen mechanismen voor het opzetten van failover-oplossingen. In het bijzonder is Oracle RAC (Oracle Real Application Cluster) een cluster van twee of meer Oracle-databaseservers die samenwerken om de belasting gelijkmatig te verdelen en failover-compatibiliteit op server-/applicatieniveau te bieden. Voor het functioneren in deze modus is een gedeelde opslag nodig, die meestal door een opslagcontainer wordt geleid.
Zoals we al eerder hebben besproken in een van onze , heeft de opslagcontainer op zichzelf, ondanks de aanwezigheid van gedupliceerde componenten (inclusief controllers), nog steeds punten van uitval - met name in de vorm van een enkele set gegevens. Daarom moet de structuur 'N servers - één opslagcontainer' worden gecompliceerd voor het bouwen van een Oracle-oplossing met verhoogde betrouwbaarheid.
Allereerst moeten we uiteraard bepalen tegen welke risico's we ons willen beschermen. In dit artikel zullen we niet ingaan op bescherming tegen bedreigingen zoals 'een meteoriet die gevallen is'. Dus het opzetten van een geografisch verspreide disaster recovery-oplossing blijft een onderwerp voor een van de volgende artikelen. Hier bekijken we de zogenaamde Cross-Rack disaster recovery-oplossing, waarbij de bescherming wordt geboden op serverkastniveau. De kasten kunnen zich zowel in dezelfde ruimte als in verschillende ruimtes bevinden, maar meestal binnen hetzelfde gebouw.
Deze kasten moeten de volledige benodigde set apparatuur en software bevatten om de werking van Oracle-databases te waarborgen, ongeacht de toestand van de 'buur'. Met andere woorden, door gebruik te maken van de Cross-Rack disaster recovery-oplossing, sluiten we de risico's bij uitval uit:
- Oracle-toepassingsservers
- Opslagsystemen
- Schakelsystemen
- Volledige uitval van alle apparatuur in de kast:
- Stroomuitval
- Koelingsysteemuitval
- Buitenlandse factoren (mens, natuur, enz.)
Duplicatie van Oracle-servers impliceert het principe van de werking van Oracle RAC en wordt gerealiseerd via de applicatie. Duplicatie van schakelingen vormt ook geen probleem. Maar duplicatie van het opslagsysteem is niet zo eenvoudig.
De eenvoudigste optie is de replicatie van gegevens van de primaire opslag naar de reserveopslag. Dit kan synchroon of asynchroon, afhankelijk van de mogelijkheden van de opslag. Bij asynchrone replicatie rijst direct de vraag naar de consistentie van de gegevens in relatie tot Oracle. Maar zelfs als er software-integratie met de applicatie is, is er altijd handmatige tussenkomst van beheerders nodig om het cluster naar de reserveopslag over te schakelen bij een storing van de primaire opslag.
Een complexere optie zijn software- en/of hardware 'virtualizers' voor opslag, die problemen met consistentie en handmatige tussenkomst vermijden. Maar de complexiteit van implementatie en het daaropvolgende beheer, evenals de vrij hoge kosten van dergelijke oplossingen, schrikt velen af.
Voor dergelijke scenario's zoals Cross-Rack disaster recovery is de All Flash array AccelStor NeoSapphire™ een uitstekende keuze. met gebruik van de Shared-Nothing architectuur. Dit model bestaat uit een tweekoppig opslagsysteem dat gebruikmaakt van de eigen technologie FlexiRemap® voor het werken met flash-opslag. Dankzij de NeoSapphire™ H710 kan een prestaties leveren tot 600K IOPS@4K random write en 1M+ IOPS@4K random read, wat onhaalbaar is met traditionele RAID-gebaseerde opslag.
Maar de belangrijkste eigenschap van de NeoSapphire™ H710 is de uitvoering van twee knooppunten in aparte behuizingen, waarvan elke een eigen kopie van de gegevens heeft. De synchronisatie van de knooppunten gebeurt via een externe InfiniBand-interface. Dankzij deze architectuur kunnen knooppunten op verschillende locaties tot 100m van elkaar worden geplaatst, wat een oplossing voor Cross-Rack disaster recovery mogelijk maakt. Beide knooppunten werken volledig synchroon. Voor de hosts lijkt de H710 op een gewone dual-controller opslag. Daarom zijn er geen aanvullende software- en hardware-opties of bijzonder complexe instellingen nodig.
Wanneer je alle bovengenoemde oplossingen voor Cross-Rack disaster recovery vergelijkt, valt de optie van AccelStor duidelijk op tussen de anderen:
AccelStor NeoSapphire™ Shared Nothing Architecture
Software- of hardware 'virtualizer' voor opslag
Oplossing op basis van replicatie
Beschikbaarheid
Serveruitval
Geen Downtime
Geen Downtime
Geen Downtime
Switchuitval
Geen Downtime
Geen Downtime
Geen Downtime
Opslaguitval
Geen Downtime
Geen Downtime
Downtime
Kastuitval
Geen Downtime
Geen Downtime
Downtime
Kosten en complexiteit
Kosten van de oplossing
Laag*
Hoog
Hoog
Implementatiecomplexiteit
Laag
Hoog
Hoog
*AccelStor NeoSapphire™ is nog steeds een All Flash-array, die per definitie niet ‘drie centen’ kost, vooral met een dubbele capaciteit. Echter, vergeleken met de totale kosten van oplossingen op basis hiervan met vergelijkbare van andere leveranciers, kan de prijs als laag worden beschouwd.
De topologie voor het aansluiten van applicatieservers en nodes van de All Flash-array zal er als volgt uitzien:
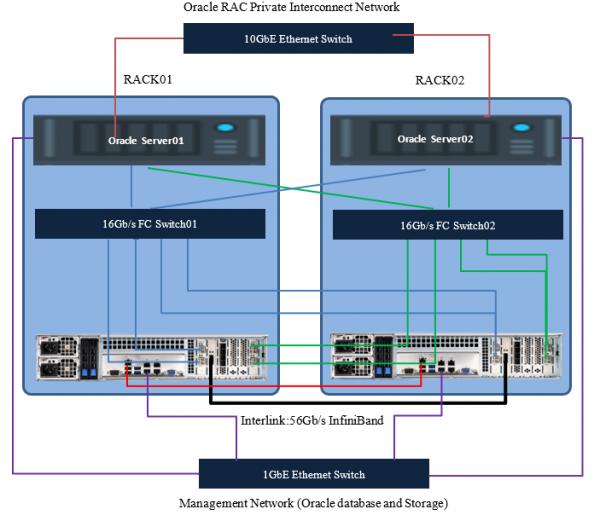
Bij het plannen van de topologie is het ook zeer aanbevolen om duplicaten van de beheerswitches en de interconnects van de servers te maken.
Hier en verder zal het gaan om een verbinding via Fibre Channel. Bij gebruik van iSCSI zal hetzelfde gebeuren, met aanpassingen aan de gebruikte typen switches en iets andere configuraties van de array.
Voorbereidend werk op de array
Gebruikte hardware en software
Specificaties van servers en switches
Componenten
Omschrijving
Oracle Database 11g-servers
Twee
Serverbesturingssysteem
Oracle Linux
Versie van de Oracle-database
11g (RAC)
Processors per server
Twee 16 cores Intel® Xeon® CPU E5-2667 v2 @ 3.30GHz
Fysiek geheugen per server
128GB
FC-netwerk
16Gb/s FC met multipathing
FC HBA
Emulex Lpe-16002B
Speciaal publiek 1GbE-poorten voor clusterbeheer
Intel ethernetadapter RJ45
16Gb/s FC-switch
Brocade 6505
Speciaal privé 10GbE-poorten voor gegevenssynchronisatie
Intel X520
Specificatie van de AccelStor NeoSapphire™ All Flash-array
Componenten
Omschrijving
Opslagsysteem
NeoSapphire™ hoge beschikbaarheidsmodel: H710
Afbeeldingsversie
4.0.1
Totaal aantal schijven
48
Schijfgrootte
1.92TB
Schijftype
SSD
FC-doelpoorten
16x 16Gb poorten (8 per node)
Beheerpoorten
De 1GbE ethernetkabel die verbinding maakt met hosts via een ethernet switch
Heartbeat-poort
De 1GbE ethernetkabel die verbinding maakt tussen twee opslagnodes
Gegevenssynchronisatiepoort
56Gb/s InfiniBand-kabel
Voordat de array wordt gebruikt, moet deze worden geïnitialiseerd. Standaard heeft het beheersadres van beide nodes hetzelfde adres (192.168.1.1). Je moet een voor een verbinding maken met hen en nieuwe (al verschillende) beheersadressen instellen en de tijdsynchronisatie configureren, waarna de beheerpoorten in één netwerk kunnen worden aangesloten. Daarna worden de nodes als een HA-paar samengevoegd door subnetten aan de interlinkverbindingen toe te wijzen.
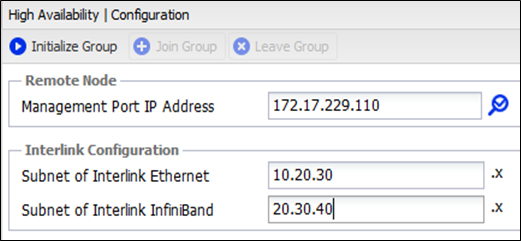
Na het voltooien van de initialisatie kan de array vanaf elke node worden beheerd.
Vervolgens maken we de benodigde volumes aan en publiceren we deze voor applicatieservers.
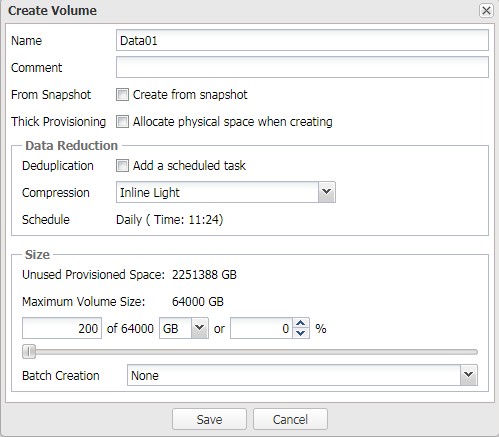
Het is sterk aanbevolen om meerdere volumes voor Oracle ASM te creëren, aangezien dit het aantal targets voor servers zal verhogen, wat uiteindelijk de algehele prestaties zal verbeteren (meer hierover over queues in een andere) ).
Testconfiguratie
Opslagvolumenaam
Volume grootte
Data01
200GB
Data02
200GB
Data03
200GB
Data04
200GB
Data05
200GB
Data06
200GB
Data07
200GB
Data08
200GB
Data09
200GB
Data10
200GB
Grid01
1GB
Grid02
1GB
Grid03
1GB
Grid04
1GB
Grid05
1GB
Grid06
1GB
Redo01
100GB
Redo02
100GB
Redo03
100GB
Redo04
100GB
Redo05
100GB
Redo06
100GB
Redo07
100GB
Redo08
100GB
Redo09
100GB
Redo10
100GB
Enkele uitleg over de werkmodi van de array en de processen die plaatsvinden tijdens noodgevallen.
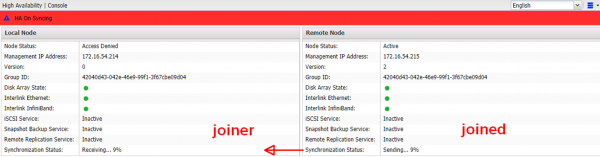
Elke node in de dataset heeft een parameter ‘versienummer’. Na de eerste initialisatie is deze gelijk en bedraagt hij 1. Als om welke reden dan ook het versienummer verschilt, gebeurt er altijd synchronisatie van gegevens van de oudere versie naar de jongere, waarna het versienummer van de jongere wordt afgestemd, wat betekent dat de kopieën identiek zijn. Redenen waarom versies kunnen verschillen zijn:
- Geplande herstart van een van de nodes.
- Uitval van een van de nodes door een onverwachte uitschakeling (stroom, oververhitting, enz.).
- Onderbreking van de InfiniBand-verbinding met onvermogen om te synchroniseren.
- Uitval van een van de nodes door datacorruptie. Hier is het nodig om een nieuwe HA-groep te creëren en de dataset volledig te synchroniseren.
In ieder geval verhoogt de node die online blijft haar versienummer met één, zodat ze na het herstellen van de verbinding haar dataset kan synchroniseren met de paren.
Als de verbinding wordt verbroken via de Ethernet-link, schakelt Heartbeat tijdelijk over naar InfiniBand en schakelt het binnen 10 seconden weer terug zodra deze hersteld is.
Configuratie van hosts.
Om redundantie en hogere prestaties te waarborgen, moet MPIO-ondersteuning voor de array worden ingeschakeld. Hiervoor moeten regels aan het bestand /etc/multipath.conf worden toegevoegd, waarna de multipath-service opnieuw moet worden opgestart.
Verborgen tekstdevices {
device {
vendor "AStor"
path_grouping_policy "group_by_prio"
path_selector "queue-length 0"
path_checker "tur"
features "0"
hardware_handler "0"
prio "const"
failback immediate
fast_io_fail_tmo 5
dev_loss_tmo 60
user_friendly_names yes
detect_prio yes
rr_min_io_rq 1
no_path_retry 0
}
}
Vervolgens, om ASM te laten werken met MPIO via ASMLib, moet het bestand /etc/sysconfig/oracleasm worden gewijzigd en moet vervolgens /etc/init.d/oracleasm scandisks worden uitgevoerd.
Verborgen tekst
# ORACLEASM_SCANORDER: Matching patterns to order disk scanning
ORACLEASM_SCANORDER="dm"
# ORACLEASM_SCANEXCLUDE: Matching patterns to exclude disks from scan
ORACLEASM_SCANEXCLUDE="sd"
Opmerking
Als je ASMLib niet wilt gebruiken, kunnen UDEV-regels worden gebruikt, die de basis zijn voor ASMLib.
Vanaf versie 12.1.0.2 is de Oracle Database-optie beschikbaar voor installatie als onderdeel van de ASMFD-software.
Zorg er altijd voor dat de schijven die voor Oracle ASM worden aangemaakt, zijn afgestemd op de blokgrootte waarmee de array fysiek werkt (4K). Anders kunnen er prestatieproblemen optreden. Daarom moeten volumes met de bijbehorende parameters worden aangemaakt:
parted /dev/mapper/device-name mklabel gpt mkpart primary 2048s 100% align-check optimal 1
Database distribution across created volumes for our test configuration
Opslagvolumenaam
Volume grootte
Volume LUNs mapping
ASM Volume Device Detail
Allocation Unit Size
Data01
200GB
Map all storage volumes to storage system all data ports
Redundancy: Normal
Name: DGDATA
Purpose: Data files
4MB
Data02
200GB
Data03
200GB
Data04
200GB
Data05
200GB
Data06
200GB
Data07
200GB
Data08
200GB
Data09
200GB
Data10
200GB
Grid01
1GB
Redundancy: Normal
Name: DGGRID1
Purpose: Grid: CRS and Voting
4MB
Grid02
1GB
Grid03
1GB
Grid04
1GB
Redundancy: Normal
Name: DGGRID2
Purpose: Grid: CRS and Voting
4MB
Grid05
1GB
Grid06
1GB
Redo01
100GB
Redundancy: Normal
Name: DGREDO1
Purpose: Redo log of thread 1
4MB
Redo02
100GB
Redo03
100GB
Redo04
100GB
Redo05
100GB
Redo06
100GB
Redundancy: Normal
Name: DGREDO2
Purpose: Redo log of thread 2
4MB
Redo07
100GB
Redo08
100GB
Redo09
100GB
Redo10
100GB
Database-instellingen
- Block size = 8K
- Swap space = 16GB
- Disable AMM (Automatic Memory Management)
- Disable Transparent Huge Pages
Other settings
# vi /etc/sysctl.conf
✓ fs.aio-max-nr = 1048576
✓ fs.file-max = 6815744
✓ kernel.shmmax 103079215104
✓ kernel.shmall 31457280
✓ kernel.shmmn 4096
✓ kernel.sem = 250 32000 100 128
✓ net.ipv4.ip_local_port_range = 9000 65500
✓ net.core.rmem_default = 262144
✓ net.core.rmem_max = 4194304
✓ net.core.wmem_default = 262144
✓ net.core.wmem_max = 1048586
✓ vm.swappiness = 10
✓ vm.min_free_kbytes = 524288 # don’t set this if you’re using Linux x86
✓ vm.vfs_cache_pressure = 200
✓ vm.nr_hugepages = 57000
# vi /etc/security/limits.conf
✓ grid soft nproc 2047
✓ grid hard nproc 16384
✓ grid soft nofile 1024
✓ grid hard nofile 65536
✓ grid soft stack 10240
✓ grid hard stack 32768
✓ oracle soft nproc 2047
✓ oracle hard nproc 16384
✓ oracle soft nofile 1024
✓ oracle hard nofile 65536
✓ oracle soft stack 10240
✓ oracle hard stack 32768
✓ soft memlock 120795954
✓ hard memlock 120795954
sqlplus “/as sysdba”
alter system set processes = 2000 scope = spfile;
alter system set open_cursors = 2000 scope = spfile;
alter system set session_cached_cursors = 300 scope = spfile;
alter system set db_files = 8192 scope = spfile;
Failover test
To demonstrate, HammerDB was used to emulate OLTP load. HammerDB configuration:
Number of Warehouses
256
Total Transactions per User
1000000000000
Virtual Users
256
The result was a measure of 2.1M TPM, which is far from the performance limit of the array , but is the "ceiling" for the current hardware configuration of the servers (primarily due to the processors) and their quantity. The goal of this test is still to demonstrate the fault tolerance of the solution as a whole, rather than achieving performance maxima. Therefore, we will just take this figure as a reference.
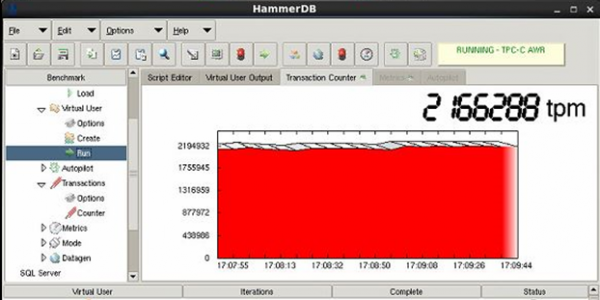
Node failure test
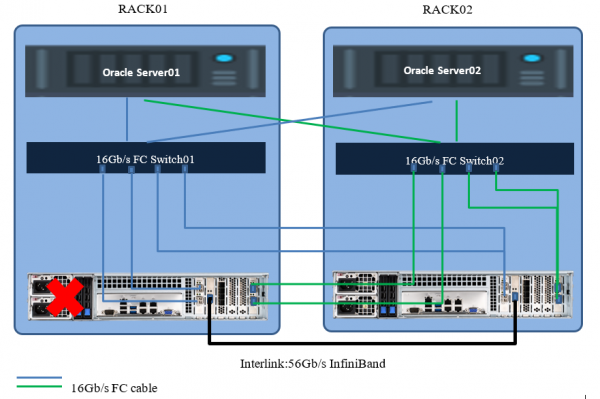
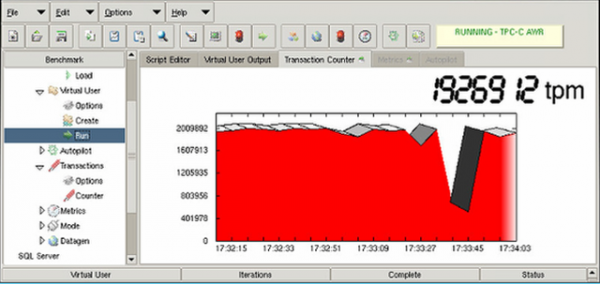
Hosts lost part of the paths to the storage but continued to operate through the remaining ones with the second node. The performance dropped for a few seconds due to path reconfiguration but then returned to normal levels. There was no service interruption.
Cabinet failure test with all equipment
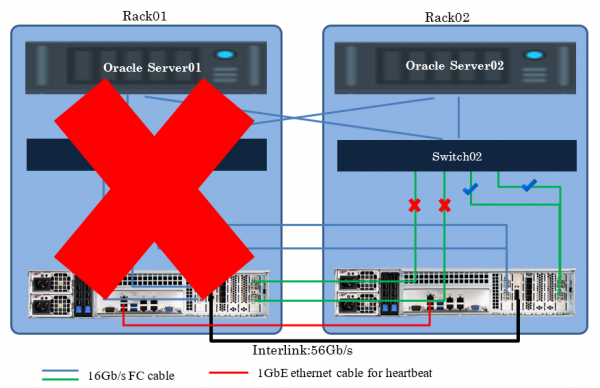
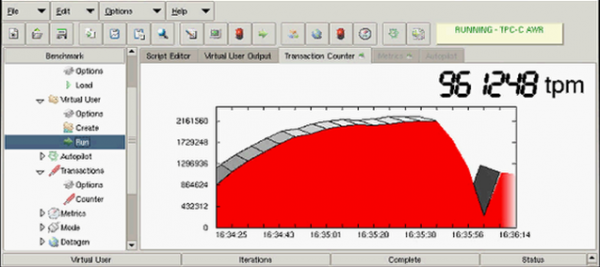
In this case, the performance also dropped for a few seconds due to path reconfiguration, then returned to half the original value. The result decreased by half from the initial due to the exclusion of one application server from operation. There was also no service interruption.
Als er behoefte is aan een kosteneffectieve en eenvoudig te implementeren oplossing voor Cross-Rack disaster recovery voor Oracle, is de combinatie van Oracle RAC en de architectuur een van de beste opties. In plaats van Oracle RAC kan elke andere software die clustering ondersteunt, zoals dezelfde databasesystemen of virtualisatiesystemen, worden gebruikt. Het principe van de oplossing blijft hetzelfde. Het uiteindelijke resultaat is een RTO en RPO van nul.
Bron: habr.com
