

Als je een tijdreeksdatabase (timeseries db, ) als hoofdopslag voor een website met statistieken gebruikt, dan kun je in plaats van de taak op te lossen, veel hoofdpijn krijgen. Ik werk aan een project waarin zo'n database wordt gebruikt, en soms heeft InfluxDB, waarover we gaan praten, echt onverwachte verrassingen gebracht.
Disclaimer: de genoemde problemen zijn van toepassing op versie InfluxDB 1.7.4.
Waarom tijdreeksen?
Het project is gericht op het volgen van transacties in verschillende blockchains en het weergeven van statistieken. Concreet kijken we naar de emissie en verbranding van stablecoins (). Op basis van deze transacties moeten we grafieken opstellen en samenvattingstabellen tonen.
Tijdens de analyse van transacties kwam het idee op: gebruik InfluxDB als hoofdopslag voor tijdreeksen. Transacties zijn punten in de tijd en passen goed in het model van tijdreeksen.
Bovendien zagen de aggregatiefuncties er zeer handig uit — ze zijn perfect voor het verwerken van grafieken over lange periodes. De gebruiker heeft een grafiek voor een jaar nodig, terwijl de database een dataset met een tijdframe van vijf minuten bevat. Het geeft geen zin om die honderdduizend punten te verzenden — naast de lange verwerking passen ze niet eens op het scherm. Je kunt je eigen implementatie voor het vergroten van het tijdframe schrijven, of gebruikmaken van de ingebouwde aggregatiefuncties in Influx. Hiermee kun je de gegevens per dag groeperen en de benodigde 365 punten verzenden.
Ik was een beetje verrast dat dergelijke databases meestal worden gebruikt om metrics te verzamelen. Servermonitoring, IoT-apparaten, allemaal vanuit waar miljoenen punten van het type: [<tijd> — <waarde metric>] "stromen". Maar als de database goed werkt met een hoge gegevensstroom, waarom zou een klein volume dan problemen moeten veroorzaken? Met deze gedachte gingen we met InfluxDB aan de slag.
Wat is er nog meer handig aan InfluxDB
Naast de genoemde aggregatiefuncties is er nog een geweldige functie — continue queries (). Dit is een ingebouwde planner in de database, die gegevens kan verwerken volgens een schema. Bijvoorbeeld, je kunt elke 24 uur alle records van de dag groeperen, het gemiddelde berekenen en één nieuw punt in een andere tabel opslaan zonder je eigen fietsen te schrijven.
Er is ook retention policies () — configuratie voor het verwijderen van gegevens na een bepaalde periode. Dit is handig wanneer je bijvoorbeeld de CPU-belasting van een week met metingen elke seconde wilt opslaan, terwijl die nauwkeurigheid over een periode van een paar maanden niet nodig is. In deze situatie kun je het als volgt doen:
- een continue query maken voor het aggregeren van gegevens in een andere tabel;
- voor de eerste tabel een verwijderingsbeleid definiëren voor metrics die ouder zijn dan diezelfde week.
En Influx zal zelf de hoeveelheid gegevens verminderen en onnodige gegevens verwijderen.
Over de opgeslagen gegevens
Er zijn niet veel gegevens: ongeveer 70.000 transacties en nog eens een miljoen punten met marktinformatie. Nieuwe records worden toegevoegd — niet meer dan 3000 punten per dag. Ook zijn er metrics over de website, maar daar zijn weinig gegevens en volgens het retention policy worden ze niet langer dan een maand opgeslagen.
Problemen
Tijdens de ontwikkeling en het daaropvolgende testen van de service deden zich steeds kritischere problemen voor tijdens het gebruik van InfluxDB.
1. Gegevens verwijderen
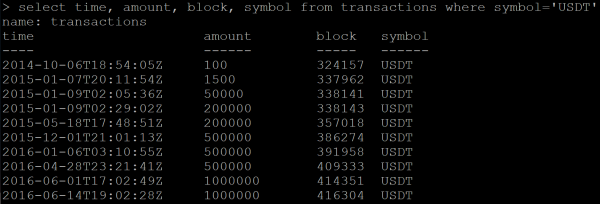
Er is een reeks gegevens met transacties:
SELECT time, amount, block, symbol FROM transactions WHERE symbol='USDT'Resultaat:
Ik stuur een commando om gegevens te verwijderen:
DELETE FROM transactions WHERE symbol='USDT'Vervolgens doe ik een aanvraag voor het verkrijgen van de reeds verwijderde gegevens. En Influx retourneert in plaats van een leeg antwoord een deel van de gegevens die verwijderd zouden moeten zijn.
Ik probeer de hele tabel te verwijderen:
DROP MEASUREMENT transactionsIk controleer de verwijdering van de tabel:
SHOW MEASUREMENTSDe tabel zie ik niet in de lijst, maar de nieuwe gegevensaanvraag blijft dezelfde set transacties retourneren.
Het probleem deed zich bij mij slechts één keer voor, omdat het geval van verwijdering een unieke situatie is. Maar dit gedrag van de database past duidelijk niet binnen de grenzen van ‘juiste’ werking. Later vond ik op github een open bijna een jaar oud over dit onderwerp.
Uiteindelijk hielp het verwijderen en daarna herstellen van de gehele database.
2. Drijvende getallen
Wiskundige berekeningen bij het gebruik van ingebouwde functies in InfluxDB geven nauwkeurigheidsfouten. Het is niet iets ongewoons, maar het is vervelend.
In mijn geval hebben de gegevens een financiële component en wil ik ze met hoge precisie verwerken. Daarom ben ik van plan om af te zien van continue queries.
3. Continue queries kunnen niet worden aangepast aan verschillende tijdzones
De service heeft een tabel met dagelijkse transactiestatistieken. Voor elke dag moeten alle transacties van die dag worden gegroepeerd. Maar de dag begint voor elke gebruiker op verschillende tijden, wat betekent dat de set transacties anders is. Volgens UTC zijn er verschuivingen waarvoor de gegevens moeten worden geaggregeerd.
In InfluxDB kun je bij het groeperen op tijd ook een verschuiving opgeven, bijvoorbeeld voor Moskou-tijd (UTC+3):
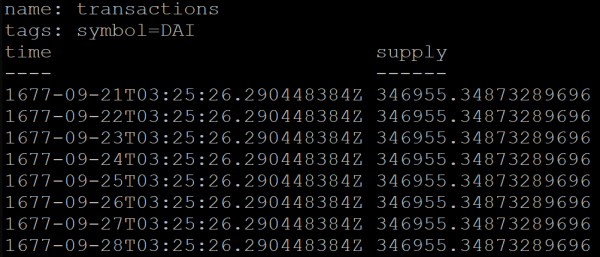
SELECT MEAN("supply") FROM transactions GROUP BY symbol, time(1d, 3h) fill(previous)Maar het resultaat van de query zal onjuist zijn. Om de een of andere reden beginnen de gegroepeerde gegevens per dag pas in 1677 (InfluxDB ondersteunt officieel tijdsintervallen vanaf dat jaar):
Om dit probleem te omzeilen, hebben we de service tijdelijk naar UTC+0 overgebracht.
4. Prestatie
Er zijn veel benchmarks op het internet die InfluxDB met andere databases vergelijken. Bij een eerste kennismaking leken ze op marketingmateriaal, maar nu geloof ik dat er een kern van waarheid in zit.
Ik zal mijn case beschrijven.
De service biedt een API-methode die statistieken voor de afgelopen dag teruggeeft. Bij de berekeningen vraagt de methode drie keer de database met de volgende queries aan:
SELECT * FROM coins_info WHERE time <= NOW() GROUP BY symbol ORDER BY time DESC LIMIT 1SELECT * FROM dominance_info ORDER BY time DESC LIMIT 1SELECT * FROM transactions WHERE time >= NOW() - 24h ORDER BY time DESCUitleg:
- In de eerste query krijgen we de laatste punten voor elke munteenheid met marktgegevens. In mijn geval zijn dat acht punten voor acht munten.
- De tweede query haalt het nieuwste punt op.
- De derde vraagt een lijst met transacties van de afgelopen dag op, wat er enkele honderden kan zijn.
Ik wil verduidelijken dat InfluxDB automatisch een index op tags en tijd bouwt, wat de queries versnelt. In de eerste query is symbol — dit is een tag.
Ik heb een stress-test voor deze API-methode uitgevoerd. Bij 25 RPS liet de server een volledige belasting van zes CPU's zien:
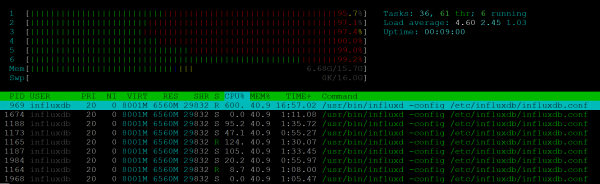
Ondertussen veroorzaakte het NodeJs-proces helemaal geen belasting.
De snelheid van de uitvoering verslechterde al bij 7-10 RPS: als één klant een antwoord binnen 200 ms kon krijgen, moesten 10 klanten een seconde wachten. 25 RPS is de grens waarbij de stabiliteit eronder lijdt, en klanten kregen 500 fouten terug.
Met zo'n prestatie is het onmogelijk om Influx in ons project te gebruiken. Bovendien kunnen in een project waar monitoring aan veel klanten moet worden gedemonstreerd soortgelijke problemen optreden en zal de metricserver overbelast raken.
Uitslag
De belangrijkste conclusie uit de opgedane ervaring is dat je geen onbekende technologie in een project moet opnemen zonder voldoende analyse. Een eenvoudige screening van open tickets op GitHub had informatie kunnen opleveren die zou hebben verhinderd dat InfluxDB als de primaire database werd gekozen.
InfluxDB leek goed te passen bij de eisen van mijn project, maar de praktijk heeft aangetoond dat deze database niet aan de behoeften voldoet en veel problemen vert laat zien.
In de projectrepository is al versie 2.0.0-beta te vinden; laten we hopen dat er significante verbeteringen in de tweede versie komen. Ondertussen ga ik de documentatie van TimescaleDB bestuderen.
Bron: habr.com
