

Waarom zijn back-ups nodig? De hardware is immers zeer betrouwbaar, en bovendien zijn er ‘clouds’ die beter zijn dan fysieke servers: met de juiste configuratie overleeft een ‘cloud’-server gemakkelijk de storing van een fysieke infrastructuurserver, en vanuit het perspectief van de servicegebruikers zal er slechts een kleine en nauwelijks merkbare sprongetje in de responstijd zijn. Bovendien vereist het dupliceren van informatie vaak betaling voor ‘overbodige’ processor tijd, schijfbelasting en netwerktrafiek.
Een ideale software werkt snel, lekt niet in het RAM-geheugen, heeft geen gaten en bestaat niet.
—Onbekend
Aangezien software nog steeds wordt geschreven door menselijke ontwikkelaars, en het testproces vaak ontbreekt, en het leveren van software uiterst zelden gebeurt volgens ‘best practices’ (die op zich ook software zijn en dus niet perfect), moet de systeembeheerder vaak taken oplossen die kort maar krachtig zijn: ‘terugzetten naar zoals het was’, ‘database herstellen’, ‘werkt langzaam — we rollen terug’, en mijn favoriete ‘ik weet niet wat, maar maak het weer werkend’.
Naast logische fouten die voortkomen uit slordig werk van ontwikkelaars, of toevallige omstandigheden, evenals de incomplete kennis of onbegrip van de kleine details van softwareontwikkeling — inclusief verbindings- en systeemcomponenten, zoals besturingssystemen, stuurprogramma's en firmware — zijn er ook andere fouten. Veel ontwikkelaars vertrouwen bijvoorbeeld op de runtime, totaal vergeten de fysieke wetten, die met software nog steeds niet te omzeilen zijn. Dit betreft de eindeloze betrouwbaarheid van de schijfsubsystemen en überhaupt elk datopslagsysteem (inclusief RAM en processor cache!), nul verwerkingstijd op de processor, en het ontbreken van fouten bij netwerkoverdracht en verwerking op de processor, en netwerkvertragingen die gelijk zijn aan 0. Ook moet men de beruchte deadline niet onderschatten, want als die niet wordt gehaald — ontstaan er problemen die verder gaan dan de nuances van netwerken en schijven.
Wat moet je doen met de problemen die opdoemen en dreigen boven waardevolle gegevens te hangen? Er is niets dat levende ontwikkelaars kan vervangen, en het is ook niet zeker dat dit in de nabije toekomst mogelijk zal zijn. Aan de andere kant is het tot nu toe alleen enkele projecten gelukt om volledig aan te tonen dat een programma zal functioneren zoals bedoeld, en absoluut is het niet gegarandeerd dat je deze bewijzen kunt nemen en toepassen op andere soortgelijke projecten. Bovendien kost het veel tijd om dergelijke bewijzen te verzamelen, en vereist het speciale vaardigheden en kennis, wat de mogelijkheden voor toepassing met het oog op deadlines praktisch minimaliseert. Bovendien beheersen we nog geen super snelle, goedkope en eindeloos betrouwbare technologie voor opslag, verwerking en transmissie van informatie. Dergelijke technologieën bestaan, als ze al bestaan, vaak alleen in de vorm van concepten, of - vaker nog - alleen in sciencefictionboeken en -films.
Goede kunstenaars kopiëren, grote kunstenaars stelen.
—Pablo Picasso.
De beste oplossingen en opmerkelijk eenvoudige dingen gebeuren vaak daar waar absoluut incompatibele, op het eerste gezicht, begrippen, technologieën, kennis en wetenschapsgebieden samenkomen.
Bijvoorbeeld, zowel vogels als vliegtuigen hebben vleugels, maar ondanks de functionele gelijkenis – het werkingsprincipe komt in sommige situaties overeen en technische problemen worden op vergelijkbare wijze opgelost: holle botten, gebruik van sterke en lichte materialen, enzovoort – zijn de resultaten absoluut verschillend, hoewel ze erg op elkaar lijken. De beste voorbeelden die we in onze techniek zien, zijn ook voor het grootste deel ontleend aan de natuur: luchtdichte compartimenten in schepen en onderzeeërs zijn een directe analogie met ringwormen; het opzetten van RAID-arrays en het controleren van gegevensintegriteit is te vergelijken met de duplicatie van DNA-ketens; en ook paren van organen, de onafhankelijkheid van verschillende organen van het centrale zenuwstelsel (automatische werking van het hart) en reflexen - autonome systemen op het internet. Natuurlijk brengen kant-en-klare oplossingen die direct worden toegepast problemen met zich mee, maar wie weet, misschien zijn er helemaal geen andere oplossingen.
Als ik maar wist waar ik zou vallen, had ik een strookje neergelegd!
—Wit-Russisch volksgezegde
Het betekent dat back-ups van vitaal belang zijn voor iedereen die wil:
- De mogelijkheid hebben om zijn systemen te herstellen met minimale downtime, of zelfs helemaal zonder.
- Durf te handelen, want in geval van een fout is er altijd de mogelijkheid om terug te draaien.
- Minimaal de gevolgen van opzettelijke beschadiging van gegevens beperken.
Hier is een beetje theorie.
Elke classificatie is willekeurig. De natuur classificeert niet. Wij classificeren omdat dit voor ons handiger is. En we classificeren op basis van gegevens die we ook willekeurig verkrijgen.
—Jean Bruhlier
Ongeacht de fysieke opslage methode kan de logische opslag van gegevens globaal worden onderverdeeld in twee manieren van toegang tot deze gegevens: block en file. Deze indeling is de laatste tijd vrij vaag geworden, want er bestaan geen puur block of puur file logische opslagen. Maar voor de eenvoud zullen we aannemen dat ze er zijn.
Blockopslag betekent dat er een fysiek apparaat is waar gegevens in vaste porties, blocks, worden opgeslagen. Toegang tot de blocks gebeurt via een bepaald adres, waarbij elke block zijn eigen adres heeft binnen het apparaat.
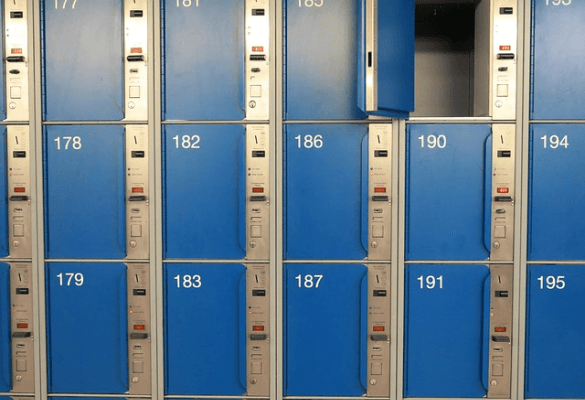
Een back-up wordt meestal gemaakt door blocks gegevens te kopiëren. Om de integriteit van gegevens op het moment van kopiëren te waarborgen, wordt het schrijven van nieuwe blocks onderbroken, evenals het wijzigen van bestaande blocks. Als we een analogie uit de gewone wereld nemen: het dichtstbijzijnde is een kast met identieke genummerde vakken.
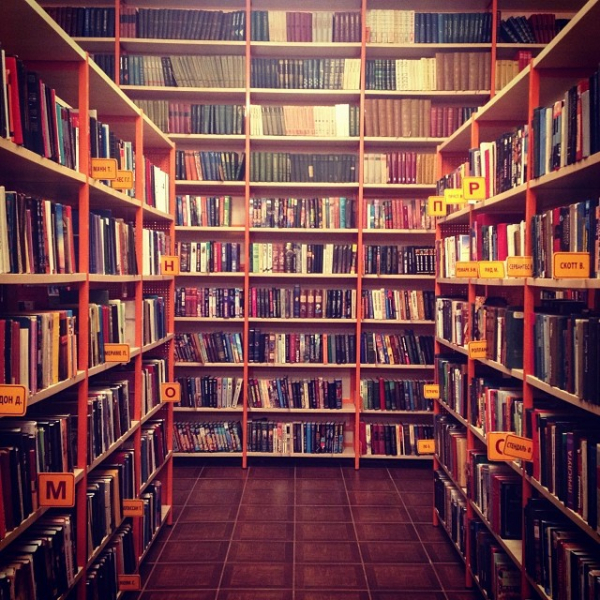
Fileopslag op basis van logische apparaten is vergelijkbaar met blockopslag en wordt vaak bovenop georganiseerd. Belangrijke verschillen zijn de aanwezigheid van een opslaghiërarchie en begrijpelijke namen. Er vindt een abstractie plaats in de vorm van een bestand - een benoemd gebied van gegevens, evenals een map - een speciaal bestand waarin beschrijvingen en toegang tot andere bestanden worden opgeslagen. Bestanden kunnen worden voorzien van aanvullende metadata: aanmaakdatum, toegangsrechten, enz. Gewoonlijk wordt dit gedaan door gewijzigde bestanden te zoeken en ze vervolgens naar een andere, structureel identieke fileopslag te kopiëren. De integriteit van de gegevens wordt meestal gerealiseerd door afwezigheid van bestanden waarin wordt geschreven. Bestandsmetadata worden op dezelfde manier gereserveerd. De dichtstbijzijnde analogie is een bibliotheek met verschillende secties voor verschillende boeken, evenals een catalogus met begrijpelijke namen van boeken.
Onlangs wordt soms een andere variant beschreven, waarmee het in principe allemaal begon: objectopslag van gegevens, welke dezelfde archaïsche kenmerken heeft.
Het verschilt van bestandsopslag doordat het geen meerlaagse indeling heeft (platte structuur), en hoewel bestandsnamen menselijk leesbaar zijn, zijn ze toch meer afgestemd op machineverwerking. Bij backups worden objectopslag meestal op dezelfde manier behandeld als bestandsopslag, maar soms zijn er ook andere opties.
— Er zijn twee soorten systeembeheerders: degenen die geen backups maken en degenen die al backups maken.
— Eigenlijk zijn het er drie: er zijn ook degenen die controleren of de backups kunnen worden hersteld.—Onbekend
Tevens is het belangrijk om te begrijpen dat het proces van gegevensbackup door programma's wordt uitgevoerd, en dus de zelfde nadelen heeft als elk ander programma. Om de afhankelijkheid van menselijke factoren te verminderen (niet te elimineren!) en van andere specificiteiten — die op zich misschien niet veel invloed uitoefenen, maar samen een merkbaar effect kunnen hebben — wordt het zogenaamde 3-2-1-regel toegepast. Er zijn veel manieren om dit te interpreteren, maar ik geef de voorkeur aan de volgende uitleg: je moet 3 sets van dezelfde gegevens opslaan, 2 sets moeten in verschillende formaten worden opgeslagen, en bovendien moet 1 set op een geografisch afgelegen opslagplaats worden bewaard.
Onder opslagformaat moet het volgende worden verstaan:
- Als er een afhankelijkheid is van de fysieke opslagwijze, veranderen we de fysieke manier van opslag.
- Als er een afhankelijkheid is van de logische opslagwijze, veranderen we de logische manier van opslag.
Voor het bereiken van het maximale effect van de 3-2-1-regel wordt aanbevolen om het opslagformaat op beide manieren te wijzigen.
Vanuit het perspectief van de gereedheid van de backup voor zijn directe doel — herstel van functionaliteit — wordt er onderscheid gemaakt tussen 'hete' en 'koude' backups. Hete backups onderscheiden zich van koude backups door slechts één ding: ze zijn onmiddellijk klaar voor gebruik, terwijl koude backups voor herstel aanvullende handelingen vereisen: decryptie, extractie uit een archief, enz.
Verwarr geen warme en koude kopieën met online en offline kopieën, die fysieke isolatie van gegevens impliceren en in wezen een andere classificatie van back-upmethoden zijn. Een offline kopie, die niet direct is aangesloten op het systeem waar het moet worden hersteld, kan zowel warm als koud zijn (wat betreft gereedheid voor herstel). Een online kopie kan direct toegankelijk zijn waar het moet worden hersteld en is meestal warm, maar er zijn ook koude kopieën.
Bovendien moet men niet vergeten dat het proces van back-ups maken meestal niet eindigt met het maken van één back-up, en dat er vaak een groot aantal kopieën kan zijn. Daarom moet men onderscheid maken tussen volledige back-ups, dat wil zeggen die welke onafhankelijk van andere back-ups hersteld kunnen worden, en differentiële (incrementele, differentiële, decrementele, enz.) kopieën - die niet zelfstandig kunnen worden hersteld en vooraf herstel van één of meer andere back-ups vereisen.
Differentiële incrementele kopieën zijn een poging om opslagruimte voor back-ups te besparen. Zo worden alleen de gewijzigde gegevens sinds de laatste back-up in de back-up geschreven.
Differentieel decrementele kopieën worden met hetzelfde doel gemaakt, maar op een iets andere manier: er wordt een volledige back-up gemaakt, maar er wordt alleen het verschil tussen de recente kopie en de vorige opgeslagen.
Daarnaast dient men het proces van back-ups bovenop opslag te overwegen die het ontbreken van duplicaten ondersteunt. Als volledige back-ups bovenop worden geschreven, zal er in werkelijkheid alleen het verschil tussen de back-ups worden opgeslagen, maar het herstelproces van de back-ups zal plaatsvinden zoals bij herstel van een volledige kopie, volledig transparant.
Quis custodiet ipsos custodes?
(Wie waakt er over de wachters? — Latijn.)
Het is zeer vervelend als er geen back-ups zijn, maar het is veel erger als er een back-up lijkt te zijn gemaakt, maar deze blijkt niet hersteld te kunnen worden omdat:
- De integriteit van de oorspronkelijke gegevens is aangetast.
- De opslag met back-ups is beschadigd.
- Het herstel verloopt vrij langzaam, je kunt geen gebruikmaken van gegevens die gedeeltelijk zijn hersteld.
Een goed opgebouwde back-upprocedure moet dergelijke opmerkingen in overweging nemen, vooral de eerste twee.
De integriteit van de oorspronkelijke gegevens kan op verschillende manieren worden gegarandeerd. De meest gebruikelijke zijn: a) het maken van back-ups van het bestandssysteem op blokniveau, b) het 'bevriezen' van de status van het bestandssysteem, c) een speciaal blokapparaat met versiebewaring, d) sequentiële opname van bestanden of blokken. Ook worden checksums gebruikt om de gegevens te verifiëren tijdens het herstel.
Opslagbeschadigingen kunnen ook worden gedetecteerd met checksums. Een aanvullende methode is het gebruik van gespecialiseerde apparaten of bestandssystemen waarin eerder geregistreerde gegevens niet kunnen worden gewijzigd, maar nieuwe kunnen worden toegevoegd.
Om het herstel te versnellen, wordt dataherstel met meerdere processen toegepast, op voorwaarde dat er geen 'bottle neck' is in de vorm van een langzame netwerkverbinding of een trage schijf. Om de situatie met gedeeltelijk herstelde gegevens te omzeilen, kan het back-upproces worden opgedeeld in relatief kleine taken, waarbij elke taak afzonderlijk wordt uitgevoerd. Op deze manier kan de functionaliteit stap voor stap worden hersteld met een inschatting van de herstelperiode. Dit probleem ligt vaker op organisatorisch vlak (SLA), daarom zullen we hier niet dieper op ingaan.
Degene die kennis heeft van specerijen is niet degene die ze aan elk gerecht toevoegt, maar degene die nooit iets overbodigs toevoegt.
—V. Sinyavsky
De praktijk van de gebruikte software onder systeembeheerders kan verschillen, maar de algemene principes blijven hoe dan ook hetzelfde, in het bijzonder:
- Het wordt ten zeerste aanbevolen om kant-en-klare oplossingen te gebruiken.
- Programma's moeten voorspelbaar werken, d.w.z. er mogen geen ongedocumenteerde kenmerken of knelpunten zijn.
- De configuratie van elk programma moet zo eenvoudig zijn dat je niet elke keer de handleiding of een spiekbriefje hoeft te lezen.
- De oplossing moet bij voorkeur universeel zijn, aangezien servers qua hardware-eigenschappen aanzienlijk kunnen verschillen.
Voor het maken van back-ups van block devices zijn er de volgende veelgebruikte programma's:
- dd, bekend bij veteranen van systeembeheer, evenals soortgelijke programma's (bijvoorbeeld dd_rescue).
- Ingebouwde programma's (hulpmiddelen) in sommige bestandssystemen die een kopie (dump) van het bestandssysteem maken.
- Alomtegende hulpprogramma's; bijvoorbeeld, partclone.
- Eigen, vaak eigenschap eigen oplossingen; bijvoorbeeld, NortonGhost en latere versies.
Voor bestandssystemen wordt de taak van back-up deels opgelost met methoden die toepasbaar zijn voor block devices, maar de taak kan ook effectiever worden opgelost, bijvoorbeeld met:
- Rsync, een universeel programma en protocol voor het synchroniseren van de status van bestandssystemen.
- Ingebouwde middelen voor archivering (ZFS).
- Derde partij middelen voor archivering; het meest populaire voorbeeld is tar. Er zijn ook andere, zoals dar - een alternatieve versie van tar gericht op moderne systemen.
Het is belangrijk om te vermelden dat er softwaretools zijn die dataconsistentie waarborgen bij het maken van back-ups. Vaak worden de volgende opties gebruikt:
- Het monteren van het bestandssysteem in de alleen-lezen modus (ReadOnly), of het bevriezen van het bestandssysteem (freeze) - deze methode is beperkt toepasbaar.
- Het maken van snapshots van de status van het bestandssysteem of block device (LVM, ZFS).
- Het toepassen van externe middelen voor het organiseren van snapshots, zelfs in gevallen waarin de vorige punten om welke reden dan ook niet kunnen worden toegepast (programma's zoals hotcopy).
- De techniek van kopiëren bij wijziging (CopyOnWrite), maar deze is meestal gebonden aan het gebruikte bestandssysteem (BTRFS, ZFS).
Dus, voor een kleine server moet je een back-upschema opstellen dat aan de volgende vereisten voldoet:
- Eenvoudig in gebruik - er zijn geen speciale extra handelingen vereist bij het werken, minimumacties voor het maken en herstellen van kopieën.
- Universeel - werkt zowel op grote als kleine servers; dit is belangrijk bij groei of schaalvergroting. servers of schaalvergroting.
- Wordt geïnstalleerd via een pakketbeheerder, of met een of twee commando's zoals 'downloaden en uitpakken'.
- Stabiel - gebruikt een standaard of al lang gevestigde opslagformaat.
- Snel in gebruik.
Kandidaten die meer of minder aan de eisen voldoen:
- rdiff-backup
- rsnapshot
- burp
- duplicati
- duplicity
- deja dup
- dar
- zbackup
- restic
- borgbackup
Als testomgeving zal een virtuele machine (op basis van XenServer) met de volgende kenmerken worden gebruikt:
- 4 cores van 2,5 GHz,
- 16 GB RAM,
- 50 GB hybrid storage (SAN met SSD-caching van 20% van de grootte van de virtuele schijf) in de vorm van een aparte virtuele schijf zonder partitie,
- 200 Mbit/s verbinding met internet.
Als server voor het ontvangen van back-ups zal een praktisch identieke machine worden gebruikt, maar met een harde schijf van 500 GB.
Besturingssysteem - Centos 7 x64: standaardindeling, een extra partitie zal worden gebruikt als gegevensbron.
Voor de bronbestanden nemen we een website op WordPress, met media bestanden van 40 GB, en een database op MySQL. Aangezien virtuele servers ze sterk variëren qua kenmerken, en voor betere reproduceerbaarheid, zijn hier
de testresultaten van de server met behulp van Sysbench.sysbench --threads=4 --time=30 --cpu-max-prime=20000 cpu run
sysbench 1.1.0-18a9f86 (gebruik makend van gebundelde LuaJIT 2.1.0-beta3)
De test wordt uitgevoerd met de volgende opties:
Aantal threads: 4
Initialiseren van de random generator vanaf de huidige tijd
Limiet van priemgetallen: 20000
Initialisatie van werkthreads…
Threads gestart!
CPU-snelheid:
evenementen per seconde: 836,69
Throughput:
evenementen/s (eps): 836,6908
verlopen tijd: 30,0039s
totaal aantal evenementen: 25104
Latentie (ms):
min: 2,38
gemiddeld: 4,78
max: 22,39
95e percentiel: 10,46
som: 119923,64
Threads eerlijkheid:
evenementen (gemiddeld/standaardafwijking): 6276,0000/13,91
uitvoertijd (gemiddeld/standaardafwijking): 29,9809/0,01
sysbench --threads=4 --time=30 --memory-block-size=1K --memory-scope=global --memory-total-size=100G --memory-oper=read memory run
sysbench 1.1.0-18a9f86 (gebruik makend van gebundelde LuaJIT 2.1.0-beta3)
De test wordt uitgevoerd met de volgende opties:
Aantal threads: 4
Initialiseren van de random generator vanaf de huidige tijd
Uitvoeren van geheugensnelheidstest met de volgende opties:
blokgrootte: 1KiB
totale grootte: 102400MiB
bewerking: lezen
bereik: globaal
Initialisatie van werkthreads…
Threads gestart!
Totaal aantal bewerkingen: 50900446 (1696677,10 per seconde)
49707,47 MiB overgedragen (1656,91 MiB/sec)
Throughput:
evenementen/s (eps): 1696677,1017
verlopen tijd: 30,0001s
totaal aantal evenementen: 50900446
Latentie (ms):
min: 0,00
gemiddeld: 0,00
max: 24,01
95e percentiel: 0,00
som: 39106,74
Threads eerlijkheid:
evenementen (gemiddeld/standaardafwijking): 12725111,5000/137775,15
uitvoertijd (gemiddeld/standaardafwijking): 9,7767/0,10
sysbench --threads=4 --time=30 --memory-block-size=1K --memory-scope=global --memory-total-size=100G --memory-oper=write memory run
sysbench 1.1.0-18a9f86 (gebruik makend van gebundelde LuaJIT 2.1.0-beta3)
De test wordt uitgevoerd met de volgende opties:
Aantal threads: 4
Initialiseren van de random generator vanaf de huidige tijd
Uitvoeren van geheugensnelheidstest met de volgende opties:
blokgrootte: 1KiB
totale grootte: 102400MiB
bewerking: schrijven
bereik: globaal
Initialisatie van werkthreads…
Threads gestart!
Totaal aantal bewerkingen: 35910413 (1197008,62 per seconde)
35068,76 MiB overgedragen (1168,95 MiB/sec)
Throughput:
evenementen/s (eps): 1197008,6179
verlopen tijd: 30,0001s
totaal aantal evenementen: 35910413
Latentie (ms):
min: 0,00
gemiddeld: 0,00
max: 16,90
95e percentiel: 0,00
som: 43604,83
Threads eerlijkheid:
evenementen (gemiddeld/standaardafwijking): 8977603,2500/233905,84
uitvoertijd (gemiddeld/standaardafwijking): 10,9012/0,41
sysbench --threads=4 --file-test-mode=rndrw --time=60 --file-block-size=4K --file-total-size=1G fileio run
sysbench 1.1.0-18a9f86 (gebruik makend van gebundelde LuaJIT 2.1.0-beta3)
De test wordt uitgevoerd met de volgende opties:
Aantal threads: 4
Initialiseren van de random generator vanaf de huidige tijd
Extra bestandsopenvlaggen: (geen)
128 bestanden, elk 8MiB
1GiB totale bestandsgrootte
Blokgrootte 4KiB
Aantal IO-aanvragen: 0
Lees-/schrijfratio voor gecombineerde willekeurige IO-test: 1,50
Periodieke FSYNC ingeschakeld, aanroepen van fsync() elke 100 aanvragen.
Aanroepen van fsync() aan het einde van de test, ingeschakeld.
Gebruik makend van synchrone I/O-modus
Uitvoeren van willekeurige r/w-test
Initialisatie van werkthreads…
Threads gestart!
Throughput:
lezen: IOPS=3868,21 15,11 MiB/s (15,84 MB/s)
schrijven: IOPS=2578.83 10.07 MiB/s (10.56 MB/s)
fsync: IOPS=8226.98
Latentie (ms):
min: 0,00
gemiddeld: 0.27
max: 18.01
95e percentiel: 1.08
totaal: 238469.45
Met deze notitie begint een grote
cyclus van artikelen over back-ups
- Back-up, deel 1: Waarom een back-up nodig is, een overzicht van methoden en technologieën
- Back-up, deel 2: Overzicht en testen van rsync-gebaseerde back-upoplossingen
- Back-up, deel 3: Overzicht en testen van duplicity, duplicaty, deja dup
- Back-up, deel 4: Overzicht en testen van zbackup, restic, borgbackup
- Back-up, deel 5: Testen van bacula en veeam backup voor linux
- Back-up, deel 6: Vergelijking van back-upoplossingen
- Back-up, deel 7: Conclusies
Bron: habr.com
