

Inleiding tot besturingssystemen
Hallo, Habr! Ik wil jullie een serie vertaalde artikelen voorstellen van een literatuur die ik interessant vind - OSTEP. In dit materiaal wordt diep ingegaan op de werking van Unix-achtige besturingssystemen, met name - hoe processen werken, verschillende planners, geheugen en andere soortgelijke componenten die een modern besturingssysteem vormen. Het origineel van al het materiaal kunt u hier bekijken . Houd er rekening mee dat de vertaling niet professioneel is uitgevoerd (vrij vrij), maar ik hoop dat ik de algemene betekenis heb behouden.
Laboratoriumopdrachten voor dit onderwerp kun je hier vinden:
Andere delen:
En je kunt ook mijn kanaal bezoeken op =)
Planning: Multi-Level Feedback Queue
In deze lezing zullen we het hebben over de problemen bij het ontwikkelen van een van de bekendste benaderingen voor
planning, die worden aangeduid als Multi-Level Feedback Queue (MLFQ). De MLFQ planner werd voor het eerst beschreven in 1962 door Fernando J. Corbató in een systeem dat werd genoemd
Compatible Time-Sharing System (CTSS). Dit werk (inclusief latere studies over
Multics) werd later genomineerd voor de Turing Award. De planner werd
later verbeterd en kreeg de vorm die we al in
sommige moderne systemen tegenkomen.
Het MLFQ-algoritme probeert twee fundamentele, elkaar overlappende problemen op te lossen.
Firstly, het probeert de doorlooptijd te optimaliseren, wat we in de vorige lezing bespraken, door de kortste taken eerst in de rij te plaatsen.
Echter, het besturingssysteem weet niet hoe lang een bepaald proces zal draaien, en dat is
noodzakelijke kennis voor de werking van SJF- en STCF-algoritmen. Secondly, MLFQ probeert
het systeem responsief te maken voor gebruikers (bijvoorbeeld voor diegenen die zitten en
naar het scherm staren in afwachting van het voltooien van een taak) en zo de tijd
van reactie te minimaliseren. Helaas verminderen algoritmes zoals RR de reactietijd, maar hebben extreme
negatieve effecten op de doorlooptijdmetrieken. Dit leidt ons tot het probleem: Hoe ontwerpen we een
planner die aan onze vereisten voldoet en tegelijkertijd niets weet over
de aard van het proces in het algemeen? Hoe kan de planner de eigenschappen van de taken die hij uitvoert leren,
en zo betere beslissingen nemen over de planning?
De kern van het probleem: Hoe taken plannen zonder perfecte kennis?
Hoe een planner ontwikkelen die de reactietijd minimaliseert.
voor interactieve taken en minimaliseert tegelijkertijd de doorlooptijd zonder enige voorafgaande kennis
van de uitvoeringstijd van de taak?
Opmerking: we leren van eerdere gebeurtenissen
De MLFQ-queue is een uitstekend voorbeeld van een systeem dat leert van
afgelopen gebeurtenissen om de toekomst te voorspellen. Dergelijke benaderingen worden vaak
aangetroffen in besturingssystemen (en in veel andere gebieden binnen de informatica, inclusief takken
van voorspellingen in hardware en algoritmes voor caching). Dergelijke benaderingen
functioneren goed wanneer taken gedragsfases hebben en dus voorspelbaar zijn.
Echter, met deze techniek moet voorzichtigheid worden betracht, omdat voorspellingen zeer gemakkelijk
onjuist kunnen zijn en het systeem kunnen leiden tot slechtere beslissingen dan
wanneer er helemaal geen kennis is.
MLFQ: Basisregels
Laten we de basisregels van het MLFQ-algoritme bekijken. En hoewel er verschillende implementaties van dit algoritme
bestaan, zijn de basisbenaderingen vergelijkbaar.
In de implementatie die we zullen bespreken, heeft MLFQ meerdere
afzonderlijke queues, elk met een andere prioriteit. Op elk moment,
bevindt de taak die klaar is voor uitvoering zich in een van de queues. MLFQ gebruikt prioriteiten
om te bepalen welke taak moet worden uitgevoerd, dat wil zeggen dat de taak met een hogere
prioriteit (de taak uit de queue met de hoogste prioriteit) als eerste zal worden uitgevoerd.
Zeker, in een specifieke queue kan er meer dan één taak zijn, zodat
ze dezelfde prioriteit hebben. In dit geval wordt het RR-mechanisme gebruikt
voor het plannen van de uitvoering tussen deze taken.
Zo komen we aan twee basisregels voor MLFQ:
Regel 1: Als prioriteit(A) > prioriteit(B), zal taak A worden uitgevoerd (B niet)
- Regel 2: Als prioriteit(A) = prioriteit(B), worden A en B uitgevoerd met behulp van RR
- Op basis van het bovenstaande zijn de belangrijkste elementen voor MLFQ-planning
de prioriteiten. In plaats van elke taak een vaste prioriteit toe te kennen,
past MLFQ de prioriteit aan op basis van het waargenomen gedrag.
Bijvoorbeeld, als een taak voortdurend CPU-werk opzij zet in afwachting van invoer van het toetsenbord,
zal MLFQ de prioriteit van het proces op een hoog niveau houden, omdat dit is wat
een interactief proces zou moeten doen. Aan de andere kant, als de taak voortdurend en
er moet een interactief proces zijn. Echter, als het tegenovergestelde het geval is, is de taak constant en
intensief het CPU gedurende een lange periode gebruikt, zal MLFQ het verlagen
prioriteit. Op deze manier zal MLFQ het gedrag van processen tijdens hun uitvoering bestuderen
en gebruik maken van de gedragingen.
Laten we een voorbeeld schetsen van hoe de wachtrijen op een bepaald moment eruit zouden kunnen zien.
Het resultaat zou er ongeveer als volgt uitzien:
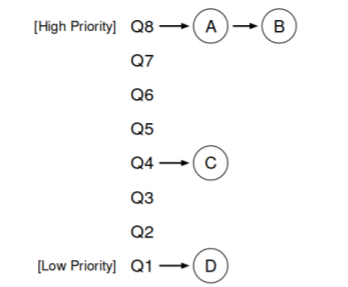
In dit schema bevinden zich 2 processen A en B in de wachtrij met de hoogste prioriteit. Proces
C bevindt zich ergens in het midden, terwijl proces D aan het einde van de wachtrij staat. Volgens de bovenstaande
beschrijvingen van het MLFQ-algoritme zal de planner alleen taken met de hoogste
prioriteit uitvoeren volgens RR, terwijl taken C en D geen aandacht zullen krijgen.
Natuurlijk geeft een statische snapshot niet het volledige beeld van hoe MLFQ werkt.
Het is belangrijk te begrijpen hoe het beeld in de loop van de tijd verandert.
Poging 1: Hoe prioriteit te veranderen
Op dit punt moet worden beslist hoe MLFQ het prioriteitsniveau van
een taak (en bijgevolg de positie van de taak in de wachtrij) tijdens de levenscyclus zal veranderen. Hiervoor
moet je het werkproces in gedachten houden: een aantal
interactieve taken met een korte uitvoeringstijd (en dus frequente vrijgeving van
CPU) en enkele lange taken die de CPU de hele tijd gebruiken, terwijl
de responstijd voor dergelijke taken niet belangrijk is. En zo kan de eerste poging worden gedaan
om het MLFQ-algoritme met de volgende regels te implementeren:
- Regel 3: Wanneer een taak het systeem binnenkomt, wordt deze in de wachtrij met de hoogste
- prioriteit geplaatst.
- Regel 4a: Als een taak het toegewezen tijdvenster volledig gebruikt, wordt haar
- prioriteit verlaagd.
- Regel 4b: Als een taak de CPU vóór het verstrijken van zijn tijdvenster vrijgeeft, blijft zij
- met dezelfde prioriteit.
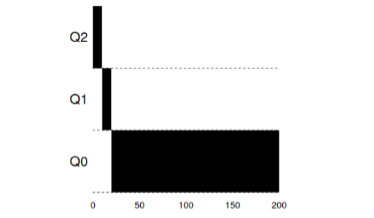
Voorbeeld 1: Een enkele langdurige taak
Zoals zichtbaar in dit voorbeeld, wordt de taak bij binnenkomst met de hoogste
prioriteit ingesteld. Na een tijdvenster van 10 ms wordt de prioriteit
door de planner verlaagd. Na het volgende tijdvenster wordt de taak eindelijk verlaagd naar
de laagste prioriteit in het systeem, waar deze blijft.
Voorbeeld 2: Een korte taak afgeleverd
Laten we nu een voorbeeld bekijken van hoe MLFQ zal proberen zich te benaderen tot SJF. In dit
voorbeeld zijn er twee taken: A, die een langdurige taak is die constant
de CPU gebruikt, en B, die een korte interactieve taak is. Stel dat,
A werkte al enige tijd toen de taak B binnenkwam.
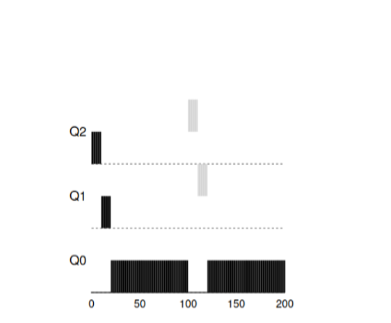
De resultaten van het scenario zijn zichtbaar in deze grafiek. Taak A, net als elke taak,
die CPU gebruikt, bevond zich onderaan. Taak B komt aan op tijd T=100 en zal
in de wachtrij met de hoogste prioriteit worden geplaatst. Aangezien de tijd die nodig is voor
deze taak kort is, zal ze klaar zijn voordat ze de laatste wachtrij bereikt.
Hieruit blijkt het belangrijkste doel van het algoritme: aangezien het algoritme niet
weet of een taak lang of kort is, neemt het eerst aan dat de taak
kort is en geeft deze de hoogste prioriteit. Als dit inderdaad een korte taak is, zal
ze snel worden uitgevoerd; anders, als het een lange taak is, zal ze langzaam afdalen
in prioriteit en zal spoedig bewijzen dat het inderdaad een langdurige taak is, die geen
respons vereist.
Voorbeeld 3: Wat betreft invoer en uitvoer?
Laten we nu eens kijken naar het voorbeeld met invoer en uitvoer. Zoals gesteld in regel 4b,
als een proces de CPU vrijgeeft zonder zijn procesortijd volledig te hebben gebruikt,
blijft het op hetzelfde prioriteitsniveau. De intenties van deze regel zijn vrij eenvoudig -
als een interactief taak veel invoer- en uitvoeroperaties uitvoert, bijvoorbeeld terwijl het
wacht op toetsaanslagen of muisklikken van de gebruiker, zal zo'n taak de CPU
eerder vrijgeven dan het toegekende venster. We willen deze taak niet verlagen in prioriteit,
en zo blijft deze op hetzelfde niveau.
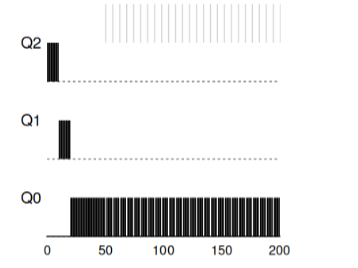
Dit voorbeeld laat zien hoe het algoritme werkt met dergelijke processen - interactief taak B, dat alleen 1 ms CPU nodig heeft voordat het
de invoer-uitvoersprocessen uitvoert, en langdurige taak A, die al zijn tijd aan CPU besteedt.
MLFQ houdt proces B op de hoogste prioriteit, omdat het continu de
CPU vrijgeeft. Als B een interactief taak is, dan heeft het algoritme in dat geval zijn
doel bereikt door interactieve taken snel te starten.
Problemen met het huidige MLFQ-algoritme
In de voorgaande voorbeelden hebben we een basisversie van MLFQ gebouwd. En het lijkt erop dat het
zijn werk goed en eerlijk doet door processortijd eerlijk te verdelen tussen
langdurige taken en snelle of invoer-intensieve taken snel te laten draaien. Helaas bevat deze aanpak verschillende
moet snel reageren op input-output. Helaas bevat deze aanpak verschillende
ernstige problemen.
Firstly, het probleem van honger: als er veel interactieve
taken in het systeem zijn, zullen ze al het CPU-tijd verbruiken en kan geen enkele lange
taak uitgevoerd worden (ze lijden honger).
Secondly, slimme gebruikers zouden hun programma's zo kunnen schrijven dat
ze de planner kunnen misleiden. De truc is om iets te doen dat ervoor zorgt dat
de planner de taak meer CPU-tijd toekent. Het algoritme dat
hierboven is beschreven is vrij kwetsbaar voor dergelijke aanvallen: voordat het tijdvenster bijna
is afgelopen, moet een invoer-output operatie worden uitgevoerd (met een, maakt niet uit welke, bestand)
en zo de CPU vrijmaken. Dergelijk gedrag zal ervoor zorgen dat men in dezelfde
wachtrij blijft en weer een groter percentage CPU-tijd ontvangt. Als je dit
op de juiste manier doet (bijvoorbeeld 99% van de tijd in het venster voor het vrijgeven van CPU),
kan zo'n taak eenvoudigweg de processor monopoliseren.
Ten slotte kan een programma zijn gedrag in de loop van de tijd veranderen. De taken,
die CPU gebruikten, kunnen interactief worden. In ons voorbeeld zouden dergelijke
taken niet goed worden behandeld door de planner, omdat ze andere
(oorspronkelijke) interactieve taken zouden hebben gekregen.
Vraag aan de zaal: welke aanvallen op de planner konden in de moderne wereld worden uitgevoerd?
Poging 2: Prioriteit verhogen
Laten we proberen de regels te veranderen en kijken of we de problemen met
honger kunnen vermijden. Wat kunnen we doen om te garanderen dat gerelateerde
CPU-taken hun tijd krijgen (ook al is het niet lang).
Een eenvoudige oplossing voor het probleem zou kunnen zijn om periodiek
de prioriteit van al deze taken in het systeem te verhogen. Er zijn veel manieren
om dit te bereiken, laten we als voorbeeld iets eenvoudigs proberen: alle
taken onmiddellijk naar de hoogste prioriteit te vertalen, vandaar de nieuwe regel:
- Regel5: Na een bepaalde periode S alle taken in het systeem naar de hoogste wachtrij te verplaatsen.
Onze nieuwe regel lost twee problemen tegelijk op. Ten eerste, processen
lijden gegarandeerd geen honger: taken die zich in de hoogste wachtrij bevinden zullen het
CPU-tijd delen volgens het RR-algoritme en zo zullen alle processen krijgen
verwerktijd. Ten eerste, als een proces dat eerder alleen de CPU gebruikte
interactief wordt, blijft het in de wachtrij met een hogere prioriteit
nadat het eenmaal een prioriteitsverhoging naar de hoogste heeft gekregen.
Laten we een voorbeeld bekijken. In dit scenario bekijken we één proces dat
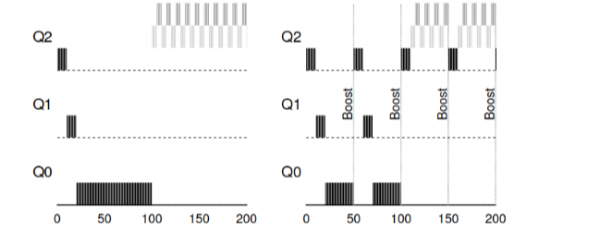
CPU gebruikt en twee interactieve, korte processen. Links in de afbeelding toont het beeld het gedrag zonder prioriteitsverhoging, en zo begint de lange taak te verhongeren na de komst van de twee interactieve taken in het systeem. In de afbeelding rechts vindt elke 50 ms een prioriteitsverhoging plaats, zodat alle processen gegarandeerd CPU-tijd krijgen en periodiek worden uitgevoerd. 50 ms is in dit geval ter illustratie genomen, in werkelijkheid is dit aantal iets hoger.
Het is duidelijk dat de toevoeging van de tijd voor periodieke verhoging S leidt tot
de relevante vraag: welke waarde moet worden ingesteld? Een van de gerespecteerde
systeemingenieurs, John Ousterhout, noemde dergelijke grootheden in systemen voo-doo
constanten, omdat ze op een bepaalde manier een soort zwarte magie vereisten voor de correcte
instelling. En helaas heeft S die geur. Als de waarde te hoog wordt ingesteld,
beginnen lange taken te verhongeren. En als de waarde te laag is ingesteld,
krijgen interactieve taken niet voldoende CPU-tijd.
Poging 3: Betere tijdregistratie
Nu hebben we nog een probleem dat moet worden opgelost: hoe voorkomen
we dat onze planner wordt bedrogen? De schuldigen aan deze mogelijkheid zijn
regels 4a, 4b, die het mogelijk maken dat een taak zijn prioriteit behoudt door de CPU
vrij te geven voordat de toegewezen tijd is verstreken. Hoe gaan we hiermee om?
De oplossing in dit geval kan worden beschouwd als een betere registratie van de CPU-tijd op elk
niveau van MLFQ. In plaats van de tijd te vergeten die het programma heeft gebruikt
voor de toegewezen periode, moet deze worden genoteerd en behouden. Nadat
een proces zijn toegewezen tijd heeft verbruikt, moet het naar het volgende
prioriteitsniveau worden verlaagd. Het maakt nu niet uit hoe het proces zijn tijd gebruikt — of
constant berekeningen uitvoerend op de CPU of door meerdere aanroepen. Dus,
regel 4 moet als volgt worden herschreven:
- Regel4: Nadat een taak de toegewezen tijd in de huidige wachtrij heeft verbruikt (ongeacht hoe vaak deze de CPU heeft vrijgegeven), wordt de prioriteit van die taak verlaagd (deze beweegt omlaag in de wachtrij).
Laten we een voorbeeld bekijken:
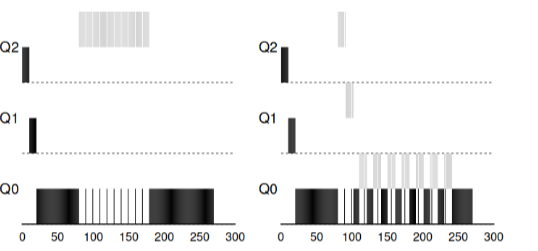 »
In de afbeelding wordt getoond wat er gebeurt als je de planner probeert te bedriegen, zoals
als het was met de vorige regels 4a, 4b, dan krijg je het resultaat aan de linkerkant. Met de nieuwe
regel — het resultaat rechts. Voor de bescherming kon elk proces I/O aanroepen tot het was voltooid en
kon het zo de CPU domineren, na de inschakeling van de bescherming, ongeacht het gedrag
van de I/O, zal het nog steeds omlaag in de wachtrijen gaan en zal het dus de CPU-resources niet onterecht
kunnen verwerven.
Verbetering van MLFQ en andere problemen
Met de bovengenoemde verbeteringen ontstaan nieuwe problemen: een van de belangrijkste
vragen is — hoe deze planner te parametriseren? Dat wil zeggen, hoeveel zouden er moeten zijn
wachtrijen? Wat moet de grootte van het werkvenster binnen de wachtrij zijn? Hoe
vaak moet de prioriteit van een programma worden verhoogd om hongerigheid te voorkomen en
rekening te houden met veranderend gedrag van het programma? Voor deze vragen is er geen eenvoudig
antwoord en alleen experimenten met belastingen en daaropvolgende configuratie
van de planner kunnen leiden tot een zekere bevredigende balans.
Bijvoorbeeld, de meeste implementaties van MLFQ staan verschillende
tijdduren toe voor verschillende wachtrijen. Hoogprioritaire wachtrijen krijgen meestal
korte intervallen. Deze wachtrijen bestaan uit interactieve taken,
waarbij het wisselen tussen hen vrij gevoelig is en 10 ms of minder moet duren.
In tegenstelling tot laagprioritaire wachtrijen, die bestaan uit lange taken die gebruikmaken van
de CPU. En in dit geval zijn lange tijdduren zeer geschikt (100 ms).
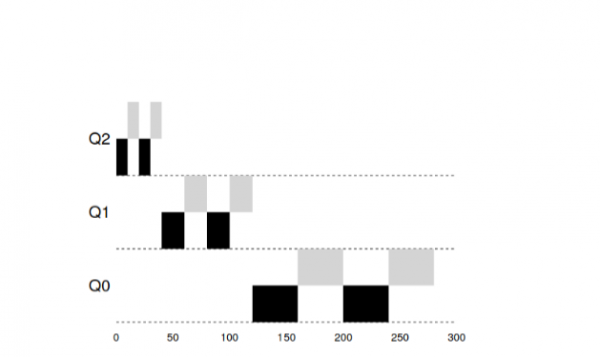
In dit voorbeeld zijn er 2 taken die 20 ms in de hoogprioritaire wachtrij hebben gewerkt, verdeeld in vensters van 10 ms. 40 ms in de gemiddelde wachtrij (venster van 20 ms) en in de laagprioritaire
wachtrij was het tijdvenster 40 ms, waar de taken hun werk voltooide.
De implementatie van MLFQ in het Solaris-besturingssysteem - een klasse van planningsalgoritmes die in de tijd splitsen.
De planner biedt een set tabellen die precies definiëren hoe de prioriteit van een proces moet
veranderen gedurende zijn levensduur, wat de grootte moet zijn.
prioriteit van het proces kan veranderen gedurende zijn levenscyclus, wat de juiste omvang moet zijn
van het toegewezen venster en hoe vaak prioriteiten voor taken moeten worden verhoogd. De administrator
van het systeem kan interactie hebben met deze tabel en de planner dwingen zich
anders te gedragen. Standaard heeft deze tabel 60 wachtrijen met een geleidelijke verhoging
van de venstergrootte van 20 ms (hoge prioriteit) tot enkele honderden ms (lage prioriteit), en
ook een boost voor alle taken eenmaal per seconde.
Andere MLFQ-planners gebruiken geen tabel of specifieke
regels die in deze lezing zijn beschreven, in plaats daarvan berekenen ze prioriteiten met behulp van
wiskundige formules. Zo gebruikt de planner in FreeBSD een formule om
de huidige prioriteit van een taak te berekenen, gebaseerd op hoeveel de processor
de CPU heeft gebruikt. Bovendien vergaat het CPU-gebruik in de loop van de tijd, en op die manier
vindt prioriteitsverhoging iets anders plaats dan hierboven beschreven. Dit zijn de
zogenaamde decay-algoritmen. Sinds versie 7.1 gebruikt FreeBSD de ULE-planner.
Ten slotte hebben veel planners andere kenmerken. Bijvoorbeeld, sommige
planners reserveren de hoogste niveaus voor het werk van het besturingssysteem, zodat
geen enkele gebruikersproces de hoogste prioriteit in
het systeem kan krijgen. Sommige systemen staan toe om adviezen te geven om de planner
te helpen prioriteiten correct in te stellen. Zo kan men bijvoorbeeld met het commando nice
de prioriteit van een taak verhogen of verlagen, en zo de kansen van het programma op CPU-tijd verhogen of
verlagen.
MLFQ: Samenvatting
We hebben een planningsaanpak beschreven die MLFQ wordt genoemd. De naam
heeft te maken met de werking ervan — het heeft meerdere wachtrijen en gebruikt feedback
om de prioriteit van taken te bepalen.
De uiteindelijke set regels is als volgt:
- Regel1: Als prioriteit(A) > Prioriteit(B), zal taak A worden uitgevoerd (B niet)
- Regel2: Als prioriteit(A) = Prioriteit(B), worden A en B uitgevoerd met behulp van RR
- Regel3: Wanneer een taak het systeem binnenkomt, wordt deze in de wachtrij met de hoogste prioriteit geplaatst.
- Regel4: Nadat een taak de toegewezen tijd in de huidige wachtrij heeft verbruikt (ongeacht hoe vaak deze de CPU heeft vrijgegeven), wordt de prioriteit van die taak verlaagd (deze beweegt omlaag in de wachtrij).
- Regel5: Na een bepaalde periode S alle taken in het systeem naar de hoogste wachtrij te verplaatsen.
MLFQ is interessant om de volgende reden — in plaats van vooraf kennis te vereisen over
de aard van de taak, leert het algoritme van het eerder gedrag van de taak en stelt het in.
de prioriteiten dienovereenkomstig. Zo probeert hij tegelijkertijd op twee stoelen te zitten — prestaties te behalen voor kleine taken (SJF, STCF) en eerlijk grote,
CPU-belastende taken te verwerken. Daarom gebruiken veel systemen, waaronder BSD en hun afgeleiden,
Solaris, Windows, Mac een bepaalde vorm van algoritme
MLFQ als basis.
Extra materialen:
- (computing)
Bron: habr.com
