

Of wat praktische tetris-ologie.
Alles nieuwe is goed vergeten oud.
Epigrafen.
Taakstelling
Het is nodig om periodiek het huidige logbestand van PostgreSQL van de AWS-cloud op een lokale Linux-host te laden. Niet in realtime, maar laten we zeggen met een kleine vertraging.
De laadperiode van het logbestand is 5 minuten.
Het logbestand in AWS draait elke uur.
Gebruikte tools
Voor het laden van het logbestand op de host wordt een bash-script gebruikt dat de AWS API aanroept:».
Parameters:
- —db-instance-identifier: De naam van de instance in AWS;
- —log-file-name: de naam van het huidige gegenereerde logbestand
- —max-item: Het totale aantal items dat door de opdrachtoutput wordt geretourneerd.Grootte van de te downloaden bestandsgedeelte.
- —starting-token: De startlabel van de gedeelten
In dit specifieke geval is de taak om de logs te downloaden ontstaan tijdens het werken aan
En gewoon — een interessante taak, voor training en variatie in de loop van de werkdag.
Ik neem aan dat de taak vanwege de alledaagsheid al is opgelost. Maar een snelle Google-oplossing gaf geen antwoorden, en verder zoeken had ik niet echt de neiging. Hoe dan ook — een goede training.
Formalizatie van de taak
Het uiteindelijke logbestand bestaat uit een reeks regels van variabele lengte. Grafisch kan het logbestand ongeveer zo worden weergegeven:
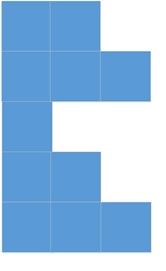
Herinnert dit al iets? Wat heeft 'tetris' hiermee te maken? Nou, dat.
Als we de mogelijke varianten die optreden bij het laden van elk bestand grafisch voorstellen (om het eenvoudig te houden, laten we zeggen dat de regels een lengte hebben), krijgen we de standaard tetris-vormen:
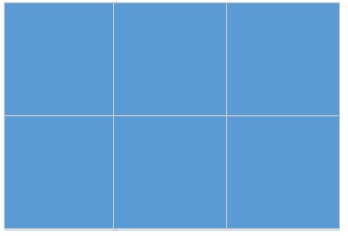
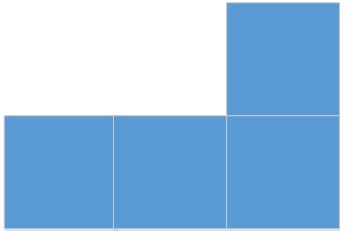
1) Het bestand is volledig geladen en is definitief. De grootte van het gedeelte is groter dan de grootte van het eindbestand:
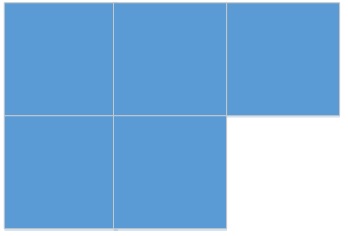
2) Het bestand heeft een vervolg. De grootte van het gedeelte is kleiner dan de grootte van het eindbestand:
3) Het bestand is een voortzetting van het vorige bestand en heeft een vervolg. De grootte van het gedeelte is kleiner dan de rest van het eindbestand:
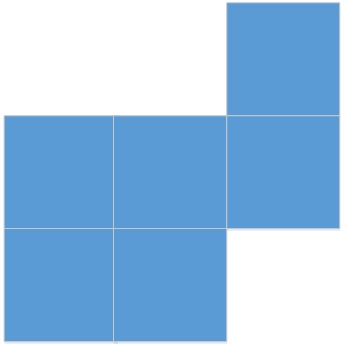
4) Het bestand is een voortzetting van het vorige bestand en is definitief. De grootte van het gedeelte is groter dan de rest van het eindbestand:
De taak is om een rechthoek te verzamelen of een beetje tetris te spelen, op een nieuw niveau.
Problemen die zich voordoen tijdens het oplossen van de taak
1) Een regel samenvoegen uit 2 gedeelten
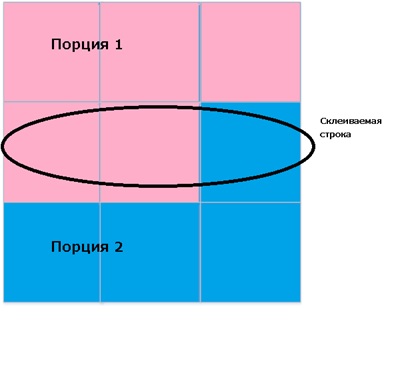
In feite zijn er geen bijzondere problemen opgetreden. Een standaard taak uit de inleidende programmeercursus.
Optimale grootte van het gedeelte
Dit is iets interessanter.
Helaas is het niet mogelijk om een offset toe te passen na de starttoken:
Zoals je al weet, wordt de optie —starting-token gebruikt om te specificeren waar paginering begint. Deze optie neemt String-waarden aan, wat betekent dat als je probeert een offsetwaarde voor de Next Token-string toe te voegen, de optie niet als een offset zal worden beschouwd.
En daarom moet je in stukken lezen.
Als je in grote porties leest, is het aantal keren dat je leest minimaal, maar het volume maximaal.
Als je in kleine porties leest, is het aantal keren dat je leest maximaal, maar is het volume minimaal.
Daarom moest er, om het verkeer te verminderen en voor de algehele netheid van de oplossing, een soort oplossing worden bedacht, die helaas een beetje als een hack overkomt.
Ter illustratie, laten we het proces van het uploaden van een logbestand bekijken in twee sterk vereenvoudigde varianten. Het aantal lezingen in beide gevallen hangt af van de grootte van de portie.
1) Laten we in kleine porties uploaden:
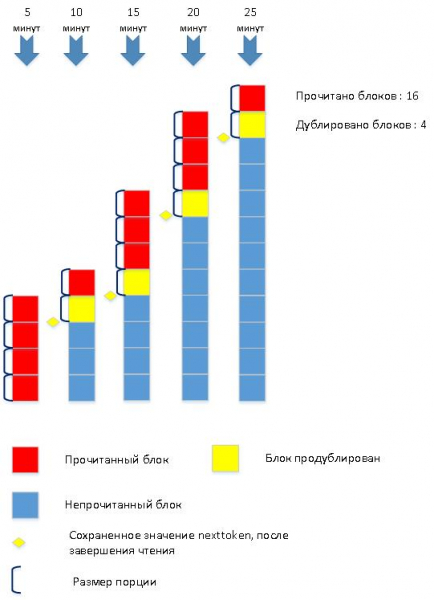
2) Laten we in grote porties uploaden:
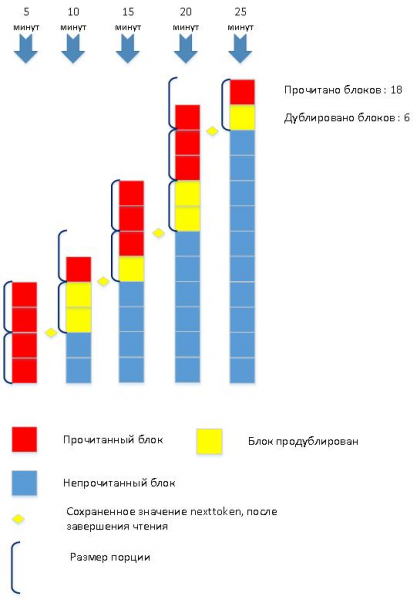
Zoals gebruikelijk is de optimale oplossing het midden..
De portiegrootte is minimaal, maar tijdens het lezen kan de grootte worden vergroot om het aantal lezingen te verminderen.
Het moet worden opgemerkt, dat de taak om de optimale grootte van de leesportie te bepalen nog niet is opgelost en verdere ontwikkeling en analyse vereist. Misschien later.
Algemene beschrijving van de implementatie
Gebruikte servicetabellen
CREATE TABLE endpoint
(
id SERIAL ,
host text
);

TABLE database
(
id SERIAL ,
…
last_aws_log_time text ,
last_aws_nexttoken text ,
aws_max_item_size integer
);
last_aws_log_time — tijdstempel van het laatst geüpload logbestand in het formaat YYYY-MM-DD-HH24.
last_aws_nexttoken — tekstuele marker van de laatste geüploade portie.
aws_max_item_size - empirisch bepaald initiële portiegrootte.
Volledige tekst van het script
download_aws_piece.sh
#!/bin/bash
#########################################################
# download_aws_piece.sh
# downloan piece of log from AWS
# version HABR
 let min_item_size=1024
 let max_item_size=1048576
 let growth_factor=3
 let growth_counter=1
 let growth_counter_max=3

 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:''STARTED'

 AWS_LOG_TIME=$1
 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:AWS_LOG_TIME='$AWS_LOG_TIME

 database_id=$2
 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:database_id='$database_id
 RESULT_FILE=$3

 endpoint=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE_DATABASE -A -t -c "select e.host from endpoint e join database d on e.id = d.endpoint_id where d.id = $database_id "`
 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:endpoint='$endpoint

 db_instance=`echo $endpoint | awk -F"." '{print toupper($1)}'`

 echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:db_instance='$db_instance

 LOG_FILE=$RESULT_FILE'.tmp_log'
 TMP_FILE=$LOG_FILE'.tmp'
 TMP_MIDDLE=$LOG_FILE'.tmp_mid'
 TMP_MIDDLE2=$LOG_FILE'.tmp_mid2'

 current_aws_log_time=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -c "select last_aws_log_time from database where id = $database_id "`

 echo $(date +%Y%m%d%H%M)':      download_aws_piece.sh:current_aws_log_time='$current_aws_log_time

  if [[ $current_aws_log_time != $AWS_LOG_TIME  ]];
  then
    is_new_log='1'
	if ! psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -q -c "update database set last_aws_log_time = '$AWS_LOG_TIME' where id = $database_id "
	then
	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - update database set last_aws_log_time .'
	  exit 1
	fi
  else
    is_new_log='0'
  fi

  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:is_new_log='$is_new_log

  let last_aws_max_item_size=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -c "select aws_max_item_size from database where id = $database_id "`
  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: last_aws_max_item_size='$last_aws_max_item_size

  let count=1
  if [[ $is_new_log == '1' ]];
  then
	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: START DOWNLOADING OF NEW AWS LOG'
	if ! aws rds download-db-log-file-portion
		--max-items $last_aws_max_item_size
		--region REGION
		--db-instance-identifier  $db_instance
		--log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 2
	fi
  else
    next_token=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -c "select last_aws_nexttoken from database where id = $database_id "`

	if [[ $next_token == '' ]];
	then
	  next_token='0'
	fi

	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: CONTINUE DOWNLOADING OF AWS LOG'
	if ! aws rds download-db-log-file-portion
	    --max-items $last_aws_max_item_size
		--starting-token $next_token
		--region REGION
		--db-instance-identifier  $db_instance
		--log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 3
	fi

	line_count=`cat  $LOG_FILE | wc -l`
	let lines=$line_count-1

	tail -$lines $LOG_FILE > $TMP_MIDDLE
	mv -f $TMP_MIDDLE $LOG_FILE
  fi

  next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
  next_token=`echo $next_token_str | awk -F" " '{ print $2}' `

  grep -v NEXTTOKEN $LOG_FILE  > $TMP_FILE

  if [[ $next_token == '' ]];
  then
	  cp $TMP_FILE $RESULT_FILE

	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:  NEXTTOKEN NOT FOUND - FINISH '
	  rm $LOG_FILE
	  rm $TMP_FILE
	  rm $TMP_MIDDLE
          rm $TMP_MIDDLE2
	  exit 0
  else
	psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -q -c "update database set last_aws_nexttoken = '$next_token' where id = $database_id "
  fi

  first_str=`tail -1 $TMP_FILE`

  line_count=`cat  $TMP_FILE | wc -l`
  let lines=$line_count-1

  head -$lines $TMP_FILE  > $RESULT_FILE

###############################################
# MAIN CIRCLE
  let count=2
  while [[ $next_token != '' ]];
  do
    echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: count='$count

	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: START DOWNLOADING OF AWS LOG'
	if ! aws rds download-db-log-file-portion
             --max-items $last_aws_max_item_size
             --starting-token $next_token
             --region REGION
             --db-instance-identifier  $db_instance
             --log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 4
	fi

	next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
	next_token=`echo $next_token_str | awk -F" " '{ print $2}' `

	TMP_FILE=$LOG_FILE'.tmp'
	grep -v NEXTTOKEN $LOG_FILE  > $TMP_FILE

	last_str=`head -1 $TMP_FILE`

    if [[ $next_token == '' ]];
	then
	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  tail -$lines $TMP_FILE >> $RESULT_FILE

	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:  NEXTTOKEN NOT FOUND - FINISH '
	  rm $LOG_FILE
	  rm $TMP_FILE
	  rm $TMP_MIDDLE
          rm $TMP_MIDDLE2
	  exit 0
	fi

    if [[ $next_token != '' ]];
	then
		let growth_counter=$growth_counter+1
		if [[ $growth_counter -gt $growth_counter_max ]];
		then
			let last_aws_max_item_size=$last_aws_max_item_size*$growth_factor
			let growth_counter=1
		fi

		if [[ $last_aws_max_item_size -gt $max_item_size ]];
		then
			let last_aws_max_item_size=$max_item_size
		fi

	  psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -q -c "update database set last_aws_nexttoken = '$next_token' where id = $database_id "

	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  #############################
	  #Get middle of file
	  head -$lines $TMP_FILE > $TMP_MIDDLE

	  line_count=`cat  $TMP_MIDDLE | wc -l`
	  let lines=$line_count-1
	  tail -$lines $TMP_MIDDLE > $TMP_MIDDLE2

	  cat $TMP_MIDDLE2 >> $RESULT_FILE

	  first_str=`tail -1 $TMP_FILE`
	fi

    let count=$count+1

  done
#
#################################################################

exit 0
Fragmenten van het script met enkele toelichtingen:
Ingangsparameters van het script:
- Tijdstempel van de logbestandsnaam in het formaat YYYY-MM-DD-HH24: AWS_LOG_TIME=$1
- Database-ID: database_id=$2
- Naam van het gecompileerde logbestand: RESULT_FILE=$3
Verkrijg de tijdstempel van het laatst geüpload logbestand:
current_aws_log_time=`psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -c "select last_aws_log_time from database where id = $database_id "`Als de tijdstempel van het laatst geüpload logbestand niet overeenkomt met de ingangparameter, wordt er een nieuw logbestand geüpload:
als [[ $current_aws_log_time != $AWS_LOG_TIME ]];
  dan
    is_new_log='1'
	als ! psql -h ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -v ON_ERROR_STOP=1 -A -t -c "update database set last_aws_log_time = '$AWS_LOG_TIME' where id = $database_id "
	dan
	  echo '***download_aws_piece.sh -FATAL_ERROR - update database set last_aws_log_time .'
	  exit 1
	fi
  anders
    is_new_log='0'
  fi
We halen de waarde van de tag nexttoken uit het geüploade bestand:
  next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
  next_token=`echo $next_token_str | awk -F" " '{ print $2}' `
Een lege waarde van nexttoken duidt het einde van de upload aan.
In de lus tellen we de porties van het bestand, terwijl we de regels aan elkaar koppelen en de grootte van de portie vergroten:
Hoofdlus
# MAIN CIRCLE
  let count=2
  while [[ $next_token != '' ]];
  do
    echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: count='$count

	echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: START DOWNLOADING OF AWS LOG'
	if ! aws rds download-db-log-file-portion
     --max-items $last_aws_max_item_size
	 --starting-token $next_token
     --region REGION
     --db-instance-identifier  $db_instance
     --log-file-name error/postgresql.log.$AWS_LOG_TIME > $LOG_FILE
	then
		echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh: FATAL_ERROR - Could not get log from AWS .'
		exit 4
	fi

	next_token_str=`cat $LOG_FILE | grep NEXTTOKEN`
	next_token=`echo $next_token_str | awk -F" " '{ print $2}' `

	TMP_FILE=$LOG_FILE'.tmp'
	grep -v NEXTTOKEN $LOG_FILE  > $TMP_FILE

	last_str=`head -1 $TMP_FILE`

    if [[ $next_token == '' ]];
	then
	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  tail -$lines $TMP_FILE >> $RESULT_FILE

	  echo $(date +%Y%m%d%H%M)':    download_aws_piece.sh:  NEXTTOKEN NOT FOUND - FINISH '
	  rm $LOG_FILE
	  rm $TMP_FILE
	  rm $TMP_MIDDLE
         rm $TMP_MIDDLE2
	  exit 0
	fi

    if [[ $next_token != '' ]];
	then
		let growth_counter=$growth_counter+1
		if [[ $growth_counter -gt $growth_counter_max ]];
		then
			let last_aws_max_item_size=$last_aws_max_item_size*$growth_factor
			let growth_counter=1
		fi

		if [[ $last_aws_max_item_size -gt $max_item_size ]];
		then
			let last_aws_max_item_size=$max_item_size
		fi

	  psql -h MONITOR_ENDPOINT.rds.amazonaws.com -U USER -d MONITOR_DATABASE -A -t -q -c "update database set last_aws_nexttoken = '$next_token' where id = $database_id "

	  concat_str=$first_str$last_str

	  echo $concat_str >> $RESULT_FILE

	  line_count=`cat  $TMP_FILE | wc -l`
	  let lines=$line_count-1

	  #############################
	  #Get middle of file
	  head -$lines $TMP_FILE > $TMP_MIDDLE

	  line_count=`cat  $TMP_MIDDLE | wc -l`
	  let lines=$line_count-1
	  tail -$lines $TMP_MIDDLE > $TMP_MIDDLE2

	  cat $TMP_MIDDLE2 >> $RESULT_FILE

	  first_str=`tail -1 $TMP_FILE`
	fi

    let count=$count+1

  done
En wat nu?
Zo, de eerste tussenliggende taak - 'uploaden van het logbestand vanuit de cloud' is opgelost. Wat te doen met het geüploade log?
Als eerste moet het logbestand worden geanalyseerd en moeten de daadwerkelijke verzoeken eruit worden gehaald.
De taak is niet al te ingewikkeld. Een eenvoudige bash-script kan dit prima aan.
upload_log_query.sh
#!/bin/bash
#########################################################
# upload_log_query.sh
# Upload table table from dowloaded aws file
# version HABR
###########################################################
echo 'TIMESTAMP:'$(date +%c)' Upload log_query table '
source_file=$1
echo 'source_file='$source_file
database_id=$2
echo 'database_id='$database_id

beginer=' '
first_line='1'
let "line_count=0"
sql_line=' '
sql_flag=' '
space=' '
cat $source_file | while read line
do
  line="$space$line"

  if [[ $first_line == "1" ]]; then
    beginer=`echo $line | awk -F" " '{ print $1}' `
    first_line='0'
  fi

  current_beginer=`echo $line | awk -F" " '{ print $1}' `

  if [[ $current_beginer == $beginer ]]; then
    if [[ $sql_flag == '1' ]]; then
     sql_flag='0'
     log_date=`echo $sql_line | awk -F" " '{ print $1}' `
     log_time=`echo $sql_line | awk -F" " '{ print $2}' `
     duration=`echo $sql_line | awk -F" " '{ print $5}' `

     #replace ' to ''
     sql_modline=`echo "$sql_line" | sed 's/'''/''''''/g'`
     sql_line=' '

	 ################
	 #PROCESSING OF THE SQL-SELECT IS HERE
     if ! psql -h ENDPOINT.rds.amazonaws.com -U USER -d DATABASE -v ON_ERROR_STOP=1 -A -t -c "select log_query('$ip_port',$database_id , '$log_date' , '$log_time' , '$duration' , '$sql_modline' )"
     then
        echo 'FATAL_ERROR - log_query '
        exit 1
     fi
	 ################

    fi #if [[ $sql_flag == '1' ]]; then

    let "line_count=line_count+1"

    check=`echo $line | awk -F" " '{ print $8}' `
    check_sql=${check^^}

    #echo 'check_sql='$check_sql

    if [[ $check_sql == 'SELECT' ]]; then
     sql_flag='1'
     sql_line="$sql_line$line"
	 ip_port=`echo $sql_line | awk -F":" '{ print $4}' `
    fi
  else

    if [[ $sql_flag == '1' ]]; then
      sql_line="$sql_line$line"
    fi

  fi #if [[ $current_beginer == $beginer ]]; then

done
Nu, met het verzoek dat uit het logbestand is gehaald, kan er mee worden gewerkt.
En er zijn verschillende nuttige mogelijkheden beschikbaar.
De geanalyseerde verzoeken moeten ergens worden opgeslagen. Hiervoor gebruiken we een service tabel log_query
CREATE TABLE log_query
(
   id SERIAL,
   queryid bigint,
   query_md5hash text not null,
   database_id integer not null,
   timepoint timestamp without time zone not null,
   duration double precision not null,
   query text not null,
   explained_plan text[],
   plan_md5hash text,
   explained_plan_wo_costs text[],
   plan_hash_value text,
   baseline_id integer,
   ip text,
   port text
);
ALTER TABLE log_query ADD PRIMARY KEY (id);
ALTER TABLE log_query ADD CONSTRAINT queryid_timepoint_unique_key UNIQUE (queryid, timepoint);
ALTER TABLE log_query ADD CONSTRAINT query_md5hash_timepoint_unique_key UNIQUE (query_md5hash, timepoint);

CREATE INDEX log_query_timepoint_idx ON log_query (timepoint);
CREATE INDEX log_query_queryid_idx ON log_query (queryid);
ALTER TABLE log_query ADD CONSTRAINT database_id_fk FOREIGN KEY (database_id) REFERENCES database (id) ON DELETE CASCADE;
De verwerking van het geanalyseerde verzoek vindt plaats in plpgsql functie 'log_query».
log_query.sql
--log_query.sql
--versie HABR
CREATE OR REPLACE FUNCTION log_query( ip_port text ,log_database_id integer , log_date text , log_time text , duration text , sql_line text   ) RETURNS boolean AS $$
DECLARE
  result boolean ;
  log_timepoint timestamp without time zone ;
  log_duration double precision ;
  pos integer ;
  log_query text ;
  activity_string text ;
  log_md5hash text ;
  log_explain_plan text[] ;

  log_planhash text ;
  log_plan_wo_costs text[] ;

  database_rec record ;

  pg_stat_query text ;
  test_log_query text ;
  log_query_rec record;
  found_flag boolean;

  pg_stat_history_rec record ;
  port_start integer ;
  port_end integer ;
  client_ip text ;
  client_port text ;
  log_queryid bigint ;
  log_query_text text ;
  pg_stat_query_text text ;
BEGIN
  result = TRUE ;

  RAISE NOTICE '***log_query';

  port_start = position('(' in ip_port);
  port_end = position(')' in ip_port);
  client_ip = substring( ip_port from 1 for port_start-1 );
  client_port = substring( ip_port from port_start+1 for port_end-port_start-1 );

  SELECT e.host , d.name , d.owner_pwd
  INTO database_rec
  FROM database d JOIN endpoint e ON e.id = d.endpoint_id
  WHERE d.id = log_database_id ;

  log_timepoint = to_timestamp(log_date||' '||log_time,'YYYY-MM-DD HH24-MI-SS');
  log_duration = duration:: double precision;


  pos = position ('SELECT' in UPPER(sql_line) );
  log_query = substring( sql_line from pos for LENGTH(sql_line));
  log_query = regexp_replace(log_query,' +',' ','g');
  log_query = regexp_replace(log_query,';+','','g');
  log_query = trim(trailing ' ' from log_query);


  log_md5hash = md5( log_query::text );

  --Explain uitvoeringsplan--
  EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||database_rec.host||' dbname='||database_rec.name||' user=DATABASE password='||database_rec.owner_pwd||' '')';

  log_explain_plan = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN '||log_query ) AS t (plan text) );
  log_plan_wo_costs = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN ( COSTS FALSE ) '||log_query ) AS t (plan text) );

  PERFORM dblink_disconnect('LINK1');
  --------------------------
  BEGIN
	INSERT INTO log_query
	(
		query_md5hash ,
		database_id ,
		timepoint ,
		duration ,
		query ,
		explained_plan ,
		plan_md5hash ,
		explained_plan_wo_costs ,
		plan_hash_value ,
		ip ,
		port
	)
	VALUES
	(
		log_md5hash ,
		log_database_id ,
		log_timepoint ,
		log_duration ,
		log_query ,
		log_explain_plan ,
		md5(log_explain_plan::text) ,
		log_plan_wo_costs ,
		md5(log_plan_wo_costs::text),
		client_ip ,
		client_port
	);
	activity_string = 	'Nieuwe query is gelogd '||
						' database_id = '|| log_database_id ||
						' query_md5hash='||log_md5hash||
						' , tijdstip = '||to_char(log_timepoint,'YYYYMMDD HH24:MI:SS');

	RAISE NOTICE '%',activity_string;

	PERFORM pg_log( log_database_id , 'log_query' , activity_string);

	EXCEPTION
	  WHEN unique_violation THEN
		RAISE NOTICE '*** unique_violation *** query is al gelogd';
	END;

	SELECT 	queryid
	INTO   	log_queryid
	FROM 	log_query
	WHERE 	query_md5hash = log_md5hash AND
			timepoint = log_timepoint;

	IF log_queryid IS NOT NULL
	THEN
	  RAISE NOTICE 'log_query met query_md5hash = % en tijdstip = % heeft al een QUERYID = %',log_md5hash,log_timepoint , log_queryid ;
	  RETURN result;
	END IF;

	------------------------------------------------
	RAISE NOTICE 'Update queryid';

	SELECT *
	INTO log_query_rec
	FROM log_query
	WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;

	log_query_rec.query=regexp_replace(log_query_rec.query,';+','','g');

	FOR pg_stat_history_rec IN
	 SELECT
         queryid ,
	  query
	 FROM
         pg_stat_db_queries
     WHERE
      database_id = log_database_id AND
       queryid is not null
	LOOP
	  pg_stat_query = pg_stat_history_rec.query ;
	  pg_stat_query=regexp_replace(pg_stat_query,'n+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'t+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,' +',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'$.','%','g');

	  log_query_text = trim(trailing ' ' from log_query_rec.query);
	  pg_stat_query_text = pg_stat_query;


	  --SELECT log_query_rec.query like pg_stat_query INTO found_flag ;
	  IF (log_query_text LIKE pg_stat_query_text) THEN
		found_flag = TRUE ;
	  ELSE
		found_flag = FALSE ;
	  END IF;


	  IF found_flag THEN

		UPDATE log_query SET queryid = pg_stat_history_rec.queryid WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;
		activity_string = 	' bijgewerkte queryid = '||pg_stat_history_rec.queryid||
		                    ' voor log_query met id = '||log_query_rec.id
		   				    ;
	    RAISE NOTICE '%',activity_string;
		EXIT ;
	  END IF ;

	END LOOP ;

  RETURN result ;
END
$$ LANGUAGE plpgsql;
Bij de verwerking wordt een servicetabel gebruikt pg_stat_db_queries, die een snapshot van de huidige verzoeken uit de tabel bevat pg_stat_history (Het gebruik van de tabel wordt hier beschreven — )
TABLE pg_stat_db_queries
(
   database_id integer,
   queryid bigint ,
   query text ,
   max_time double precision
);
TABLE pg_stat_history
(
…
database_id integer ,
…
queryid bigint ,
…
max_time double precision	 ,
…
);
De functie biedt een aantal nuttige mogelijkheden voor de verwerking van aanvragen uit het logbestand. Namelijk:
Mogelijkheid #1 — Historie van uitgevoerde aanvragen
Zeer nuttig voor het aanpakken van prestatie-incidenten. Begin met het bekijken van de geschiedenis — wanneer begon de vertraging?
Zoek daarna, zoals gebruikelijk, naar externe oorzaken. Misschien is de databasebelasting plotseling toegenomen en speelt die specifieke aanvraag geen rol.
Voeg een nieuw record toe aan de tabel log_query
  port_start = position('(' in ip_port);
  port_end = position(')' in ip_port);
  client_ip = substring( ip_port from 1 for port_start-1 );
  client_port = substring( ip_port from port_start+1 for port_end-port_start-1 );

  SELECT e.host , d.name , d.owner_pwd
  INTO database_rec
  FROM database d JOIN endpoint e ON e.id = d.endpoint_id
  WHERE d.id = log_database_id ;

  log_timepoint = to_timestamp(log_date||' '||log_time,'YYYY-MM-DD HH24-MI-SS');
  log_duration = to_number(duration,'99999999999999999999D9999999999');


  pos = position ('SELECT' in UPPER(sql_line) );
  log_query = substring( sql_line from pos for LENGTH(sql_line));
  log_query = regexp_replace(log_query,' +',' ','g');
  log_query = regexp_replace(log_query,';+','','g');
  log_query = trim(trailing ' ' from log_query);

  RAISE NOTICE 'log_query=%',log_query ;

  log_md5hash = md5( log_query::text );

  --Explain execution plan--
  EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||database_rec.host||' dbname='||database_rec.name||' user=DATABASE password='||database_rec.owner_pwd||' '')';

  log_explain_plan = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN '||log_query ) AS t (plan text) );
  log_plan_wo_costs = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN ( COSTS FALSE ) '||log_query ) AS t (plan text) );

  PERFORM dblink_disconnect('LINK1');
  --------------------------
  BEGIN
	INSERT INTO log_query
	(
		query_md5hash ,
		database_id ,
		timepoint ,
		duration ,
		query ,
		explained_plan ,
		plan_md5hash ,
		explained_plan_wo_costs ,
		plan_hash_value ,
		ip ,
		port
	)
	VALUES
	(
		log_md5hash ,
		log_database_id ,
		log_timepoint ,
		log_duration ,
		log_query ,
		log_explain_plan ,
		md5(log_explain_plan::text) ,
		log_plan_wo_costs ,
		md5(log_plan_wo_costs::text),
		client_ip ,
		client_port
	);
Mogelijkheid #2 — Bewaren van uitvoeringsplannen voor aanvragen
Op dit punt kan een bezwaar-verduidelijking-opmerking ontstaan: «Maar er is al autoexplain». Het is er wel, maar wat heeft het voor zin als het uitvoeringsplan in hetzelfde logbestand wordt opgeslagen en je dat logbestand moet parseren om het voor verdere analyse op te slaan?
Ik hoefde echter het volgende:
ten eerste: het uitvoeringsplan opslaan in een servicetabel van de monitoringsdatabase;
Ten tweede: de mogelijkheid hebben om uitvoeringsplannen met elkaar te vergelijken, zodat je direct kunt zien dat het uitvoeringsplan van de query is veranderd.
Er is een query met specifieke uitvoeringsparameters. Het verkrijgen en opslaan van het uitvoeringsplan met behulp van EXPLAIN is een eenvoudige taak.
Bovendien kan met de uitdrukking EXPLAIN (COSTS FALSE) een raamwerk voor het plan worden verkregen, dat zal worden gebruikt voor het verkrijgen van de hash-waarde van het plan, wat helpt bij de latere analyse van de geschiedenis van de wijziging van het uitvoeringsplan.
Het uitvoeringsplan sjabloon verkrijgen
  --Leg uitvoeringsplan uit--
  EXECUTE 'SELECT dblink_connect(''LINK1'',''host='||database_rec.host||' dbname='||database_rec.name||' user=DATABASE password='||database_rec.owner_pwd||' '')';

  log_explain_plan = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN '||log_query ) AS t (plan text) );
  log_plan_wo_costs = ARRAY ( SELECT * FROM dblink('LINK1', 'EXPLAIN ( COSTS FALSE ) '||log_query ) AS t (plan text) );

  PERFORM dblink_disconnect('LINK1');
Mogelijkheid #3 — Gebruik van querylogboeken voor monitoring
Aangezien de prestatie-indicatoren zijn ingesteld op de ID van de query en niet op de tekst ervan, moeten de queries uit het logboek worden gekoppeld aan de queries waarvoor de prestatie-indicatoren zijn ingesteld.
Althans om een nauwkeurig tijdstip van het voorval van de prestatie te hebben.
Dus, wanneer er zich een prestatie-incident voordoet voor de ID van de query, is er een verwijzing naar de specifieke query met specifieke parameterwaarden en de exacte tijd van uitvoering en duur van de query. Deze informatie verkrijgen kan alleen met behulp van de weergave pg_stat_statements — dat is niet mogelijk.
Zoek de queryid van de query en werk de record in de tabel log_query bij.
SELECT *
	INTO log_query_rec
	FROM log_query
	WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;

	log_query_rec.query=regexp_replace(log_query_rec.query,';+','','g');

	FOR pg_stat_history_rec IN
	 SELECT
      queryid ,
	  query
	 FROM
       pg_stat_db_queries
     WHERE
	   database_id = log_database_id AND
       queryid is not null
	LOOP
	  pg_stat_query = pg_stat_history_rec.query ;
	  pg_stat_query=regexp_replace(pg_stat_query,'n+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'t+',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,' +',' ','g');
	  pg_stat_query=regexp_replace(pg_stat_query,'$.','%','g');

	  log_query_text = trim(trailing ' ' from log_query_rec.query);
	  pg_stat_query_text = pg_stat_query;

	  --SELECT log_query_rec.query like pg_stat_query INTO found_flag ;
	  IF (log_query_text LIKE pg_stat_query_text) THEN
		found_flag = TRUE ;
	  ELSE
		found_flag = FALSE ;
	  END IF;


	  IF found_flag THEN

		UPDATE log_query SET queryid = pg_stat_history_rec.queryid WHERE query_md5hash = log_md5hash AND timepoint = log_timepoint ;
		activity_string = 	' updated queryid = '||pg_stat_history_rec.queryid||
		                    ' for log_query with id = '||log_query_rec.id
		   				    ;

	    RAISE NOTICE '%',activity_string;
		EXIT ;
	  END IF ;

	END LOOP ;
Naschrift
De beschreven methode heeft uiteindelijk haar toepassing gevonden in , waardoor er meer informatie beschikbaar is voor analyse bij het oplossen van performance-incidenten van query's.
Hoewel, vanuit mijn persoonlijke perspectief, er nog gewerkt moet worden aan het algoritme voor het kiezen en aanpassen van de grootte van de ingeladen portie. Deze taak is voorlopig nog niet in het algemeen geval opgelost. Het zal waarschijnlijk interessant zijn.
Maar dat is een heel ander verhaal …
Bron: habr.com
