

Hallo, Habr! Vandaag bouwen we een systeem dat met behulp van Spark Streaming berichtstromen van Apache Kafka verwerkt en de verwerkte resultaten opslaat in de clouddatabase AWS RDS.
Stel je voor dat een kredietorganisatie ons de taak geeft om inkomende transacties 'in real-time' te verwerken voor al zijn vestigingen. Dit kan worden gedaan om snel de open valutaposities voor de schatkist, limieten of financiële resultaten van transacties, enzovoorts, te berekenen.
Hoe we deze case zonder magie en toverspreuken kunnen implementeren — lees verder! Laten we beginnen!
Inleiding
Zeker, het verwerken van grote datasets in real-time biedt uitgebreide mogelijkheden voor gebruik in moderne systemen. Een van de populairste combinaties hiervoor is het tandem van Apache Kafka en Spark Streaming, waarbij Kafka een stroom van binnenkomende berichten creëert en Spark Streaming deze berichten verwerkt over een gedefinieerde tijdsinterval.
Om de fouttolerantie van de applicatie te verhogen, zullen we controlepunten - checkpoints - gebruiken. Met dit mechanisme, wanneer de Spark Streaming-module verloren gegevens moet herstellen, hoeft hij alleen maar terug te keren naar het laatste controlepunt en de berekeningen vanaf dat punt te hervatten.
Architectuur van het ontwikkelde systeem
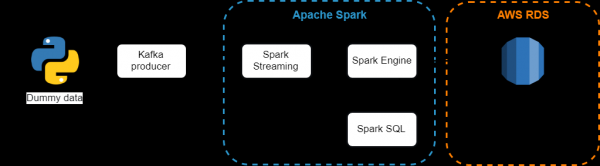
Gebruikte componenten:
- — is een gedistribueerd berichtsysteem met publiceren en abonneren. Het is geschikt voor zowel offline als online consumptie van berichten. Om dataverlies te voorkomen, worden Kafka-berichten op schijf opgeslagen en binnen het cluster gerepliceerd. Het Kafka-systeem is gebouwd bovenop de synchronisatiedienst ZooKeeper;
- — de Spark-component voor het verwerken van streaminggegevens. De Spark Streaming-module is opgebouwd met behulp van een 'micro-batch'-architectuur, waarbij een gegevensstroom wordt geïnterpreteerd als een continue reeks kleine gegevenspakketten. Spark Streaming ontvangt gegevens uit verschillende bronnen en combineert deze in kleine pakketten. Nieuwe pakketten worden gemaakt op regelmatige tijdsintervallen. Aan het begin van elk tijdsinterval wordt een nieuw pakket aangemaakt, en alle gegevens die binnen dat interval binnenkomen, worden in dat pakket opgenomen. Aan het einde van het interval stopt de toename van het pakket. De grootte van het interval wordt bepaald door een parameter die batchinterval wordt genoemd;
- — combineert relationele verwerking met functionele programmering in Spark. Gestructureerde gegevens verwijzen naar gegevens met een schema, dat wil zeggen een set van velden die voor alle records gelijk zijn. Spark SQL ondersteunt invoer vanuit meerdere bronnen van gestructureerde gegevens en, dankzij de aanwezigheid van schema-informatie, kan het alleen de noodzakelijke velden van records efficiënt extraheren, en biedt het ook DataFrame-API's;
- — is een relatief goedkope cloud-gebaseerde relationele database, een webservice die de configuratie, werking en schaling vereenvoudigt, en wordt rechtstreeks beheerd door Amazon.
Installeren en starten van de Kafka-server
Voordat je Kafka kunt gebruiken, moet je ervoor zorgen dat Java beschikbaar is, aangezien het gebruikmaakt van de JVM:
sudo apt-get update
sudo apt-get install default-jre
java -version
Laten we een nieuwe gebruiker aanmaken om met Kafka te werken:
sudo useradd kafka -m
sudo passwd kafka
sudo adduser kafka sudo
Daarna downloaden we de distributie van de officiële Apache Kafka-website:
wget -P /YOUR_PATH "http://apache-mirror.rbc.ru/pub/apache/kafka/2.2.0/kafka_2.12-2.2.0.tgz"Pak het gedownloade archief uit:
tar -xvzf /YOUR_PATH/kafka_2.12-2.2.0.tgz
ln -s /YOUR_PATH/kafka_2.12-2.2.0 kafka
De volgende stap is optioneel. Het punt is dat de standaardinstellingen niet alle mogelijkheden van Apache Kafka volledig benutten. Bijvoorbeeld, het verwijderen van onderwerpen, categorieën of groepen waarop berichten gepubliceerd kunnen worden. Om dit te veranderen, bewerken we het configuratiebestand:
vim ~/kafka/config/server.propertiesVoeg aan het einde van het bestand het volgende toe:
delete.topic.enable = trueVoordat we de Kafka-server starten, moeten we de ZooKeeper-server opstarten. We zullen het hulpscript gebruiken dat samen met de Kafka-distributie wordt geleverd:
Cd ~\/kafka
bin\/zookeeper-server-start.sh config\/zookeeper.properties
Nadat ZooKeeper succesvol is gestart, starten we de Kafka-server in een aparte terminal:
bin\/kafka-server-start.sh config\/server.propertiesLaten we een nieuw onderwerp aanmaken met de naam Transaction:
bin\/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic transactionLaten we controleren of het onderwerp met het juiste aantal partities en replicaties is aangemaakt:
bin\/kafka-topics.sh --describe --zookeeper localhost:2181 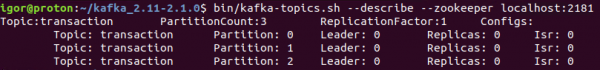
We laten de testmomenten van de producer en consumer voor het zojuist aangemaakte onderwerp achterwege. Meer informatie over hoe we het verzenden en ontvangen van berichten kunnen testen, staat in de officiële documentatie - . We gaan nu verder met het schrijven van de producer in Python met behulp van de KafkaProducer API.
Het schrijven van de producer
De producer zal willekeurige gegevens genereren - 100 berichten per seconde. Met willekeurige gegevens bedoelen we een woordenboek dat uit drie velden bestaat:
- Filiaal — de naam van het verkooppunt van de kredietorganisatie;
- Valuta — de valuta van de transactie;
- Bedrag — het bedrag van de transactie. Het bedrag zal een positief getal zijn als het een aankoop van valuta door de bank betreft, en negatief als het om verkoop gaat.
De code voor de producer ziet er als volgt uit:
from numpy.random import choice, randint

def get_random_value():
    new_dict = {}

    branch_list = ['Kazan', 'SPB', 'Novosibirsk', 'Surgut']
    currency_list = ['RUB', 'USD', 'EUR', 'GBP']

    new_dict['branch'] = choice(branch_list)
    new_dict['currency'] = choice(currency_list)
    new_dict['amount'] = randint(-100, 100)

    return new_dict
Vervolgens gebruiken we de methode send om een bericht naar de server te sturen in het vereiste onderwerp, in JSON-indeling:
from kafka import KafkaProducer

producer = KafkaProducer(bootstrap_servers=['localhost:9092'],
                             value_serializer=lambda x:dumps(x).encode('utf-8'),
                             compression_type='gzip')
my_topic = 'transaction'
data = get_random_value()

try:
    future = producer.send(topic = my_topic, value = data)
    record_metadata = future.get(timeout=10)

    print('--> Het bericht is naar een onderwerp verzonden:
            {}, partition: {}, offset: {}'
            .format(record_metadata.topic,
                record_metadata.partition,
                record_metadata.offset ))

except Exception as e:
    print('--> Het lijkt erop dat er een fout is opgetreden: {}'.format(e))

finally:
    producer.flush()
Bij het uitvoeren van het script krijgen we de volgende berichten in de terminal:
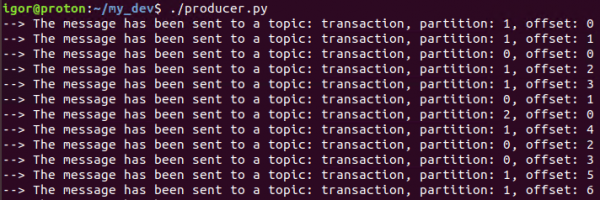
Dit betekent dat alles werkt zoals we wilden - de producer genereert en verzendt berichten naar het juiste onderwerp.
De volgende stap is het installeren van Spark en het verwerken van deze stroom van berichten.
Installatie van Apache Spark
Apache Spark is een universeel en hoogpresterend clusterrekenplatform.
Wat prestaties betreft, overtreft Spark populaire implementaties van het MapReduce-model en biedt het tegelijkertijd ondersteuning voor een breder scala aan rekenkundige types, inclusief interactieve query's en streamingverwerking. Snelheid speelt een belangrijke rol bij het verwerken van grote hoeveelheden gegevens, want die speed maakt het mogelijk om interactief te werken zonder minuten of uren te wachten. Een van de belangrijkste voordelen van Spark, dat deze hoge snelheid mogelijk maakt, is de capaciteit om berekeningen in het geheugen uit te voeren.
Dit framework is geschreven in Scala, dus we moeten deze eerst installeren:
sudo apt-get install scalaDownload het Spark-distributiepakket van de officiële website:
wget "http://mirror.linux-ia64.org/apache/spark/spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz"Pak het archief uit:
sudo tar xvf spark-2.4.2/spark-2.4.2-bin-hadoop2.7.tgz -C /usr/local/sparkVoeg het pad naar Spark toe in het bash-bestand:
vim ~/.bashrcVoeg via de editor de volgende regels toe:
SPARK_HOME=/usr/local/spark
export PATH=$SPARK_HOME/bin:$PATH
Voer de onderstaande opdracht uit na het aanbrengen van wijzigingen in bashrc:
source ~/.bashrcImplementatie van AWS PostgreSQL
We moeten nu de database implementeren waarin we de verwerkte informatie uit de streams gaan plaatsen. Hiervoor zullen we de AWS RDS-service gebruiken.
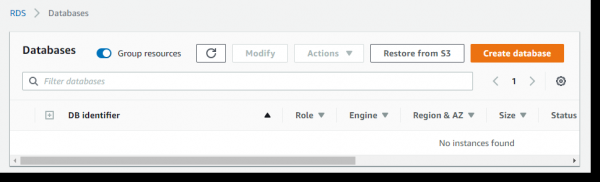
Ga naar de AWS-console —> AWS RDS —> Databases —> Maak database aan:
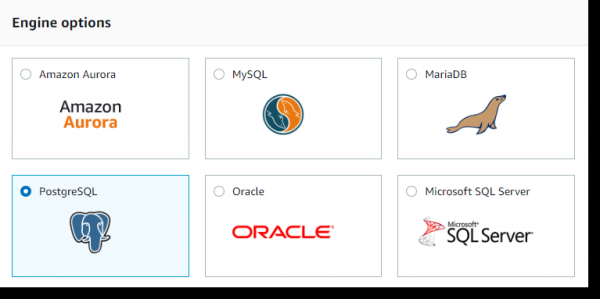
Kies PostgreSQL en klik op de knop Volgende:
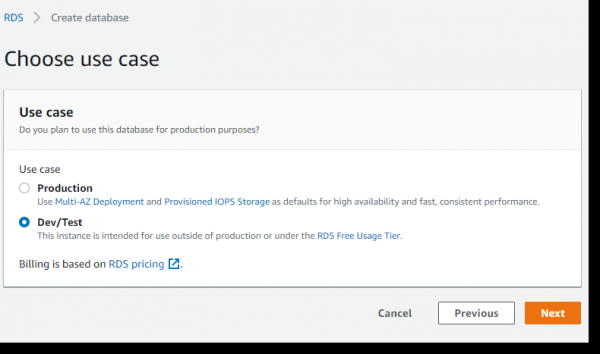
Aangezien dit voorbeeld uitsluitend voor educatieve doeleinden is, gebruiken we een gratis server 'op de minimale instellingen' (Free Tier):
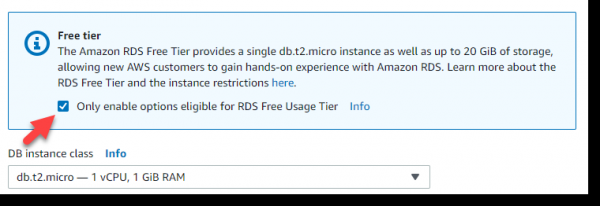
Vink vervolgens het vakje in het blok Free Tier aan, en daarna wordt automatisch een instance van het type t2.micro voorgesteld — hoewel niet erg sterk, is hij gratis en prima geschikt voor onze taak:
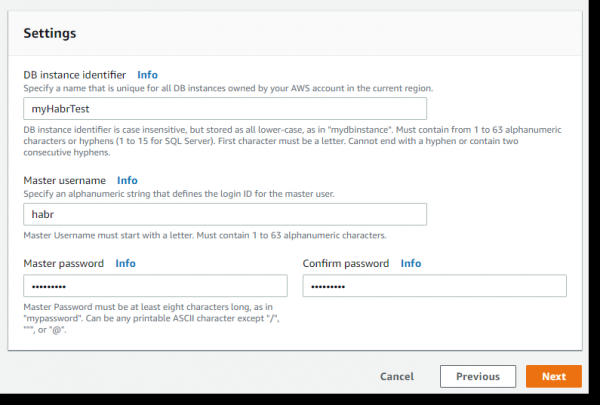
Daarna komen zeer belangrijke zaken: de naam van de DB-instance, de naam van de mastergebruiker en zijn wachtwoord. Laten we de instance de naam geven: myHabrTest, mastergebruiker: habr, wachtwoord: habr12345 en klik op de knop Volgende:
Op de volgende pagina staan de parameters die verantwoordelijk zijn voor de beschikbaarheid van onze DB-server van buitenaf (Public accessibility) en de beschikbaarheid van poorten:
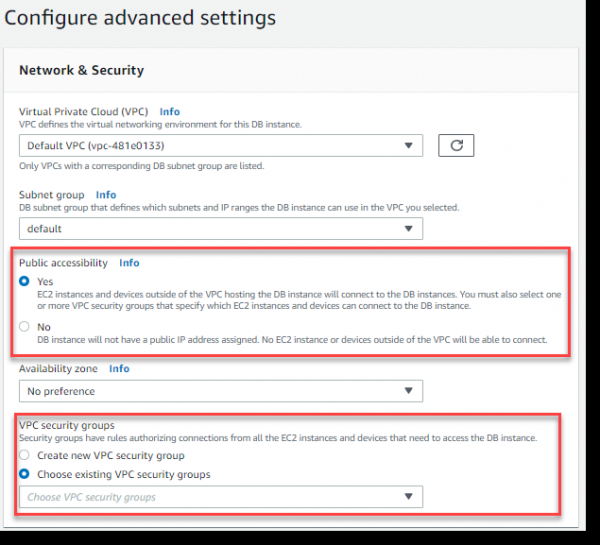
Laten we een nieuwe instelling maken voor de VPC-beveiligingsgroep, die het mogelijk maakt om van buitenaf toegang te krijgen tot onze DB-server via poort 5432 (PostgreSQL).
Laten we in een apart venster van de browser naar de AWS-console gaan in het gedeelte VPC Dashboard —> Security Groups —> Maak beveiligingsgroep aan:
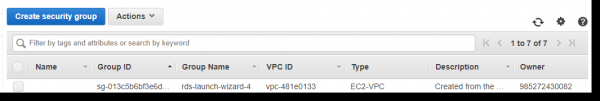
Geef een naam op voor de Security group — PostgreSQL, een beschrijving, geef aan aan welke VPC deze groep moet worden gekoppeld en druk op de knop Create:

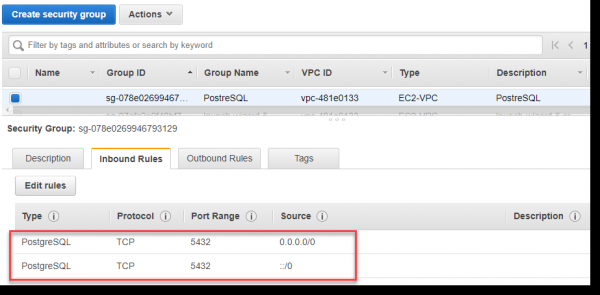
Vul voor de zojuist gemaakte groep de Inbound rules in voor poort 5432, zoals weergegeven in de afbeelding hieronder. Het is niet nodig om de poort handmatig op te geven, je kunt PostgreSQL selecteren uit de vervolgkeuzelijst Type.
Strikt genomen betekent de waarde ::/0 dat de inkomende traffic toegankelijk is voor de server van overal ter wereld, wat canoniek niet helemaal correct is, maar voor het voorbeeld maken we ons deze benadering gemakkelijk:
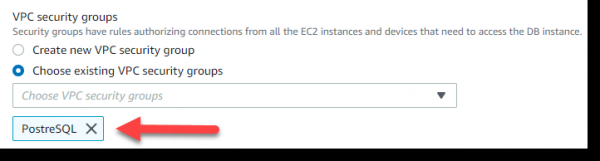
Laten we teruggaan naar de browserpagina waar we 'Configure advanced settings' hebben geopend en kiezen in de sectie VPC security groups —> Kies bestaande VPC security groups —> PostgreSQL:
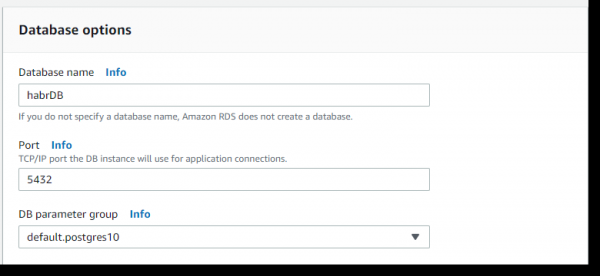
Vervolgens, in de sectie Database options —> Database name —> geef een naam op — habrDB.
De overige parameters, afgezien van het uitschakelen van het maken van back-ups (backup retention period — 0 days), monitoring en Performance Insights, kunnen we standaard laten. Druk op de knop Create database:
Streamhandler
De laatste stap is het ontwikkelen van een Spark-job die elke twee seconden nieuwe gegevens verwerkt die van Kafka komen en het resultaat in de database opslaat.
Zoals eerder opgemerkt, zijn checkpoints de belangrijkste mechanismen in SparkStreaming, die moeten worden ingesteld voor failover. We zullen checkpoints gebruiken en, in het geval dat de procedure faalt, hoeft de Spark Streaming-module om verloren gegevens te herstellen alleen maar terug te keren naar de laatste checkpoint en de berekeningen vanaf daar te hervatten.
Een checkpoint kan worden ingeschakeld door een map in een failover, betrouwbare bestandssysteem (bijv. HDFS, S3, enz.) in te stellen, waarin de informatie van de checkpoint wordt opgeslagen. Dit kan bijvoorbeeld gedaan worden met:
streamingContext.checkpoint(checkpointDirectory)In ons voorbeeld zullen we de volgende aanpak gebruiken, namelijk dat als checkpointDirectory bestaat, de context wordt hersteld uit de gegevens van de checkpoint. Als de map niet bestaat (d.w.z. het is de eerste keer), wordt de functie functionToCreateContext opgeroepen om een nieuwe context aan te maken en de DStreams in te stellen:
from pyspark.streaming import StreamingContext

context = StreamingContext.getOrCreate(checkpointDirectory, functionToCreateContext)
Maak een DirectStream-object aan met de bedoeling te verbinden met het topic 'transaction' met behulp van de createDirectStream-methode van de KafkaUtils-bibliotheek:
from pyspark.streaming.kafka import KafkaUtils

sc = SparkContext(conf=conf)
ssc = StreamingContext(sc, 2)

broker_list = 'localhost:9092'
topic = 'transaction'

directKafkaStream = KafkaUtils.createDirectStream(ssc,
                                [topic],
                                {"metadata.broker.list": broker_list})
We parseren binnenkomende gegevens in JSON-formaat:
rowRdd = rdd.map(lambda w: Row(branch=w['branch'],
                                       currency=w['currency'],
                                       amount=w['amount']))

testDataFrame = spark.createDataFrame(rowRdd)
testDataFrame.createOrReplaceTempView("treasury_stream")
Gebruikmakend van Spark SQL, voeren we een eenvoudige groepering uit en geven het resultaat weer in de console:
select
    from_unixtime(unix_timestamp()) as curr_time,
    t.branch                        as branch_name,
    t.currency                      as currency_code,
    sum(amount)                     as batch_value
from treasury_stream t
group by
    t.branch,
    t.currency
Het ophalen van de SQL-query en deze uitvoeren via Spark SQL:
sql_query = get_sql_query()
testResultDataFrame = spark.sql(sql_query)
testResultDataFrame.show(n=5)
En daarna slaan we de verkregen geaggregeerde gegevens op in een tabel in AWS RDS. Om de aggregatieresultaten in de database tabel op te slaan, gebruiken we de write-methode van het DataFrame-object:
testResultDataFrame.write
    .format("jdbc")
    .mode("append")
    .option("driver", 'org.postgresql.Driver')
    .option("url","jdbc:postgresql://myhabrtest.ciny8bykwxeg.us-east-1.rds.amazonaws.com:5432/habrDB")
    .option("dbtable", "transaction_flow")
    .option("user", "habr")
    .option("password", "habr12345")
    .save()
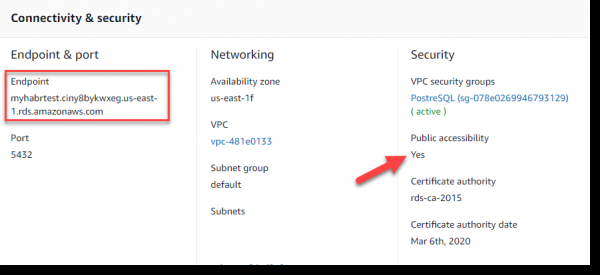
Enkele woorden over de configuratie van de verbinding met AWS RDS. De gebruiker en het wachtwoord hebben we aangemaakt in de stap "Implementatie AWS PostgreSQL". Als URL voor de database server dient de Endpoint gebruikt te worden, die wordt weergegeven in het gedeelte Connectivity & security:
Voor een correcte koppeling van Spark en Kafka, dient de job uitgevoerd te worden via spark-submit met behulp van het artefact spark-streaming-kafka-0-8_2.11. Daarnaast passen we ook het artefact toe voor interactie met de PostgreSQL-database, die we doorgeven via —packages.
Voor de flexibiliteit van het script trekken we ook de naam van de berichtenserver en het topic, waaruit we gegevens willen ophalen, als invoerparameters.
Het is tijd om het systeem te starten en de werking te testen:
spark-submit
--packages org.apache.spark:spark-streaming-kafka-0-8_2.11:2.0.2,
org.postgresql:postgresql:9.4.1207
spark_job.py localhost:9092 transaction
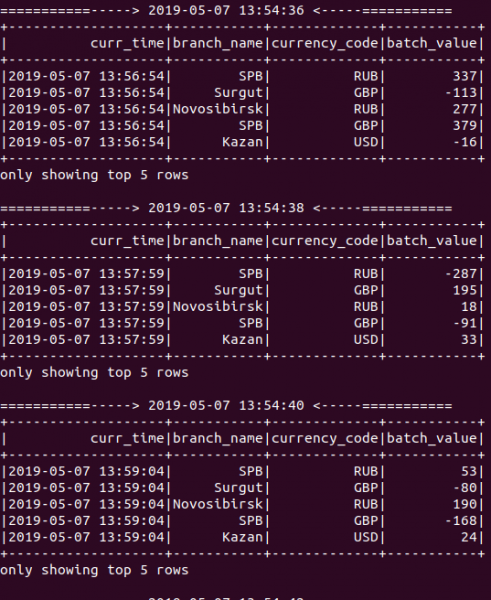
Het is gelukt! Zoals te zien op de onderstaande afbeelding — tijdens de werking van de applicatie worden nieuwe aggregatieresultaten elke 2 seconden weergegeven, omdat we de batching interval op 2 seconden hebben ingesteld bij het aanmaken van het StreamingContext-object:
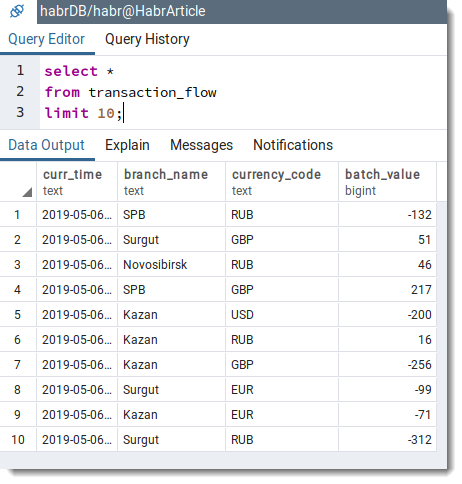
Daarna doen we een eenvoudige query naar de database om te controleren of er records in de tabel zijn transaction_flow:
Conclusie
In dit artikel werd een voorbeeld van stromen van gegevensverwerking besproken met behulp van Spark Streaming in combinatie met Apache Kafka en PostgreSQL. Met de toename van gegevenshoeveelheden uit verschillende bronnen, is het moeilijk om de praktische waarde van Spark Streaming voor het creëren van streamingapplicaties en applicaties die in real-time opereren te overschatten.
De volledige broncode vindt u in mijn repository op .
Ik bespreek dit artikel graag, ik kijk uit naar uw opmerkingen en hoop op constructieve kritiek van alle geïnteresseerde lezers.
Veel succes!
Ps. Aanvankelijk was het de bedoeling om een lokale PostgreSQL-database te gebruiken, maar gezien mijn liefde voor AWS, heb ik besloten om de database naar de cloud te verplaatsen. In het volgende artikel over dit onderwerp zal ik laten zien hoe ik het hierboven beschreven systeem volledig implementeer in AWS met behulp van AWS Kinesis en AWS EMR. Blijf op de hoogte!
Bron: habr.com
