

De markt voor gedistribueerde computing en big data groeit, als we kijken , met 18-19% per jaar. Dit betekent dat de keuze van software voor deze doeleinden relevant blijft. In deze post beginnen we met de vraag waarom gedistribueerde computation nodig is, gaan we dieper in op de keuze van software, bespreken we het gebruik van Hadoop met behulp van Cloudera, en tot slot praten we over de keuze van hardware en hoe dit op verschillende manieren invloed heeft op de prestaties.
Waarom zijn gedistribueerde berekeningen nodig in een normaal bedrijf? Het is eenvoudig en tegelijkertijd complex. Eenvoudig — omdat we in de meeste gevallen relatief eenvoudige berekeningen per informatie-eenheid uitvoeren. Complex — omdat er veel van dergelijke informatie is. Heel veel. Als gevolg hiervan moeten we . Op deze manier zijn de gebruiksscenario's vrij universeel: berekeningen kunnen overal worden toegepast waar een groot aantal metrics op een nog grotere dataset moet worden meegenomen.
Een van de recente voorbeelden: het pizzanetwerk Dodo Pizza op basis van de analyse van de bestellingen van klanten, dat bij het kiezen van een pizza met willekeurige toppings gebruikers doorgaans slechts met zes basissets van ingrediënten plus een paar willekeurige bezig zijn. Dienovereenkomstig heeft de pizzeria haar inkoop hierop afgestemd. Bovendien kon ze beter aanbevelingen doen voor aanvullende producten die tijdens het bestelproces werden aangeboden, waardoor de winst toenam.
Nog een voorbeeld: van artikelnummers stelde winkel H&M in staat om het assortiment in bepaalde winkels met 40% te verkleinen, terwijl het verkoopniveau behouden bleef. Dit werd bereikt door slecht verkopende items uit te sluiten, waarbij rekening werd gehouden met seizoensgebondenheid.
De keuze van de tool
De standaard voor dit soort berekeningen is Hadoop. Waarom? Omdat Hadoop een uitstekende, goed gedocumenteerde framework is (zelfde als Habr, dat een heleboel gedetailleerde artikelen over dit onderwerp levert) dat wordt geleverd met een hele set aan hulpmiddelen en bibliotheken. U kunt enorme datasets, zowel gestructureerd als ongestructureerd, invoeren, en het systeem distribueert ze zelf over de rekenkracht. Bovendien kan deze rekenkracht op elk moment worden vergroot of verminderd — de horizontale schaalbaarheid in actie.
In 2017 publiceerde het invloedrijke adviesbureau Gartner , dat Hadoop binnenkort verouderd zal zijn. De reden is vrij eenvoudig: analisten denken dat bedrijven massaal naar de cloud zullen migreren, omdat ze daar op basis van werkelijk gebruik van rekenkracht kunnen betalen. Een tweede belangrijke factor die Hadoop mogelijk "de das omdoet", is de snelheid van werking. Omdat alternatieven zoals Apache Spark of Google Cloud DataFlow sneller werken dan MapReduce, de basis van Hadoop.
Hadoop steunt op verschillende pijlers, waarvan de meest prominente de MapReduce-technologie (een systeem voor gegevensdistributie voor berekeningen tussen servers) en het HDFS-bestandssysteem zijn. Laatstgenoemde is speciaal ontworpen voor het opslaan van informatie die verdeeld is over de knooppunten van een cluster: elke blok met een vaste grootte kan op verschillende knooppunten worden geplaatst, en door replicatie wordt de systeemweerstand tegen storingen van individuele knooppunten gewaarborgd. In plaats van een tabel voor bestanden wordt een speciale server gebruikt, de zogenaamde NameNode.
In de onderstaande illustratie wordt het werkingsschema van MapReduce weergegeven. In de eerste fase worden gegevens verdeeld op basis van een bepaalde eigenschap, in de tweede fase worden ze verdeeld over de rekenkracht, en in de derde fase vindt de berekening plaats.
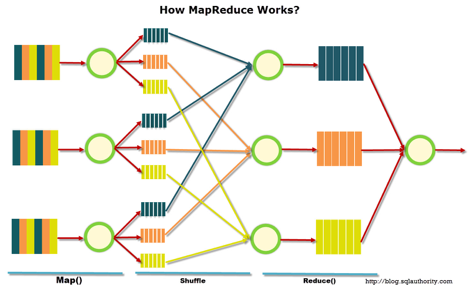
Oorspronkelijk werd MapReduce ontwikkeld door Google voor zijn zoekmachine. Vervolgens werd MapReduce opensource en werd het project overgenomen door Apache. Google is geleidelijk overgestapt op andere oplossingen. Een interessant detail: momenteel heeft Google een project genaamd Google Cloud Dataflow, gepositioneerd als de volgende stap na Hadoop, als een snelle vervanging.
Bij nader inzien valt op dat Google Cloud Dataflow is gebaseerd op een variant van Apache Beam, waarbij Apache Beam een goed gedocumenteerd framework van Apache Spark bevat, wat betekent dat de uitvoeringssnelheid van oplossingen vrijwel identiek is. Bovendien werkt Apache Spark uitstekend met het HDFS-bestandssysteem, waardoor het op Hadoop-servers kan worden uitgerold.
Als we hier de hoeveelheid documentatie en kant-en-klare oplossingen voor Hadoop en Spark ten opzichte van Google Cloud Dataflow aan toevoegen, wordt de keuze voor de tool duidelijk. Bovendien kunnen ingenieurs zelf bepalen welke code - voor Hadoop of Spark - ze willen uitvoeren, afhankelijk van de taak, ervaring en kwalificatie.
Cloud of lokale server
De tendens naar de alomtegenwoordige overstap naar de cloud heeft zelfs een interessant begrip opgeleverd, zoals Hadoop-as-a-service. In dit scenario is het beheer van de aangesloten servers zeer belangrijk geworden. Want helaas is pure Hadoop, ondanks zijn populariteit, een vrij moeilijke tool om op te zetten, omdat veel handmatige configuratie nodig is. Bijvoorbeeld, servers apart configureren, de prestaties ervan in de gaten houden, en zorgvuldig talloze parameters instellen. Kortom, het is werk voor liefhebbers en er is een grote kans om ergens een fout te maken of iets te missen.
Daarom zijn verschillende distributies zeer populair geworden die aanvankelijk zijn uitgerust met handige implementatie- en beheerhulpmiddelen. Een van de populairste distributies die Spark ondersteunen en alles vereenvoudigen, is Cloudera. Deze heeft zowel betaalde als gratis versies - en in de laatste versie is alle belangrijkste functionaliteit beschikbaar, zonder beperking van het aantal knooppunten.
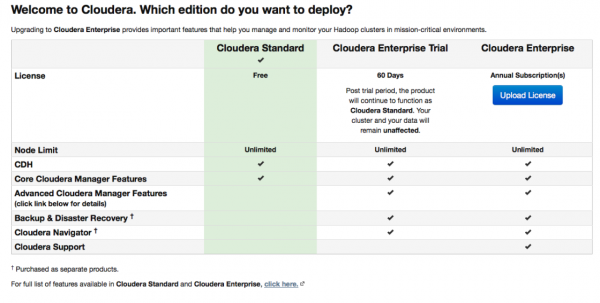
Tijdens de configuratie zal Cloudera Manager via SSH verbinding maken met uw servers. Een interessant punt: bij de installatie is het beter om op te geven dat het moet gebeuren met zogenaamde parcels: speciale pakketten waarin alle benodigde componenten zijn opgenomen, ingesteld om met elkaar samen te werken. In wezen is dit een verbeterde versie van een pakketbeheerder.
Na de installatie hebben we een beheerconsole voor het cluster waar we telemetrie van de clusters kunnen bekijken, de geïnstalleerde diensten, plus u kunt middelen toevoegen/verwijderen en de configuratie van het cluster bewerken.
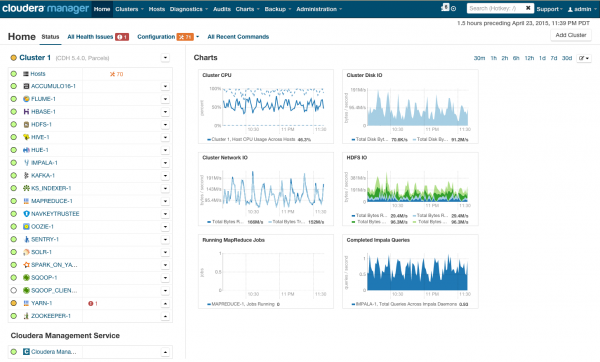
U krijgt nu een doorkijkje van de raket die u naar de toekomst van BigData zal brengen. Maar voordat we zeggen 'laten we gaan', laten we onder de motorkap kijken.
Harde vereisten
Op hun website vermeldt Cloudera verschillende mogelijke configuraties. De algemene principes waarop ze zijn gebaseerd, worden in de illustratie weergegeven:
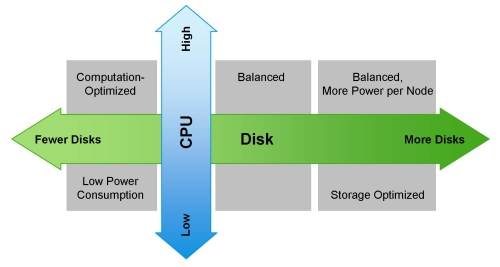
MapReduce kan dit optimistische beeld doorkruisen. Als we opnieuw naar het schema in het vorige hoofdstuk kijken, wordt het duidelijk dat in bijna alle gevallen de MapReduce-taak kan stuiten op een 'flessenhals' bij het lezen van gegevens van schijf of uit het netwerk. Dit wordt ook opgemerkt in de blog van Cloudera. Voor alle snelle berekeningen, inclusief via Spark, dat vaak wordt gebruikt voor realtime berekeningen, is de snelheid van invoer/uitvoer van groot belang. Daarom is het bij het gebruik van Hadoop cruciaal dat er uitgebalanceerde en snelle machines in het cluster zijn, wat, zachtjes gezegd, niet altijd mogelijk is in de cloudinfrastructuur.
Balans in de belastingverdeling wordt bereikt door het gebruik van Openstack-virtualisatie op servers met krachtige multicore-CPU's. De datanodes hebben hun eigen verwerkingsresources en specifieke schijven. In onze oplossing Atos Codex Data Lake Engine wordt brede virtualisatie bereikt, waardoor we zowel qua prestaties (de invloed van de netwerkinfrastructuur wordt geminimaliseerd) als qua TCO (onnodige fysieke servers worden uitgesloten) voordelen behalen.
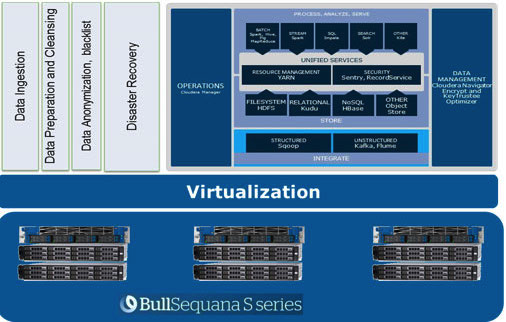
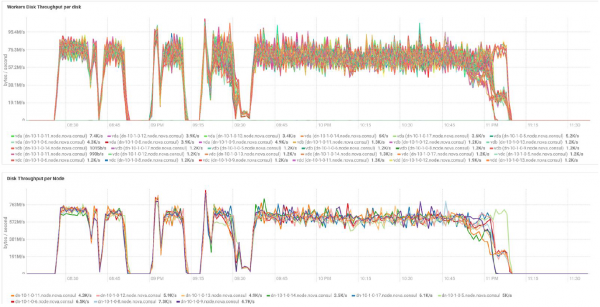
Bij het gebruik van BullSequana S200-servers krijgen we een zeer gelijkmatige belasting zonder een deel van de knelpunten. De minimale configuratie omvat 3 BullSequana S200-servers, elk met twee JBOD's, met optioneel extra S200's die elk vier datanodes bevatten. Hier is een voorbeeld van de belasting in de TeraGen-test:
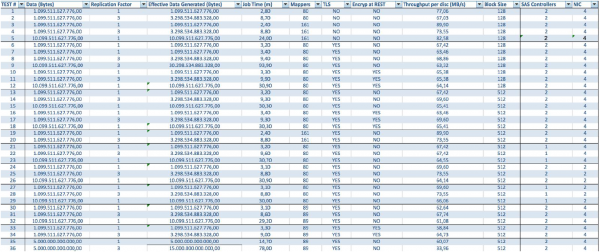
Tests met verschillende datavolumes en replicatiewaarden vertonen dezelfde resultaten met betrekking tot de belastingverdeling tussen de cluster nodes. Hieronder staat een grafiek van de schijftoegang verdeeld over de prestatietests.
Berekeningen zijn uitgevoerd op basis van de minimale configuratie van 3 BullSequana S200-servers. Deze omvat 9 datanodes en 3 master nodes, evenals gereserveerde virtuele machines voor het geval er bescherming op basis van OpenStack Virtualization wordt ingezet. Het resultaat van de TeraSort-test: blokgrootte van 512 MB met een replicatiefactor van drie en encryptie bedraagt 23,1 minuten.
Hoe kan het systeem worden uitgebreid? Voor de Data Lake Engine zijn er verschillende soorten uitbreidingen beschikbaar:
- Data transfer nodes: voor elke 40 TB bruikbare ruimte
- Analytische nodes met de mogelijkheid om GPU's te installeren
- Andere opties afhankelijk van de zakelijke behoeften (bijvoorbeeld, als Kafka nodig is en dergelijke)
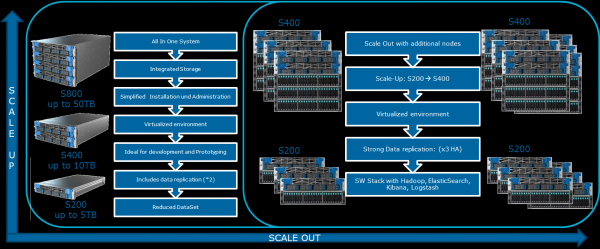
De Atos Codex Data Lake Engine omvat zowel de servers als de vooraf geïnstalleerde software, inclusief de Cloudera-kits met licentie; Hadoop zelf, OpenStack met virtuele machines op basis van RedHat Enterprise Linux-kernel, datareplicatiesystemen en backups (inclusief via de backup node en Cloudera BDR — Backup and Disaster Recovery). Atos Codex Data Lake Engine was de eerste oplossing met virtualisatie die gecertificeerd is. .
Als je geïnteresseerd bent in details, beantwoorden we graag je vragen in de reacties.
Bron: habr.com
