

Begin dit maand, op 3 mei, werd de grote release van het 'beheer systeem voor gedistribueerde dataopslag in Kubernetes' aangekondigd — . Meer dan een jaar geleden hebben we al algemene overzicht van Rook gepresenteerd. Toen werden we gevraagd om te vertellen over de ervaring met het gebruik in de praktijk — en nu, vlak voor deze belangrijke mijlpaal in de geschiedenis van het project, zijn we blij om onze verzamelde indrukken te delen.
Kortom, Rook is een set van voor Kubernetes, die volledig het beheer, de implementatie en het automatische herstel van opslagoplossingen zoals Ceph, EdgeFS, Minio, Cassandra, CockroachDB overnemen.
Op dit moment is de meest ontwikkelde (en in stabiele oplossing in .
Opmerking: onder de belangrijke veranderingen in de release van Rook 1.0.0 met betrekking tot Ceph zijn de ondersteuning van Ceph Nautilus en de mogelijkheid om NFS te gebruiken voor CephFS- of RGW-buckets. Daarnaast is er de 'veroudering' van de ondersteuning voor EdgeFS tot het bètaniveau.
Dus in dit artikel gaan we:
- beantwoorden welke voordelen we zien in het gebruik van Rook voor de implementatie van Ceph in een Kubernetes-cluster;
- onze ervaringen en indrukken van het gebruik van Rook in productie delen;
- vertellen waarom we Rook 'Ja!' zeggen, en onze plannen daarvoor.
Laten we beginnen met de algemene concepten en theorie.
“Ik heb een voordeel van één toren!” (onbekende schaker)
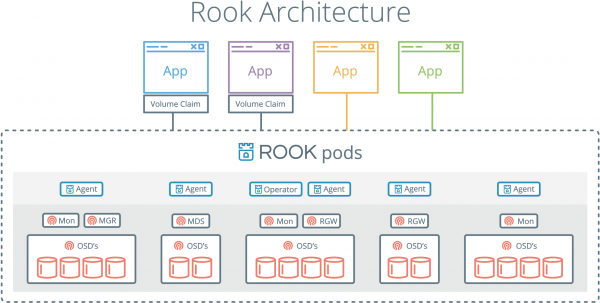
Een van de belangrijkste voordelen van Rook is dat de interactie met data-opslag plaatsvindt via de mechanismen van Kubernetes. Dit betekent dat je niet langer commando's voor de configuratie van Ceph van een papierblad naar de console hoeft te kopiëren.
— Wil je CephFS in het cluster implementeren? Schrijf gewoon een YAML-bestand!
— Wat? Wil je ook nog een objectstore met de S3 API implementeren? Schrijf gewoon een tweede YAML-bestand!
Rook is ontworpen volgens de regels van een typische operator. De interactie met hem vindt plaats via , waarin we de benodigde kenmerken van de Ceph-entiteiten beschrijven (aangezien dit de enige stabiele implementatie is, wordt in dit artikel standaard over Ceph gesproken, tenzij anders aangegeven). Volgens de opgegeven parameters voert de operator automatisch de benodigde configuratieopdrachten uit.
Laten we de specificaties bekijken aan de hand van het voorbeeld van het maken van een Object Store, en meer specifiek — CephObjectStoreUser.
apiVersion: ceph.rook.io/v1
kind: CephObjectStore
metadata:
  name: {{ .Values.s3.crdName }}
  namespace: kube-rook
spec:
  metadataPool:
    failureDomain: host
    replicated:
      size: 3
  dataPool:
    failureDomain: host
    erasureCoded:
      dataChunks: 2
      codingChunks: 1
  gateway:
    type: s3
    sslCertificateRef:
    port: 80
    securePort:
    instances: 1
    allNodes: false
---
apiVersion: ceph.rook.io/v1
kind: CephObjectStoreUser
metadata:
  name: {{ .Values.s3.crdName }}
  namespace: kube-rook
spec:
  store: {{ .Values.s3.crdName }}
  displayName: {{ .Values.s3.username }}
De in de lijst vermelde parameters zijn vrij standaard en vereisen weinig commentaar, maar het is belangrijk om speciale aandacht te besteden aan diegene die in sjabloonvariabelen zijn weergegeven.
Het algemene werkingsschema is dat we via een YAML-bestand bronnen "bestellen", waarvoor de operator de nodige commando's uitvoert en ons een "niet-werkelijke" geheimcode teruggeeft, waarmee we verder kunnen werken. (zie hieronder). En uit de eerder genoemde variabelen wordt een opdracht en de naam van het geheim samengesteld.
Wat is deze opdracht? Bij het aanmaken van een gebruiker voor het objectopslag zal de Rook-operator binnen de pod het volgende uitvoeren:
radosgw-admin user create --uid="rook-user" --display-name="{{ .Values.s3.username }}"Het resultaat van deze opdracht zal een JSON-structuur zijn:
{
    "user_id": "rook-user",
    "display_name": "{{ .Values.s3.username }}",
    "keys": [
        {
           "user": "rook-user",
           "access_key": "NRWGT19TWMYOB1YDBV1Y",
           "secret_key": "gr1VEGIV7rxcP3xvXDFCo4UDwwl2YoNrmtRlIAty"
        }
    ],
    ...
}
Sleutels — datgene wat in de toekomst nodig zal zijn voor applicaties om toegang te krijgen tot de objectopslag via de S3 API. De Rook-operator kiest ze vriendelijk uit en plaatst ze in zijn namespace in de vorm van een geheim met de naam rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}.
Om de gegevens uit dit geheim te gebruiken, is het voldoende om ze toe te voegen aan de container als omgevingsvariabelen. Als voorbeeld geef ik een sjabloon voor een Job waarin we automatisch buckets creëren voor elke gebruikersomgeving:
{{- range $bucket := $.Values.s3.bucketNames }}
apiVersion: batch/v1
kind: Job
metadata:
  name: create-{{ $bucket }}-bucket-job
  annotations:
    "helm.sh/hook": post-install
    "helm.sh/hook-weight": "2"
spec:
  template:
    metadata:
      name: create-{{ $bucket }}-bucket-job
    spec:
      restartPolicy: Never
      initContainers:
      - name: waitdns
        image: alpine:3.6
        command: ["/bin/sh", "-c", "while ! getent ahostsv4 rook-ceph-rgw-{{ $.Values.s3.crdName }}; do sleep 1; done" ]
      - name: config
        image: rook/ceph:v1.0.0
        command: ["/bin/sh", "-c"]
        args: ["s3cmd --configure --access_key=$(ACCESS-KEY) --secret_key=$(SECRET-KEY) -s --no-ssl --dump-config | tee /config/.s3cfg"]
        volumeMounts:
        - name: config
          mountPath: /config
        env:
        - name: ACCESS-KEY
          valueFrom:
            secretKeyRef:
              name: rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}
              key: AccessKey
        - name: SECRET-KEY
          valueFrom:
            secretKeyRef:
              name: rook-ceph-object-user-{{ $.Values.s3.crdName }}-{{ $.Values.s3.username }}
              key: SecretKey
      containers:
      - name: create-bucket
        image: rook/ceph:v1.0.0
        command:
        - "s3cmd"
        - "mb"
        - "--host=rook-ceph-rgw-{{ $.Values.s3.crdName }}"
        - "--host-bucket= "
        - "s3://{{ $bucket }}"
        ports:
        - name: s3-no-sll
          containerPort: 80
        volumeMounts:
        - name: config
          mountPath: /root
      volumes:
      - name: config
        emptyDir: {}
---
{{- end }}
Alle acties die in deze Job zijn beschreven, zijn uitgevoerd binnen Kubernetes. De in YAML-bestanden beschreven structuren zijn opgeslagen in een Git-repository en herhaaldelijk hergebruikt. Hierin zien we een groot voordeel voor DevOps-engineers en het CI/CD-proces in het algemeen.
Met Rook en Rados is het een plezier
Het gebruik van de combinatie Ceph + RBD brengt bepaalde beperkingen met zich mee bij het koppelen van volumes aan pods.
Specifiek moet er in de namespace een geheim aanwezig zijn om toegang tot Ceph te krijgen, zodat stateful-applicaties goed kunnen functioneren. Het is normaal als je 2-3 omgevingen in je namespaces hebt: je kunt het geheim handmatig kopiëren. Maar wat te doen als voor elke feature van ontwikkelaars een aparte omgeving met zijn eigen namespace wordt aangemaakt?
Hier hebben we het probleem opgelost met behulp van , die automatisch geheimen in nieuwe namespaces kopieerde (een voorbeeld van zo'n hook is beschreven in ).
#! /bin/bash

if [[ $1 == “--config” ]]; then
   cat <<EOF
{"onKubernetesEvent":[
 {"name": "OnNewNamespace",
  "kind": "namespace",
  "event": ["add"]
  }
]}
EOF
else
    NAMESPACE=$(kubectl get namespace -o json | jq '.items | max_by( .metadata.creationTimestamp ) | .metadata.name')
    kubectl -n ${CEPH_SECRET_NAMESPACE} get secret ${CEPH_SECRET_NAME} -o json | jq ".metadata.namespace="${NAMESPACE}"" | kubectl apply -f -
fi
Echter, bij het gebruik van Rook is dit probleem eenvoudigweg niet aanwezig. Het proces van koppelen gebeurt met behulp van eigen drivers op basis van of (momenteel in bètastadium) en vereist daarom geen geheimen.
Rook lost veel problemen automatisch op, wat ons aanmoedigt om het te gebruiken in nieuwe projecten.
De belegering van Rook
Laten we de praktische sectie beëindigen met het uitrollen van Rook en Ceph, zodat we onze eigen experimenten kunnen uitvoeren. Om deze ontoegankelijke toren gemakkelijker te veroveren, hebben de ontwikkelaars een Helm-pakket voorbereid. Laten we deze downloaden:
$ helm fetch rook-master/rook-ceph --untar --version 1.0.0 In het bestand rook-ceph/values.yaml kan een scala aan verschillende instellingen worden gevonden. Het belangrijkste is om tolerances voor agents en zoeken op te geven. Waarvoor het mechanisme van taints/tolerances kan worden gebruikt, hebben we in detail besproken in .
In het kort willen we niet dat pods met de client-applicatie zich op dezelfde knooppunten bevinden als de schijven voor gegevensopslag. De reden is simpel: zo heeft het werk van de Rook-agents geen invloed op de applicatie zelf.
Dus, we openen het bestand rook-ceph/values.yaml met onze favoriete editor en voegen aan het einde de volgende blok toe:
discover:
  toleration: NoExecute
  tolerationKey: node-role/storage
agent:
  toleration: NoExecute
  tolerationKey: node-role/storage
  mountSecurityMode: Any
We voegen de overeenkomstige taint toe aan elk knooppunt dat is gereserveerd voor gegevensopslag:
$ kubectl taint node ${NODE_NAME} node-role/storage="":NoExecuteDaarna installeren we de Helm-chart met het commando:
$ helm install --namespace ${ROOK_NAMESPACE} ./rook-cephNu moeten we een cluster creëren en de locatie opgeven :
apiVersion: ceph.rook.io/v1
kind: CephCluster
metadata:
  clusterName: "ceph"
  finalizers:
  - cephcluster.ceph.rook.io
  generation: 1
  name: rook-ceph
spec:
  cephVersion:
    image: ceph/ceph:v13
  dashboard:
    enabled: true
  dataDirHostPath: /var/lib/rook/osd
  mon:
    allowMultiplePerNode: false
    count: 3
  network:
    hostNetwork: true
  rbdMirroring:
    workers: 1
  placement:
    all:
      tolerations:
      - key: node-role/storage
        operator: Exists
  storage:
    useAllNodes: false
    useAllDevices: false
    config:
      osdsPerDevice: "1"
      storeType: filestore
    resources:
      limits:
        memory: "1024Mi"
      requests:
        memory: "1024Mi"
    nodes:
    - name: host-1
      directories:
      - path: "/mnt/osd"
    - name: host-2
      directories:
      - path: "/mnt/osd"
    - name: host-3
      directories:
      - path: "/mnt/osd"
We controleren de status van Ceph - we verwachten HEALTH_OK te zien HEALTH_OK:
$ kubectl -n ${ROOK_NAMESPACE} exec $(kubectl -n ${ROOK_NAMESPACE} get pod -l app=rook-ceph-operator -o name -o jsonpath='{.items[0].metadata.name}') -- ceph -sLaten we ook controleren of de pods met de client-applicatie niet op de voor Ceph gereserveerde knooppunten komen:
$ kubectl -n ${APPLICATION_NAMESPACE} get pods -o custom-columns=NAME:.metadata.name,NODE:.spec.nodeNameVervolgens kunnen optioneel aanvullende componenten worden ingesteld. Meer hierover is te vinden in . Voor administratieve doeleinden raden we ten zeerste aan om het dashboard en de toolbox te installeren.
Rook-haken: is Rook voor alles voldoende?
Zoals te zien is, gaat de ontwikkeling van Rook in volle gang. Maar er zijn nog steeds problemen die ons verhinderen om volledig af te stappen van handmatige configuratie van Ceph:
- Geen enkele Rook-driver de metriek van het gebruik van gemonteerde volumes exporteren, wat ons van monitoring uitsluit.
- Flexvolume en CSI de grootte van volumes wijzigen (in tegenstelling tot RBD), waardoor Rook een nuttig (en soms zelfs kritisch noodzakelijk!) hulpmiddel verliest.
- Rook is nog steeds niet zo flexibel als reguliere Ceph. Als we willen instellen dat de pool voor CephFS-metadata op SSD wordt opgeslagen en de gegevens op HDD, moeten we afzonderlijke apparaatsgroepen handmatig in de CRUSH-maps definiëren.
- Hoewel de rook-ceph-operator als stabiel wordt beschouwd, zijn er momenteel bepaalde problemen bij het upgraden van Ceph van versie 13 naar 14.
Conclusies
„Momenteel is het Rook gesloten voor de buitenwereld door pionnen, maar we geloven dat het op een dag de doorslaggevende rol in het spel zal spelen!“ (aanroep speciaal bedacht voor dit artikel)
Het Rook-project heeft ongetwijfeld onze harten veroverd - we zijn van mening dat [met al zijn voor- en nadelen] het zeker uw aandacht verdient.
Onze verdere plannen zijn gericht op het maken van rook-ceph als module voor , wat het gebruik in onze vele Kubernetes-clusters nog eenvoudiger en handiger zal maken.
P.S.
Lees ook op onze blog:
- «»;
- «»;
- «»;
- «»;
- «».
Bron: habr.com
