

Inleidende opmerking
Ik heb deze presentatie in het Engels gepresenteerd op de GopherCon Rusland 2019 in Moskou en in het Russisch tijdens de meetup in Nizhny Novgorod. Het gaat over de bitmap-index — minder vaak voorkomend dan de B-tree, maar zeker niet minder interessant. Ik deel van de presentatie op de conferentie in het Engels en de tekstuele transcriptie in het Russisch.
We gaan bekijken hoe een bitmap-index werkt, wanneer deze beter is, wanneer slechter dan andere indexen, en in welke gevallen hij aanzienlijk sneller is; we zullen zien in welke populaire DBMS al bitmap-indexen bestaan; en we zullen proberen onze eigen index te schrijven in Go. En als 'toetje' gaan we gebruik maken van kant-en-klare bibliotheken om onze eigen super snelle gespecialiseerde database te maken.
Ik hoop dat mijn inspanningen nuttig en interessant voor jullie zullen zijn. Laten we beginnen!
Inleiding

Hallo allemaal! Het is nu zes uur 's avonds, we zijn allemaal super vermoeid. Geweldige tijd om over de saaie theorie van database-indexen te praten, nietwaar? Maak je geen zorgen, ik zal hier en daar een paar stukjes broncode delen. 🙂
Als we serieus zijn, dan is de presentatie vol met informatie en hebben we niet zo veel tijd. Dus laten we beginnen.
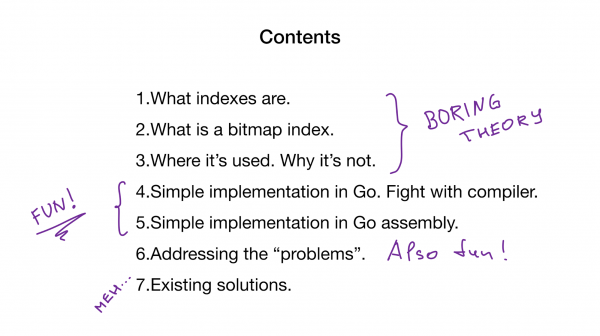
Vandaag ga ik het volgende bespreken:
- wat indexen zijn;
- wat een bitmap-index is;
- waar deze wordt gebruikt en waar hij NIET wordt gebruikt en waarom;
- een eenvoudige implementatie in Go en wat worstelen met de compiler;
- een iets minder eenvoudige, maar veel productievere implementatie in Go-assembler;
- de 'problemen' van bitmap-indexen;
- bestaande implementaties.
Wat zijn indexen?
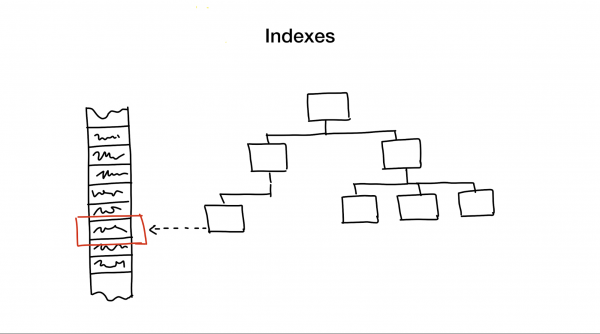
Een index is een aparte datastructuur die we behouden en bijwerken naast de hoofdata. Deze wordt gebruikt om zoekopdrachten te versnellen. Zonder indexen zou een zoekopdracht een volledige doorlooptijd over de data vereisen (een proces dat full scan wordt genoemd), en dit proces heeft een lineaire algoritmische complexiteit. Maar databases bevatten meestal enorme hoeveelheden data en lineaire complexiteit is veel te traag. Idealiter willen we logaritmische of constante complexiteit.
Dit is een enorm complex onderwerp, vol nuances en compromissen, maar na tientallen jaren ontwikkeling en onderzoek naar verschillende databases ben ik bereid te stellen dat er maar een paar breed gebruikte benaderingen zijn voor het creëren van database-indexen.
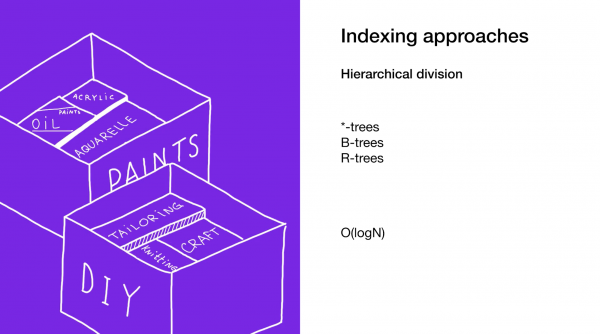
De eerste benadering bestaat uit het hiërarchisch verkleinen van het zoekgebied, het opdelen van het zoekgebied in kleinere delen.
Gewoonlijk doen we dit met behulp van verschillende soorten bomen. Een voorbeeld hiervan is een grote doos met materialen in uw kast, waarin kleinere dozen met materialen zijn verdeeld op verschillende thema's. Als u naar materialen zoekt, zult u zeker in de doos met het label "Materialen" kijken en niet in de doos met het label "Koekjes", toch?
De tweede benadering is om meteen het benodigde element of de groep elementen te identificeren. We doen dit met hash-mappen of in omgekeerde indexen. Het gebruik van hash-mappen is heel vergelijkbaar met het vorige voorbeeld, alleen hebt u in uw kast een hoop kleine dozen met de uiteindelijke items in plaats van een doos met dozen.
De derde benadering is om de noodzaak van zoeken te elimineren. Dit doen we met behulp van Bloom-filters of cuckoo-filters. De eerste geven onmiddellijk antwoord, zodat u niet hoeft te zoeken.
De laatste benadering is om de volledige capaciteit van moderne hardware te benutten. Dit doen we met bitmap-indexen. Ja, bij het gebruik ervan moet je soms door de hele index gaan, maar we doen dit super efficiënt.
Zoals ik al zei, is het onderwerp van database-indexen uitgebreid en vol compromissen. Dit betekent dat we soms meerdere benaderingen tegelijk kunnen gebruiken: als we de zoektocht nog verder willen versnellen of als we alle mogelijke zoektypes moeten dekken.
Vandaag ga ik het hebben over de minste bekende aanpak van de genoemde — de bitmap-indexen.
Wie ben ik om over dit onderwerp te praten?
Ik ben teamleider bij Badoo (misschien kent u een ander product van ons — Bumble). We hebben inmiddels meer dan 400 miljoen gebruikers wereldwijd en veel functies die het beste paar voor hen selecteren. Dit doen we met behulp van maatwerkdiensten die ook bitmap-indexen gebruiken.
Wat is een bitmap-index eigenlijk?
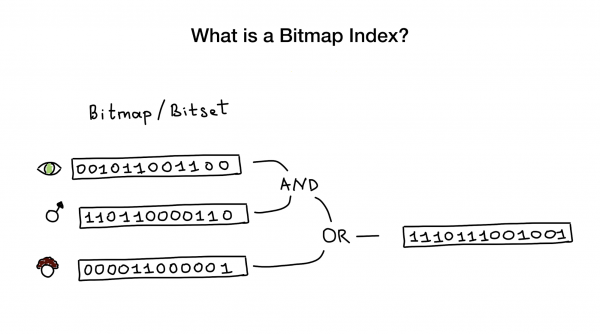
Bitmap-indexen, zoals de naam al doet vermoeden, gebruiken bitmaps of bitsets om een zoekindex te implementeren. Van een vogelvluchtperspectief bestaat deze index uit een of meerdere van dergelijke bitmaps, die entiteiten (zoals mensen) en hun eigenschappen of parameters (leeftijd, oogkleur, enz.) vertegenwoordigen, en een algoritme dat bitbewerkingen (AND, OR, NOT) gebruikt om op een zoekopdracht te reageren.
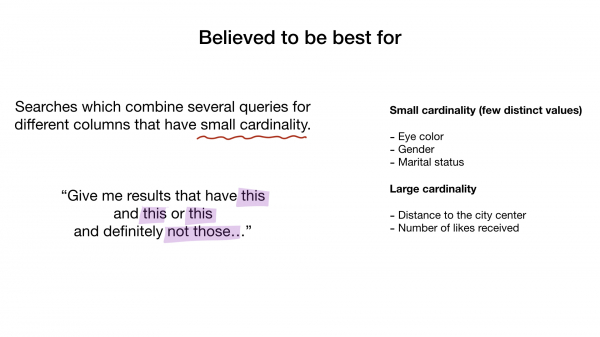
Er wordt gezegd dat bitmap-indexen het beste en zeer efficiënt zijn in situaties waarin er gezocht wordt met gecombineerde verzoeken over meerdere kolommen met een lage cardinaliteit (denk aan 'oogkleur' of 'burgerlijke staat' in vergelijking met iets als 'afstand tot het stadscentrum'). Maar later zal ik laten zien dat ze ook uitstekend werken voor kolommen met een hoge cardinaliteit.
Laten we een eenvoudig voorbeeld van een bitmap-index bekijken.
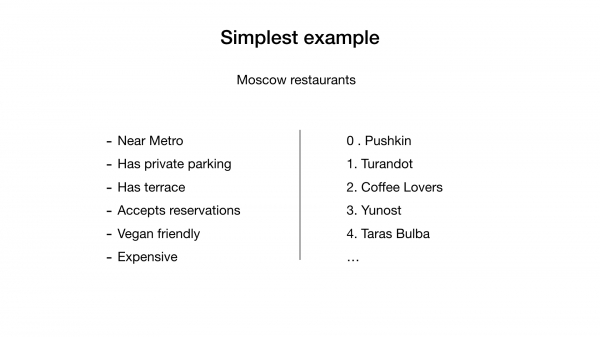
Stel je voor dat we een lijst hebben van Moskou-restaurants met binaire eigenschappen zoals deze:
- dichtbij de metro (near metro);
- heeft privé-parking (has private parking);
- heeft een terras (has terrace);
- reserveren mogelijk (accepts reservations);
- geschikt voor vegetariërs (vegan friendly);
- duur (expensive).
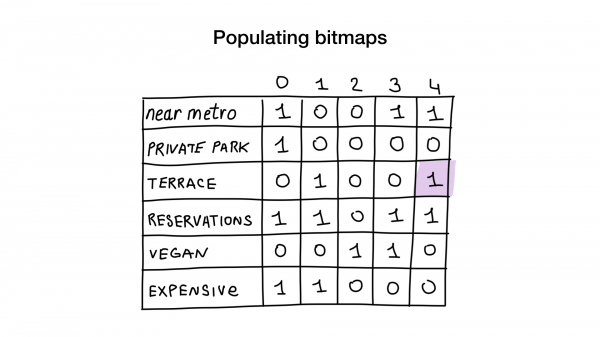
Laten we elke restaurant een volgnummer geven, beginnend bij 0, en geheugen toewijzen voor 6 bitmaps (één voor elke eigenschap). Vervolgens vullen we deze bitmaps in afhankelijk van of het restaurant deze eigenschap heeft of niet. Als restaurant 4 een terras heeft, dan wordt bit nummer 4 in de bitmap 'heeft een terras' ingesteld op 1 (als er geen terras is, dan op 0).
Nu hebben we de simpelste bitmap-index die mogelijk is, en we kunnen deze gebruiken om te antwoorden op verzoeken zoals:
- "Laat me de restaurants zien die geschikt zijn voor vegetariërs";
- "Laat me de goedkope restaurants met een terras zien, waar ik een tafel kan reserveren."
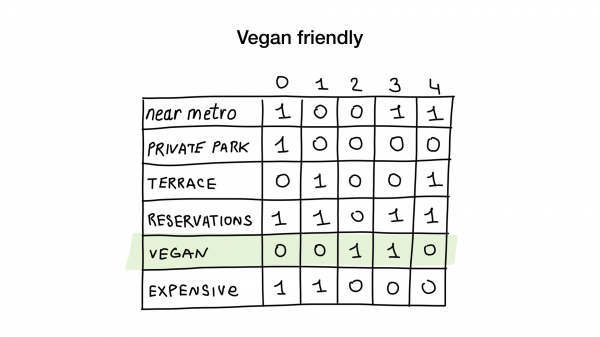
Hoe? Laten we kijken. De eerste vraag is heel eenvoudig. Alles wat we nodig hebben, is de bitmap 'geschikt voor vegetariërs' om te veranderen in een lijst van restaurants wiens bits zijn ingesteld.
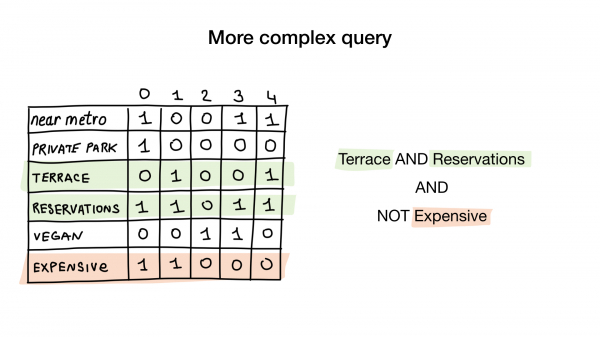
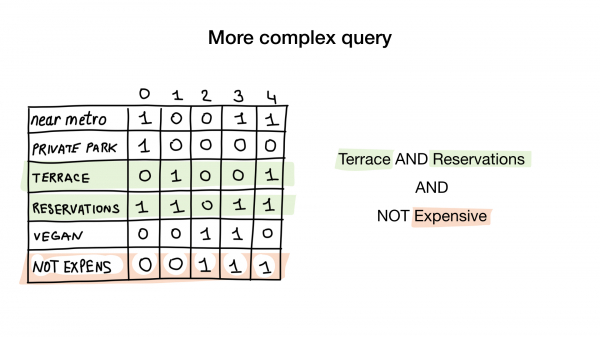
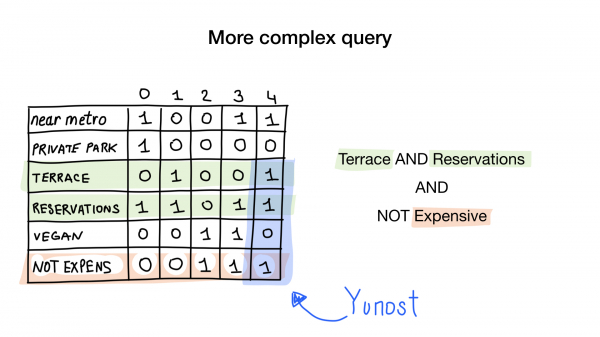
De tweede vraag is iets moeilijker. We moeten de bitwise NOT-operatie op de bitmap 'duur' gebruiken om een lijst van goedkope restaurants te krijgen, vervolgens AND-en we deze met de bitmap 'reserveren mogelijk' en AND-en we het resultaat met de bitmap 'veranda aanwezig'. De resulterende bitmap bevat een lijst van zaken die aan al onze criteria voldoen. In dit geval is dat alleen restaurant 'Juno'.
Hier is veel theorie, maar maak je geen zorgen, we zullen heel snel de code zien.
Waar worden bitmap-indexen gebruikt?
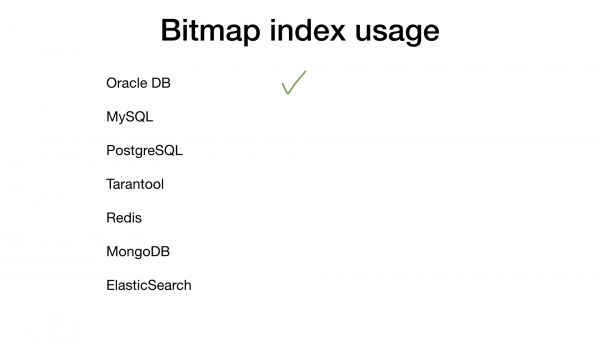
Als je 'bitmap-indexen' googelt, zullen 90% van de antwoorden op de een of andere manier gerelateerd zijn aan Oracle DB. Maar andere DBMS'en ondersteunen ongetwijfeld ook zo'n gaaf ding, toch? Niet helemaal.
Laten we de lijst van hoofdverdachten doorlopen.
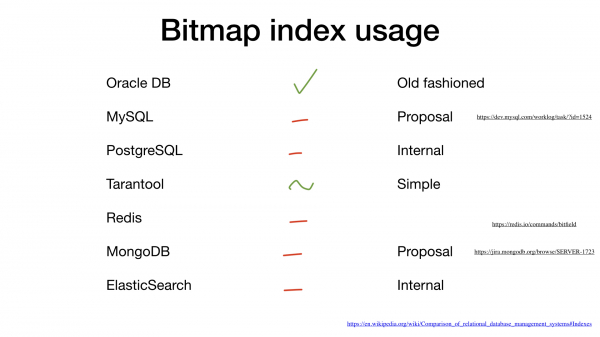
MySQL ondersteunt nog geen bitmap-indexen, maar er is een voorstel om deze optie toe te voegen ().
PostgreSQL ondersteunt bitmap-indexen niet, maar gebruikt eenvoudige bitmaps en bitbewerkingen om de zoekresultaten van verschillende andere indexen te combineren.
Tarantool heeft bitset-indexen, het ondersteunt eenvoudige zoekopdrachten erop.
Redis heeft eenvoudige bitvelden) zonder zoekmogelijkheden.
MongoDB ondersteunt nog geen bitmap-indexen, maar er is ook een voorstel om deze optie toe te voegen.
Elasticsearch gebruikt bitmaps binnenin).
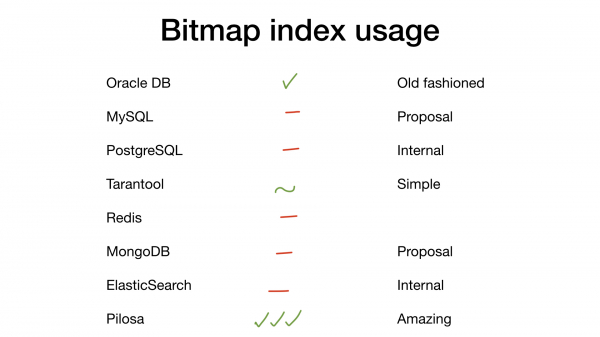
- Maar er is een nieuwe buur in ons huis: Pilosa. Dit is een nieuwe niet-relationele database, geschreven in Go. Het bevat alleen bitmap-indexen en is volledig daarop gebaseerd. We zullen het er later over hebben.
Implementatie in Go
Maar waarom worden bitmap-indexen zo zelden gebruikt? Voordat ik deze vraag beantwoord, wil ik je een implementatie van een zeer eenvoudige bitmap-index in Go laten zien.
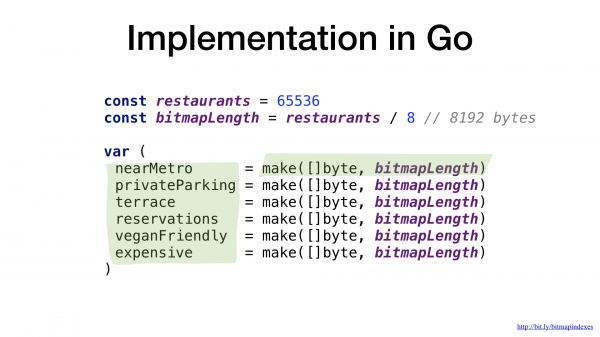
Bitmaps worden in wezen eenvoudig voorgesteld als datablokjes. Laten we in Go hiervoor gebruikmaken van byte-slices.
We hebben één bitmap voor één restaurantkenmerk, en elke bit in de bitmap geeft aan of een specifiek restaurant dat kenmerk heeft of niet.
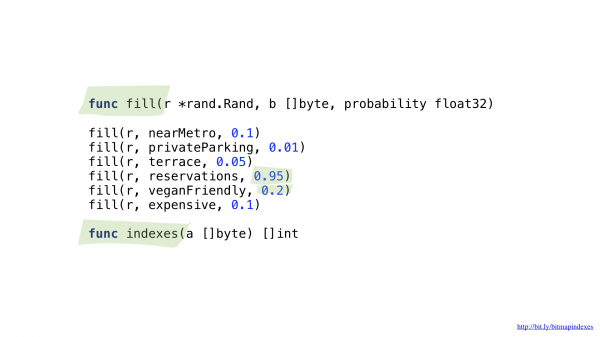
We hebben twee hulpfuncties nodig. Eén zal worden gebruikt om onze bitmaps met willekeurige gegevens te vullen. Willekeurige gegevens, maar met een bepaalde waarschijnlijkheid dat een restaurant elk kenmerk heeft. Bijvoorbeeld, ik denk dat er in Moskou heel weinig restaurants zijn waar je geen tafel kunt reserveren, en ik denk dat ongeveer 20% van de etablissementen geschikt is voor vegetariërs.
De tweede functie zal de bitmap omzetten in een lijst van restaurants.
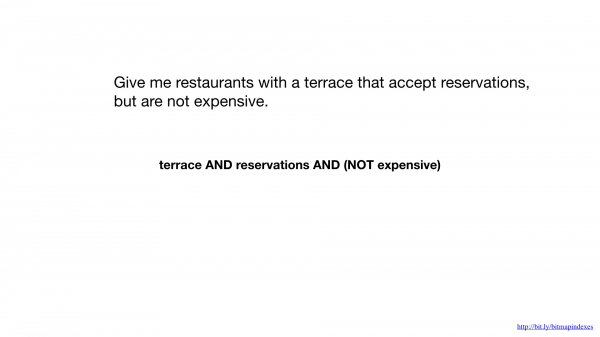
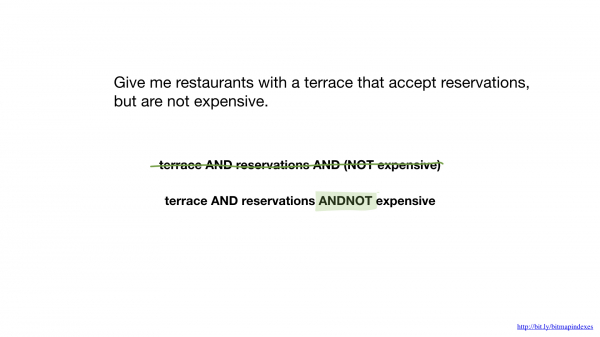
Om te beantwoorden op de vraag 'Toon me goedkope restaurants met een veranda waar je een tafel kunt reserveren', hebben we twee bitoperaties nodig: NOT en AND.
We kunnen onze code een beetje vereenvoudigen door gebruik te maken van een geavanceerdere operatie AND NOT.
We hebben functies voor elke van deze bewerkingen. Beide gaan over slices, nemen de corresponderende elementen uit elk en combineren ze met een bitoperatie, waarna het resultaat in de resultaat slice wordt geplaatst.
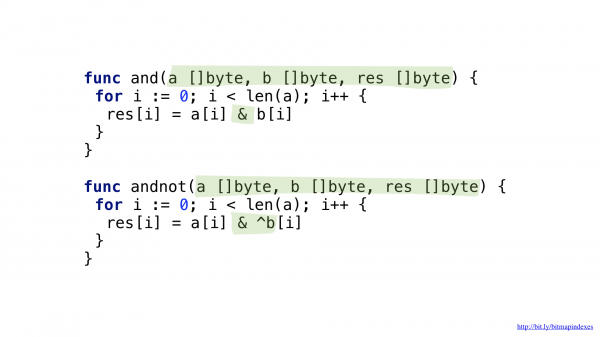
En nu kunnen we onze bitmaps en functies gebruiken om op het zoekverzoek te reageren.
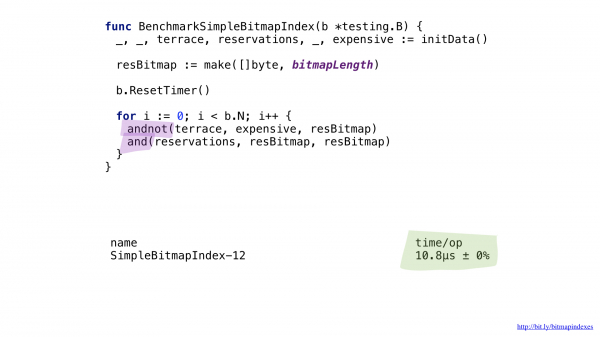
De prestaties zijn niet zo hoog, ook al zijn de functies heel eenvoudig en hebben we goed bespaard door niet bij elke functie-aanroep een nieuwe resultaten slice terug te geven.
Na wat profilering met pprof merkte ik dat de Go-compiler een heel eenvoudige, maar belangrijke optimalisatie miste: function inlining.
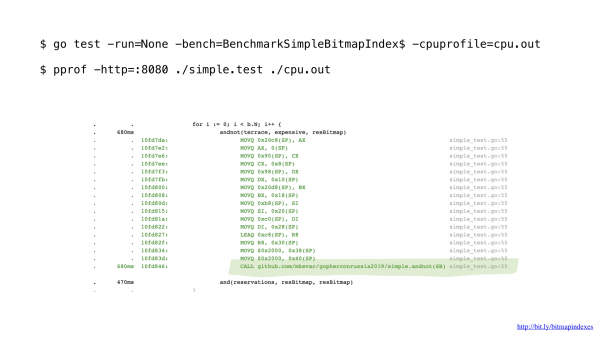
Het probleem is dat de Go-compiler bang is voor lussen die over slices gaan, en categorisch weigert om functies in te line te zetten die zulke lussen bevatten.
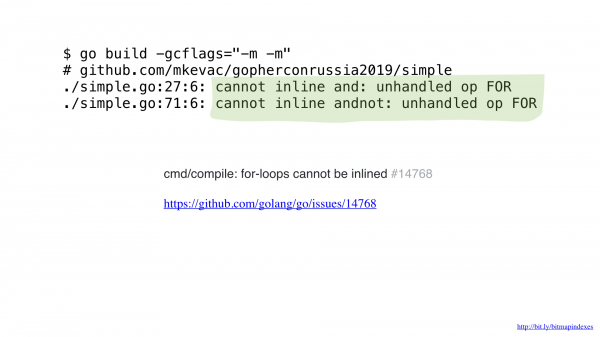
Maar ik ben daar niet bang voor en kan de compiler bedriegen door goto in plaats van een lus te gebruiken, zoals in de goede oude tijd.
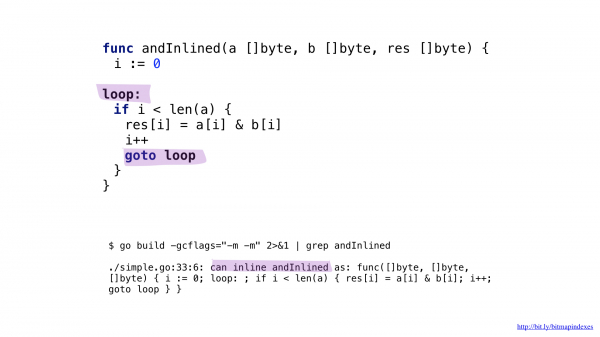
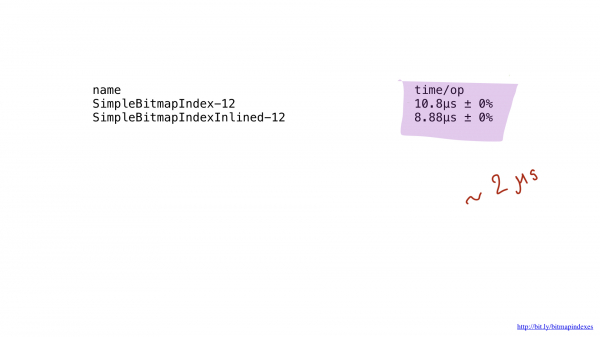
En zoals je kunt zien, inline de compiler nu onze functie met plezier! Uiteindelijk besparen we ongeveer 2 microseconden. Niet slecht!
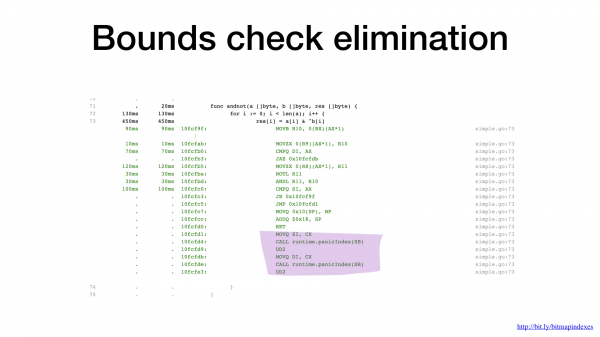
Het tweede knelpunt is gemakkelijk te zien als je goed naar de assembly-output kijkt. De compiler heeft een slice-bereikcontrole toegevoegd in onze heetste lus. Het punt is dat Go een veilige taal is; de compiler is bezorgd dat mijn drie argumenten (drie slices) verschillende groottes hebben. Er zou dan theoretisch de mogelijkheid kunnen zijn van een buffer overflow.
Laten we de compiler geruststellen door hem te laten zien dat alle slices dezelfde grootte hebben. We kunnen dit doen door een eenvoudige controle aan het begin van onze functie toe te voegen.
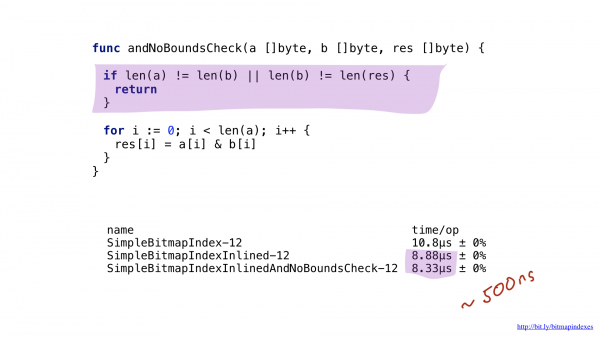
Daarop laat de compiler blij de controle voorbijgaan, en zo besparen we nog eens 500 nanoseconden.
Grote batches
Oké, we hebben enige prestaties uit onze eenvoudige implementatie gehaald, maar dit resultaat is eigenlijk veel slechter dan mogelijk met de huidige hardware.
Alles wat we doen, zijn basis bitbewerkingen, en onze processoren voeren deze zeer efficiënt uit. Maar helaas 'voeden' we onze processor met heel kleine stukjes werk. Onze functies voeren operaties byte voor byte uit. We kunnen onze code heel eenvoudig tweaken zodat deze met 8-byte stukken werkt door UInt64-slices te gebruiken.
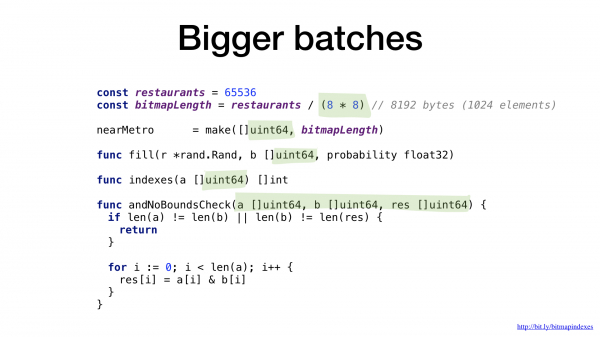
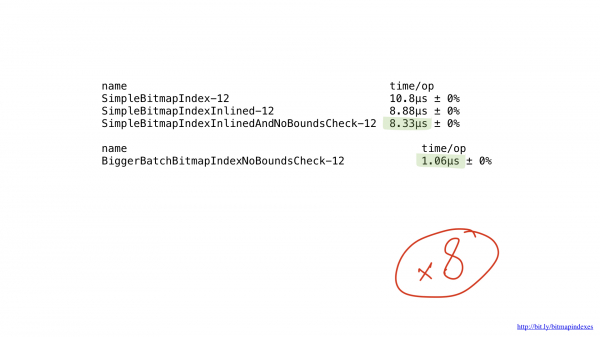
Zoals je kunt zien, heeft deze kleine wijziging ons programma acht keer versneld door de batchgrootte acht keer te vergroten. De winst kan als lineair worden beschouwd.
Implementatie in assembly
Maar dit is nog niet het einde. Onze processoren kunnen werken met stukken van 16, 32 en zelfs 64 byte. Dergelijke 'brede' operaties worden single instruction multiple data (SIMD) genoemd, en het proces van het transformeren van code zodat deze dergelijke operaties gebruikt, wordt vectorisatie genoemd.
Helaas is de Go-compiler geen ster in vectorisatie. Op dit moment is de enige manier om code in Go te vectoriseren door de gegevensbewerkingen handmatig met Go-assembly te schrijven.
Go-assembly is een vreemd beest. Je weet waarschijnlijk dat assembly sterk aan de architectuur van de computer is gekoppeld waarvoor je schrijft, maar in Go is dat niet het geval. Go-assembly lijkt meer op IRL (intermediate representation language) of een tussenliggende taal: het is vrijwel platformonafhankelijk. Rob Pike heeft enkele jaren geleden een uitstekende lezing hierover gegeven op GopherCon in Denver.
Daarnaast gebruikt Go een ongebruikelijk formaat, Plan 9, dat verschilt van de algemeen erkende formaten AT&T en Intel.
Je kunt met zekerheid zeggen dat het schrijven van Go-assembly met de hand geen geweldige tijdverdrijf is.
Maar gelukkig zijn er al twee krachtige tools die ons helpen bij het schrijven van Go-assembly: PeachPy en avo. Beide tools genereren Go-assembly uit hoger niveau code, geschreven in respectievelijk Python en Go.
Deze hulpprogramma's vereenvoudigen zaken zoals registerallocatie, het schrijven van lussen, en maken over het algemeen de toegang tot de wereld van assemblertaalprogrammering in Go gemakkelijker.
We zullen avo gebruiken, zodat onze programma's bijna gewone Go-programma's zullen zijn.
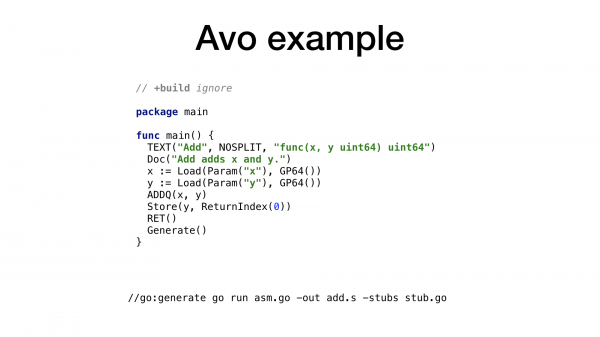
Zo ziet het eenvoudigste voorbeeld van een avo-programma eruit. We hebben een functie main() die daarin de functie Add() definieert, die bedoeld is om twee getallen op te tellen. Hier zijn hulpfuncties aanwezig voor het verkrijgen van parameters op basis van naam en het verkrijgen van een van de beschikbare en geschikte registers. Voor elke processorbewerking is er een overeenkomstige functie in avo, zoals te zien is bij ADDQ. En tenslotte zien we een hulpfunctie voor het opslaan van de resulterende waarde.
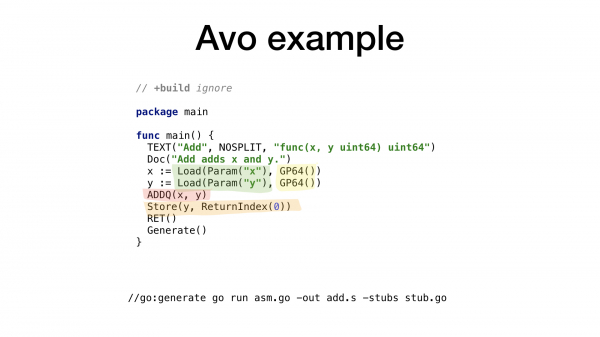
Door go generate aan te roepen, voeren we het programma op avo uit en er worden uiteindelijk twee bestanden gegenereerd:
- add.s met de resulterende code in Go-assemblertaal;
- stub.go met functiekopteksten voor de verbinding tussen de twee werelden: Go en assembler.
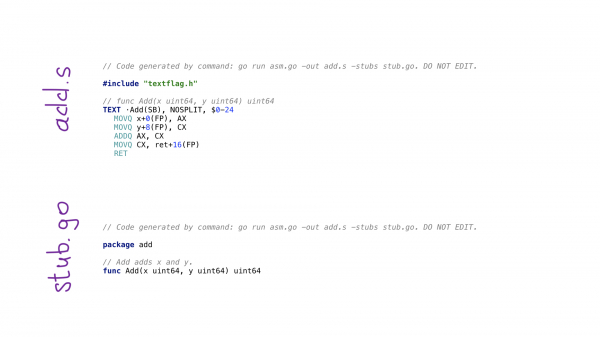
Nu we hebben gezien wat avo doet, laten we naar onze functies kijken. Ik heb zowel de scalare als de vectorversies (SIMD) van de functies geïmplementeerd.
Laten we eerst naar de scalare versies kijken.
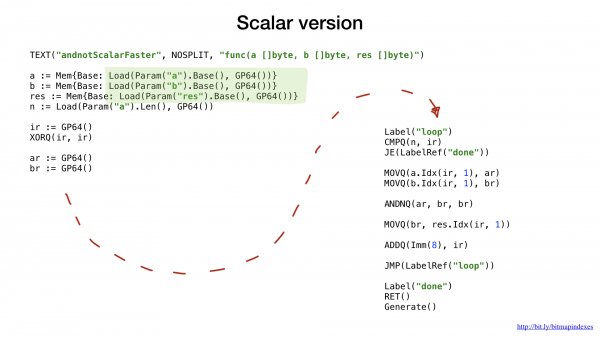
Zoals in het vorige voorbeeld vragen we om een vrij en correct algemeen register, hoeven we geen offset en grootte voor argumenten te berekenen. Dit doet avo allemaal voor ons.
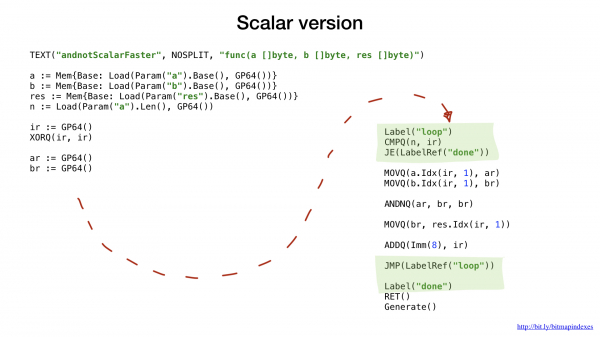
Eerder gebruikten we labels en goto (of sprongen) om de prestaties te verbeteren en de Go-compiler te misleiden, maar nu doen we dit vanaf het begin. Het punt is dat lussen een hoger niveau begrip zijn. In assembler hebben we slechts labels en sprongen.
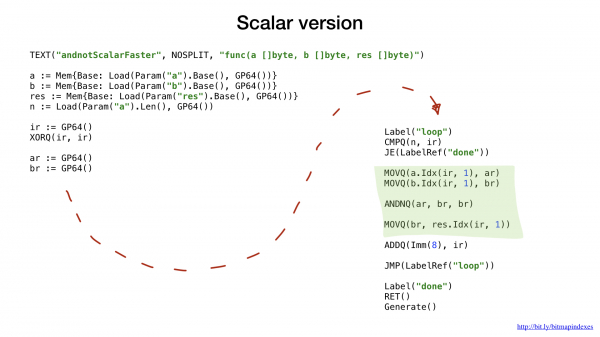
De resterende code zou je al bekend en begrijpelijk moeten zijn. We emuleren de lus met labels en sprongen, nemen een klein deel van de gegevens uit onze twee slices, combineren deze met een bitbewerking (AND NOT in dit geval) en plaatsen vervolgens het resultaat in de resulterende slice. Dat is alles.
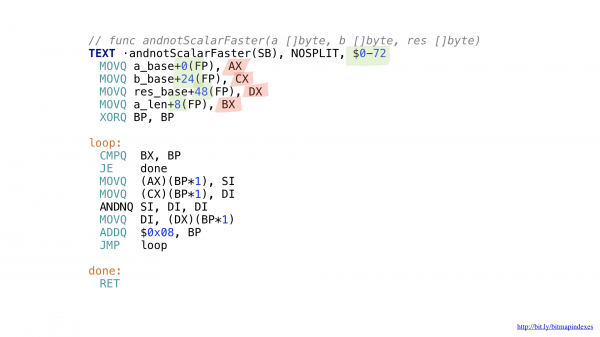
Zo ziet de uiteindelijke code in assembler eruit. We hoefden geen offsets en groottes te berekenen (gemarkeerd in groen) of toezicht te houden op de gebruikte registers (gemarkeerd in rood).
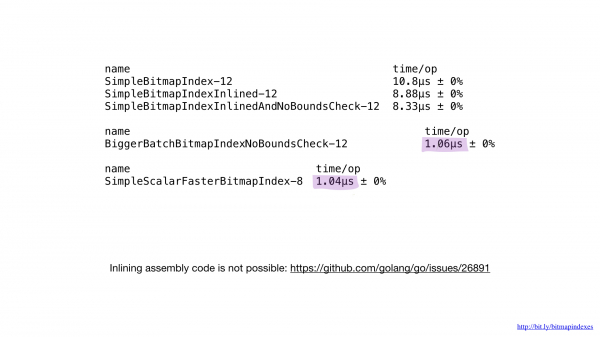
Als we de prestaties van de implementatie in assembly vergelijken met die van de beste implementatie in Go, zien we dat ze gelijk zijn. Dat is te verwachten. We hebben immers niets bijzonders gedaan — we hebben alleen gereproduceerd wat de Go-compiler zou doen.
Helaas kunnen we de compiler niet dwingen om onze in assembly geschreven functies inline te maken. De Go-compiler heeft momenteel niet de mogelijkheid om dit te doen, hoewel het verzoek om deze functie al geruime tijd bestaat.
Daarom is het onmogelijk om enige voordelen te halen uit kleine functies in assembly. We moeten ofwel grote functies schrijven, of de nieuwe package math/bits gebruiken, of assembly vermijden.
Laten we nu eens kijken naar de vectorversies van onze functies.
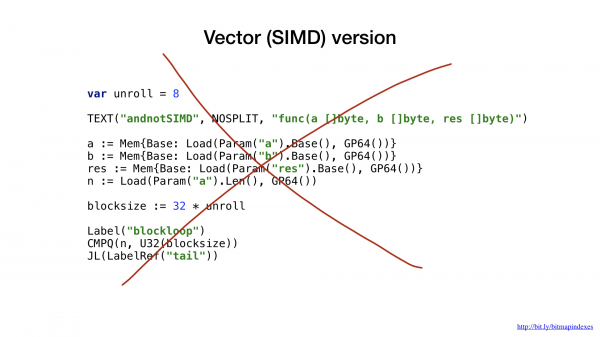
Voor dit voorbeeld heb ik besloten om AVX2 toe te passen, dus we zullen bewerkingen gebruiken die werken met 32-byte blokken. De structuur van de code lijkt erg op die van de scalairvariant: parameters laden, verzoeken om een vrije algemene register, enzovoort.
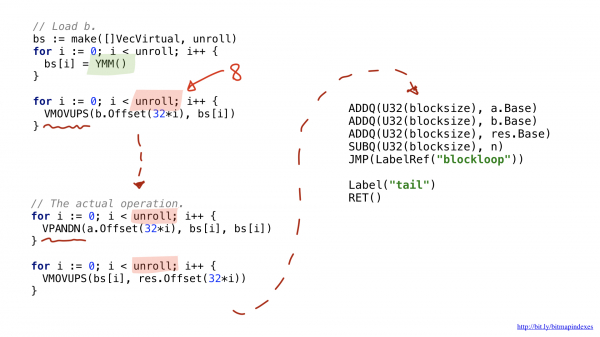
Een van de nieuwigheden is dat bredere vectorbewerkingen speciale brede registers gebruiken. Voor 32-byte blokken zijn dit de registers met de prefix Y. Daarom zie je de functie YMM() in de code. Als ik AVX-512 met 64-bit blokken had gebruikt, zou de prefix Z zijn.
Een tweede nieuwigheid is dat ik besloot een optimalisatie toe te passen die loop unrolling wordt genoemd, dat wil zeggen, acht loopbewerkingen handmatig te doen voordat ik naar het begin van de loop spring. Deze optimalisatie vermindert het aantal branches in de code en is beperkt door het aantal beschikbare vrije registers.
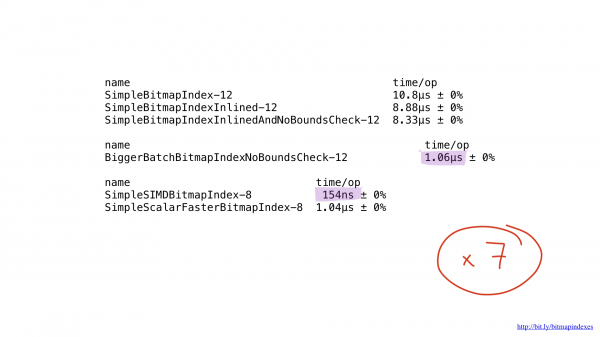
Maar hoe zit het met de prestaties? Die zijn geweldig! We hebben een versnellingsfactor van ongeveer zeven keer bereikt in vergelijking met de beste oplossing in Go. Indrukwekkend, nietwaar?
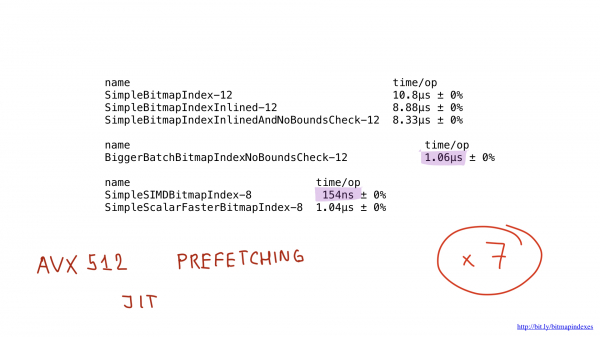
Maar zelfs deze implementatie zou potentieel versneld kunnen worden met behulp van AVX-512, prefetching of JIT (just-in-time compiler) voor de query planner. Maar dat is zeker een onderwerp voor een aparte presentatie.
Problemen met bitmap-indexen
Nu we de eenvoudige implementatie van bitmap-indexen in Go en de veel productievere implementatie in assembly hebben bekeken, laten we eindelijk bespreken waarom bitmap-indexen zo zelden worden gebruikt.
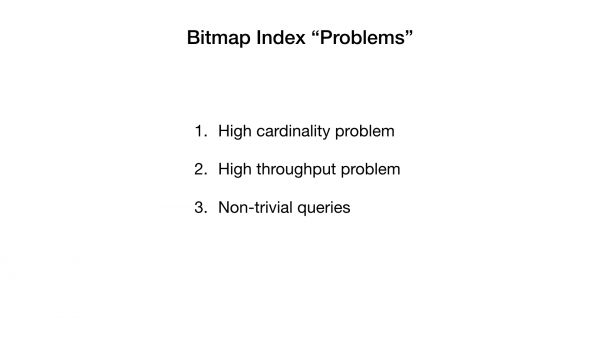
In oude wetenschappelijke werken worden drie problemen van bitmap-indexen genoemd, maar recentere studies en ik beweren dat deze al verouderd zijn. Laten we niet te diep op elk van deze problemen ingaan, maar een oppervlakkige beschouwing geven.
Probleem van hoge cardinaliteit
Men zegt ons dus dat bitmap-indexen alleen geschikt zijn voor velden met een lage cardinaliteit, dat wil zeggen velden met weinig waarden (zoals geslacht of oogkleur), en de reden is dat de gebruikelijke representatie van dergelijke velden (één bit per waarde) in het geval van hoge cardinaliteit te veel ruimte zou innemen en bovendien deze bitmap-indexen slecht (zelden) gevuld zouden zijn.
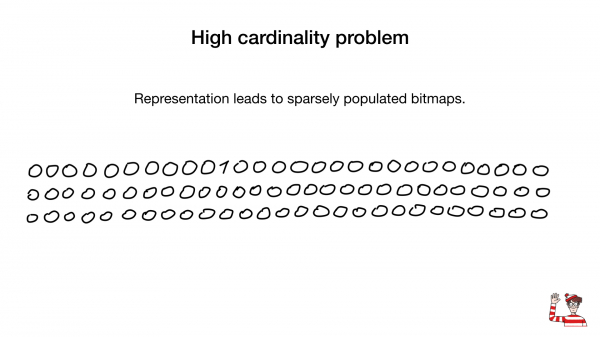
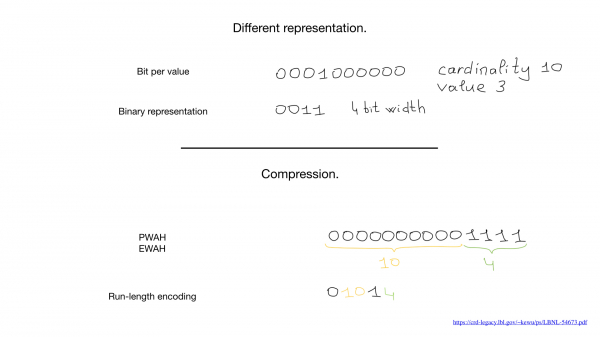
Soms kunnen we een andere representatie gebruiken, bijvoorbeeld de standaardrepresentatie die we voor getallen gebruiken. Maar het was de ontwikkeling van compressie-algoritmen die alles veranderde. In de afgelopen decennia hebben wetenschappers en onderzoekers een groot aantal compressie-algoritmen voor bitmap-gegevens bedacht. Hun belangrijkste voordeel is dat we de bitmaps niet hoeven te decomprimeren om bitbewerkingen uit te voeren — we kunnen bitbewerkingen direct op de gecomprimeerde bitmaps uitvoeren.
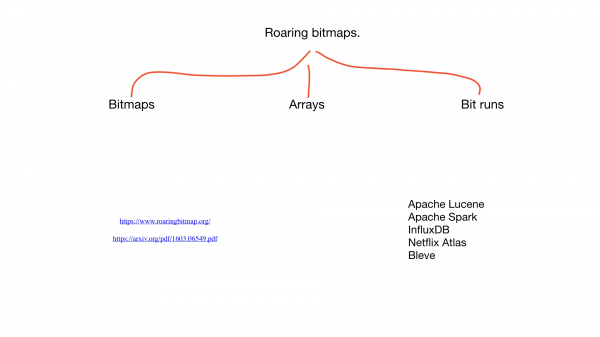
Onlangs zijn ook hybride benaderingen ontstaan, zoals roaring bitmaps. Ze gebruiken tegelijkertijd drie verschillende representaties voor bitmaps — echte bitmaps, arrays en zogenaamde bit runs — en balanceren tussen deze om de prestaties te maximaliseren en het geheugenverbruik te minimaliseren.
Je kunt roaring bitmaps tegenkomen in de meest populaire applicaties. Er zijn al talloze implementaties voor verschillende programmeertalen, waaronder meer dan drie implementaties voor Go.
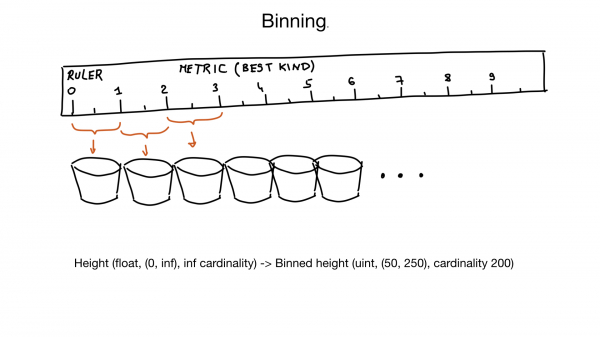
Een andere aanpak die ons kan helpen omgaan met hoge cardinaliteit, heet groepering (binning). Stel je voor dat je een veld hebt dat de lengte van een persoon vertegenwoordigt. Lengte is een getal met een decimale komma, maar wij mensen denken daar niet zo over. Voor ons maakt het niet uit of iemand 185,2 cm of 185,3 cm lang is.
Dus we kunnen vergelijkbare waarden binnen 1 cm groeperen.
En als we ook weten dat er zeer weinig mensen zijn die een lengte hebben van minder dan 50 cm of meer dan 250 cm, kunnen we het veld met oneindige cardinaliteit in feite omzetten in een veld met ongeveer 200 waarden.
Natuurlijk kunnen we indien nodig extra filtering toepassen.
Het probleem van hoge doorvoersnelheid
Een volgend probleem van bitmap-indexen is dat hun bijwerking zeer kostbaar kan zijn.
Databases moeten in staat zijn om gegevens bij te werken op het moment dat potentieel honderden andere aanvragen deze gegevens doorzoeken. We hebben locks nodig om problemen met gelijktijdige toegang tot gegevens of andere problemen met gedeelde toegang te vermijden. En waar er één grote lock is, is er een probleem — lock contention, wanneer die lock een bottleneck wordt.
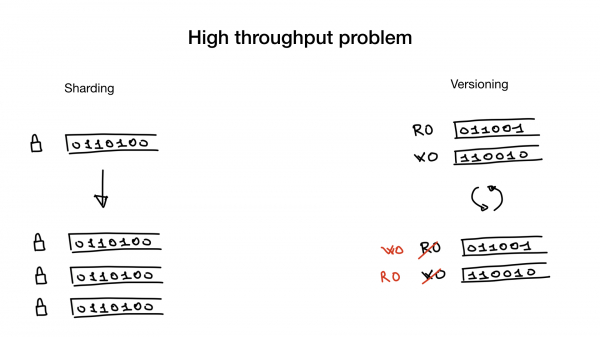
Dit probleem kan worden opgelost of omzeild door sharding of door het gebruik van versieversie-indexen.
Sharding is een eenvoudige en algemeen bekende techniek. U kunt een bitmap-index sharden zoals u andere gegevens zou sharden. In plaats van één grote lock krijgt u verschillende kleine locks en voorkomt u zo lock contention.
Een tweede manier om het probleem op te lossen, is door versieversie-indexen te gebruiken. U kunt één kopie van de index hebben die u gebruikt voor zoeken of lezen, en één voor schrijven of bijwerken. En om de paar tijdseenheden (bijvoorbeeld elke 100 ms of 500 ms) dupliceert u ze en verwisselt u ze. Dit is natuurlijk alleen toepasbaar als uw applicatie kan werken met een iets achterlopende zoekindex.
Deze twee benaderingen kunnen tegelijkertijd worden gebruikt: u kunt een gedistribueerde versieversie-index hebben.
Complexere queries
Het laatste probleem van bitmap-indexen is dat, zoals ons wordt verteld, ze slecht geschikt zijn voor complexere soorten queries, zoals 'tussen'-queries.
En dat is waar, als je erover nadenkt, zijn bitbewerkingen zoals AND, OR enz. niet echt geschikt voor queries als 'Toon mij hotels met kamerprijzen van 200 tot 300 dollar per nacht'.
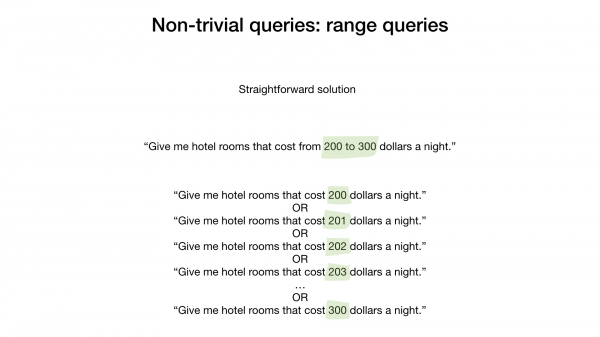
Een naïeve en zeer onredelijke oplossing zou zijn om resultaten voor elke dollarwaarde te nemen en deze samen te voegen met een bitbewerkingsoperatie OR.
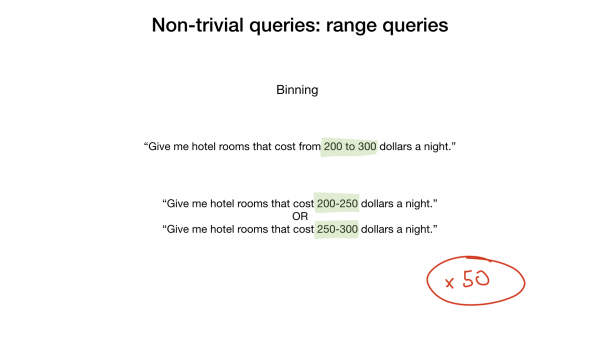
Een iets meer correcte oplossing zou zijn om te groeperen. Bijvoorbeeld in groepen van 50 dollar. Dit zou ons proces met 50 keer versnellen.
Maar het probleem kan ook eenvoudig worden opgelost door gebruik te maken van een representatie die speciaal is gemaakt voor dit soort verzoeken. In wetenschappelijke werken wordt dit range-encoded bitmaps genoemd.
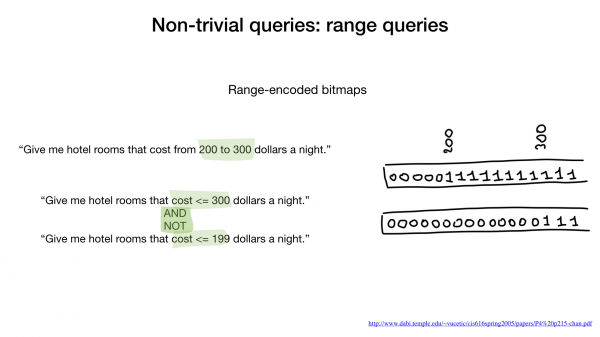
In zo'n representatie stellen we niet gewoon een bit in voor een bepaalde waarde (bijvoorbeeld 200), maar stellen we deze waarde in en alles wat daarboven ligt. 200 en hoger. Hetzelfde geldt voor 300: 300 en hoger. En ga zo verder.
Door deze representatie te gebruiken, kunnen we dit soort zoekopdrachten beantwoorden door slechts twee keer door de index te gaan. Eerst krijgen we een lijst met hotels waar de kamerprijs minder is dan 300 dollar, en vervolgens verwijderen we de hotels waar de kamerprijs minder is dan 199 dollar. Klaar.
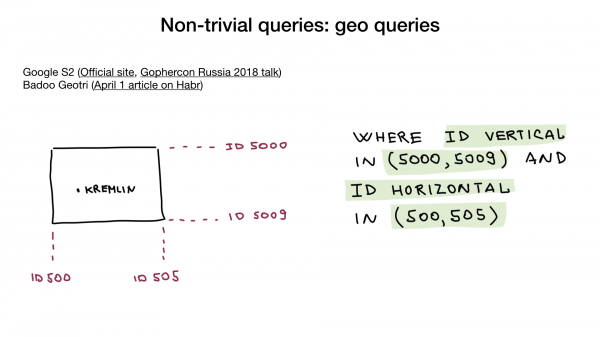
Je zult het misschien niet geloven, maar zelfs geografische verzoeken zijn mogelijk met bitmap-indexen. De truc is om een georepresentatie te gebruiken die je coördinaat omringt met een geometrische figuur. Bijvoorbeeld, S2 van Google. De figuur moet kunnen worden voorgesteld als drie of meer intersecterende rechte lijnen die genummerd kunnen worden. Op deze manier kunnen we ons geografische verzoek omzetten in verschillende "interval" verzoeken (langs deze genummerde lijnen).
Kant-en-klare oplossingen
Ik hoop dat ik je een beetje heb geïnteresseerd en dat je een nuttige tool aan je arsenaal hebt toegevoegd. Als je ooit zoiets moet doen, weet je in welke richting je moet kijken.
Echter, niet iedereen heeft de tijd, geduld en middelen om bitmap-indexen vanaf nul op te bouwen. Vooral de geavanceerdere, met behulp van SIMD, bijvoorbeeld.
Gelukkig zijn er een aantal kant-en-klare oplossingen die je kunnen helpen.
Roaring bitmaps
Ten eerste is er de roaring bitmaps-bibliotheek waar ik het al over had. Deze bevat alle benodigde containers en bitbewerkingen die je nodig hebt om een volledige bitmap-index te maken.
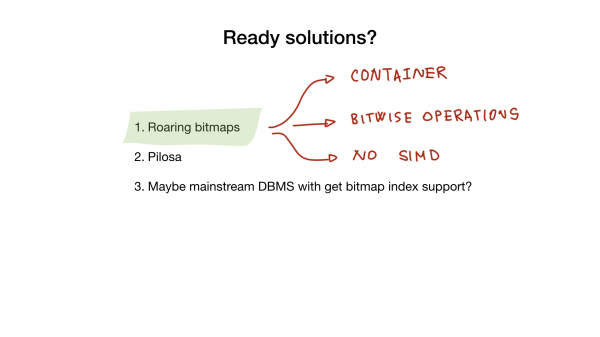
Helaas maakt geen van de Go-implementaties op dit moment gebruik van SIMD, wat betekent dat de Go-implementaties minder efficiënt zijn dan bijvoorbeeld de implementaties in C.
Pilosa
Een ander product dat je kan helpen is de database Pilosa, die in wezen alleen bitmap-indexen heeft. Dit is een relatief nieuwe oplossing, maar het verovert snel de harten.
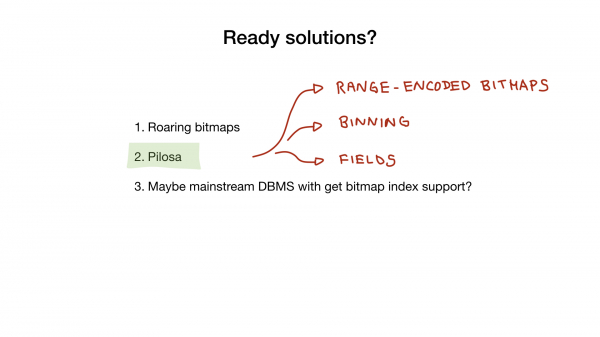
Pilosa maakt gebruik van roaring bitmaps en biedt je de mogelijkheid om deze te gebruiken, en vereenvoudigt en verklaart alles wat ik eerder heb besproken: groepering, range-gecodeerde bitmaps, het concept van een veld, enzovoort.
Laten we snel kijken naar een voorbeeld van het gebruik van Pilosa om een vraag te beantwoorden die je al bekend is.
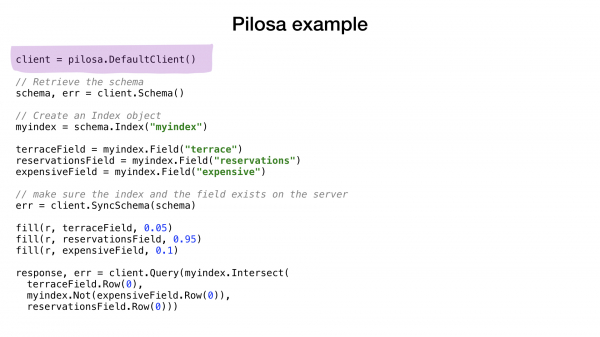
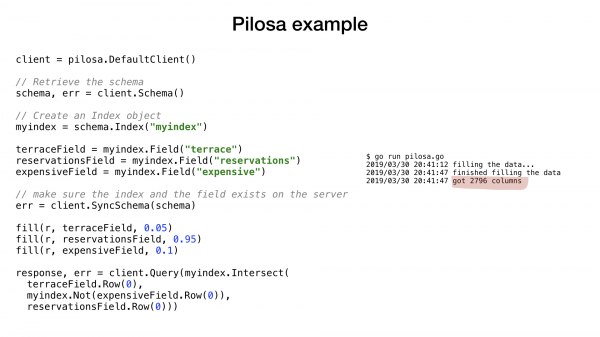
Het voorbeeld lijkt sterk op wat je eerder hebt gezien. We maken een client voor de Pilosa-server, creëren een index en de benodigde velden, vullen vervolgens onze velden met willekeurige gegevens op basis van kansen en tenslotte voeren we de bekende query uit.
Daarna gebruiken we NOT op het veld 'expensive', kruisen vervolgens het resultaat (of AND) met het veld 'terrace' en met het veld 'reservations'. En uiteindelijk krijgen we het eindresultaat.
Ik hoop echt dat in de nabije toekomst dit nieuwe type indexen — bitmap-indexen — ook beschikbaar komt in databases zoals MySQL en PostgreSQL.
Conclusie
Als je nog niet in slaap bent gevallen, bedankt. Ik moest verschillende onderwerpen vluchtig aanstippen vanwege de beperkte tijd, maar ik hoop dat de presentatie nuttig en misschien zelfs inspirerend was.
Het is goed om iets te weten over bitmap-indexen, zelfs als je ze op dit moment niet nodig hebt. Laat ze een extra gereedschap in je gereedschapskist zijn.
We hebben verschillende trucs bekeken om de prestaties voor Go te verbeteren en de dingen waarmee de Go-compiler momenteel nog niet zo goed overweg kan. Dit is absoluut nuttig om te weten voor elke Go-programmeur.
Dat is alles wat ik wilde vertellen. Dank je!
Bron: habr.com
