

dit is een standaard (ISO, ITU-T, ГОСТ) voor een taal die gestructureerde informatie beschrijft, evenals de regels voor het coderen van deze informatie. Voor mij als programmeur is het gewoon weer een formaat voor serialisatie en gegevensrepresentatie, naast JSON, XML, XDR en anderen. Het is extreem wijdverspreid in ons dagelijkse leven en velen komen ermee in aanraking: in mobiele, telefonie, VoIP-communicatie (UMTS, LTE, WiMAX, SS7, H.323), in netwerkprotocollen (LDAP, SNMP, Kerberos), in alles wat met cryptografie te maken heeft (X.509, CMS, PKCS-standaarden), op bankkaarten en biometrische paspoorten, en nog veel meer.
Dit artikel bespreekt : Python ASN.1 bibliotheek die actief wordt toegepast in projecten gerelateerd aan cryptografie in .
Eigenlijk is het niet aan te raden om ASN.1 voor cryptografische taken te gebruiken: ASN.1 en zijn codecs zijn complex. Dit betekent dat de code niet eenvoudig zal zijn, en dit is altijd een extra aanvalsvector. Het is voldoende om te kijken van kwetsbaarheden in ASN.1 bibliotheken. Bruce Schneier raadt in zijn ook aan om deze standaard vanwege de complexiteit niet te gebruiken: „De bekendste TLV-codering is ASN.1, maar het is ongelooflijk complex en we schuwen het“. Maar helaas hebben we vandaag de dag waarin actief gebruik wordt gemaakt van , CRL, OCSP, TSP, CMP-protocollen, , berichten , en een heleboel standaarden . Daarom moeten we leren om met ASN.1 te werken als je met iets cryptografisch bezig bent.
ASN.1 kan op veel manieren/codecs worden gecodeerd:
- (Basic Encoding Rules)
- (Canonical Encoding Rules)
- (Distinguished Encoding Rules)
- (Generic String Encoding Rules)
- (JSON Encoding Rules)
- LWER (Light Weight Encoding Rules)
- (Octet Encoding Rules)
- (Packed Encoding Rules)
- SER (Signalling specific Encoding Rules)
- (XML Encoding Rules)
en een aantal anderen. Maar in cryptografische taken worden in de praktijk meestal twee gebruikt: BER en DER. Zelfs in ondertekende XML-documenten (, ) zullen er nog steeds Base64-gecodeerde ASN.1 DER-objecten zijn, zoals in het JSON-georiënteerde protocol van Let’s Encrypt. Het is beter om alle deze codecs en coderingprincipes van BER/CER/DER te begrijpen in artikelen en boeken: , , .
BER is een binaire byte-georiënteerde (bijvoorbeeld PER, populair in de mobiele communicatie — bit-georiënteerd) TLV-formaat. Elk element wordt gecodeerd als: een tag (Tag), die het type van het gecodeerde element identificeert (geheel getal, string, datum, enz.), lengte (Llengte) van de inhoud en de inhoud zelf (Vwaarde). BER stelt optioneel in staat om geen lengtewaarde op te geven, door een speciaal onbepaald lengtewaarde in te stellen en de boodschap te beëindigen met een End-Of-Octets-label. Naast de lengtecodering heeft BER veel variabiliteit in de manier van codering van datatypen, zoals bijvoorbeeld:
- INTEGER, OBJECT IDENTIFIER, BIT STRING en de lengte van elementen kunnen niet genormaliseerd zijn (niet gecodeerd in de minimale vorm);
- BOOLEAN is waar bij elke niet-nul inhoud;
- BIT STRING kan 'overbodige' nul-bits bevatten;
- BIT STRING, OCTET STRING en al hun afgeleide stringtypen, inclusief datum/tijd, kunnen worden opgedeeld in variabele lengtestukken, waarvan de lengte tijdens (de)codering niet van tevoren bekend is;
- UTCTime/GeneralizedTime kunnen verschillende manieren hebben om de tijdzone-offset en 'overbodige' nul-secties op te geven;
- DEFAULT waarden van SEQUENCE kunnen gecodeerd worden, maar dat hoeft niet;
- Genoemde waarden van de laatste bits in de BIT STRING kunnen naar keuze niet gecodeerd worden;
- SEQUENCE (OF)/SET (OF) kunnen een willekeurige volgorde van elementen hebben.
Vanwege het bovenstaande is het niet altijd mogelijk om gegevens zo te coderen dat ze identiek zijn aan de originele vorm. Daarom zijn er een subset van regels uitgevonden: DER - dat strikt slechts één geldige manier van codering voorschrijft, wat kritiek is voor cryptografische taken, waar bijvoorbeeld het wijzigen van één bit de handtekening of controlewaarde ongeldig maakt. DER heeft een aanzienlijk nadeel: de lengtes van alle elementen moeten tijdens het coderen vooraf bekend zijn, wat streaming serialisatie van gegevens niet mogelijk maakt. CER-codec mist deze tekortkoming en garandeert ook een eenduidige weergave van gegevens. Helaas (of gelukkig dat we nog geen complexere decoders hebben?), werd het niet populair. Daarom komen we in de praktijk 'gemengd' gebruik van BER- en DER-gecodeerde gegevens tegen. Aangezien zowel CER als DER subsets van BER zijn, kan elke BER-decoder ze verwerken.
Problemen met pyasn1
Op ons werk schrijven we veel Python-programma's die verband houden met cryptografie. En enkele jaren geleden waren er bijna geen gratis bibliotheken: ofwel zijn het zeer laag-niveau bibliotheken die alleen het coderen/decoderen van bijvoorbeeld een geheel getal en de header van een structuur mogelijk maken, of het is de bibliotheek . We hebben er enkele jaren gewoond en in het begin waren we erg tevreden, omdat het ons in staat stelde om met ASN.1-structuren te werken als met hoogwaardige objecten: bijvoorbeeld, het gedecodeerde X.509-certificaatobject stelt ons in staat om toegang te krijgen tot zijn velden via een woordenboekinterface: cert["tbsCertificate"]["serialNumber"] toont ons het serienummer van dit certificaat. Evenzo kunnen we complexe objecten 'bouwen' door met hen te werken als met lijsten en woordenboeken, en daarna gewoon de functie pyasn1.codec.der.encoder.encode aanroepen om de geserialiseerde weergave van het document te krijgen.
Echter, er kwamen tekortkomingen, problemen en beperkingen aan het licht. In pyasn1 waren er en, helaas, zijn er nog steeds fouten: op het moment van schrijven van dit artikel, werd een van de basis types in pyasn1 - GeneralizedTime, gedecodeerd en gecodeerd.
In onze projecten slaan we vaak alleen het pad naar het bestand, de offset en de lengte in bytes op van het object waar we naar willen verwijzen, om ruimte te besparen. Bijvoorbeeld, een willekeurig ondertekend bestand gaat waarschijnlijk worden gevonden in de CMS SignedData ASN.1-structuur:
  0     [1,3,1018]  ContentInfo SEQUENCE
  4     [1,1,   9]   . contentType: ContentType OBJECT IDENTIFIER 1.2.840.113549.1.7.2 (id_signedData)
 19-4   [0,0,1003]   . content: [0] EXPLICIT [UNIV 16] ANY
 19     [1,3, 999]   . . DEFINED BY id_signedData: SignedData SEQUENCE
 23     [1,1,   1]   . . . version: CMSVersion INTEGER v3 (03)
 26     [1,1,  19]   . . . digestAlgorithms: DigestAlgorithmIdentifiers SET OF
                           [...]
 47     [1,3, 769]   . . . encapContentInfo: EncapsulatedContentInfo SEQUENCE
 51     [1,1,   8]   . . . . eContentType: ContentType OBJECT IDENTIFIER 1.3.6.1.5.5.7.12.2 (id_cct_PKIData)
 65-4   [1,3, 751]   . . . . eContent: [0] EXPLICIT OCTET STRING 751 bytes OPTIONAL

                 HIER IS DE INHOUD VAN HET TE ONDERTEKENEN BESTAND VAN 751 BYTE

820     [1,2, 199]   . . . signerInfos: SignerInfos SET OF
823     [1,2, 196]   . . . . 0: SignerInfo SEQUENCE
826     [1,1,   1]   . . . . . version: CMSVersion INTEGER v3 (03)
829     [0,0,  22]   . . . . . sid: SignerIdentifier CHOICE subjectKeyIdentifier
                               [...]
956     [1,1,  64]   . . . . . signature: SignatureValue OCTET STRING 64 bytes
                     . . . . . . C1:B3:88:BA:F8:92:1C:E6:3E:41:9B:E0:D3:E9:AF:D8
                     . . . . . . 47:4A:8A:9D:94:5D:56:6B:F0:C1:20:38:D2:72:22:12
                     . . . . . . 9F:76:46:F6:51:5F:9A:8D:BF:D7:A6:9B:FD:C5:DA:D2
                     . . . . . . F3:6B:00:14:A4:9D:D7:B5:E1:A6:86:44:86:A7:E8:C9
en we kunnen het originele ondertekende bestand ophalen met een offset van 65 bytes, met een lengte van 751 bytes. pyasn1 slaat deze informatie niet op in zijn gedecodeerde objecten. Een zogenaamde TLVSeeker is geschreven — een kleine bibliotheek die het mogelijk maakt om tags en lengtes van objecten te decoderen, waarin we commando's gaven als "ga naar de volgende tag", "ga naar binnen in de tag" (we gaan naar binnen in het SEQUENCE-object), "ga naar de volgende tag", "geef je offset en de lengte van het object waar we zijn". Dit was 'handmatig' navigeren door ASN.1 DER-geserialiseerde gegevens. Maar zo kon men niet werken met BER-geserialiseerde gegevens, omdat bijvoorbeeld de byte-reeks OCTET STRING in meerdere chunk-achtige vormen gecodeerd kon zijn.
Een ander nadeel voor onze doeleinden met pyasn1 is de onmogelijkheid om te begrijpen of een bepaald veld wel of niet aanwezig was in het SEQUENCE op basis van de gedecodeerde objecten. Bijvoorbeeld, als de structuur het veld Field SEQUENCE OF Smth OPTIONAL bevat, dan kon het volledig ontbreken in de ontvangen gegevens (OPTIONAL), of het kon aanwezig zijn, maar met een nul-lengte (lege lijst). In het algemeen was dit niet vast te stellen. En dit is noodzakelijk voor een strenge validatie van de ontvangen gegevens. Stel je voor dat een of andere certificeringsautoriteit een certificaat zou uitgeven met "niet helemaal" valide gegevens volgens de ASN.1-schema's! Bijvoorbeeld, de certificeringsautoriteit "TÜRKTRUST Elektronik Sertifika Hizmet Sağlayıcısı" heeft in zijn rootcertificaat de toegestane grenzen overschreden. de grenzen van de lengte van het subjectcomponent — het kan niet eerlijk worden gedecodeerd volgens het schema. De DER-codec vereist dat een veld waarvoor de waarde gelijk is aan DEFAULT, niet wordt gecodeerd bij verzending — in de praktijk komen dergelijke documenten voor en de eerste versie van PyDERASN stond zelfs bewust dit ongeldige (volgens DER) gedrag toe voor de achterwaartse compatibiliteit.
Een ander beperkt punt is het gebrek aan inzicht in welke codering (BER/DER) voor een object in de structuur is gebruikt. Bijvoorbeeld, de CMS-standaard stelt dat een bericht in BER wordt gecodeerd, maar het veld signedAttrs, waarop de cryptografische handtekening wordt gevormd, moet in DER staan. Als we het in DER decoderen, krijgen we problemen met de CMS-verwerking, en als we het in BER decoderen, weten we niet in welke vorm signedAttrs aanwezig was. We moeten uiteindelijk met TLVSeeker (waarvan er geen equivalente is in pyasn1) de locatie van elk van de signedAttrs-velden zoeken en deze afzonderlijk uit het geserialiseerde formaat halen en in DER decoderen.
Een zeer gewilde mogelijkheid voor ons was de automatische verwerking van DEFINED BY-velden, die zeer vaak voorkomen. Na het decoderen van de ASN.1-structuur kunnen er meerdere ANY-velden achterblijven die verder moeten worden verwerkt volgens het schema dat is gekozen op basis van de OBJECT IDENTIFIER die in het structuurveld is opgegeven. In de Python-code betekent dit het schrijven van 'if'-statements en vervolgens het aanroepen van de decoder voor het ANY-veld.
De opkomst van PyDERASN
Bij Atlas sturen we regelmatig patches naar boven als we problemen tegenkomen of verbeteringen aan de gebruikte open-source software aanbrengen. We hebben meerdere keren verbeteringen naar pyasn1 gestuurd, maar de code van pyasn1 is niet de eenvoudigste om te begrijpen en soms vonden er incompatibele API-wijzigingen plaats die ons hinderden. Bovendien waren we gewend om tests te schrijven met generatieve testing, wat in pyasn1 ontbrak.
Op een dag besloot ik dat ik er genoeg van had en dat het tijd was om een eigen bibliotheek te schrijven met __slot__-en, offsets en prachtig weergegeven blobs! Gewoon een ASN.1-codec creëren zou niet voldoende zijn — het was nodig om al onze van elkaar afhankelijke projecten ernaar over te zetten, wat honderden duizenden regels code betekent waarin veel met ASN.1-structuren wordt gewerkt. Dit betekent dat een van de vereisten voor deze bibliotheek de eenvoud van het vertalen van de huidige pyasn1-code is. Ik bracht mijn hele vakantie door om deze bibliotheek te schrijven en alle projecten over te zetten. Aangezien ze praktisch 100% testdekking hebben, betekende dit ook volledige functionaliteit van de bibliotheek.
PyDERASN heeft ook praktisch 100% testdekking. Het maakt gebruik van generatieve testing met een geweldige bibliotheek . Daarnaast is er ook -op 32-core machines. Hoewel we praktisch geen Python2-code meer hebben, blijft PyDERASN compatibiliteit ermee waarborgen en heeft het daardoor een enige afhankelijkheid. Bovendien is het getest tegenover .
De werkwijze is vergelijkbaar met pyasn1 — werken met hoog-niveau objecten in Python. De beschrijving van ASN.1-schema's is vergelijkbaar.
class TBSCertificate(Sequence):
    schema = (
        ("version", Version(expl=tag_ctxc(0), default="v1")),
        ("serialNumber", CertificateSerialNumber()),
        ("signature", AlgorithmIdentifier()),
        ("issuer", Name()),
        ("validity", Validity()),
        ("subject", Name()),
        ("subjectPublicKeyInfo", SubjectPublicKeyInfo()),
        ("issuerUniqueID", UniqueIdentifier(impl=tag_ctxp(1), optional=True)),
        ("subjectUniqueID", UniqueIdentifier(impl=tag_ctxp(2), optional=True)),
        ("extensions", Extensions(expl=tag_ctxc(3), optional=True)),
    )
Echter, PyDERASN heeft een soort strikte typing. In pyasn1, als een veld het type CMSVersion(INTEGER) had, kon daar int of INTEGER aan worden toegewezen. PyDERASN vereist dat het toegewezen object daadwerkelijk CMSVersion is. Bovendien, omdat we Python3-code schrijven, gebruiken we ook , waardoor in onze functies geen onduidelijke argumenten zoals def func(serial, contents) staan, maar def func(serial: CertificateSerialNumber, contents: EncapsulatedContentInfo), en PyDERASN helpt bij het naleven van zulke code.
Bovendien zijn er in PyDERASN zeer handige gemakken bij die typing. pyasn1 stond niet toe om in SubjectKeyIdentifier().subtype(implicitTag=Tag(…)) een SubjectKeyIdentifier() object toe te wijzen (zonder de benodigde IMPLICIT TAG) en men moest vaak objecten kopiëren en opnieuw maken alleen maar vanwege gewijzigde IMPLICIT/EXPLICIT tags. PyDERASN zorgt strikt voor alleen het basis type — de tags worden automatisch uit de bestaande ASN.1 schema structuur ingevoerd. Dit vereenvoudigt de code van applicaties aanzienlijk.
Als er een fout optreedt tijdens het decoderen, is het in pyasn1 moeilijk te begrijpen waar precies deze fout zich heeft voorgedaan. Bijvoorbeeld in het eerder genoemde Turkse certificaat krijgen we de volgende fout: UTF8String (tbsCertificate:issuer:rdnSequence:3:0:value:DEFINED BY 2.5.4.10:utf8String) (bij 138) ontevreden grenzen: 1 ⇐ 77 ⇐ 64. Bij het schrijven van ASN.1 structuren kunnen mensen fouten maken, en dit helpt bij het eenvoudiger debuggen van applicaties of het vaststellen van problemen met gecodeerde documenten van de andere partij.
In de eerste versie van PyDERASN was er geen ondersteuning voor BER-codering. Dit kwam veel later en wordt tot op heden nog niet ondersteund voor UTCTime/GeneralizedTime met tijdzones. Dit zal in de toekomst komen, aangezien het project voornamelijk in de vrije tijd van werk wordt geschreven.
In de eerste versie was er ook geen ondersteuning voor DEFINED BY-velden. Enkele maanden later kwam deze mogelijkheid beschikbaar. class ContentInfo(Sequence): schema = ( ("contentType", ContentType(defines=((("content",), { id_authenticatedData: AuthenticatedData(), id_digestedData: DigestedData(), id_encryptedData: EncryptedData(), id_envelopedData: EnvelopedData(), id_signedData: SignedData(), }),))), ("content", Any(expl=tag_ctxc(0))), )
geeft aan dat als contentType een OID met de waarde id_signedData bevat, het content-veld (dat zich in deze SEQUENCE bevindt) volgens het schema SignedData moet worden gedecodeerd. Waarom zoveel haakjes? Een veld kan meerdere velden tegelijk "bepalen", zoals het geval is in EnvelopedData-structuren. De te bepalen velden worden geïdentificeerd via het zogenaamde decode path – dit geeft de exacte locatie van elk element in alle structuren aan.
Het is niet altijd wenselijk of mogelijk om deze defines onmiddellijk in het schema op te nemen. Er kunnen toepassing-specifieke gevallen zijn waarin OID's en structuren alleen in een extern project bekend zijn. PyDERASN biedt de mogelijkheid om deze defines direct tijdens het decoderen van een structuur op te geven:
ContentInfo().decode(data, ctx={"defines_by_path": (( ( "content", DecodePathDefBy(id_signedData), "certificates", any, "certificate", "tbsCertificate", "extensions", any, "extnID", ), ((("extnValue",), { id_ce_authorityKeyIdentifier: AuthorityKeyIdentifier(), id_ce_basicConstraints: BasicConstraints(), [...] id_ru_subjectSignTool: SubjectSignTool(), }),), ),)})
Hier zeggen we dat in CMS SignedData voor alle bijgevoegde certificaten alle extensies (AuthorityKeyIdentifier, BasicConstraints, SubjectSignTool, enzovoort) moeten worden gedecodeerd. We geven via decode path aan aan welk element de defines moeten "worden toegevoegd", alsof ze in het schema waren opgegeven.
Ten slotte heeft PyDERASN de mogelijkheid om vanuit de
opdrachtregel pretty printing Je kunt willekeurige ASN.1 decoderen, maar je kunt ook een specifieke schema opgeven en iets dergelijks zien:
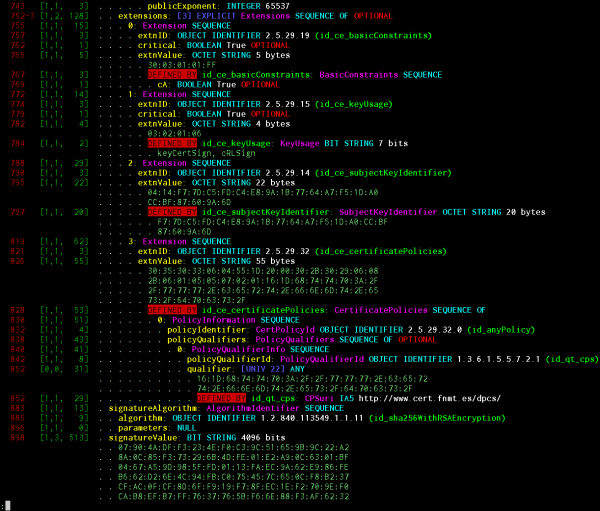
Weergeven informatie: verschuiving van het object, lengte van de tag, lengte van de inhoud, aanwezigheid van EOC (end-of-octets), teken van BER-codering, teken van indefinite-length codering, lengte en verschuiving van de EXPLICIT tag (indien aanwezig), diepte van de objectinbedding in structuren, IMPLICIT/EXPLICIT waarde van de tag, naam van het object volgens het schema, zijn basis ASN.1 type, volgnummer binnen SEQUENCE/SET OF, waarde van CHOICE (indien aanwezig), mensvriendelijke naam INTEGER/ENUMERATED/BIT STRING volgens het schema, waarde van een willekeurig basis type, DEFAULT/OPTIONAL vlag uit het schema, teken dat het object automatisch is gedecodeerd als DEFINED BY en door welke OID dit is gebeurd, mensvriendelijke OID.
Het pretty-print-systeem is speciaal ontworpen om een reeks van PP-objecten te genereren, die vervolgens al met afzonderlijke middelen worden gevisualiseerd. De screenshot toont de renderer in eenvoudige kleurtekst. Er zijn ook renderers in JSON/HTML-formaat, zodat dit met syntaxisaccentuering in de browser van ASN.1 kan worden bekeken zoals in project.
Andere bibliotheken
Dit was niet het doel, maar PyDERASN bleek aanzienlijk dan pyasn1. Bijvoorbeeld, het decoderen van CRL-bestanden van megabytes kan zo lang duren dat er nagedacht moet worden over tussentijdse opslagformaten (snelle) en de architectuur van toepassingen moet worden gewijzigd. Pyasn1 decodeert CRL op mijn laptop in meer dan 20 minuten, terwijl PyDERASN het in slechts 28 seconden doet! Er is een project , gericht op snelle verwerking van cryptografische structuren: het decodeert (volledig, niet lui) dezelfde CRL in 29 seconden, maar verbruikt bijna twee keer zoveel RAM bij gebruik onder Python3 (983 MiB versus 498), en 3,5 keer zoveel onder Python2 (1677 versus 488), terwijl pyasn1 zelfs 4,3 keer meer verbruikt (2093 versus 488).
asn1crypto, dat ik noemde, hebben we niet overwogen omdat het project nog maar net was begonnen en we er nog niet van gehoord hadden. Ik zou nu ook geen aandacht meer aan hem besteden omdat ik meteen ontdekte dat dezelfde GeneralizedTime geen willekeurige vorm accepteert en bij serialisatie stilletjes fracties van seconden verwijdert. Dit is acceptabel voor het werken met X.509-certificaten, maar is in het algemeen niet geschikt.
Op dit moment is PyDERASN de strengste van de vrije Python/Go DER-decoders die ik ken. In de encoding/asn1-bibliotheek van mijn favoriete Go OBJECT IDENTIFIER en UTCTime/GeneralizedTime strings. Soms kan striktheid een belemmering vormen (vooral vanwege de achterwaartse compatibiliteit met oudere applicaties die niemand meer zal repareren), daarom kan tijdens het decoderen in PyDERASN verschillende instellingen worden doorgegeven. verzachtende controles.
De projectcode probeert zo eenvoudig mogelijk te zijn. De volledige bibliotheek bestaat uit één bestand. De code is geschreven met de nadruk op begrijpelijkheid, zonder overbodige prestatie-optimalisaties en DRY-code. Zoals eerder vermeld, is er geen ondersteuning voor volledige BER-decodering van UTCTime/GeneralizedTime strings, noch voor REAL, RELATIVE OID, EXTERNAL, INSTANCE OF, EMBEDDED PDV, CHARACTER STRING datatypes. In alle andere gevallen zie ik persoonlijk geen reden om andere bibliotheken in Python te gebruiken.
Zoals al mijn projecten, type , , , , PyDERASN is volledig , verspreid onder de voorwaarden van , en beschikbaar voor gratis download. Voorbeelden van gebruik zijn er en in .
, , lid van , Python/Go-ontwikkelaar, hoofd specialist .
Bron: habr.com
