

Serverless is niet het fysieke ontbreken van servers. Het is geen 'moordenaar' van containers en geen tijdelijke trend. Het is een nieuwe benadering voor het bouwen van systemen in de cloud. In dit artikel zullen we de architectuur van Serverless-applicaties bespreken, bekijken welke rol de serverless-dienstverlener speelt en open-sourceprojecten verkennen. Tot slot spreken we over de toepassingsvragen van Serverless.
Ik wil de serverkant van een toepassing schrijven (bijvoorbeeld een webwinkel). Dit kan een chat zijn, een contentpublicatieservice of een load balancer. Hoe dan ook, er zal genoeg hoofd pijn zijn: ik moet de infrastructuur voorbereiden, de afhankelijkheden van de toepassing vaststellen en nadenken over het besturingssysteem van de host. Dan zal ik kleine componenten moeten bijwerken die de werking van de rest van de monoliet niet beïnvloeden. En laten we de schaalbaarheid onder belasting niet vergeten.
Wat als we ephemerale containers gebruiken waarin de vereiste afhankelijkheden al zijn voorgeïnstalleerd en de containers van elkaar en van het besturingssysteem van de host zijn geïsoleerd? We splitsen de monoliet in microservices, die we onafhankelijk van elkaar kunnen bijwerken en schalen. Door de code in zo'n container te plaatsen, kan ik deze op elke infrastructuur draaien. Dat is al beter.
En als ik geen zin heb om containers in te stellen? Geen zin heb om na te denken over de schaalbaarheid van de toepassing. Geen zin heb om te betalen voor inactieve containers wanneer de belasting op de service minimaal is. Ik wil gewoon code schrijven. Me concentreren op de bedrijfslogica en producten met de snelheid van het licht op de markt brengen.
Deze gedachten leidde me naar serverless computing. Serverless betekent in dit geval niet dat er geen servers zijn, maar dat er geen hoofdpijn is van het beheren van infrastructuur.
Het idee is dat de logica van de toepassing wordt opgesplitst in onafhankelijke functies. Ze hebben een evenementgestuurde structuur. Elke functie voert een "microtaak" uit. Alles wat van de ontwikkelaar vereist is, is om de functies in de door de cloudprovider aangeboden console te uploaden en deze te koppelen aan gebeurtenisbronnen. De code zal op verzoek worden uitgevoerd in een automatisch voorbereide container, en ik betaal alleen voor de uitvoeringstijd.
Laten we eens kijken hoe het ontwikkelingsproces van de toepassing er nu uitziet.
Vanuit het perspectief van de ontwikkelaar
Eerder hebben we het gehad over de toepassing voor een webwinkel. In de traditionele aanpak wordt de belangrijkste logica van het systeem uitgevoerd door een monolithische toepassing. En de server met de toepassing draait continu, zelfs als er geen belasting is.
Om naar serverless over te schakelen, splitsen we de toepassing op in microtaken. Voor elk van hen schrijven we onze eigen functie. De functies zijn onafhankelijk van elkaar en slaan geen informatie over de status op (stateless). Ze kunnen zelfs in verschillende talen geschreven zijn. Als er één faalt, stopt de hele applicatie niet. De architectuur van de applicatie ziet er als volgt uit:
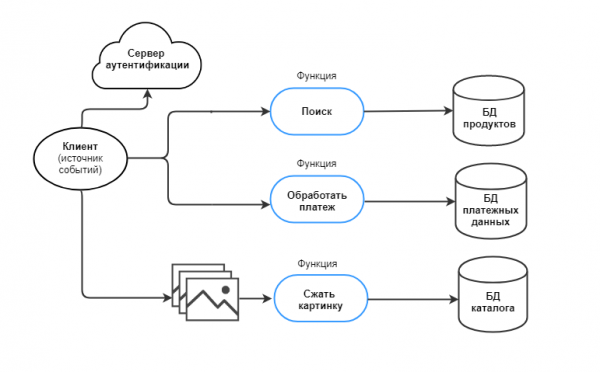
De opsplitsing in functies binnen Serverless lijkt op het werken met microservices. Maar een microservice kan meerdere taken uitvoeren, terwijl een functie idealiter één taak moet uitvoeren. Stel je voor dat de taak is om statistieken te verzamelen en deze op verzoek van de gebruiker weer te geven. In de microservice-aanpak voert één service deze taak uit met twee ingangen: één voor schrijven en één voor lezen. In serverless computing zijn dit twee verschillende, niet aan elkaar verbonden functies. De ontwikkelaar bespaart compute-resources als bijvoorbeeld de statistieken vaker worden bijgewerkt dan dat ze worden opgevraagd.
Serverless-functies moeten binnen een korte tijdspanne (timeout) uitgevoerd worden, die door de serviceprovider wordt bepaald. Voor AWS is de timeout bijvoorbeeld 15 minuten. Dit betekent dat langdurige functies (long-lived) moeten worden aangepast aan de eisen - dit is wat Serverless onderscheidt van andere populaire technologieën vandaag de dag (containers en Platform as a Service).
We wijzen een evenement toe aan elke functie. Een evenement is een trigger voor een actie:
Evenement
De actie die de functie uitvoert
Er is een afbeelding van het product in de opslag geüpload
De afbeelding comprimeren en in de catalogus uploaden
Het adres van de fysieke winkel is bijgewerkt in de database
Laad de nieuwe locatie in de kaarten
De klant betaalt het product
Start de betalingsverwerking
Evenementen kunnen HTTP-verzoeken, streamingdata, berichtenqueues enzovoort zijn. Bronnen van evenementen zijn veranderingen of het verschijnen van gegevens. Bovendien kunnen functies op een timer worden uitgevoerd.
De architectuur is uitgewerkt en de applicatie is bijna serverless geworden. Laten we verdergaan naar de serviceprovider.
Vanuit het perspectief van de provider
Meestal worden serverless computing diensten aangeboden door cloud serviceproviders. Ze hebben verschillende namen: Azure Functions, AWS Lambda, Google Cloud Functions, IBM Cloud Functions.
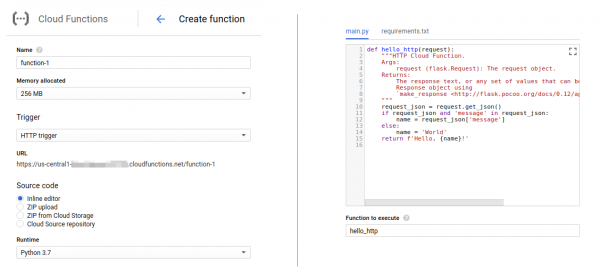
We zullen de dienst gebruiken via de console of het persoonlijke dashboard van de provider. De code van de functies kan op een van de volgende manieren worden geüpload:
- de code schrijven in ingebouwde editors via de webconsole,
- een archief met code uploaden,
- werken met publieke of private git-repositories.
Hier configureren we de gebeurtenissen die de functie aanroepen. De sets van gebeurtenissen kunnen per provider verschillen.
De provider heeft op zijn infrastructuur het systeem Function as a Service (FaaS) gebouwd en geautomatiseerd:
- De code van de functies wordt opgeslagen in de opslag van de provider.
- Wanneer er een gebeurtenis optreedt, worden er automatisch containers met de voorbereide omgeving op de server uitgerold. Elke instantie van de functie heeft zijn eigen geïsoleerde container.
- De functie wordt vanuit de opslag naar de container gestuurd, verwerkt en geeft het resultaat terug.
- Het aantal gelijktijdige gebeurtenissen neemt toe — het aantal containers groeit. Het systeem schaalt automatisch. Als gebruikers de functie niet aanroepen, blijft deze inactief.
- De provider stelt de inactiviteitstijd van de containers vast — als functies binnen deze tijd niet in de container verschijnen, wordt deze vernietigd.
Zo krijgen we Serverless 'out of the box'. We betalen voor de dienst volgens het pay-as-you-go-model, en alleen voor de functies die worden gebruikt, en alleen voor de tijd dat ze werden gebruikt.
Om ontwikkelaars kennis te laten maken met de dienst, bieden providers tot 12 maanden gratis testen aan, maar beperken de totale rekentijd, het aantal aanvragen per maand, het budget of het verbruikte vermogen.
Het belangrijkste voordeel van samenwerking met een provider is dat je je geen zorgen hoeft te maken over de infrastructuur (servers, virtuele machines, containers). Aan de kant van de provider kan FaaS worden gerealiseerd met zowel eigen ontwikkelingen als open-source tools. Daarover zullen we verder praten.
Aan de kant van open source
De afgelopen paar jaar werkt de open-source gemeenschap actief aan Serverless-tools. Ook de grootste spelers op de markt dragen bij aan de ontwikkeling van serverless platforms:
- Google biedt ontwikkelaars zijn open-source tool aan ― . Bij de ontwikkeling waren IBM, RedHat, Pivotal en SAP betrokken;
- IBM werkten aan het serverless platform , dat later een project van de Apache Foundation werd;
- Microsoft hebben een deel van de code van het platform .
gedeeltelijk geopend. en Kubeless werkt zowel met Kubernetes als met Docker Swarm. Het framework fungeert als een soort controller - het bereidt op verzoek een uitvoeringsomgeving binnen de cluster voor en start vervolgens de functie daar.
Frameworks bieden ruimte voor het configureren van het hulpmiddel naar eigen behoeften. Zo kan de ontwikkelaar in Kubeless de timeout voor de uitvoering van de functie instellen (de standaardwaarde is 180 seconden). Fission probeert het probleem van de koude start op te lossen door sommige containers continu draaiende te houden (hoewel dit kosten met zich meebrengt voor ongebruikte middelen). OpenFaaS biedt een reeks triggers voor elke smaak en kleur: HTTP, Kafka, Redis, MQTT, Cron, AWS SQS, NATs en meer.
Instructies om aan de slag te gaan zijn te vinden in de officiële documentatie van de frameworks. Het werken ermee vereist iets meer vaardigheden dan bij het werken met een provider - dat is minimaal het kunnen opstarten van een Kubernetes-cluster via de CLI. Het maximum is het integreren van andere open-source hulpmiddelen (bijvoorbeeld een queue manager zoals Kafka).
Ongeacht op welke manier we met Serverless werken - via een provider of met open-source - we zullen een aantal voordelen en nadelen van de Serverless-aanpak ervaren.
Vanuit het perspectief van voordelen en nadelen
Serverless ontwikkelt de ideeën van containerinfrastructuur en een microservices-aanpak, waarbij teams in een meertalige modus kunnen werken zonder zich aan één platform te binden. Het bouwen van een systeem wordt eenvoudiger, en fouten kunnen gemakkelijker worden hersteld. De microservicesarchitectuur stelt ons in staat om nieuwe functionaliteit veel sneller aan het systeem toe te voegen dan bij een monolithische applicatie.
Serverless verkort de ontwikkeltijd nog verder, waardoor de ontwikkelaar zich uitsluitend kan concentreren op de zakelijke logica van de applicatie en het schrijven van code. Als gevolg hiervan wordt de tijd om nieuwe ontwikkelingen op de markt te brengen verkort.
Als bonus krijgen we automatische schaalvergroting onder belasting, en betalen we alleen voor de gebruikte middelen en alleen in de tijd dat ze worden gebruikt.
Zoals elke technologie heeft Serverless nadelen.
Een van deze nadelen kan de koude starttijd zijn (gemiddeld tot 1 seconde voor talen zoals JavaScript, Python, Go, Java, Ruby).
Aan de ene kant is de tijd voor een koude start in de praktijk afhankelijk van veel variabelen: de programmeertaal waarin de functie is geschreven, het aantal bibliotheken, de codegrootte, en de interactie met extra bronnen (zoals databases of authenticatieservers). Aangezien de ontwikkelaar deze variabelen kan beheren, kan hij de opstarttijd verkorten. Maar aan de andere kant kan de ontwikkelaar de opstarttijd van de container niet beheren - dit hangt volledig af van de provider.
Een koude start kan een warme start worden wanneer de functie gebruikmaakt van een eerder door een evenement geopende container. Dit kan zich in drie gevallen voordoen:
- indien klanten de service frequent gebruiken en het aantal verzoeken aan de functie toeneemt;
- indien de provider, het platform of het framework toestaan dat sommige containers altijd actief blijven;
- indien de ontwikkelaar functies op een timer aanroept (bijvoorbeeld elke 3 minuten).
Voor veel applicaties is een koude start geen probleem. Het is belangrijk om uit te gaan van het type en de taken van de service. Een opstartvertraging van een seconde is niet altijd cruciaal voor een zakelijke applicatie, maar kan kritiek zijn voor medische diensten. Waarschijnlijk is in dit geval de serverless benadering niet meer geschikt.
Een volgende nadeel van serverless is de korte levensduur van de functie (timeout, waarbinnen de functie moet worden uitgevoerd).
Maar als er gewerkt moet worden met langdurige taken, kan er een hybride architectuur worden gebruikt - een combinatie van serverless met een andere technologie.
Niet alle systemen kunnen volgens het serverless-schema werken.
Sommige applicaties zullen nog steeds gegevens en status tijdens uitvoering opslaan. Sommige architecturen blijven monolithisch, terwijl sommige functies langdurig zullen zijn. Echter (net als eens cloudtechnologieën en later containers), is serverless een technologie met een grote toekomst.
In dit kader zou ik graag soepel willen overgaan op de vraag van de toepassing van de serverless benadering.
Wat betreft de toepassing
In 2018 steeg het percentage gebruik van serverless . Onder de bedrijven die deze technologie al in hun diensten hebben geïmplementeerd, zijn marktgiganten zoals Twitter, PayPal, Netflix, T-Mobile en Coca-Cola. Het is belangrijk te begrijpen dat serverless geen wondermiddel is, maar een hulpmiddel voor het oplossen van een bepaald scala aan taken:
- Om de downtijd van middelen te verminderen. Het is niet nodig om de virtuele machine altijd in te schakelen voor diensten met weinig verkeer.
- Data 'on the fly' verwerken. Afbeeldingen comprimeren, achtergronden verwijderen, video-encoding wijzigen, werken met IoT-sensoren, wiskundige bewerkingen uitvoeren.
- Andere diensten aan elkaar koppelen. Een Git-repository met interne programma's, een chatbot in Slack met Jira en de agenda.
- De belasting balanceren. Laten we daar dieper op ingaan.
Stel je voor dat er een dienst is die 50 bezoekers heeft. Daarvoor staat een virtuele machine met zwakke hardware. Af en toe neemt de belasting van de dienst vele malen toe. Dan kan de zwakke hardware niet meer volgen.
We kunnen een load balancer in het systeem integreren die de belasting bijvoorbeeld over drie virtuele machines verdeelt. Op dit moment kunnen we de belasting niet precies voorspellen, dus houden we een aantal resources 'voor reserve' in werking. En betalen we teveel voor stilstand.
In zo'n situatie kunnen we het systeem optimaliseren met een hybride benadering: we laten één virtuele machine achter de load balancer en plaatsen een link naar een Serverless Endpoint met functies. Als de belasting de drempel overschrijdt, start de load balancer exemplaren van functies die een deel van de verzoeken verwerken.
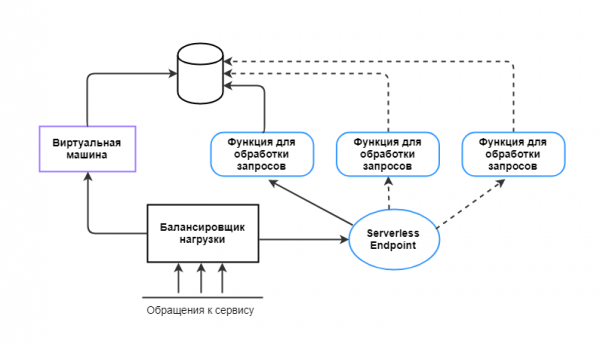
Op deze manier kan Serverless worden gebruikt waar we niet al te vaak, maar intensief een groot aantal verzoeken moeten verwerken. In dit geval is het voordeliger om meerdere functies gedurende 15 minuten te draaien dan de hele tijd een virtuele machine of server aan te houden.
Ondanks alle voordelen van serverless computing, is het vooral belangrijk om de logica van de applicatie te evalueren en te begrijpen welke taken Serverless in dit specifieke geval kan oplossen voordat we het implementeren.
Serverless en Selectel
Bij Selectel hebben we al via ons controlepaneel. Nu bouwen we ons eigen FaaS-platform. We willen dat ontwikkelaars hun taken met Serverless kunnen oplossen via een handige, flexibele interface.
Als je ideeën hebt over hoe het ideale FaaS-platform eruit zou moeten zien en hoe je Serverless in je projecten wilt gebruiken, deel deze dan in de reacties. We zullen je wensen in overweging nemen bij de ontwikkeling van het platform.
Materialen die in het artikel zijn gebruikt:
Bron: habr.com
