

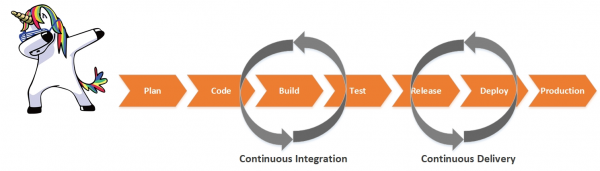
Het onderwerp DevOps is momenteel erg populair. Continuous integration en delivery pipelines worden door iedereen geïntegreerd die het maar kan. Maar de meesten besteden niet altijd de juiste aandacht aan de betrouwbaarheid van informatiesystemen in de verschillende fasen van de CI/CD-pijplijn. In dit artikel wil ik graag mijn ervaringen delen met het automatiseren van kwaliteitscontroles van software en het implementeren van mogelijke scenario's voor 'zelfherstel'.
Ik werk als engineer in de IT-servicemanagementafdeling van het bedrijf . Mijn specialisatie is de implementatie van verschillende systemen voor het monitoren van de prestaties en beschikbaarheid van applicaties. Ik heb vaak contact met IT-opdrachtgevers uit verschillende marktsegmenten over actuele kwesties met betrekking tot de monitoring van de kwaliteit van hun IT-diensten. De belangrijkste taak is om de releasecyclus te minimaliseren en de frequentie van uitgaven te verhogen. Dit klinkt natuurlijk goed: meer releases - meer nieuwe functies - meer tevreden gebruikers - meer winst. Maar in de praktijk gaat niet altijd alles goed. Bij zeer hoge uitrolsnelheden rijst onmiddellijk de vraag naar de kwaliteit van onze releases. Zelfs met een volledig geautomatiseerde pijplijn is een van de grootste problemen het verplaatsen van services van test naar productie, zonder de uptime en de interactie van gebruikers met de applicatie te beïnvloeden.
Na talloze gesprekken met opdrachtgever kan ik zeggen dat kwaliteitscontrole van releases, de betrouwbaarheid van applicaties en de mogelijkheid van 'zelfherstel' (bijvoorbeeld terug naar een stabiele versie) in de verschillende fasen van de CI/CD-pijplijn - tot de meest zorgwekkende en actuele thema's behoren.
Onlangs werkte ik zelf aan de cliëntzijde - in de ondersteuningsdienst voor de applicatiesoftware van een online bank. In de architectuur van onze applicatie maakten we gebruik van een groot aantal zelfgeschreven microservices. Het meest treurige was dat niet alle ontwikkelaars met de snelle ontwikkeling konden omgaan; de kwaliteit van sommige microservices lijdde eronder, wat leidde tot grappige bijnamen voor hen en hun makers. Er ontstonden verhalen over de materialen waaruit deze producten werden gemaakt.
«Formulering van de taak»
De hoge releasefrequentie en het grote aantal microservices maken het moeilijk om de werking van de applicatie als geheel te begrijpen, zowel in de testfase als in de operationele fase. Veranderingen vinden constant plaats en het is erg moeilijk om deze te beheersen zonder goede monitoringtools. Vaak zitten ontwikkelaars 's ochtends na een nachtelijke release als op een kruitvat te wachten tot er niets kapotgaat, terwijl alle tests in de testfase succesvol waren.
Er is nog een punt. In de testfase wordt de werking van de software gecontroleerd: de uitvoering van de belangrijkste functies van de applicatie en het ontbreken van fouten. Kwalitatieve prestatiewaarderingen ontbreken vaak of houden niet rekening met alle aspecten van de werking van de applicatie en de integratielaag. Sommige metrics worden helemaal niet gecontroleerd. Hierdoor leert de technischedienst pas over een storing in de productieomgeving wanneer echte gebruikers beginnen te klagen. We willen de impact van slechte software op eindgebruikers minimaliseren.
Een van de oplossingen is om kwaliteitscontroles van software op verschillende stadia van de CI/CD-pijplijn te implementeren en verschillende scenario's toe te voegen voor het herstel van systemen bij ongevallen. We moeten ook onthouden dat we DevOps hebben. Het bedrijf verwacht zo snel mogelijk een nieuw product. Daarom moeten al onze controles en scenario's geautomatiseerd zijn.
De taak wordt in twee delen opgesplitst:
- kwaliteitscontrole van builds in de testfase (het automatiseren van het proces van het opvangen van slechte builds);
- kwaliteitscontrole van software in de productieomgeving (mechanismen voor automatische probleemdetectie en mogelijke scenario's voor zelfherstel).
Een tool voor monitoring en het verzamelen van metrics
Om de gestelde taken te realiseren, is er een monitoringsysteem nodig dat problemen kan detecteren en deze kan doorgeven aan automatiseringssystemen op verschillende stadia van de CI/CD-pijplijn. Een positief punt zou zijn als dit systeem nuttige metrics levert voor verschillende teams: ontwikkeling, testen, exploitatie. En het zou helemaal geweldig zijn als dat ook voor het bedrijf is.
Voor het verzamelen van metrics kunnen verschillende systemen worden gebruikt (Prometheus, ELK Stack, Zabbix, enz.), maar naar mijn mening zijn APM-oplossingen het meest geschikt voor deze taken (), die je leven aanzienlijk kunnen vereenvoudigen.
In mijn werk bij de servicedienst begon ik met het maken van een vergelijkbaar project, waarbij ik een APM-oplossing van Dynatrace gebruikte. Nu ik als integrator werk, ben ik behoorlijk goed op de hoogte van de markt voor monitoring systemen. Mijn subjectieve mening: Dynatrace is het beste geschikt voor deze soort taken.
De oplossing van Dynatrace biedt een horizontale weergave van elke gebruikersoperatie met een hoge mate van detail tot op het niveau van de uitvoer van de code. Je kunt de gehele interactieketen volgen tussen verschillende informatieservices: van de levels van frontend web- en mobiele applicaties, back-end applicatieservers, integratiebus tot aan specifieke database-aanroepen.
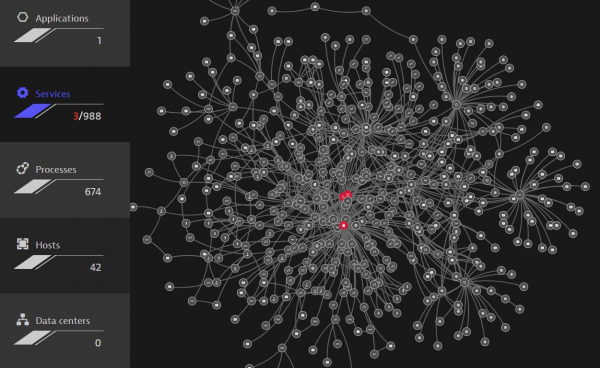 . Automatische opbouw van alle afhankelijkheden tussen de componenten van het systeem
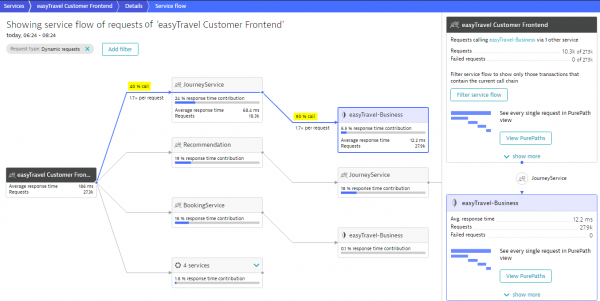 . Automatische identificatie en opbouw van de route van de serviceoperatie
Vergeet ook niet dat we moeten integreren met verschillende automatiseringsinstrumenten. De oplossing biedt hier een gebruiksvriendelijke API, waarmee je verschillende metrics en evenementen kunt verzenden en ontvangen.
Laten we verder gaan met een gedetailleerd overzicht van hoe we de gestelde taken kunnen oplossen met behulp van het Dynatrace-systeem.
Taak 1. Automatisering van de kwaliteitscontrole van builds in de testfase
De eerste taak is om problemen zo vroeg mogelijk te identificeren in de fasen van de applicatieleveringspipeline. Alleen 'goede' code-builds mogen de productieomgeving bereiken. Hiervoor moeten extra monitors voor de kwaliteitscontrole van je services in je pipeline tijdens de testfase zijn opgenomen.
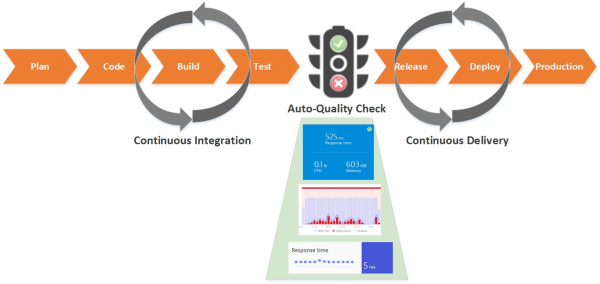
Laten we stap voor stap bekijken hoe we dit kunnen implementeren en dit proces kunnen automatiseren:
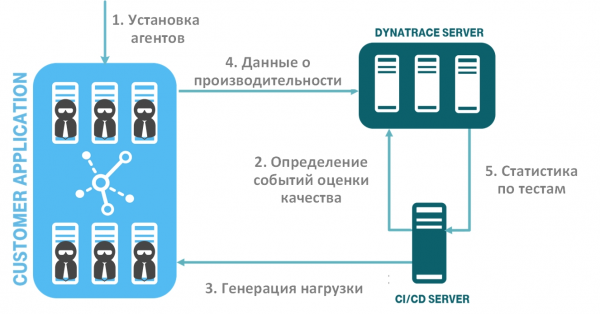
In de afbeelding wordt de stroom van geautomatiseerde stappen voor kwaliteitscontrole van software weergegeven:
- implementatie van het monitoringsysteem (installatie van agents);
- bepaling van de kwaliteitsbeoordelingsevents van je software (metrics en drempelwaarden) en overdracht ervan naar het monitoringsysteem;
- genereren van belasting en prestatietests;
- verzameling van gegevens over prestaties en beschikbaarheid in het monitoringsysteem;
- overdracht van gegevens over tests, gebaseerd op gebeurtenissen voor de kwaliteitsbeoordeling van software, van het monitoringssysteem naar het CI/CD-systeem. Automatische analyse van builds.
Stap 1. Het opzetten van het monitoringsysteem
Eerst moet je agenten installeren in je testomgeving. De oplossing van Dynatrace heeft een prettige eigenschap: het maakt gebruik van de universele OneAgent, die op het OS-instantie (Windows, Linux, AIX) wordt geïnstalleerd, automatisch je services ontdekt en begint met het verzamelen van monitoringsgegevens hierover. Je hoeft geen aparte agent voor elk proces in te stellen. Een soortgelijke situatie geldt voor cloud- en containerplatforms. Je kunt ook het installatieproces van de agenten automatiseren. Dynatrace past uitstekend binnen het concept van 'infrastructuur als code' (): er zijn al kant-en-klare scripts en instructies voor alle populaire platforms. Je integreert de agent in de configuratie van je service, en bij de uitrol ervan ontvang je direct een nieuwe service met al werkende agent.
Stap 2. Bepalen van evaluatie gebeurtenissen voor je softwarekwaliteit
Nu moeten we bepalen welke services en bedrijfsoperaties we in kaart brengen. Het is belangrijk om juist die gebruikersoperaties in aanmerking te nemen die kritisch zijn voor je business. Hier raad ik aan om te overleggen met business- en systeemanalisten.
Vervolgens moet je bepalen welke metrics je wilt opnemen in de controles voor elk van de niveaus. Bijvoorbeeld, dit kunnen uitvoeringstijden zijn (uitgesplitst in gemiddelde, mediaan, percentielen enzovoorts), fouten (logische, servicegerelateerde, infrastructuurgerelateerde enzovoorts) en verschillende infrastructuurmetrics (geheugenheap, garbage collector, threadcount enzovoorts).
Voor de automatisering en het gebruiksgemak voor het DevOps-team verschijnt het concept 'Monitoring als Code'. Wat ik daarmee bedoel is: een ontwikkelaar/tester kan een eenvoudig JSON-bestand schrijven dat de kwaliteitsindicaties van de software aangeeft.
Laten we een voorbeeld van zo'n JSON-bestand bekijken. Als een paar sleutel/waarde worden objecten uit de Dynatrace API gebruikt (de beschrijving van de API kun je hier bekijken ).
{
   "timeseries": [
   {
     "timeseriesId": "service.ResponseTime",
     "aggregation": "avg",
     "tags": "Frontend",
     "severe": 250000,
     "warning": 1000000
   },
   {
     "timeseriesId": "service.ResponseTime ",
     "aggregation": "avg",
     "tags": "Backend",
     "severe": 4000000,
     "warning": 8000000
   },
   {
     "timeseriesId": "docker.Container.Cpu",
     "aggregation": "avg",
     "severe": 50,
     "warning": 70
   }
  ]
}
Het bestand bevat een array van definities voor tijdreeksen (timeseries):
- timeseriesId – de te controleren metric, bijvoorbeeld Response Time, Error count, Memory used, enz.;
- aggregation — het aggregatieniveau van de metrics, in ons geval avg, maar u kunt elke gewenste gebruiken (avg, min, max, sum, count, percentile);
- tags – het label van het object in het monitoring systeem, of u kunt een specifieke object-id opgeven;
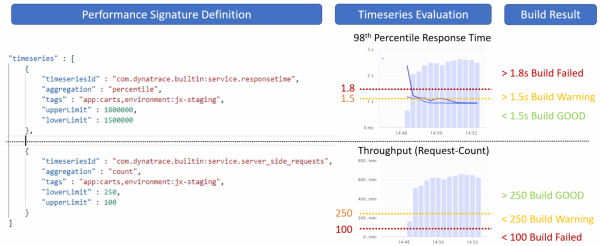
- severe en warning – deze waarden regelen de drempels voor onze metrics; als de waarde van de tests de severe drempel overschrijdt, wordt onze build gemarkeerd als ongeslaagd.
De volgende afbeelding toont een voorbeeld van het gebruik van dergelijke drempels.
Stap 3. Genereren van belasting
Nadat we de kwaliteitsniveaus van onze service hebben vastgesteld, is het noodzakelijk om testbelasting te genereren. U kunt elke voor u geschikte testtool gebruiken, zoals Jmeter, Selenium, Neotys, Gatling, enz.
Het Dynatrace monitoring systeem stelt u in staat om verschillende metadata uit uw tests vast te leggen en te herkennen welke tests bij welke releasecyclus en welke service horen. Het wordt aanbevolen om extra headers toe te voegen in de HTTP-aanvragen van de test.
De volgende afbeelding toont een voorbeeld waarin we met behulp van de extra header X-Dynatrace-Test aangeven dat deze test betrekking heeft op de testoperatie voor het toevoegen van een product aan de winkelwagentje.
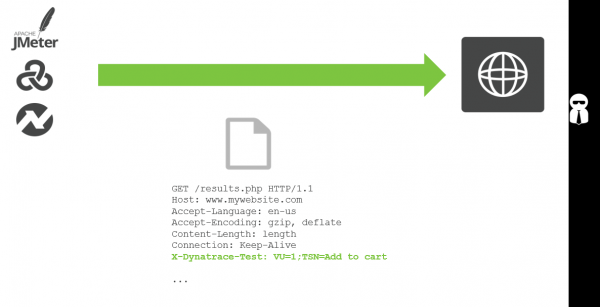
Bij het starten van elke belastingstest verzendt u extra contextinformatie naar Dynatrace via de CI/CD server API. Op deze manier kan het systeem verschillende tests van elkaar onderscheiden.
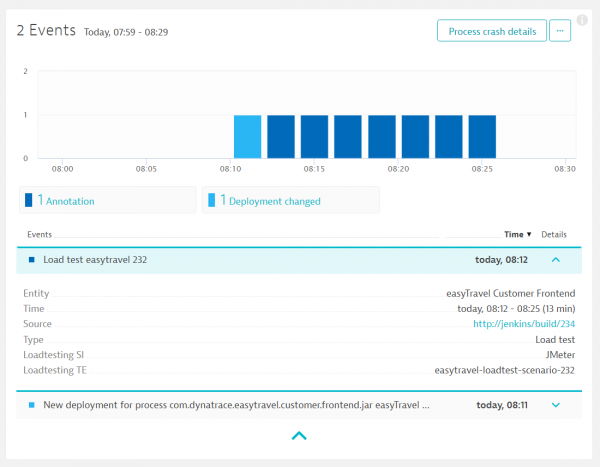 . Een gebeurtenis in het monitoring systeem over het starten van belastingtesting
Stap 4-5. Verzamelen van prestatiegegevens en doorgeven van gegevens aan het CI/CD systeem
Samen met de gegenereerde test wordt er een gebeurtenis naar het monitoringsysteem verzonden die aangeeft dat het nodig is om gegevens over de kwaliteitsmetrics te verzamelen. Ook wordt onze JSON-bestand opgegeven waarin de belangrijkste metrics zijn gedefinieerd.
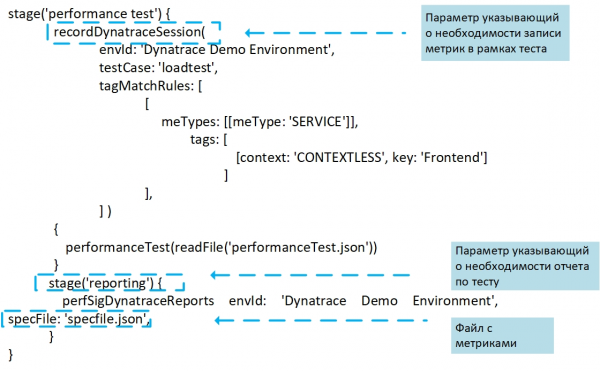 Een gebeurtenis die de noodzaak van softwarekwaliteitscontrole op de CI/CD-server genereert voor verzending naar het monitoringsysteem.
In ons voorbeeld heet de gebeurtenis voor kwaliteitscontrole perfSigDynatraceReport (Performance_Signature) – is een kant-en-klare voor integratie met Jenkins, ontwikkeld door het team van T-Systems Multimedia Solutions. In elke gebeurtenis van de kwaliteitscontrole worden informatie over de service, het buildnummer en de testtijd opgenomen. De plugin verzamelt prestatiegegevens tijdens de build, evalueert deze en vergelijkt het resultaat met eerdere builds en niet-functionele vereisten.
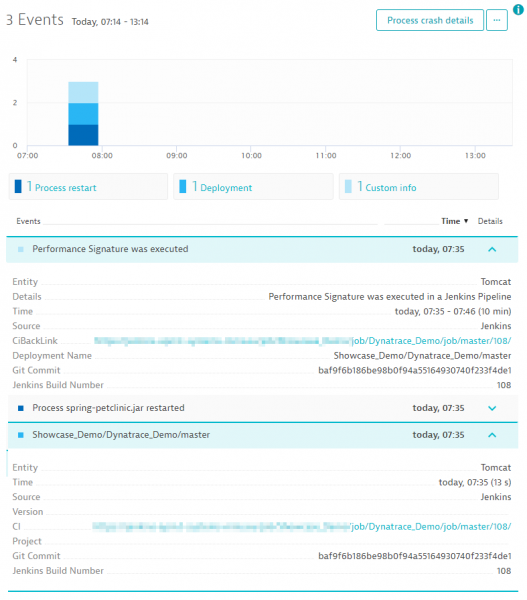 Een gebeurtenis in het monitoringsysteem over het starten van de kwaliteitscontrole van de build.
Na het voltooien van de test worden alle metrics voor de softwarekwaliteitsbeoordeling teruggestuurd naar het systeem voor continue integratie, bijvoorbeeld Jenkins, dat een rapport met de resultaten genereert.
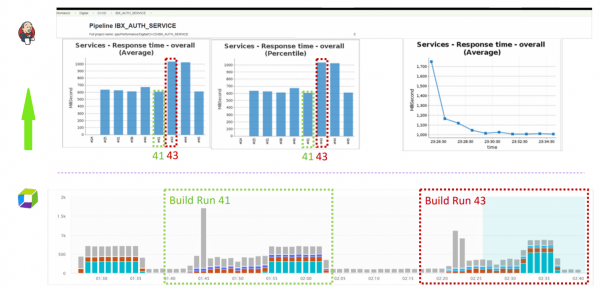 Statistiekenresultaat per build op de CI/CD-server.
Voor elke individuele build zien we statistieken voor elke door ons opgegeven metric gedurende de hele testperiode. We zien ook of er overtredingen waren van bepaalde drempelwaarden (waarschuwing en ernstige thresholds). Op basis van de verzamelde gegevens wordt de build gemarkeerd als stabiel, onstabiel of mislukt. Voor uw gemak kunt u ook vergelijkingscijfers van de huidige build met de vorige aan het rapport toevoegen.
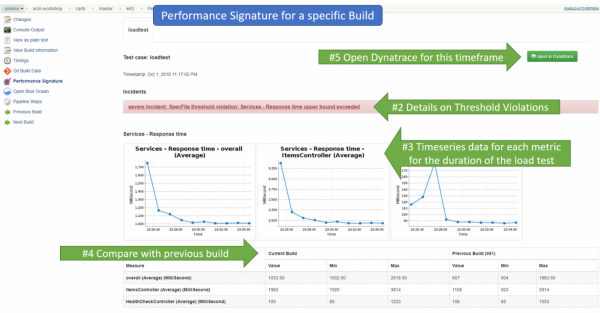 Bekijk gedetailleerde statistieken per build op de CI/CD-server.
Gedetailleerde vergelijking van twee builds
Indien nodig kunt u naar de interface van Dynatrace gaan en daar de statistieken van elke build gedetailleerd bekijken en ze met elkaar vergelijken.
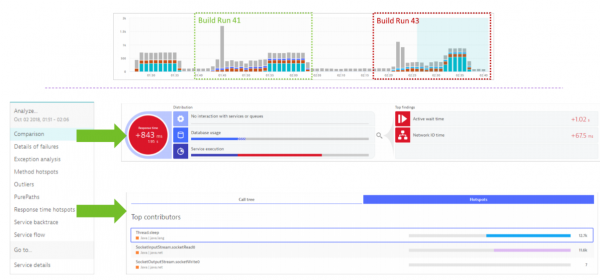 Vergelijking van statistieken per build in Dynatrace.
Conclusies
Uiteindelijk krijgen we de service 'monitoring as a service', geautomatiseerd in de pipeline van continue integratie. De ontwikkelaar of tester hoeft alleen een lijst met metrics in een JSON-bestand te definiëren, alles gebeurt automatisch. We krijgen transparante kwaliteitscontrole van releases: alle meldingen over prestaties, resourcegebruik of architecturale regressies.
Taak 2. Automatisering van softwarekwaliteitscontrole in de productieomgeving.
Dus, we hebben de taak opgelost om het monitoringproces tijdens de testfase in de pipeline te automatiseren. Op deze manier minimaliseren we het percentage onvolmaakte builds dat de productieomgeving bereikt.
Maar wat als slechte software toch in productie komt, of iets gewoon niet werkt? Voor de utopie wilden we mechanismen voor automatische probleemdetectie en, waar mogelijk, dat het systeem zelf zijn functionaliteit weer herstelt, althans 's nachts.
Daarvoor moeten we, analogie met het vorige gedeelte, automatische kwaliteitscontroles van de software in de productieomgeving voorzien en scenario's voor zelfherstel van het systeem inbouwen.
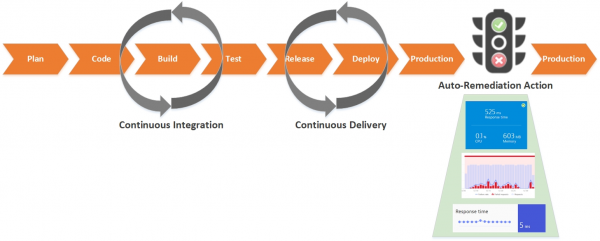
Auto-reparatie als code
In de meeste bedrijven bestaat al een opgebouwde kennisbasis over verschillende soorten veelvoorkomende problemen en een lijst met acties voor hun oplossing, zoals het herstarten van processen, het opschonen van middelen, het terugdraaien van versies, het herstellen van onjuiste configuratiewijzigingen, het vergroten of verkleinen van het aantal componenten in een cluster, het schakelen tussen blauwe of groene omgevingen, en meer.
Hoewel deze gebruiksscenario's al vele jaren bekend zijn bij veel teams waarmee ik spreek, hebben slechts weinigen erover nagedacht en geld geïnvesteerd in hun automatisering.
Als je erover nadenkt, is er niets buitengewoons ingewikkelds aan het implementeren van processen voor zelfherstel van de functionaliteit van de applicatie; het enige wat je hoeft te doen is de al bekende werkscenario's van je beheerders omzetten in codescenario's (het concept "auto-reparatie als code") die je van tevoren hebt geschreven voor elk specifiek geval. De scenario's voor automatische reparatie moeten gericht zijn op het aanpakken van de oorzaak van het probleem. Jij bepaalt zelf de juiste responsacties op incidenten.
Elke metriek uit je monitoring systeem kan als trigger voor het starten van een scenario dienen, zolang deze metrics maar precies aangeven dat er iets mis is, want je wilt geen valse waarschuwingen in een productieomgeving.
Je kunt elk systeem of een combinatie van systemen gebruiken: Prometheus, ELK Stack, Zabbix, etc. Maar ik zal een paar voorbeelden geven op basis van APM-oplossingen (als voorbeeld nemen we weer Dynatrace), wat je leven ook gemakkelijker kan maken.
Ten eerste is hier alles wat betreft de performance vanuit het perspectief van de applicatie. De oplossing biedt honderden metrics op verschillende niveaus die je kunt gebruiken als triggers:
- gebruikersniveau (browsers, mobiele applicaties, IoT-apparaten, gebruikersgedrag, conversie, enz.);
- serviceniveau en operaties (prestaties, beschikbaarheid, fouten, enz.);
- applicatie-infrastructuurniveau (OS-metrieken van de host, JMX, MQ, webserver, enz.);
- platformniveau (virtualisatie, cloud, container, enz.).
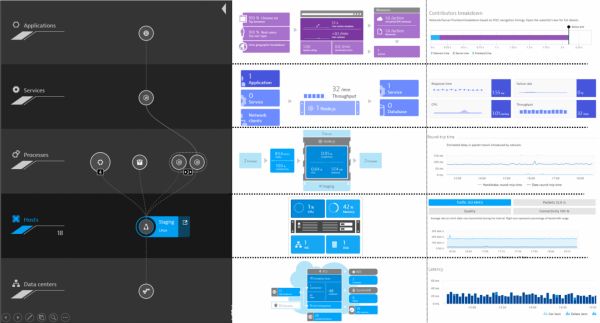 Monitoring niveaus in Dynatrace.
Ten tweede, zoals eerder vermeld, heeft Dynatrace een open API die het erg eenvoudig maakt om het te integreren met verschillende externe systemen. Bijvoorbeeld, het verzenden van een melding naar een automatiseringssysteem wanneer controleparameters worden overschreden.
Hieronder is een voorbeeld voor interactie met Ansible.
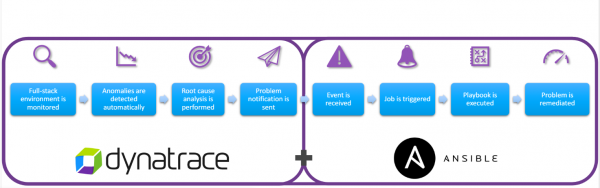
Vervolgens geef ik een aantal voorbeelden van welke automatiseringen er mogelijk zijn. Dit is slechts een deel van de cases, de lijst in uw omgeving kan zich beperken tot uw verbeelding en de mogelijkheden van uw monitoringtools.
1. Slechte deployment – terugdraaien van de versie
Zelfs als we alles goed testen in de testomgeving, blijft er een kans dat een nieuwe release uw applicatie in de productieomgeving kan beëindigen. Ook het menselijke element blijft altijd een factor.
In de volgende afbeelding zien we een plotselinge stijging van de uitvoeringstijd van operaties op de service. Het begin van deze stijging valt samen met het tijdstip van de deployment naar de applicatie. Al deze informatie wordt als gebeurtenissen naar het automatiseringssysteem gestuurd. Als de functionaliteit van de service niet normaliseert binnen de door ons ingestelde tijd, wordt automatisch een script aangeroepen dat de versie terugdraait naar de oude.
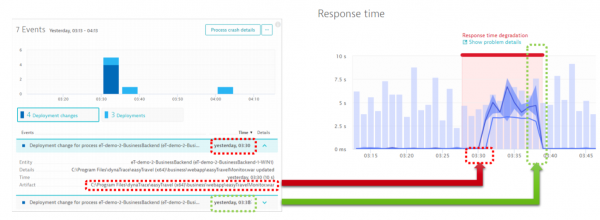 Degradatie van de operationele prestaties na de deployment.
2. Honderd procent belasting van resources – voeg een node toe aan de routering
In het volgende voorbeeld stelt het monitoring systeem vast dat er op een van de componenten een CPU-belasting van 100% is.
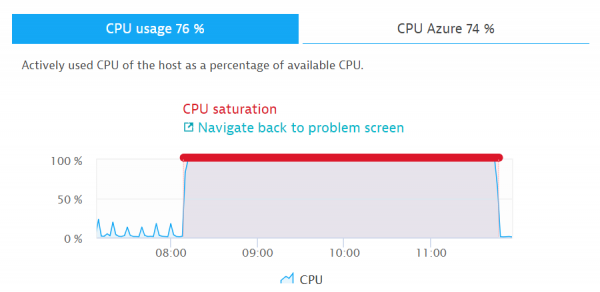 CPU-belasting 100%
Er zijn verschillende scenario's mogelijk voor dit evenement. Bijvoorbeeld, het monitoringsysteem controleert aanvullend of de resource-tekort verband houdt met een toename van de belasting op de service. Als dat zo is, wordt er een script uitgevoerd dat automatisch een node toevoegt aan de routering, waardoor de functionaliteit van het systeem in het geheel wordt hersteld.
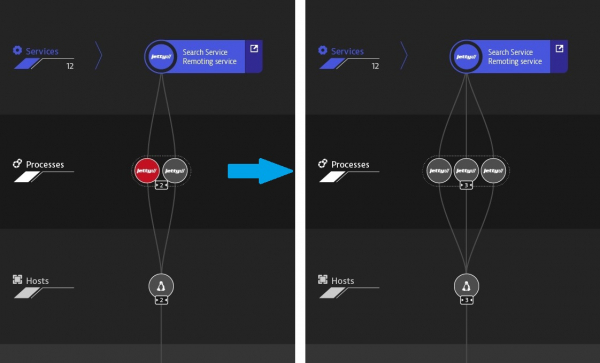 Schaalvergroting na een incident
3. Geen ruimte op de harde schijf – schijfopruiming
Ik denk dat deze processen bij velen al zijn geautomatiseerd. Met APM kun je ook de beschikbare ruimte op het opslag systeem in de gaten houden. Bij gebrek aan ruimte of wanneer de schijf traag werkt, roepen we een script aan om te reinigen of voegen we extra ruimte toe.
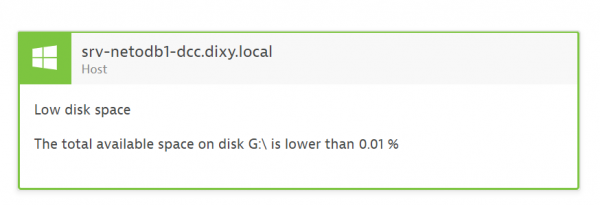
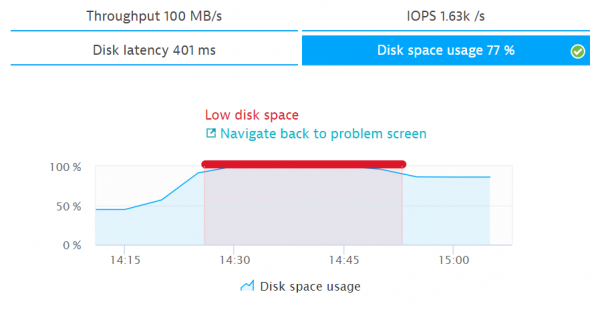 Schijfbelasting 100%
4. Lage gebruikersactiviteit of lage conversie – schakelen tussen de blauwe en groene tak
Ik kom vaak klanten tegen die twee omgevingen (blue-green deploy) gebruiken voor applicaties in productie. Dit maakt het snel schakelen tussen branches mogelijk bij de levering van nieuwe releases. Vaak kunnen er na de deployment ingrijpende veranderingen optreden die niet meteen opgemerkt worden. De degradatie van prestaties en beschikbaarheid is dan mogelijk niet zichtbaar. Voor snelle respons op dergelijke veranderingen is het beter om verschillende statistieken te gebruiken die het gebruikersgedrag weerspiegelen (aantal sessies en gebruikersacties, conversie, bounce rate). In de volgende afbeelding wordt een voorbeeld getoond waarin er bij een daling van de conversie geschakeld wordt tussen de softwarebranches.
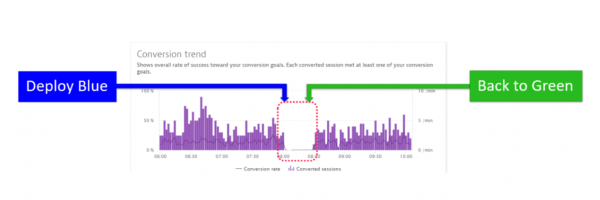 Daling van de conversie na het schakelen tussen softwarebranches.
Mechanismen voor automatische probleemdetectie
Aan het einde geef ik nog een voorbeeld van waarom ik Dynatrace zo leuk vind.
In mijn verhaal over het automatiseren van kwaliteitscontroles in de testomgeving bepaalden we alle drempelwaarden handmatig. Dit is normaal voor de testomgeving; de tester bepaalt zelf de indicatoren voor elke controle afhankelijk van de belasting. In productie is het wenselijk dat problemen automatisch worden ontdekt, rekening houdend met verschillende mechanismen voor baseline.
Dynatrace heeft interessante ingebouwde kunstmatige intelligentie tools die op basis van mechanismen voor het detecteren van afwijkende metrics (baselining) en het opbouwen van een interactiekaart tussen alle componenten, gebeurtenissen met elkaar vergelijken en correlaties maken, anomalieën in de werking van uw service detecteren en gedetailleerde informatie over elk probleem en de onderliggende oorzaak bieden.
Door automatisch de afhankelijkheden tussen componenten te analyseren, bepaalt Dynatrace niet alleen of de problematische dienst de hoofd oorzaak is, maar ook de afhankelijkheid ervan van andere diensten. In het onderstaande voorbeeld volgt Dynatrace automatisch de prestaties van elke dienst tijdens de uitvoering van transacties en identificeert het de Golang-dienst als de hoofd oorzaak.
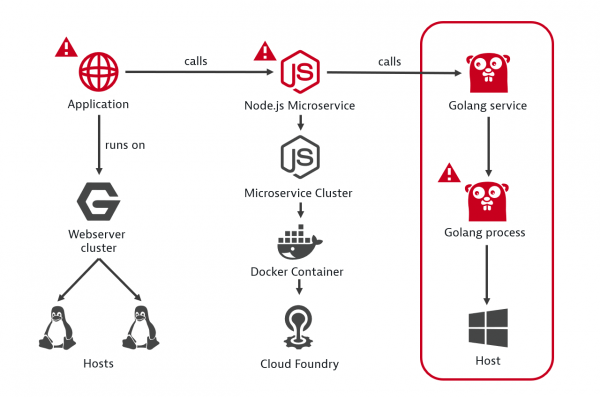 Voorbeeld van het vaststellen van de onderliggende oorzaak van een storing.
Op de volgende afbeelding wordt het proces van het monitoren van problemen met uw applicatie vanaf het begin van het incident afgebeeld.
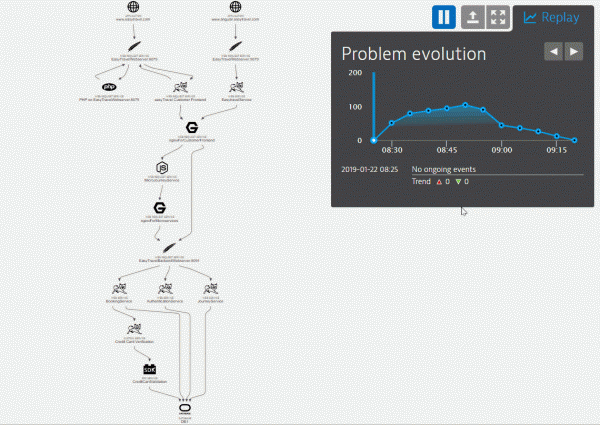 Visualisatie van het opkomende probleem met weergave van alle componenten en evenementen daarop.
Het monitoringsysteem heeft een volledige chronologie van gebeurtenissen rondom het probleem verzameld. In het venster onder de tijdlijn zien we alle belangrijke gebeurtenissen voor elk van de componenten. Op basis van deze gebeurtenissen kunt u procedures voor automatische correctie instellen in de vorm van codescripts.
Daarnaast raad ik aan om het monitoringsysteem te integreren met Service Desk of een bugtracker. Bij het optreden van een probleem krijgen ontwikkelaars snel volledige informatie voor hun analyse op het niveau van de code in de productieomgeving.
Conclusie
Uiteindelijk hebben we een CI/CD-pijplijn gecreëerd met ingebouwde geautomatiseerde kwaliteitscontroles in de pipeline. We minimaliseren het aantal onbetrouwbare builds, verhogen de algehele betrouwbaarheid van het systeem, en als de werking van het systeem toch verstoord raakt, activeren we mechanismen voor herstel.
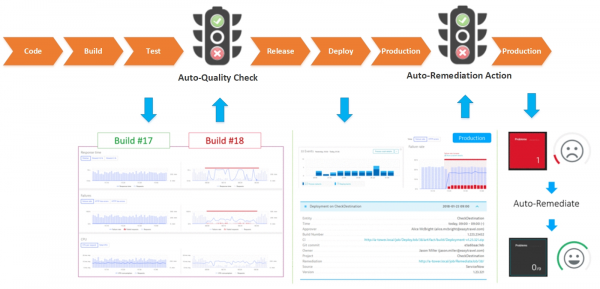
Het is zeker de moeite waard om inspanningen te investeren in de automatisering van kwaliteitsmonitoring van software, het is niet altijd een snel proces, maar op de lange termijn zal het zijn vruchten afwerpen. Ik raad aan om na de oplossing van een nieuw incident in de productieomgeving onmiddellijk na te denken over welke monitors moeten worden toegevoegd voor controles in de testomgeving om te voorkomen dat een slechte build in de productie terechtkomt, en ook om een script op te stellen voor de automatische correctie van deze problemen.
Ik hoop dat mijn voorbeelden u zullen helpen in uw inspanningen. Ik ben ook benieuwd naar uw voorbeelden van de gebruikte metrics voor het realiseren van zelfherstel van systeemprestaties.
Bron: habr.com
