

Tegenwoordig is hoge beschikbaarheid van services altijd en overal vereist, niet alleen in grote dure projecten. Tijdelijk onbeschikbare websites met de boodschap 'Sorry, onderhevig aan onderhoud' komen nog steeds voor, maar roepen meestal een milde glimlach op. Voeg daarbij het leven in de cloud, waar voor het opstarten van een extra server slechts één API-aanroep nodig is zonder dat je je zorgen hoeft te maken over 'hardware' exploitatie. En dan zijn er geen excuses meer waarom een kritische systemen niet betrouwbaar zijn gebouwd met behulp van clusteringtechnologieën en redundantie.
We zullen vertellen welke oplossingen we hebben overwogen om de betrouwbaarheid van databases in onze services te waarborgen en welke conclusies we hebben getrokken. Plus een demo met vergaande conclusies.
Legacy in de architectuur van hoge beschikbaarheid
Dit wordt nog duidelijker als je kijkt naar de ontwikkeling van verschillende opensource-systemen. Oude oplossingen waren gedwongen om technologieën voor hoge beschikbaarheid toe te voegen naarmate de vraag toenam. En de kwaliteit ervan was verschillend. Oplossingen van de nieuwe generatie maken hoge beschikbaarheid de basis van hun architectuur. Bijvoorbeeld, MongoDB positioneert clusters als de primaire gebruiksmethode. Een cluster schaalt horizontaal, wat een sterk concurrentievoordeel is voor deze DBMS.
Laten we terugkeren naar PostgreSQL. Dit is een van de oudste en populairste opensource-projecten, met de eerste release in 1995. Het team van het project beschouwde hoge beschikbaarheid lange tijd niet als een probleem dat door het systeem moest worden opgelost. Daarom werd replicatietechnologie voor het maken van datakopieën pas ingebouwd in versie 8.2 in 2006, maar deze was bestand-gebaseerd (log shipping). In 2010 werd in versie 9.0 streaming replicatie geïntroduceerd, en deze vormt de basis voor het creëren van verschillende clusters. Dit verbaast mensen die kennis maken met PostgreSQL na Enterprise SQL of moderne NoSQL — de standaardoplossing vanuit de gemeenschap is gewoon een paar master-replicas met synchrone of asynchrone replicatie. Daarbij wordt de master-switch in de stock handmatig uitgevoerd, en de vraag over het switchen van clients wordt ook voorgesteld als een zelfoplossend probleem.
Hoe we besloten om een betrouwbare PostgreSQL te implementeren en wat we daarvoor hebben gekozen
Toch zou PostgreSQL niet zo populair zijn geworden zonder een enorme hoeveelheid projecten en tools die helpen bij het opbouwen van een fouttolerante oplossing die geen constante aandacht vereist. In de cloud (MCS) zijn sinds de lancering van DBaaS enkele PostgreSQL-servers en master-replica paren met asynchrone replicatie beschikbaar geweest.
Natuurlijk wilden we het leven voor iedereen makkelijker maken en een PostgreSQL-installatie beschikbaar stellen die als basis voor hoogwaardige diensten kon dienen, zonder dat er constant op gelet hoefde te worden en zonder dat je 's nachts wakker hoefde te worden voor een failover. In dit segment zijn er zowel oude bewezen oplossingen als een nieuwe generatie tools die gebruikmaken van de laatste ontwikkelingen.
Tegenwoordig gaat het probleem van hoge beschikbaarheid niet om redundantie (dat ligt voor de hand), maar om consensus — het algoritme voor leiderschap (Leader election). Vaak gebeuren grote storingen niet door een gebrek aan servers, maar door consensusproblemen: er is geen nieuwe leider gekozen, er zijn twee leiders in verschillende datacenters, enzovoort. Een voorbeeld hiervan is het faillissement van de MySQL-cluster van Github — ze hebben een .
De wiskundige basis van deze kwestie is erg serieus. Aan de ene kant is er de , die theoretische beperkingen oplegt aan de mogelijkheden van het bouwen van HA-oplossingen, en aan de andere kant zijn er wiskundig bewezen algoritmes voor consensusbepaling, zoals de en . Op basis hiervan bestaan er behoorlijk populaire DCS (gedecentraliseerde consensus systemen) — Zookeeper, etcd, Consul. Daarom, als het besluitvormingsysteem gebaseerd is op een eigen algoritme dat zelf is geschreven, moet men daar uiterst voorzichtig mee omgaan. Na het analyseren van een enorme hoeveelheid systemen hebben we gekozen voor Patroni — een opensource-systeem dat voornamelijk wordt ontwikkeld door Zalando.
Als een lyrische uitweiding wil ik zeggen dat we ook multi-master oplossingen hebben overwogen, dat wil zeggen clusters die horizontaal schaalbaar zijn voor schrijfoperaties. We hebben echter om twee hoofdredenen besloten geen dergelijk cluster te maken. Ten eerste hebben deze oplossingen een hoge complexiteit en dus meer kwetsbare punten. Het zal moeilijk zijn om een stabiele oplossing voor alle gevallen te maken. Ten tweede, in dit geval verliest PostgreSQL zijn puurheid (native), sommige functies worden onbereikbaar, en bij sommige applicaties kunnen zich verborgen bugs voordoen tijdens het gebruik.
Patroni
Dus, hoe werkt Patroni? De ontwikkelaars hebben niet het wiel uitgevonden en hebben voorgesteld een van de bewezen DCS-oplossingen als basis te gebruiken. Dit omvat het beheer van alle vragen met betrekking tot configuratiesynchronisatie, leiderschap en quorum. We hebben gekozen voor etcd.
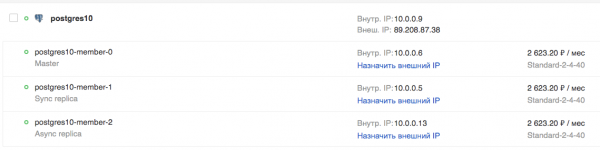
Vervolgens zorgt Patroni voor de juiste toepassing van alle instellingen op PostgreSQL en de replicatie-instellingen, evenals het uitvoeren van commando's voor switchover en failover (dat wil zeggen - normale en noodsituatie overschakeling van de master). In de cloud MCS kan een cluster worden gemaakt uit een master, een synchrone replica en een of meerdere asynchrone replica's. De aanwezigheid van een synchrone replica waarborgt de gegevensbehoud op ten minste 2 servers, en deze replica zal de belangrijkste 'kandidaat voor de master' zijn.
Aangezien etcd op dezelfde servers draait, wordt aanbevolen om 3 of 5 servers te hebben voor een optimale quorumwaarde. Dergelijk cluster kan horizontaal worden geschaald voor lezen (over de schaalbaarheid voor schrijven heb ik hierboven geschreven). Toch moet worden opgemerkt dat asynchrone replica's de neiging hebben om achter te blijven, vooral bij hoge belasting.
Het gebruik van dergelijke replica's voor lezen (hot standby) is gerechtvaardigd voor rapportage- of analytische taken en verlicht de masterserver.
Als je een dergelijk cluster zelf wilt opzetten, heb je het volgende nodig:
- 3 of meer servers voorbereiden, IP-adressering en firewallregels tussen hen instellen;
- pakketten voor de diensten etcd, Patroni en PostgreSQL installeren;
- etcd-cluster configureren;
- de patroni-service configureren om met PostgreSQL te werken.
In totaal moeten er een tiental configuratiebestanden correct worden opgesteld zonder fouten. Het is zeker de moeite waard om een configuration management tool te gebruiken, zoals Ansible. Bovendien ontbreekt hier nog steeds een high-availability TCP-balancer. Het maken daarvan is een apart project.
Voor degenen die een kant-en-klaar cluster nodig hebben, maar er niet mee willen rommelen, hebben we geprobeerd het leven te vereenvoudigen door een kant-en-klaar cluster op Patroni in onze cloud te maken, dat gratis kan worden getest. Behalve het cluster zelf hebben we:
- Een TCP-balancer; deze wijst altijd naar de huidige master via verschillende poorten, naar de synchrone of asynchrone replica, afhankelijk van de situatie;
- Een API voor het wisselen van de actieve master van Patroni.
Ze kunnen zowel via de MCS cloud API als de webconsole worden gekoppeld.
Demo
Laten we testen hoe de PostgreSQL-cluster in de MCS cloud zich gedraagt bij problemen met de database.
Hieronder staat de code van de applicatie, die kunstmatige evenementen zal loggen en dit op het scherm zal melden. In geval van fouten zal het dit melden en doorgaan met zijn werk in een lus, totdat we het stoppen met de combinatie Ctrl + C.
from __future__ import print_function

from datetime import datetime
from random import randint
from time import sleep
import psycopg2


def main():
    try:
        connection = psycopg2.connect(user = "admin",
                                      password = "P@ssw0rd",
                                      host = "89.208.87.38",
                                      port = "5432",
                                      database = "myproddb")

        cursor = connection.cursor()
        cursor.execute("SELECT version();")
        record = cursor.fetchone()
        print("Verbonden met", record[0])

        cursor.execute(
            "INSERT INTO log VALUES ({});".format(randint(1, 10000)))
        connection.commit()
        cursor.execute("SELECT COUNT(event_id) from log;")
        record = cursor.fetchone()
        print("Waarde gelogd, totale telling: {}".format(record[0]))
    except Exception as error:
        print ("Fout bij het verbinden met PostgreSQL", error)
    finally:
        if connection:
            cursor.close()
            connection.close()
            print("Verbinding gesloten")


if __name__ == '__main__':
    try:
        while True:
            try:
                print(datetime.now())
                main()
                sleep(3)
            except Exception as e:
                print("Fout opgevangen:
", e)
                sleep(1)
    except KeyboardInterrupt:
        print("afsluiten")
De applicatie heeft PostgreSQL nodig om te functioneren. Laten we een cluster maken in de MCS cloud, gebruikmakend van de API. In een gewone terminal, waar de variabele OS_TOKEN de token voor toegang tot de API bevat (deze kan worden verkregen met de opdracht openstack token issue), typen we de commando's:
We maken het cluster aan:
cat < pgc10.json
{"cluster":{"name":"postgres10","allow_remote_access":true,"datastore":{"type":"postgresql","version":"10"},"databases":[{"name":"myproddb"}],"users":[{"databases":[{"name":"myproddb"}],"name":"admin","password":"P@ssw0rd"}],"instances":[{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}},{"key_name":"shared","availability_zone":"DP1","flavorRef":"d659fa16-c7fb-42cf-8a5e-9bcbe80a7538","nics":[{"net-id":"b91eafed-12b1-4a46-b000-3984c7e01599"}],"volume":{"size":50,"type":"DP1"}}]}}
EOF

curl -s -H "X-Auth-Token: $OS_TOKEN"
-H 'Accept: application/json'
-H 'Content-Type: application/json'
-d @pgc10.json https://infra.mail.ru:8779/v1.0/ce2a41bbd1434013b85bdf0ba07c770f/clusters
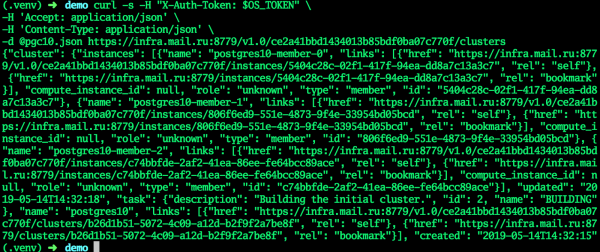
Wanneer de cluster de STATUS ACTIVE bereikt, zullen alle velden actuele waarden ontvangen — de cluster is klaar.
In de GUI:
Laten we proberen verbinding te maken en een tabel te maken:
psql -h 89.208.87.38 -U admin -d myproddb
Wachtwoord voor gebruiker admin:
psql (11.1, server 10.7)
Typ "help" voor hulp.

myproddb=> CREATE TABLE log (event_id integer NOT NULL);
CREATE TABLE
myproddb=> INSERT INTO log VALUES (1),(2),(3);
INSERT 0 3
myproddb=> SELECT * FROM log;
 event_id
----------
        1
        2
        3
(3 rijen)

myproddb=>
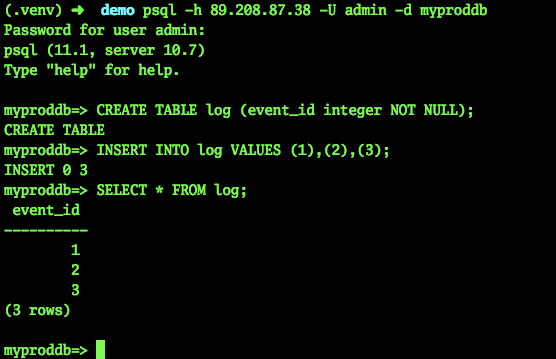
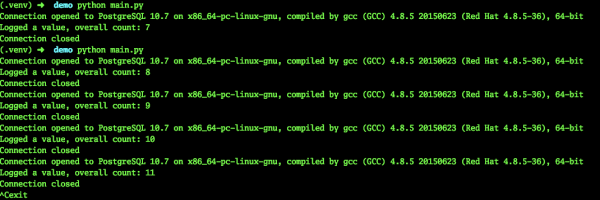
In de applicatie geven we de actuele instellingen voor verbinding met PostgreSQL op. We zullen het adres van de TCP-loadbalancer opgeven, zodat handmatige overschakeling naar het adres van de master niet nodig is. We starten het. Zoals te zien is, worden gebeurtenissen met succes gelogd in de database.
Geplande overschakeling van de master
Laten we nu de werking van onze applicatie testen tijdens de geplande overschakeling van de master:
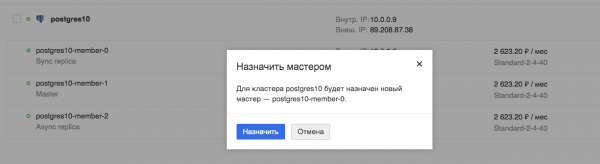
We observeren de applicatie. We zien dat de werking van de applicatie inderdaad wordt onderbroken, maar het duurt slechts een paar seconden, in dit specifieke geval, maximaal 9.
Uitval van de machine
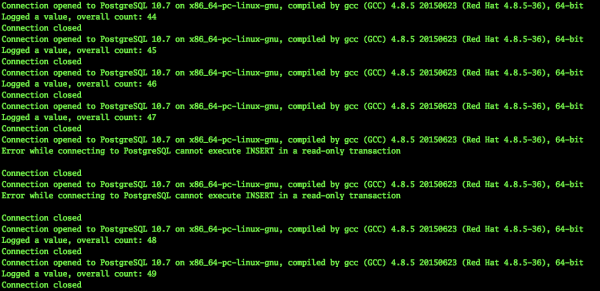
Laten we nu proberen de uitval van de virtuele machine, de huidige master, te simuleren. We zouden de virtuele machine via de Horizon-interface gewoon kunnen uitschakelen, maar dat zou een normale uitschakeling zijn. Een dergelijke overschakeling zou door alle services, inclusief Patroni, worden verwerkt.
We hebben echter een onvoorspelbare uitschakeling nodig. Daarom heb ik onze beheerders gevraagd om de virtuele machine — de huidige master — voor testdoeleinden op een onregelmatige manier uit te schakelen.
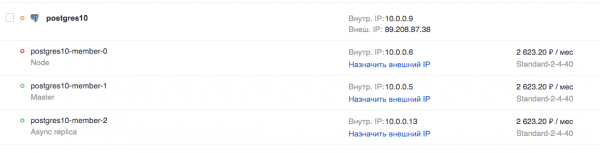
Ondertussen bleef onze applicatie werken. Het is duidelijk dat een dergelijke noodoverschakeling van de master niet onopgemerkt kan blijven.
2019-03-29 10:45:56.071234
Verbinding geopend naar PostgreSQL 10.7 op x86_64-pc-linux-gnu, gecompileerd door gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Waarde geregistreerd, totale telling: 453
Verbinding gesloten
2019-03-29 10:45:59.205463
Verbinding geopend naar PostgreSQL 10.7 op x86_64-pc-linux-gnu, gecompileerd door gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Waarde geregistreerd, totale telling: 454

Verbinding gesloten
2019-03-29 10:46:02.661440
Fout bij het verbinden met PostgreSQL: server sloot de verbinding onverwachts.
        Dit betekent waarschijnlijk dat de server abnormaal is beëindigd
        voordat of tijdens de verwerking van het verzoek.

Vangde fout:
 lokale variabele 'verbinding' werd verwezen voordat deze was toegewezen
……………………………………………………….. - hier is een bepaalde hoeveelheid fouten
2019-03-29 10:46:30.930445
Fout bij het verbinden met PostgreSQL: server sloot de verbinding onverwachts.
        Dit betekent waarschijnlijk dat de server abnormaal is beëindigd
        voordat of tijdens de verwerking van het verzoek.

Vangde fout:
 lokale variabele 'verbinding' werd verwezen voordat deze was toegewezen
2019-03-29 10:46:31.954399
Verbinding geopend naar PostgreSQL 10.7 op x86_64-pc-linux-gnu, gecompileerd door gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Waarde geregistreerd, totale telling: 455
Verbinding gesloten
2019-03-29 10:46:35.409800
Verbinding geopend naar PostgreSQL 10.7 op x86_64-pc-linux-gnu, gecompileerd door gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-36), 64-bit
Waarde geregistreerd, totale telling: 456
Verbinding gesloten
^Cexit
Zoals te zien is, kon de applicatie zijn werk binnen minder dan 30 seconden voortzetten. Ja, een aantal gebruikers van de dienst zal de problemen opmerken. Echter, dit is een serieuze serverstoring, iets dat niet vaak voorkomt. Een persoon (beheerder) zou waarschijnlijk niet zo snel hebben kunnen reageren, tenzij hij klaar zat met een togglescript in de console.
Uitslag
Naar mijn mening biedt zo'n cluster enorme voordelen voor beheerders. In wezen zullen ernstige storingen en uitval van database-servers niet merkbaar zijn voor de applicatie en dus ook niet voor de gebruiker. Er is geen noodzaak om iets in haast te repareren en over te schakelen naar tijdelijke configuraties, servers, enz. En als deze oplossing als een kant-en-klaar service in de cloud wordt gebruikt, is er geen tijd nodig voor de voorbereiding ervan. Men kan zich bezighouden met interessantere zaken.
Bron: habr.com
