

Het onderwerp van grote storingen in moderne datacenters roept vragen op waarvoor in het eerste artikel geen antwoorden waren — we hebben besloten dit verder uit te werken.
Als we de statistieken van het Uptime Institute mogen geloven, is het merendeel van de incidenten in datacenters gerelateerd aan uitval van de energievoorziening — deze vormen 39% van de incidenten. Daarop volgt de menselijke factor — dat is nog eens 24% van de storingen. De derde meest significante oorzaak (15%) waren uitvallen van het koelsysteem, en op de vierde plaats (12%) kwamen natuurrampen. De totale bijdrage van andere ongevallen bedraagt slechts 10%. Zonder afbreuk te doen aan de gegevens van deze gerenommeerde organisatie, zullen we gemeenschappelijke elementen in verschillende storingen benadrukken en proberen te begrijpen of ze vermeden hadden kunnen worden. Spoiler: in de meeste gevallen kan dat.
De wetenschap van contacten
Simpel gezegd zijn er met de energievoorziening slechts twee problemen: ofwel is er geen contact waar het zou moeten zijn, ofwel is er contact waar dat niet zou moeten zijn. Je kunt lang speculeren over de betrouwbaarheid van moderne ononderbroken stroomvoorzieningssystemen, maar ze bieden lang niet altijd een oplossing. Neem bijvoorbeeld de beruchte zaak van het door British Airways gebruikte datacenter, dat eigendom is van de moedermaatschappij International Airlines Group. Dichtbij Heathrow Airport zijn er twee van zulke objecten — Boadicea House en Comet House. In het eerste vond op 27 mei 2017 een toevallige stroomonderbreking plaats, wat leidde tot overbelasting en uitval van het UPS-systeem. Het gevolg was dat een deel van de IT-apparatuur fysiek beschadigd raakte, en het heeft drie dagen geduurd om de laatste storing te verhelpen.
De luchtvaartmaatschappij moest meer dan duizend vluchtannuleringen of -verplaatsingen doorvoeren, ongeveer 75.000 passagiers konden niet op tijd vertrekken — voor schadevergoedingen was $128 miljoen gemoeid, exclusief de kosten die nodig waren om de werking van de datacenters te herstellen. Het verhaal achter de oorzaken van de blackout is onduidelijk. Als we de resultaten van het interne onderzoek, gepresenteerd door CEO van International Airlines Group Willie Walsh, mogen geloven, is het gebeurd door een fout van ingenieurs. Desondanks had het ononderbroken stroomvoorzieningssysteem zo'n onderbreking moeten kunnen weerstaan — daarvoor is het immers aangelegd. Het datacenter werd beheerd door specialisten van het uitbestedingsbedrijf CBRE Managed Services, waardoor British Airways probeerde de schade via de Londense rechtbank te verhalen.
Stroomuitvallen verlopen volgens vergelijkbare scenario's: eerst is er een uitschakeling door de energievoorziener, soms als gevolg van slecht weer of interne problemen (inclusief personeelsovereenkomsten), en vervolgens kan het ononderbroken stroomvoorzieningssysteem de belasting niet aan of veroorzaakt een kortstondige onderbreking van de sinusgolf storingen bij tal van diensten, waarvan het herstel een hoop tijd en geld kost. Kan men dergelijke storingen voorkomen? Absoluut. Dat kan, mits het systeem goed wordt ontworpen, maar zelfs de makers van grote datacentra zijn niet immuun voor fouten.
Menselijke factor
Wanneer onjuiste acties van datacenterpersoneel de directe oorzaak van een incident zijn, raken de problemen meestal (maar niet altijd) de softwarekant van de IT-infrastructuur. Dergelijke storingen komen zelfs voor in grote bedrijven. In februari 2017 werden door een verkeerd ingevoerde opdracht van een lid van de technische exploitatiegroep van een van de datacentra een aantal servers van Amazon Web Services uitgeschakeld. De fout deed zich voor tijdens het debuggen van het factureringsproces voor klanten van de Amazon Simple Storage Service (S3). De medewerker probeerde een aantal virtuele servers die door het factureringssysteem werden gebruikt, te verwijderen, maar raakte een grotere cluster.
Als gevolg van de fout van de engineer werden servers verwijderd waarop belangrijke softwaremodulen van de cloudopslag van Amazon draaiden. In het bijzonder werd het indexeringssub systeem beschadigd, dat informatie bevatte over de metadata en de locatie van alle S3-objecten in de Amerikaanse regio US-EAST-1. Het incident had ook invloed op het systeem dat werd gebruikt voor gegevensopslag en het beheer van de beschikbare opslagcapaciteit. Na de verwijdering van de virtuele machines vereisten deze twee subsystemen een volledige herstart, en vervolgens wachtte een verrassing voor de engineers van Amazon — gedurende een lange periode kon de openbare cloudopslag geen klantverzoeken verwerken.
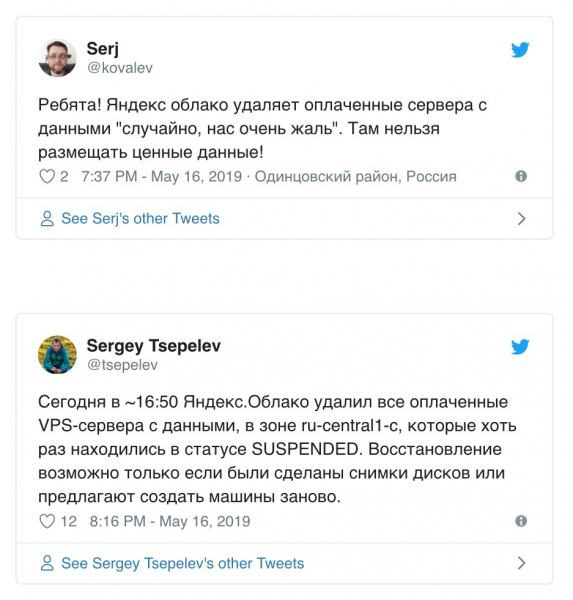
Het effect was omvangrijk, aangezien veel grote platforms gebruikmaken van Amazon S3. Storingen hebben invloed gehad op Trello, Coursera, IFTTT en, wat het meest vervelend is, de diensten van grote Amazon-partners uit de S&P 500. Het is moeilijk om de schade in dergelijke gevallen te berekenen, maar deze bleek in de orde van grootte van honderden miljoenen dollars te liggen. Zoals je ziet, is het voldoende om één foute opdracht uit te voeren om de grootste cloudplatformdiensten te verstoren. Dit is niet een eenmalig geval; op 16 mei 2019, tijdens onderhoudswerkzaamheden, was de dienst Yandex.Cloud virtuele machines van gebruikers in de zone ru-central1-c die ooit in de status SUSPENDED stonden. Hier zijn al klantgegevens verloren gegaan, waarvan een deel onherstelbaar verloren is. Natuurlijk zijn mensen niet perfect, maar moderne systemen voor informatiebeveiliging zijn sinds lang in staat om de acties van bevoegde gebruikers te controleren vóór het uitvoeren van de door hen ingevoerde opdrachten. Door dergelijke oplossingen in Yandex of Amazon te implementeren, kunnen soortgelijke incidenten worden voorkomen.
Bevroren koeling
In januari 2017 vond er een grote storing plaats in het datacenter van het bedrijf ‘MegaFon’ in Dmitrov. De temperatuur in de regio Moskou daalde tot -35 °C, wat leidde tot een uitval van het koelsysteem van het object. De persdienst van de operator wilde niet veel vertellen over de oorzaken van het incident – Russische bedrijven praten zeer terughoudend over ongelukken in hun bezittingen, wat betreft publieke transparantie blijven we ver achter op het Westen. Op sociale media ging de theorie rond dat de warmteoverdrachtvloeistof in de leidingen langs de straat was bevroren en dat er ethyleenglycol was gelekt. Als we deze theorie geloven, kon de exploitatieafdeling door de lange feestdagen niet snel 30 ton koelvloeistof verkrijgen en moest zij improviseren met beschikbare middelen, waarbij ze een geïmproviseerde frikoeling organiseerden in strijd met de regels voor de werking van het systeem. De extreme kou verergerde het probleem – in januari vond er plotseling een winter plaats in Rusland, hoewel niemand dit verwachtte. Uiteindelijk moest het personeel een deel van de serverrekken uitschakelen, waardoor sommige diensten van de operator gedurende twee dagen niet bereikbaar waren.
Misschien kan hier ook gesproken worden van een weeranomalie, maar zulke kou is voor de hoofdstad geen bijzonders. De temperatuur in de winter in de regio Moskou kan ook tot veel lagere waarden dalen, daarom worden datacenters gebouwd met het oog op een betrouwbare werking bij −42°C. Meestal falen koelsystemen bij vorst door een te lage concentratie van glycolen en een teveel aan water in de koelvloeistof. Er zijn ook problemen met de installatie van leidingen of met fouten in het ontwerp en de test van het systeem, voornamelijk gerelateerd aan de wens om te besparen. Uiteindelijk komt er bij een relatief onschuldig probleem een ernstige storing voor, die eigenlijk had kunnen worden voorkomen.
Natuurrampen
Meestal verstoren onweders en/of orkanen de werking van de technische infrastructuur van het datacenter, wat resulteert in het stoppen van diensten en/of fysiek schade aan de apparatuur. Incidenten veroorzaakt door slecht weer komen vrij vaak voor. In 2012 raasde orkaan Sandy met zware regen over de westkust van de VS. Het datacenter Peer 1, gelegen in een wolkenkrabber in Lower Manhattan, , nadat zout zeewater de kelders had overspoeld. De noodgeneratoren waren op de 18e verdieping geplaatst en de brandstofvoorraad was beperkt — regels die na de aanslagen op 9/11 in New York zijn ingevoerd, verbieden het opslaan van grote hoeveelheden brandstof op hogere verdiepingen.
De brandstofpomp viel ook uit, waardoor het personeel enkele dagen handmatig diesel voor de generators moest vervoeren. De heldhaftigheid van het team redde het datacenter van een ernstige storing, maar was die echt nodig? We leven op een planeet met een stikstof-zuurstofatmosfeer en veel water. Onweders en orkanen zijn hier gebruikelijk (vooral in kustgebieden). Ontwerpers zouden waarschijnlijk de bijbehorende risico's in overweging moeten nemen en een geschikt ononderbroken stroomvoorzieningssysteem moeten bouwen. Of in ieder geval een geschiktere locatie voor het datacenter kiezen dan een wolkenkrabber op een eiland.
Alles verder
In deze categorie onderscheidt het Uptime Institute verschillende incidenten, waarbij het moeilijk is om een typisch geval te kiezen. Diefstallen van koperen kabels, inbraken in datacenters, elektrische steunpilaren en transformatorstations, voertuigen, branden die de optica beschadigen door graafmachines, knaagdieren (ratten, konijnen en zelfs wombats, die eigenlijk tot de buideldieren behoren), evenals liefhebbers die willen oefenen met schieten op draden — het aanbod is uitgebreid. Stroomstoringen kunnen zelfs worden veroorzaakt door van elektriciteit bij een illegale marihuanaplantage. In de meeste gevallen zijn specifieke mensen verantwoordelijk voor het incident, dat wil zeggen dat we opnieuw met de menselijke factor te maken hebben, waarbij het probleem een naam en een achternaam heeft. Zelfs als een ongeluk op het eerste gezicht lijkt samen te hangen met een technische storing of natuurrampen, kan het worden voorkomen met een goede ontwerp van het object en een juiste exploitatie. Uitzonderingen zijn mogelijk kritieke schade aan de infrastructuur van datacenters of de vernietiging van gebouwen en constructies door een natuurramp. Dit zijn werkelijk overmachtssituaties; alle andere problemen worden veroorzaakt door de verbinding tussen de computer en de stoel — dit is wellicht het minst betrouwbare deel van elk complex systeem.
Bron: habr.com
