

Fijne vrijdag allemaal! Vrienden, vandaag gaan we door met de serie publicaties over de cursus , want de lessen in de nieuwe groep beginnen al aan het einde van volgende week. Laten we beginnen!
Monitoring is gewoon. Dat is een bekend feit. Zet Nagios op, start NRPE op het externe systeem, configureer Nagios op poort NRPE TCP 5666 en je hebt monitoring.
Het is zo eenvoudig dat het saai is. Nu heb je de basisstatistieken over CPU-tijd, schijfsubsystemen, en RAM, die standaard binnenkomen in Nagios en NRPE. Maar dit is eigenlijk geen 'monitoring' op zich. Dit is slechts het begin.
(Meestal installeert men PNP4Nagios, RRDtool en Thruk, configureert men notificaties in Slack en gaat men direct naar nagiosexchange, maar laten we dat nu even vergeten).
Goede monitoring is eigenlijk best complex; je moet echt weten hoe de applicatie die je monitort in elkaar steekt.
Is monitoring moeilijk?
Elke server, of het nu Linux of Windows is, heeft per definitie een bepaald doel. Apache, Samba, Tomcat, bestandsopslag, LDAP - al deze diensten zijn meer of minder uniek op een of meerdere manieren. Elke heeft zijn eigen functie, zijn eigen kenmerken. Er zijn verschillende manieren om metrics en KPI's (key performance indicators) te verkrijgen die voor jou interessant zijn wanneer de server onder belasting is.
Auteur van de foto en een werkende opdracht krijgen.
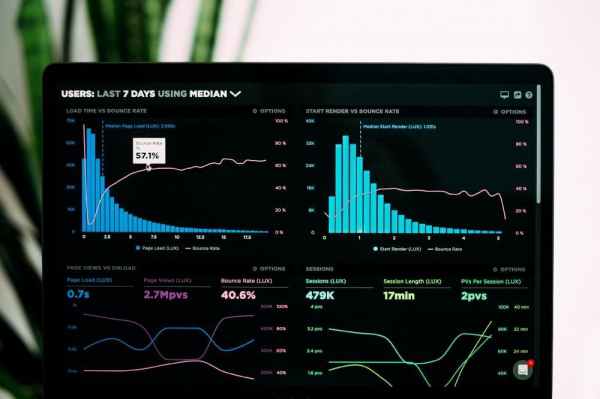
(- ik zou willen dat mijn dashboards in neonblauw waren — dromend zuchtend —… hm…)
Elke software die diensten levert, moet een mechanisme hebben voor het verzamelen van metrics. Apache heeft de module mod-status, die de statuspagina van de server weergeeft. Nginx heeft stub_status. Tomcat heeft JMX of speciale webapplicaties die belangrijke metrics tonen. In MySQL is er de opdracht 'show global status', enz.
Waarom bouwen ontwikkelaars dergelijke mechanismen niet in de applicaties die ze maken?
Doen alleen ontwikkelaars dit?
Een bepaald niveau van onverschilligheid bij het inbouwen van metrics beperkt zich niet tot ontwikkelaars. Ik heb gewerkt bij bedrijven die applicaties met Tomcat ontwikkelden en geen van hun metrics, geen logboeken van de activiteitsservice, gaven, behalve de algemene foutlogboeken van Tomcat. Sommige ontwikkelaars genereren een overvloed aan logs die niets betekenen voor de systeembeheerder die het geluk heeft ze om 3:15 's nachts te moeten lezen.
Auteur van de foto en een werkende opdracht krijgen.
Systeemingenieurs die dergelijke producten in productie brengen, moeten ook verantwoordelijk zijn voor de situatie. Weinig systeemingenieurs hebben de tijd en de motivatie om significante statistieken uit de logs te halen, zonder de context van deze statistieken en de mogelijkheid om ze te interpreteren in het licht van de activiteiten van de applicatie. Sommigen begrijpen niet welke voordelen ze eruit kunnen halen, behalve indicatoren zoals 'er is momenteel iets mis (of zal dat binnenkort zijn)'.
De verandering van denkwijze met betrekking tot de noodzaak van metrics moet niet alleen plaatsvinden bij ontwikkelaars, maar ook bij systeemingenieurs.
Voor elke systeemingenieur die niet alleen moet reageren op kritieke gebeurtenissen, maar ook moet garanderen dat ze afwezig zijn, is het ontbreken van metrics meestal een obstakel.
Echter, systeemingenieurs duiken meestal niet in de code, terwijl ze geld verdienen voor hun bedrijf. Ze hebben leidende ontwikkelaars nodig die het belang begrijpen van de verantwoordelijkheden van een systeemingenieur bij het identificeren van problemen, het vergroten van het bewustzijn van prestatieproblemen, enzovoort.
Dit devops-ding
De devops-mentaliteit beschrijft de synergie tussen de denkwijzen van ontwikkelaars (dev) en operaties (ops). Elke onderneming die beweert dat ze 'devops doen', moet:
- zeggen wat ze waarschijnlijk niet doen (een knipoog naar de meme uit de film 'The Princess Bride' - 'Ik denk niet dat dat betekent wat jij denkt dat het betekent!')
- een houding van continue productverbetering bevorderen.
Je kunt een product niet verbeteren en weten dat het is verbeterd als je niet weet hoe het momenteel functioneert. Je kunt niet begrijpen hoe het product werkt als je niet begrijpt hoe de componenten, de services waar het van afhankelijk is, de belangrijkste pijnpunten en knelpunten werken.
Als je geen potentiële knelpunten observeert, kun je de techniek van 'Vijf Waarom' niet volgen bij het schrijven van een Postmortem. Je kunt niet alles op één scherm samenbrengen om te zien hoe het product functioneert of om te begrijpen hoe het eruit ziet als 'normaal en gelukkig'.
Verschuiving naar links, LINKS, IK ZEI, LEEEEEFT—
Voor mij is een van de belangrijkste principes van Devops 'Verschuiving naar links' (shift left). Verschuiving naar links in deze context betekent een verschuiving van de mogelijkheid (niet de verantwoordelijkheid, en alleen mogelijkheden) doen wat systeemingenieurs doorgaans doen, zoals het creëren van prestatiemetrics, logs efficiënter gebruiken, enzovoort, aan de linkerkant van de levenscyclus van softwarelevering (Software Delivery Life Cycle).
Auteur van de foto en een werkende opdracht krijgen.
Softwareontwikkelaars moeten in staat zijn om de bewakingstools die het bedrijf gebruikt te begrijpen en te gebruiken om alle vormen van monitoring uit te voeren, metrics, logging, monitoringinterfaces en, het belangrijkste, te observeren hoe hun product in productie werkt.. Je kunt ontwikkelaars niet dwingen om tijd en energie in monitoring te steken, zolang ze niet kunnen zien hoe de metrics eruitzien en hoe de producteigenaar deze aan zijn CTO op de volgende briefing zal presenteren, enzovoort.
Kortom,
- Breng het paard naar het water. Laat ontwikkelaars zien hoeveel problemen ze voor zichzelf kunnen vermijden, help ze de juiste KPI's en metrics voor hun applicaties te identificeren, zodat er minder geklaagd wordt door de producteigenaar, die door de technische directeur (CTO) wordt toegeschreeuwd. Breng ze zachtjes en rustig naar de verlichting. Als dit niet lukt, koop ze dan om, dreig, of overtuig hen of de producteigenaar om zo snel mogelijk de ontvangst van deze metrics uit de applicaties te realiseren, en teken daarna de diagrams. Dit zal moeilijk zijn, omdat het niet als een prioriteit zal worden beschouwd, en de productroutekaart zal veel projecten met een inkomstenverwachting bevatten die in afwachting zijn van uitvoering. Daarom heb je een economische rechtvaardiging nodig om de tijd en middelen die besteed worden aan de implementatie van monitoring in het product te rechtvaardigen.
- Help system engineers get some sleep. Show them that using the 'release checklist' for any product being launched is a good practice. Checking that all applications in production are covered by metrics will help achieve restful nights, allowing developers to see what is and isn’t working. However, the best way to annoy and frustrate any developer, product owner, or technical director is to stubbornly throw obstacles in their way and resist. Such behavior will impact the release date of any product if we wait until the last minute again, so be sure to shift left and address these issues in the project plan as soon as possible. If necessary, sneak into product meetings. Wear fake mustaches and a felt hat or something like that; it never fails. Raise your concerns, showcase the obvious benefits, and evangelize.
- Ensure that both developers (dev) and operations (ops) understand the significance and the consequences of metrics entering the 'red zone'. Don’t leave operations as the sole guardians of product reliability; make sure developers are involved too (#productsquads).
- Logs are great, but so are metrics. Combine them and don’t let your logs turn into trash in a massive, burning ball of uselessness. Explain and show developers why no one but them will decode their logs; show them what it’s like to sift through useless logs at 3:15 AM.
Auteur van de foto en een werkende opdracht krijgen.
That’s all for now. New material will be released next week. If you’d like to learn more about the course, we invite you to , which will take place on Monday. We’re typically looking forward to your comments.
Bron: habr.com
