

Achtergrond
Het gebeurde dat de server werd aangevallen door een ransomware-virus, dat gelukkig gedeeltelijk ongerept .ibd-bestanden heeft achtergelaten (bestanden met ruwe gegevens van InnoDB-tabellen), maar volledig de .fpm-bestanden (structuurbestanden) heeft versleuteld. De .idb-bestanden konden worden onderverdeeld in:
- bestanden die kunnen worden hersteld via standaardhulpmiddelen en handleidingen. Voor dergelijke gevallen is er een uitstekende ;
- gedeeltelijk versleutelde tabellen. Dit zijn voornamelijk grote tabellen waarvoor (zoals ik begreep) de aanvallers niet genoeg geheugen hadden voor volledige versleuteling;
- en volledig versleutelde tabellen die niet kunnen worden hersteld.
Bepalen tot welke variant de tabellen behoren, kon eenvoudig door het bestand in een teksteditor met de juiste codering (in mijn geval UTF8) te openen en te controleren op aanwezigheden van tekstvelden, bijvoorbeeld:
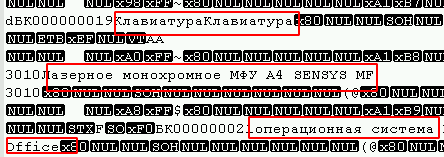
Ook in het begin van het bestand zijn er veel nullen te zien, en virussen die blokversleuteling toepassen (de meest voorkomende) raken deze meestal ook aan.

In mijn geval lieten de aanvallers aan het einde van elk versleuteld bestand een reeks van 4 bytes (1, 0, 0, 0) achter, wat de taak vergemakkelijkte. Voor het vinden van niet-geïnfecteerde bestanden was er zelfs een script nodig:
def opened(path):
    files = os.listdir(path)
    for f in files:
        if os.path.isfile(path + f):
            yield path + f

for full_path in opened("C:somepath"):
    file = open(full_path, "rb")
    last_string = ""
    for line in file:
        last_string = line
        file.close()
    if (last_string[len(last_string) -4:len(last_string)]) != (1, 0, 0, 0):
        print(full_path)
Zo kon ik bestanden vinden die tot de eerste type behoorden. De tweede omvat een lange handmatige benadering, maar er was al genoeg gevonden. Alles zou goed zijn, maar het is noodzakelijk om te weten de absoluut exacte structuur en (natuurlijk) ontstond er een situatie waarbij ik met een vaak veranderende tabel moest werken. Niemand kon zich herinneren of het veldtype was veranderd of dat er een nieuwe kolom was toegevoegd.
Helaas kon Debri City niet helpen bij zo'n geval, daarom wordt dit artikel geschreven.
Ter zake
Er is een tabelstructuur van drie maanden geleden die niet overeenkomt met de huidige (mogelijk in één veld, maar misschien ook meer). De tabelstructuur is als volgt:
CREATE TABLE `table_1` (
    `id` INT (11),
    `date` DATETIME ,
    `description` TEXT ,
    `id_point` INT (11),
    `id_user` INT (11),
    `date_start` DATETIME ,
    `date_finish` DATETIME ,
    `photo` INT (1),
    `id_client` INT (11),
    `status` INT (1),
    `lead__time` TIME ,
    `sendstatus` TINYINT (4)
);
En dit is wat je moet extraheren:
id_pointINT (11);id_userINT (11);date_startDATETIME ;date_finishDATETIME .
Voor herstel wordt byte-voor-byte-analyse van het .ibd-bestand gebruikt, gevolgd door conversie naar een leesbaarder formaat. Aangezien het voldoende is om deze datatypes zoals int en datetime te analyseren om het vereiste te vinden, worden in dit artikel alleen deze types beschreven; soms zal ik ook naar andere datatypes verwijzen, wat kan helpen bij soortgelijke situaties.
Probleem 1: in de velden met de types DATETIME en TEXT waren er NULL-waarden, en in het bestand werden deze gewoon overgeslagen, waardoor het niet mogelijk was om een structuur voor herstel in mijn geval te bepalen. In de nieuwe kolommen was de standaardwaarde null, en delen van de transactie konden verloren zijn gegaan door de instelling innodb_flush_log_at_trx_commit = 0, daarom zou het extra tijd kosten om de structuur te bepalen.
Probleem 2: we moeten er rekening mee houden dat rijen die via DELETE zijn verwijderd nog steeds in het ibd-bestand blijven, maar bij ALTER TABLE zal hun structuur niet worden bijgewerkt. Uiteindelijk kan de datastructuur variëren van het begin van het bestand naar het einde. Als je vaak OPTIMIZE TABLE gebruikt, zul je waarschijnlijk niet met dit probleem worden geconfronteerd.
Let op, de versie van de DBMS beïnvloedt de manier waarop gegevens worden opgeslagen, en dit voorbeeld werkt mogelijk niet voor andere major versies. In mijn geval werd de Windows-versie van mariadb 10.1.24 gebruikt. Ook, hoewel je in mariadb met InnoDB-tabellen werkt, zijn ze in feite , wat de toepasbaarheid van de methode met InnoDB mysql uitsluit.
Analyse van het bestand
In Python geeft het datatype de gegevens weer in Unicode in plaats van de gebruikelijke reeks cijfers. Hoewel je het bestand op deze manier kunt bekijken, kun je voor gebruiksgemak de bytes omzetten naar numerieke vormen door de byte-array naar een gewoon array om te zetten (list(example_byte_array)). In ieder geval kunnen beide methoden handig zijn voor de analyse.
Na het bekijken van verschillende ibd-bestanden kun je het volgende tegenkomen:
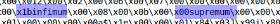
En als je het bestand splits volgens deze sleutelwoorden, krijg je meestal gelijkmatige blokken gegevens. We zullen infimum gebruiken als scheidingslijn.
table = table.split("infimum".encode())Een interessante observatie is dat voor tabellen met een klein aantal gegevens er tussen infimum en supremum een aanwijzer is naar het aantal rijen in het blok.
 — testtabel met 1 rij
 — testtabel met 2 rijen
De stringarray table[0] kan worden overgeslagen. Nadat ik het heb bekeken, kon ik geen ruwe tabelgegevens ontdekken. Waarschijnlijk dient dit blok voor het opslaan van indexen en sleutels.
Vanaf table[1] en door deze om te zetten naar een numerieke array, zijn er al enkele patronen zichtbaar, namelijk:
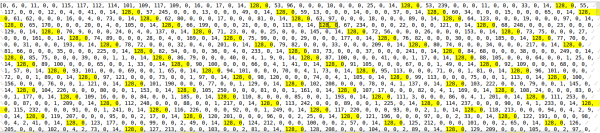
Dit zijn int-waarden opgeslagen als string. De eerste byte geeft aan of het getal positief of negatief is. In mijn geval zijn alle getallen positief. Uit de overige 3 bytes kan het getal worden bepaald met behulp van de volgende functie. Script:
def find_int(val: str):  # voorbeeld '128, 1, 2, 3'
    val = [int(v) for v in val.split(", ")]
    result_int = val[1]*256**2 + val[2]*256*1 + val[3]
    return result_int
Bijvoorbeeld, 128, 0, 0, 1 = 1, of 128, 0, 75, 108 = 19308.
In de tabel was er een primaire sleutel met auto-increment, en deze kan hier ook worden gevonden.
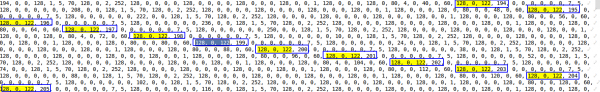
Door gegevens uit de testtabellen te vergelijken, werd vastgesteld dat het DATETIME-object uit 5 bytes bestond en begon met 153 (waarschijnlijk wijst dit op jaarlijkse intervallen). Aangezien het bereik van DATTIME '1000-01-01' tot '9999-12-31' is, denk ik dat het aantal bytes kan variëren, maar in mijn geval vallen de gegevens binnen het bereik van 2016 tot 2019, dus we zullen aannemen dat 5 bytes voldoende zijn.
Voor het bepalen van de tijd zonder seconden, zijn de volgende functies geschreven. Script:
day_ = lambda x: x % 64 // 2  # {x,x,X,x,x }

def hour_(x1, x2):  # {x,x,X1,X2,x}
    if x1 % 2 == 0:
        return x2 // 16
    elif x1 % 2 == 1:
        return x2 // 16 + 16
    else:
        raise ValueError

min_ = lambda x1, x2: (x1 % 16) * 4 + (x2 // 64)  # {x,x,x,X1,X2}
Voor het jaar en de maand is het niet gelukt om een goed functionerende functie te schrijven, daarom moest ik hardcoden. Script:
ym_list = {'2016, 1': '153, 152, 64', '2016, 2': '153, 152, 128',
           '2016, 3': '153, 152, 192', '2016, 4': '153, 153, 0',
           '2016, 5': '153, 153, 64', '2016, 6': '153, 153, 128',
           '2016, 7': '153, 153, 192', '2016, 8': '153, 154, 0',
           '2016, 9': '153, 154, 64', '2016, 10': '153, 154, 128',
           '2016, 11': '153, 154, 192', '2016, 12': '153, 155, 0',
           '2017, 1': '153, 155, 128', '2017, 2': '153, 155, 192',
           '2017, 3': '153, 156, 0', '2017, 4': '153, 156, 64',
           '2017, 5': '153, 156, 128', '2017, 6': '153, 156, 192',
           '2017, 7': '153, 157, 0', '2017, 8': '153, 157, 64',
           '2017, 9': '153, 157, 128', '2017, 10': '153, 157, 192',
           '2017, 11': '153, 158, 0', '2017, 12': '153, 158, 64',
           '2018, 1': '153, 158, 192', '2018, 2': '153, 159, 0',
           '2018, 3': '153, 159, 64', '2018, 4': '153, 159, 128',
           '2018, 5': '153, 159, 192', '2018, 6': '153, 160, 0',
           '2018, 7': '153, 160, 64', '2018, 8': '153, 160, 128',
           '2018, 9': '153, 160, 192', '2018, 10': '153, 161, 0',
           '2018, 11': '153, 161, 64', '2018, 12': '153, 161, 128',
           '2019, 1': '153, 162, 0', '2019, 2': '153, 162, 64',
           '2019, 3': '153, 162, 128', '2019, 4': '153, 162, 192',
           '2019, 5': '153, 163, 0', '2019, 6': '153, 163, 64',
           '2019, 7': '153, 163, 128', '2019, 8': '153, 163, 192',
           '2019, 9': '153, 164, 0', '2019, 10': '153, 164, 64',
           '2019, 11': '153, 164, 128', '2019, 12': '153, 164, 192',
           '2020, 1': '153, 165, 64', '2020, 2': '153, 165, 128',
           '2020, 3': '153, 165, 192','2020, 4': '153, 166, 0',
           '2020, 5': '153, 166, 64', '2020, 6': '153, 1, 128',
           '2020, 7': '153, 166, 192', '2020, 8': '153, 167, 0',
           '2020, 9': '153, 167, 64','2020, 10': '153, 167, 128',
           '2020, 11': '153, 167, 192', '2020, 12': '153, 168, 0'}

def year_month(x1, x2):  # {x,X,X,x,x }

    for key, value in ym_list.items():
        key = [int(k) for k in key.replace("'", "").split(", ")]
        value = [int(v) for v in value.split(", ")]
        if x1 == value[1] and x2 // 64 == value[2] // 64:
            return key
    return 0, 0
Ik ben er zeker van dat, als je er een zekere tijd aan besteedt, deze verwarring kan worden opgelost.
Hierna de functie die een datetime-object retourneert vanuit een string. Script:
def find_data_time(val:str):
    val = [int(v) for v in val.split(", ")]
    day = day_(val[2])
    hour = hour_(val[2], val[3])
    minutes = min_(val[3], val[4])
    year, month = year_month(val[1], val[2])
    return datetime(year, month, day, hour, minutes)
Het is gelukt om vaak terugkerende waarden van int, int, datetime, datetime te vinden. 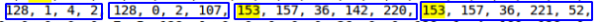 , dat lijkt precies te zijn wat nodig is. Bovendien komt deze volgorde niet twee keer in dezelfde string voor.
Met behulp van reguliere expressies vinden we de benodigde gegevens:
fined = re.findall(r'128, d*, d*, d*, 128, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*, 153, 1[6,5,4,3]d, d*, d*, d*', int_array)Let op, dat bij het zoeken met deze expressie, NULL-waarden in de vereiste velden niet kunnen worden gedefinieerd, maar in mijn geval is dat niet kritisch. Vervolgens doorlopen we de gevonden resultaten. Script:
result = []
for val in fined:
    pre_result = []
    bd_int  = re.findall(r"128, d*, d*, d*", val)
    bd_date= re.findall(r"(153, 1[6,5,4,3]d, d*, d*, d*)", val)
    for it in bd_int:
        pre_result.append(find_int(bd_int[it]))
    for bd in bd_date:
        pre_result.append(find_data_time(bd))
    result.append(pre_result)
Eigenlijk is alles, de gegevens uit de array result zijn precies de gegevens die we nodig hebben. ###PS.###
Ik begrijp dat deze aanpak lang niet voor iedereen geschikt zal zijn, maar het belangrijkste doel van het artikel is eerder om aan te zetten tot actie dan om al jouw problemen op te lossen. Ik denk dat de meest juiste oplossing zou zijn om de broncode zelf te gaan bestuderen. , maar vanwege de beperkte tijd lijkt de huidige methode de snelste optie.
In sommige gevallen, door het bestand te analyseren, kun je de geschatte structuur bepalen en het op een van de standaard manieren herstellen zoals hierboven beschreven. Dit zal veel beter zijn en minder problemen opleveren.
Bron: habr.com
