

Hallo allemaal. Ik ben de hoofd systeembeheerder bij OK en ben verantwoordelijk voor de stabiele werking van het portaal. Ik wil vertellen over hoe we het proces van automatische schijfvervanging hebben ingericht, en vervolgens hoe we de beheerder uit dit proces hebben verwijderd en vervangen door een bot.
Dit artikel is een soort transliteratie van op HighLoad+ 2018
Het opbouwen van het proces voor schijfvervanging
Eerst een paar cijfers
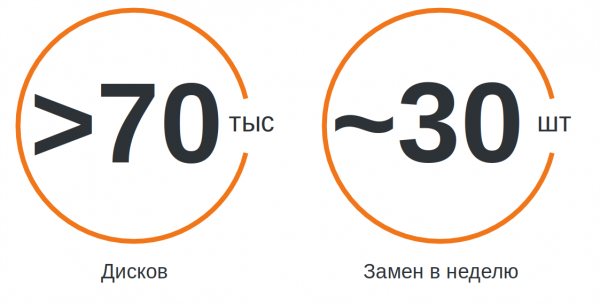
OK is een gigantische service die door miljoenen mensen wordt gebruikt. Het wordt beheerd door ongeveer 7.000 servers, die zich in 4 verschillende datacenters bevinden. In de servers zitten meer dan 70.000 schijven. Als je ze stapelt, krijg je een toren van meer dan 1 km hoog.
Harde schijven zijn de component van de server die het vaakst defect raakt. Bij zulke volumes moeten we ongeveer 30 schijven per week vervangen, en deze procedure is een onaangename routine geworden.
Incidenten
Bij ons in het bedrijf is er een volledig incidentmanagementsysteem. We registreren elk incident in Jira en lossen het vervolgens op. Als het incident invloed op gebruikers had, komen we zeker samen om te bespreken hoe we sneller kunnen reageren in dergelijke gevallen, hoe we de impact kunnen verminderen en natuurlijk hoe we herhaling kunnen voorkomen.
Opslagmedia zijn geen uitzondering. Hun toestand wordt bewaakt door Zabbix. We monitoren berichten in Syslog op lees-/schrijffouten, analyseren de status van HW/SW-RAIDs, houden SMART in de gaten en berekenen de slijtage voor SSD's.
Hoe schijven vroeger werden vervangen
Wanneer er in Zabbix een trigger afgaat, wordt er een incident in Jira aangemaakt en automatisch toegewezen aan de betreffende engineers in de datacentra. Dit doen we voor alle HW-incidenten, dat wil zeggen de incidenten die enige fysieke arbeid met de apparatuur in het datacenter vereisen.
De engineer van het datacenter is de persoon die zich bezighoudt met hardware-vragen, verantwoordelijk is voor de installatie, onderhoud en demontage van servers. Na ontvangst van een ticket gaat de engineer aan de slag. In de schijfkasten vervangt hij zelf de schijven. Maar als hij geen toegang heeft tot het benodigde apparaat, vraagt de engineer om hulp van de beschikbare systeembeheerders. In eerste instantie moet de schijf uit de rotatie worden gehaald. Hiervoor moeten de nodige wijzigingen op de server worden aangebracht, toepassingen worden gestopt en de schijf worden afgemonteerd.
De dienstdoende systeembeheerder is tijdens de werkshift verantwoordelijk voor de werking van het hele portaal. Hij onderzoekt incidenten, voert reparaties uit en helpt ontwikkelaars met kleine taken. Hij houdt zich alleen niet bezig met harde schijven.
Eerder communiceerden datacenteringineurs met de systeembeheerder via chat. Ingenieurs stuurden links naar Jira-tickets, de beheerder ging deze na en hield een log bij in een notitieboek. Maar voor zulke taken zijn chats ongemakkelijk: de informatie is daar niet gestructureerd en gaat snel verloren. Bovendien kon de beheerder gewoon van de computer weggaan en enige tijd niet op verzoeken reageren, terwijl de ingenieur bij de server stond met een stapel schijven en wachtte.
Maar het ergste was dat de beheerders het geheel niet zagen: welke schijfincidenten er waren en waar potentiële problemen konden ontstaan. Dit komt doordat we alle HW-incidenten doorspeelden aan de ingenieurs. Ja, het was mogelijk om alle incidenten op het dashboard van de beheerder weer te geven, maar er waren er zoveel en de beheerder werd maar bij sommige betrokken.
Bovendien kon de ingenieur geen juiste prioriteiten stellen omdat hij niets wist over de functie van bepaalde servers en de verdeling van informatie over de opslagmedia.
Nieuwe vervangprocedure
Het eerste wat we deden, was alle schijfincidenten onderbrengen in een aparte type "HW-schijf" en we hebben er velden aan toegevoegd zoals "naam blokapparaat", "grootte" en "type schijf" zodat deze informatie in het ticket werd opgeslagen en we er niet voortdurend in de chat over hoefden te wisselen.
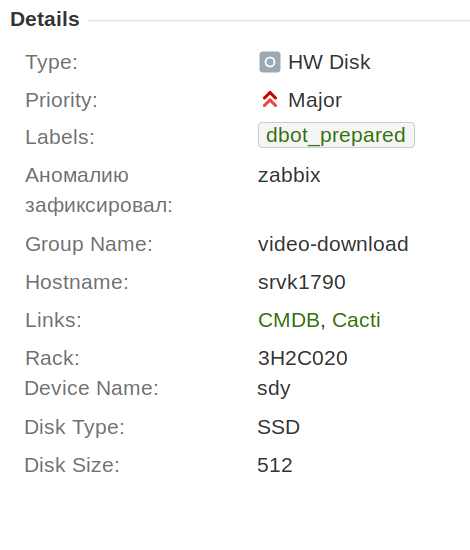
Ook hebben we afgesproken dat we binnen één incident slechts één schijf zullen vervangen. Dit heeft het proces van automatisering, statistiekverzameling en werkzaamheden aanzienlijk vereenvoudigd.
Daarnaast hebben we een veld "verantwoordelijke administrator" toegevoegd. Hier wordt automatisch de dienstdoende systeembeheerder ingevuld. Dit is erg handig, omdat de ingenieur nu altijd ziet wie verantwoordelijk is. Het is niet nodig om in de agenda te kijken en het te zoeken. Dit veld heeft het mogelijk gemaakt om tickets die mogelijk zijn hulp nodig hebben op het dashboard van de beheerder te plaatsen.
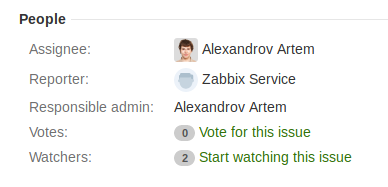
Om ervoor te zorgen dat alle deelnemers optimaal profiteren van de innovaties, hebben we filters en dashboards gemaakt en dit met de mensen besproken. Wanneer mensen de veranderingen begrijpen, distantiëren ze zich er niet van als iets onnodigs. Voor de engineer is het belangrijk om het racknummer te kennen waar de server zich bevindt, de grootte en het type schijf. De administrator moet in de eerste plaats begrijpen wat voor groep servers dit is en welk effect er kan zijn bij het vervangen van de schijf.
Het hebben van velden en hun weergave is handig, maar het heeft ons niet bevrijd van de noodzaak om chats te gebruiken. Hiervoor moesten we de werkprocessen aanpassen.
Vroeger was het zo:
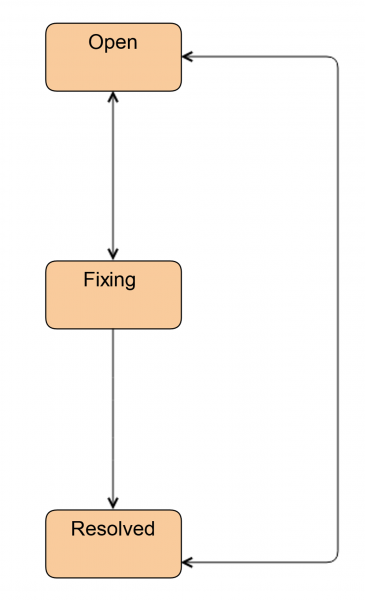
Vandaag de dag werken engineers nog steeds zo, wanneer ze geen hulp van een administrator nodig hebben.
Het eerste dat we deden, was een nieuwe status in te voeren: Investigate. In deze status bevindt de ticket zich wanneer de engineer nog niet heeft besloten of hij een administrator nodig heeft of niet. Via deze status kan de engineer de ticket aan de administrator overdragen. Bovendien markeren we met deze status tickets wanneer een schijf vervangen moet worden, maar de schijf zelf niet op locatie aanwezig is. Dit gebeurt soms in het geval van CDN en externe locaties.
We hebben ook de status toegevoegd: Klaar. De ticket wordt naar deze status overgezet na de vervanging van de schijf. Dat wil zeggen, alles is al gedaan, maar de HW/SW RAID op de server is nog aan het synchroniseren. Dit kan behoorlijk wat tijd in beslag nemen.
Als een administrator bij het werk betrokken is, wordt het schema iets ingewikkelder.
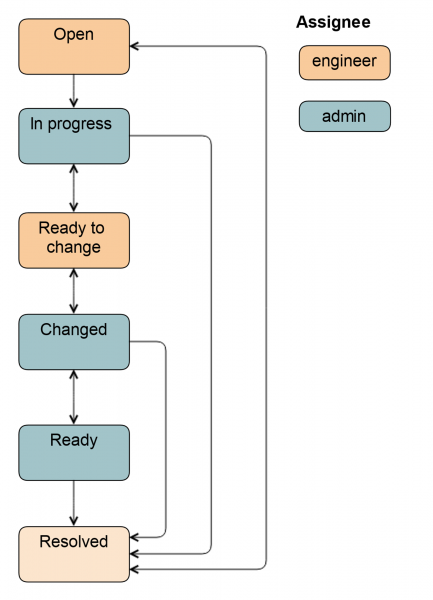
Van de status Open kan de ticket zowel door de systeemadministrator als de engineer worden overgezet. In de status In progress haalt de administrator de schijf uit de roulatie zodat de engineer deze eenvoudig kan verwijderen: hij schakelt de verlichting in, demonteert de schijf, stopt applicaties, afhankelijk van de specifieke groep servers.
Vervolgens wordt de ticket overgezet naar Ready to change: dit is een signaal voor de engineer dat de schijf gerecycled kan worden. Alle velden in Jira zijn al ingevuld, de engineer weet welk type en grootte schijf het moet zijn. Deze gegevens worden ofwel automatisch in het vorige status ingevoerd of door de administrator.
Na de vervanging van de schijf wordt de ticket overgezet naar de status Changed. Er wordt gecontroleerd of de juiste schijf is geplaatst, er wordt een indeling gemaakt, de applicatie wordt gestart en er zijn enkele taken voor gegevensherstel. De ticket kan ook worden overgezet naar de status Klaar, in dit geval blijft de verantwoordelijkheid bij de administrator doordat hij de schijf in de roulatie heeft gebracht. Het volledige schema ziet er als volgt uit.
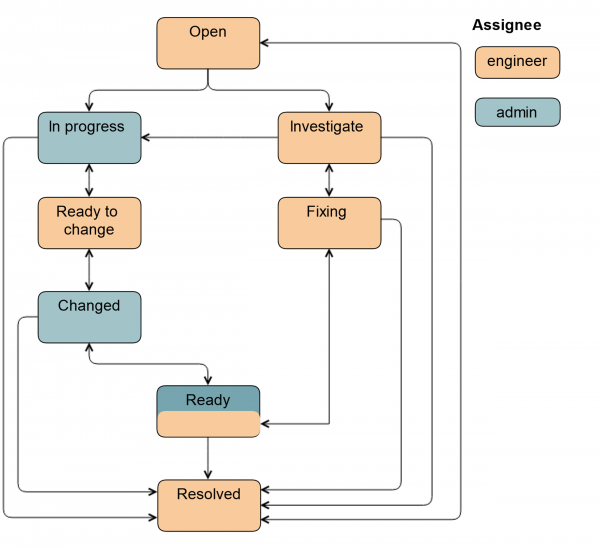
Het toevoegen van nieuwe velden heeft ons leven aanzienlijk vergemakkelijkt. De jongens werken nu met gestructureerde informatie, en het is duidelijk wat er op welk moment gedaan moet worden. Prioriteiten zijn veel relevanter geworden, omdat deze nu door de beheerder worden vastgesteld.
De noodzaak voor chats is vervallen. Natuurlijk kan de beheerder de ingenieur een bericht sturen met "hier moet sneller worden vervangen" of "het is al avond, lukt het om te vervangen?". Maar we communiceren niet meer dagelijks via chats over deze zaken.
Schijven worden nu in batches vervangen. Als de beheerder iets eerder op kantoor komt, heeft hij wat vrije tijd en is er nog niets gebeurd, kan hij een aantal servers voorbereiden voor vervanging: velden instellen, schijven uit rotatie halen en de taak aan de ingenieur overdragen. De ingenieur komt iets later in het datacenter, ziet de taak, pakt de benodigde opslagmedia van het magazijn en vervangt ze meteen. Hierdoor is de vervangingssnelheid toegenomen.
De opgedane ervaring bij het opzetten van de workflow.
- Bij het opstellen van de procedure moet informatie uit verschillende bronnen worden verzameld.
Sommige van onze beheerders wisten niet dat de ingenieur de schijven zelf vervangt. Sommigen dachten dat de ingenieurs toezicht hielden op de synchronisatie van MD RAID, hoewel niet iedereen daartoe toegang had. Sommige senior ingenieurs deden dit, maar niet altijd, omdat het proces nergens was gedocumenteerd. - De procedure moet eenvoudig en begrijpelijk zijn.
Het is moeilijk voor mensen om veel stappen in hun hoofd te houden. De belangrijkste naastliggende statussen in Jira moeten op het hoofdscherm worden weergegeven. We kunnen ze hernoemen; bijvoorbeeld, In progress noemen we Ready to change. En de andere statussen kunnen in een dropdown-menu worden verborgen, zodat ze niet in het oog springen. Maar het is beter om mensen niet te beperken, geef ze de mogelijkheid om de overgang te maken.
Leg de waarde van innovaties uit. Wanneer mensen het begrijpen, accepteren ze de nieuwe procedure beter. Voor ons was het erg belangrijk dat mensen niet gewoon door het proces heen klikken, maar er daadwerkelijk doorheen lopen. Daarna hebben we daarop automatisering opgebouwd. - Wachten, analyseren, begrijpen.
Het kostte ons ongeveer een maand om de procedure op te zetten, de technische implementatie, vergaderingen en discussies. En de implementatie nam meer dan drie maanden in beslag. Ik zag hoe mensen langzaam beginnen gebruik te maken van de vernieuwing. In de eerste fasen was er veel negativiteit. Maar dit hing helemaal niet af van de procedure zelf of de technische uitvoering ervan. Bijvoorbeeld, één beheerder gebruikte niet Jira, maar een Jira-plug-in in Confluence, waardoor hem bepaalde dingen niet toegankelijk waren. Toen we hem Jira lieten zien, nam de productiviteit van de beheerder toe, zowel voor algemene taken als voor schijfvervangingen.
Automatisering van schijfvervangingen
We hebben verschillende pogingen gedaan om schijfvervangingen te automatiseren. We hadden al enkele voorbereidende werkzaamheden en scripts, maar deze werkten allemaal ofwel in een interactieve of handmatige modus en vereisten handmatige uitvoering. Pas na de implementatie van de nieuwe procedure realiseerden we ons dat we precies datgene misten.
Nu het proces van schijfvervanging in fasen is opgedeeld, met een aangewezen uitvoerder en een lijst van acties voor elke fase, kunnen we de automatisering gefaseerd invoeren, en niet ineens. Bijvoorbeeld, de eenvoudigste fase - Ready (controle van RAID/data-synchronisatie) - kan gemakkelijk aan een bot worden gedelegeerd. Zodra de bot iets is opgeleid, kunnen we hem een verantwoordelijkere taak geven - het invoegen van de schijf in rotatie, enzovoort.
Zootje van setups
Voordat we over de bot gaan praten, laten we een korte rondleiding maken door onze installatie-zoo. Dit is in de eerste plaats te wijten aan de enorme omvang van onze infrastructuur. Ten tweede proberen we voor elke service de optimale hardwareconfiguratie te vinden. We hebben ongeveer 20 modellen van hardware RAID, voornamelijk LSI en Adaptec, maar er zijn ook HP en DELL van verschillende versies. Elke RAID-controller heeft zijn eigen beheertool. De set van commando's en de uitvoer kan per versie verschillen bij elke RAID-controller. Waar HW-RAID niet wordt gebruikt, kan mdraid worden gebruikt.
Vrijwel alle nieuwe installaties doen we zonder schijfreservering. We proberen hardware- en software RAID niet meer te gebruiken, omdat we onze systemen op datacenter-niveau en niet op server-niveau reserveren. Maar natuurlijk zijn er veel legacy-servers die moeten worden ondersteund.
Sommige schijven worden in RAID-controllers als raw-apparaten doorgegeven, terwijl andere JBOD gebruiken. Er zijn configuraties met één systeemschijf in de server, en als deze moet worden vervangen, moet de server opnieuw worden ingezet met het installeren van het besturingssysteem en applicaties, en dan moeten dezelfde versies worden toegevoegd, evenals configuratiebestanden, en moeten applicaties worden opgestart. Daarnaast zijn er veel groepen servers waar redundantie niet op het niveau van het opslag subsysteem plaatsvindt, maar direct in de applicaties zelf.
In totaal hebben we meer dan 400 unieke groepen servers waarop ongeveer 100 verschillende applicaties draaien. Om zoveel varianten te dekken hadden we een multifunctioneel automatiseringsinstrument nodig. Bij voorkeur met een eenvoudige DSL, zodat niet alleen degene die het schreef, het kan onderhouden.
We hebben voor Ansible gekozen omdat het agentloos is: er hoefde geen infrastructuur te worden voorbereid, het heeft een snelle opstart. Bovendien is het geschreven in Python, dat als standaard binnen het team is aanvaard.
Algemene schema
Laten we het algemene schema van automatisering bekijken aan de hand van één incident. Zabbix detecteert dat schijf sdb is uitgevallen, een trigger gaat af, en er wordt een ticket in Jira aangemaakt. De beheerder kijkt naar het ticket, ziet dat het geen duplicaat en geen false positive is, dat wil zeggen dat de schijf moet worden vervangen, en zet het ticket op In progress.
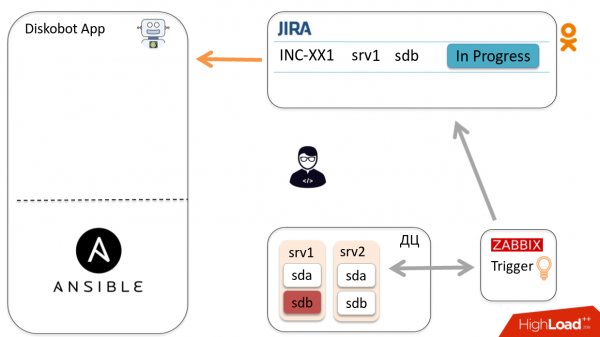
De applicatie DiskoBot, geschreven in Python, vraagt periodiek Jira om nieuwe tickets. Het merkt op dat er een nieuw ticket In progress is, en de bijbehorende thread wordt geactiveerd, die het playbook in Ansible start (dit gebeurt voor elke status in Jira). In dit geval wordt Prepare2change gestart.
Ansible wordt naar de host gestuurd, haalt de schijf uit de rotatie en rapporteert de status terug aan de applicatie via Callbacks.
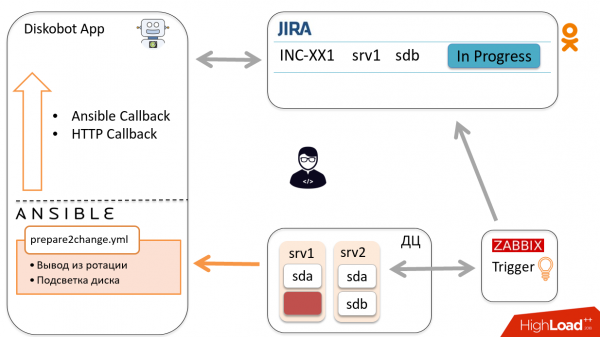
Op basis van de resultaten zet de bot automatisch het ticket op Ready to change. De ingenieur ontvangt een melding en gaat de schijf vervangen, waarna het ticket op Changed wordt gezet.
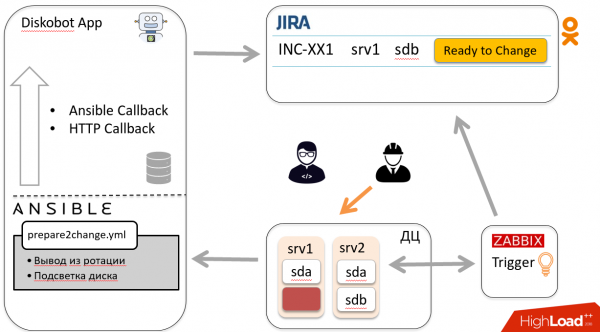
Volgens het eerder beschreven schema komt het ticket terug bij de bot, die een ander playbook start, naar de host gaat en de schijf weer in de rotatie invoert. De bot sluit het ticket. Hoera!
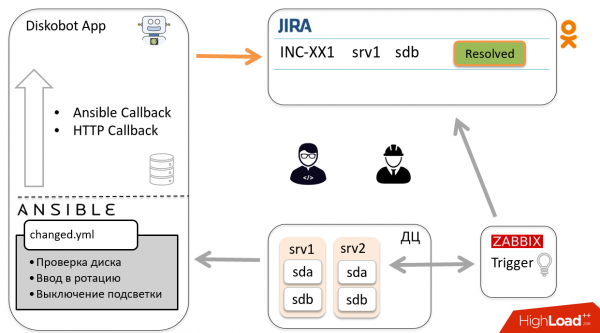
Laten we nu enkele componenten van het systeem bespreken.
Diskobot
Deze applicatie is geschreven in Python. Het selecteert tickets uit Jira op basis van JQL. Afhankelijk van de status van het ticket, komt het bij de juiste handler terecht, die op zijn beurt het bijbehorende Ansible playbook start.
JQL en opvraagintervallen zijn gedefinieerd in het configuratiebestand van de applicatie.
jira_states:
  investigate:
    jql: '… status = Open and "Disk Size" is EMPTY'
    interval: 180

  inprogress:
    jql: '…  and "Disk Size" is not EMPTY and "Device Name" is not EMPTY'

  ready:
    jql: '… and (labels not in ("dbot_ignore") or labels is EMPTY)'
    interval: 7200
Bijvoorbeeld, onder de tickets in status In progress worden alleen de tickets geselecteerd waarvan de velden Disk size en Device name zijn ingevuld. Device name is de naam van het blokapparaat dat nodig is voor het uitvoeren van het playbook. Disk size is nodig zodat de engineer weet welke grootte schijf vereist is.
Onder de tickets met status Ready worden tickets met het label dbot_ignore gefilterd. Overigens gebruiken we Jira-labels zowel voor dergelijke filtering als voor het markeren van duplicaat-tickets en het verzamelen van statistieken.
In het geval van een playbook-fout wijst Jira het label dbot_failed toe, zodat we later kunnen analyseren.
Interacties met Ansible
De applicatie interageert met Ansible via . In playbook_executor geven we de bestandsnaam en een set variabelen door. Dit maakt het mogelijk om het Ansible-project in de vorm van gewone yml-bestanden te houden in plaats van het in Python-code te beschrijven.
Daarnaast worden in Ansible via *extra_vars* de naam van het blokapparaat, de status van het ticket en de callback_url doorgegeven, waarin de issue key is ingebed — deze wordt gebruikt voor de callback in HTTP.
Voor elke uitvoering wordt er een tijdelijke inventory gegenereerd, bestaande uit één host en een groep waarin deze host zich bevindt, zodat de group_vars van toepassing zijn.
Hier is een voorbeeldtaak waarin de HTTP callback is geïmplementeerd.
De resultaten van de uitvoering van playbooks ontvangen we via callback(s). Ze zijn van twee typen:
- , deze geeft gegevens over de resultaten van de uitvoering van het playbook. Hierin zijn de taken beschreven die zijn gestart, succesvol of onsuccesvol uitgevoerd. Deze callback wordt aangeroepen aan het einde van het afspelen van het playbook.
- HTTP callback om informatie te verkrijgen tijdens het afspelen van het playbook. In de Ansible-taak voeren we een POST/GET-aanroep uit naar onze applicatie.
Via HTTP callback(s) worden variabelen doorgegeven die zijn gedefinieerd tijdens de uitvoering van het playbook en die we willen opslaan en gebruiken in toekomstige uitvoeringen. Deze gegevens schrijven we in sqlite.
Ook via HTTP callback laten we opmerkingen achter en veranderen we de status van het ticket.
HTTP callback
# Make callback to Diskobot App
# Variables:
#    callback_post_body: # A dict with follow keys. All keys are optional
#       msg: If exist it would be posted to Jira as comment
#       data: If exist it would be saved in Incident.variables
#       desire_state: Set desire_state for incident
#       status: If exist Proceed issue to that status

  - name: Callback to Diskobot app (jira comment/status)
    uri:
      url: "{{ callback_url }}/{{ devname }}"
      user: "{{ diskobot_user }}"
      password: "{{ diskobot_pass }}"
      force_basic_auth: True
      method: POST
      body: "{{ callback_post_body | to_json }}"
      body_format: json
    delegate_to: 127.0.0.1
Net als veel vergelijkbare taken hebben we deze in een apart common-bestand ondergebracht en voegen we het toe wanneer nodig, om herhaling in playbooks te voorkomen. Hierin wordt een callback_url genoemd, waarin de issue key en de hostnaam zijn verwerkt. Wanneer Ansible deze POST-aanroep uitvoert, begrijpt de bot dat deze afkomstig is van een bepaalde incident.
Hier is een voorbeeld uit een playbook waarin we een schijf uit een MD-apparaat hebben gehaald:
  # Save mdadm configuration
  - include: common/callback.yml
    vars:
      callback_post_body:
        status: 'Ready to change'
        msg: "Removed disk from mdraid {{ mdadm_remove_disk.msg | comment_jira }}"
        data:
          mdadm_data: "{{ mdadm_remove_disk.removed }}"
          parted_info: "{{ parted_info | default() }}"
    when:
      - mdadm_remove_disk | changed
      - mdadm_remove_disk.removed
Deze taak verandert de status van het Jira-ticket naar "Klaar om te veranderen" en voegt een opmerking toe. Ook wordt in de variabele mdam_data een lijst bewaard van de md-apparaten waaruit de schijf is verwijderd, en in parted_info - een dump van de partitie van parted.
Wanneer de engineer een nieuwe schijf plaatst, kunnen we deze variabelen gebruiken om de dump van de partities te herstellen en de schijf weer aan de md-apparaten toe te voegen waaruit deze was verwijderd.
Ansible controle modus
Automatisering inschakelen was eng. Daarom hebben we besloten om alle playbooks in de modus
te draaien, waarin Ansible geen acties op servers uitvoert, maar deze alleen simuleert.
Zo'n uitvoering gebeurt via een apart callback-module, en we bewaren de uitvoerresultaten van het playbook als een opmerking in Jira.
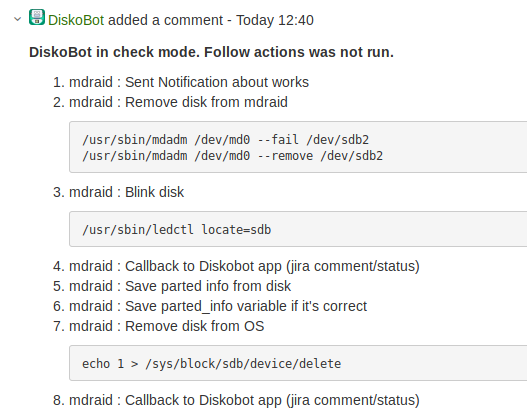
Ten eerste stelde dit ons in staat om het functioneren van de bot en de playbooks te valideren. Ten tweede verhoogde het het vertrouwen van de beheerders in de bot.
Toen we de validatie doorlopen hadden en begrepen dat we Ansible niet alleen in dry run mode konden uitvoeren, hebben we in Jira een knop 'Run Diskobot' gemaakt om hetzelfde playbook met dezelfde variabelen op dezelfde host in normale modus uit te voeren.
Bovendien wordt de knop gebruikt om het playbook opnieuw te starten in geval van een fout.
Structuur van Playbooks
Ik heb eerder vermeld dat de bot verschillende playbooks uitvoert, afhankelijk van de status van het Jira-ticket.
Ten eerste is het veel makkelijker om de toegang te organiseren.
Ten tweede is het in sommige gevallen gewoon noodzakelijk.
Bijvoorbeeld, wanneer een systeemschijf wordt vervangen, moet je in eerste instantie naar het implementatiesysteem gaan, een taak aanmaken en na een correcte implementatie zal de server via ssh toegankelijk zijn, en kan de applicatie erop worden geïnstalleerd. Als we dit allemaal in één playbook zouden doen, zou Ansible het vanwege de ontoegankelijkheid van de host niet kunnen uitvoeren.
We gebruiken Ansible-rollen voor elke servergroep. Hier is te zien hoe de playbook(s) in een van hen zijn georganiseerd.
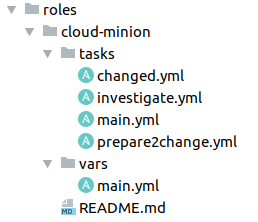
Dit is handig, omdat het meteen duidelijk is waar welke taken zich bevinden. In main.yml, dat de toegang is voor de Ansible-rol, kunnen we gewoon een include hebben op basis van de status van het ticket of algemene taken die voor iedereen nodig zijn, zoals identificatie of het verkrijgen van een token.
Investigation.yml
Het wordt uitgevoerd voor tickets in de status Investigation en Open. Het belangrijkste voor deze playbook is de naam van het blokapparaat. Deze informatie is niet altijd beschikbaar.
Om deze te verkrijgen, analyseren we de Jira-samenvatting, de laatste waarde van de Zabbix-trigger. Daar kan de naam van het blokapparaat staan — geluk hebben. Of het kan een mount point zijn, dan moeten we naar de server gaan, parseren en de juiste schijf berekenen. Ook kan de trigger een scsi-adres of andere informatie doorgeven. Maar soms zijn er helemaal geen aanwijzingen, en moeten we analyseren.
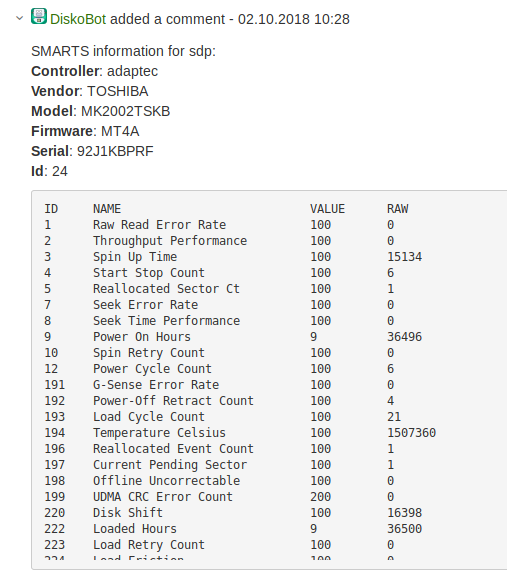
Als we de naam van het blokapparaat hebben vastgesteld, verzamelen we informatie over het type en de grootte van de schijf om de velden in Jira in te vullen. We verzamelen ook informatie over de verkoper, het model, de firmware, ID, SMART, en voegen dit alles toe in de opmerking in het Jira-ticket. De administrator en de engineer hoeven deze gegevens nu niet meer te zoeken. 🙂
prepare2change.yml
Het uitnemen van de schijf uit de rotatie, ter voorbereiding op vervanging. De moeilijkste en meest verantwoordelijke fase. Hier kan je de applicatie stoppen wanneer dit niet kan. Of de schijf eruit halen waarvan de replica’s ontbreken, wat impact kan hebben op de gebruikers en dataverlies kan veroorzaken. Hier hebben we de meeste controles en notificaties in de chat.
In het eenvoudigste geval gaat het om het verwijderen van de schijf uit HW/MD RAID.
In complexere situaties (in onze opslagsystemen), wanneer failover op applicatieniveau plaatsvindt, moeten we naar de applicatie gaan via de API, het uithalen van de schijf melden, deze deactiveren en het herstel starten.
We migreren momenteel massaal naar , en als de server cloud-gebaseerd is, dan vraagt Diskobot de cloud API, meldt dat hij met deze minion gaat werken — de server waarop de containers draaien — en vraagt om "migreer alle containers van deze minion". En hij activeert ook de verlichting van de schijf, zodat de engineer meteen kan zien welke eruit moet.
changed.yml
Na de vervanging van de schijf controleren we in de eerste plaats de beschikbaarheid ervan.
Ingenieurs plaatsen niet altijd nieuwe schijven, dus hebben we een controle toegevoegd voor SMART-waarden die aan onze eisen voldoen.
Welke attributen bekijken weAantal opnieuw toegewezen sectoren (5) < 100
Huidig aantal hangende sectoren (107) == 0
Als de schijf de test niet doorstaat, wordt de ingenieur geïnformeerd over de vervangingsverplichting. Als alles in orde is, wordt de verlichting uitgeschakeld, een markering aangebracht en wordt de schijf in rotatie gebracht.
ready.yml
De eenvoudigste situatie: controle van de synchronisatie van HW/SW-raid of het beëindigen van de gegevenssynchronisatie in de toepassing.
Toepassings-API's
Ik heb al een paar keer genoemd dat de bot vaak de toepassingen-API's aanroept. Natuurlijk hadden niet alle toepassingen de benodigde methoden, dus moesten we deze aanpassen. Hier zijn de belangrijkste methoden die we gebruiken:
- Status. De status van de cluster of schijf om te begrijpen of je ermee kunt werken;
- Start/stop. Activeren deactiveren van de schijf;
- Migreer/herstel. Migratie en herstel van gegevens tijdens en na de vervanging.
Ervaringen met Ansible
Ik ben dol op Ansible. Maar vaak, wanneer ik naar verschillende opensource-projecten kijk en zie hoe mensen playbooks schrijven, ben ik een beetje bang. Complexe logische samenhang van when/loop, gebrek aan flexibiliteit en idempotentie door veelvuldig gebruik van shell/commando.
We hebben besloten alles zo eenvoudig mogelijk te houden door gebruik te maken van de modulaire voordelen van Ansible. Op het hoogste niveau zijn er playbooks, die elke beheerder of externe ontwikkelaar die iets van Ansible weet, kan schrijven.
- naam: Schijf knipperen
  become: True
  registreer: locate_action
  disk_locate:
      locate: '{{ locate }}'
      devname: '{{ devname }}'
      ids: '{{ locate_ids | default(pd_id) | default(omit) }}'
Als het moeilijk is om bepaalde logica in playbooks te implementeren, brengen we het naar een Ansible-module of filter. Scripts kunnen in Python of elke andere taal worden geschreven.
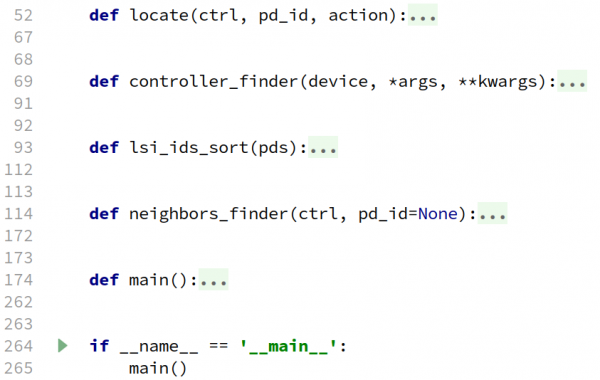
Ze zijn eenvoudig en snel te schrijven. Bijvoorbeeld, de module voor het knipperen van de schijf, waarvan het gebruik hierboven is aangetoond, bestaat uit 265 regels.
Op het allerlaagste niveau bevindt zich de bibliotheek. Voor dit project hebben we een aparte toepassing geschreven, een soort abstractie bovenop de hardware- en software-RAID, die de overeenkomstige verzoeken uitvoert.
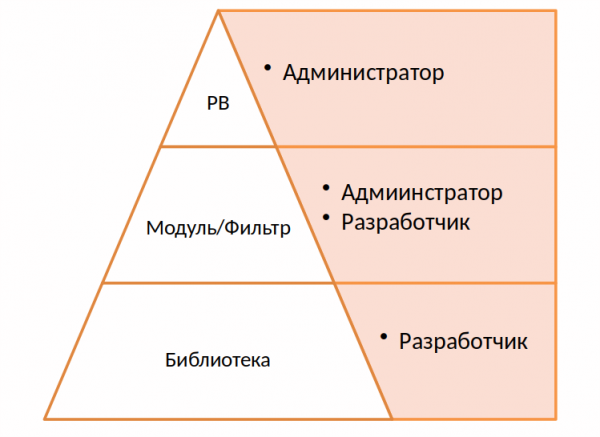
De sterkste punten van Ansible zijn de eenvoud en begrijpelijke playbooks. Ik vind dat we hier gebruik van moeten maken en geen angstaanjagende yaml-bestanden en een enorme hoeveelheid voorwaarden, shell-code en lussen moeten genereren.
Als je onze ervaring met de Ansible API wilt herhalen, houd dan rekening met twee dingen:
- Playbook_executor en het playbook kunnen geen timeout ontvangen. Er is een timeout voor ssh-sessies, maar geen timeout voor het playbook. Als we proberen een schijf los te koppelen die niet meer in het systeem bestaat, zal het playbook oneindig doorgaan, daarom moest ik de uitvoering omhullen in een aparte wrapper en beëindigen op basis van de timeout.
- Ansible werkt op basis van fork-processen, daarom is de API niet thread-safe. We draaien al onze playbooks één voor één.
Uiteindelijk zijn we erin geslaagd om ongeveer 80% van de schijven automatisch te vervangen. Over het algemeen is de vervangingssnelheid verdubbeld. Vandaag de dag kijkt de beheerder alleen naar het incident en beslist hij of de schijf vervangen moet worden of niet, en maakt vervolgens één klik.
Maar nu beginnen we een ander probleem tegen te komen: sommige nieuwe beheerders weten niet hoe ze schijven moeten vervangen. 🙂
Bron: habr.com
