

We did it!
«The goal of this course is to prepare you for your technical future.»
 Hello, Habr. Remember the awesome article (+219, 2588 bookmarked, 429k reads)?
So, Hamming (yes, yes, self-checking and self-correcting ) has an entire , inspired by his lectures. We are translating it because the guy knows what he's talking about.
This book is not just about IT, it's about the mindset of incredibly cool people. «This is not just a boost of positive thinking; it describes the conditions that increase your chances of doing great work.»
Thanks for the translation to Andrei Pakhomov.
Information Theory was developed by C. E. Shannon in the late 1940s. The Bell Laboratories management insisted he call it ‘Theory of Communication’, as it’s a much more accurate title. For obvious reasons, the title ‘Information Theory’ has significantly greater impact on the public, so Shannon chose it, and it is what we know today. The very title suggests that the theory deals with information, which makes it important as we delve deeper into the information age. In this chapter, I will touch on a few key findings from this theory, providing not strict but rather intuitively understandable proofs of certain aspects of this theory, so you understand what ‘Information Theory’ really is, where you can apply it, and where you cannot.
First of all, what is “information”? Shannon equates information with uncertainty. He chose the negative logarithm of the probability of an event as the quantitative measure of information you gain when an event with probability p occurs. For example, if I tell you that the weather in Los Angeles is foggy, then p is close to 1, which doesn't really give us much information. But if I say that it rains in Monterey in June, then there is uncertainty in that message, and it contains more information. A certain event contains no information, as log 1 = 0.
Laten we hier dieper op ingaan. Shannon geloofde dat de kwantitatieve maat van informatie een continue functie van de waarschijnlijkheid van gebeurtenis p moest zijn, en voor onafhankelijke gebeurtenissen moest deze additief zijn - de hoeveelheid informatie die verkregen wordt door het uitvoeren van twee onafhankelijke gebeurtenissen, moet gelijk zijn aan de hoeveelheid informatie die voor het gezamenlijke evenement wordt verkregen. Bijvoorbeeld, de uitkomst van het rollen van een dobbelsteen en het gooien van een munt worden meestal beschouwd als onafhankelijke gebeurtenissen. Laten we bovenstaande vertalen naar de taal van de wiskunde. Als I (p) de hoeveelheid informatie is die in een gebeurtenis met waarschijnlijkheid p zit, dan krijgen we voor een gezamenlijk evenement, bestaande uit twee onafhankelijke gebeurtenissen x met waarschijnlijkheid p1 en y met waarschijnlijkheid p2,
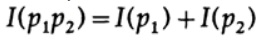
(x en y zijn onafhankelijke gebeurtenissen)
Dit is de functionele vergelijking van Cauchy, die waar is voor alle p1 en p2. Om deze functionele vergelijking op te lossen, veronderstellen we dat
p1 = p2 = p,
dit geeft
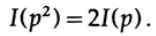
Als p1 = p2 en p2 = p, dan
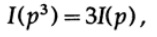
enzovoorts. Door dit proces uit te breiden, met behulp van de standaardmethode voor exponenten, is het waar voor alle rationale getallen m / n dat
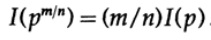
Uit de veronderstelde continuïteit van de informatiemaat volgt dat de logaritmische functie de enige continue oplossing van de functionele vergelijking van Cauchy is.
In de informatietheorie is het gebruikelijk om de basis van de logaritme gelijk aan 2 te nemen, waardoor een binaire keuze precies 1 bit informatie bevat. Daarom wordt informatie gemeten met de formule
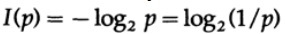
Laten we even pauzeren en begrijpen wat er hierboven is gebeurd. Ten eerste hebben we geen definitie gegeven van het begrip “informatie”, we hebben gewoon de formule voor de kwantitatieve maat ervan gedefinieerd.
Ten tweede hangt deze maat af van onzekerheid, en hoewel deze in voldoende mate geschikt is voor machines - zoals telefoonsystemen, radio, televisie, computers, enz. - weerspiegelt deze niet de normale menselijke houding ten opzichte van informatie.
Ten derde is het een relatieve maat, het hangt af van de huidige staat van uw kennis. Als u kijkt naar een reeks “willekeurige getallen” van een willekeurige getallengenerator, gaat u ervan uit dat elk volgend getal onzeker is, maar als u de formule kent voor het berekenen van 'willekeurige getallen', is het volgende getal bekend en bevat het daarom geen informatie.
Dus, de definitie die Shannon voor informatie heeft gegeven, is in veel gevallen geschikt voor machines, maar lijkt niet te corresponderen met de menselijke interpretatie van het woord. Om deze reden had 'Theorie van Informatie' beter 'Theorie van Communicatie' kunnen heten. Het is echter al te laat om definities te wijzigen (waardoor de theorie zijn oorspronkelijke populariteit heeft verworven, en die nog steeds mensen doet denken dat deze theorie zich bezighoudt met 'informatie'), dus we moeten het ermee eens zijn, maar u moet zich goed realiseren hoe ver Shannons definitie van informatie afstaat van de gangbare betekenis. Shannons informatie heeft betrekking op iets heel anders, namelijk onzekerheid.
Hier is iets om over na te denken wanneer u enige terminologie voorstelt. In hoeverre komt de voorgestelde definitie, bijvoorbeeld de definitie van informatie die door Shannon is gegeven, overeen met uw oorspronkelijke idee en in hoeverre verschilt deze? Er is bijna geen term die precies uw eerdere visie op het concept weergeeft, maar uiteindelijk weerspiegelt de gebruikte terminologie de betekenis van het concept, dus de formalisering van iets door middel van scherpe definities voegt altijd een zekere ruis toe.
Laten we een systeem beschouwen waarvan het alfabet uit symbolen q bestaat met kansen pi. In dit geval de gemiddelde hoeveelheid informatie in het systeem (de verwachte waarde) is gelijk aan:
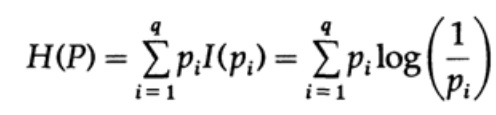
Dit wordt de entropie van het systeem met kansverdeling {pi} genoemd. We gebruiken de term 'entropie', omdat dezelfde wiskundige vorm voorkomt in de thermodynamica en de statistische mechanica. Daarom creëert de term 'entropie' een bepaalde aura van belangrijkheid, die uiteindelijk niet gerechtvaardigd is. Een gelijkaardige wiskundige vorm van notatie impliceert niet dezelfde interpretatie van de symbolen!
De entropie van de kansverdeling speelt een belangrijke rol in de coderingstheorie. De ongelijkheid van Gibbs voor twee verschillende kansverdelingen pi en qi is een van de belangrijke gevolgen van deze theorie. Dus moeten we bewijzen dat
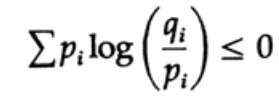
Het bewijs steunt op de duidelijke grafiek, fig. 13.I, die laat zien dat
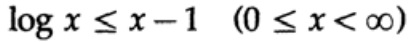
en de gelijkheid alleen wordt bereikt bij x = 1. Laten we de ongelijkheid toepassen op elk lid van de som in de linker helft:
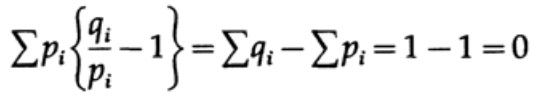
Als het alfabet van het communicatiekanaal uit q symbolen bestaat, dan, door de kans op verzending van elk symbool qi = 1/q te nemen en q in te vullen, krijgen we uit de ongelijkheid van Gibbs.
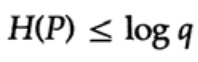
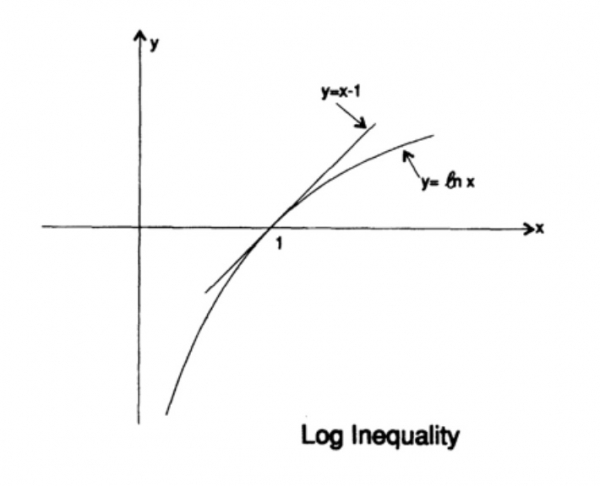
Figuur 13.I
Dit betekent dat als de kans op verzending van alle q symbolen gelijk is en gelijk aan — 1/q, de maximale entropie gelijk is aan ln q; in dat geval is de ongelijkheid geldig.
In het geval van een eenduidig decodeerbare code hebben we de ongelijkheid van Kraft.
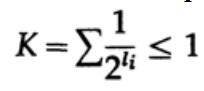
Nu, als we pseudo-kansen definiëren,
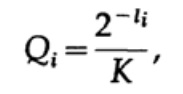
waarbij dit eindig is, 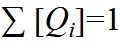 = 1, wat volgt uit de ongelijkheid van Gibbs,
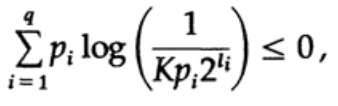
en een beetje algebra toepassen (onthoud dat K ≤ 1, dus we kunnen de logaritmische term negeren en misschien de ongelijkheid later versterken), dan krijgen we
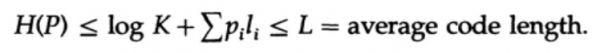
waarbij L de gemiddelde lengte van de code is.
Dus, entropie is de minimale grens voor elke symbolische code met een gemiddelde codewoordlengte L. Dit is de Shannon-theorema voor een storingsvrije kanaal.
Laten we nu de belangrijkste theorema over de beperkingen van communicatiesystemen bekijken, waarbij informatie wordt verzonden als een stroom van onafhankelijke bits en ruis aanwezig is. Het wordt verondersteld dat de kans op correcte verzending van een bit P > 1/2 is, en de kans dat de waarde van het bit omgekeerd wordt tijdens verzending (dat er een fout optreedt) is Q = 1 - P. Voor de eenvoud veronderstellen we dat fouten onafhankelijk zijn en de kans op een fout gelijk is voor elk verzonden bit — dat is, er is 'witte ruis' in het communicatiekanaal.
De weg hebben we een lange stroom van n bits, gecodeerd in één bericht — n-dimensionale uitbreiding van de enkelvoudige bitcode. We zullen de waarde van n later bepalen. Laten we een bericht dat uit n-bits bestaat beschouwen als een punt in een n-dimensionale ruimte. Aangezien we een n-dimensionale ruimte hebben — en ter vereenvoudiging aannemen dat elk bericht dezelfde kans op voorkomen heeft — zijn er M mogelijke berichten (M zal ook later gedefinieerd worden), dus de kans op elk verzonden bericht is gelijk aan

(zender)
Grafiek 13.II
Laten we het idee van de doorvoerbandbreedte van het kanaal verder bekijken. Zonder in detail te treden, wordt de doorvoerbandbreedte van het kanaal gedefinieerd als het maximale volume informatie dat betrouwbaar over een communicatienaam kan worden verzonden, rekening houdend met het gebruik van de meest efficiënte codering. Er zijn geen argumenten voor de stelling dat er meer informatie door een communicatienaam kan worden verzonden dan zijn capaciteit. Dit kan worden bewezen voor een binaire symmetrische naam (die we in dit geval gebruiken). De capaciteit van het kanaal, bij verzenden per bit, wordt gegeven als
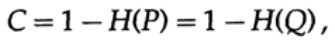
waarbij, zoals eerder, P de kans op afwezigheid van fouten in een verzonden bit is. Bij het verzenden van n onafhankelijke bits wordt de capaciteit van het kanaal gedefinieerd als
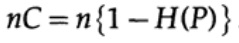
Als we dicht bij de doorvoerbandbreedte van het kanaal zijn, moeten we bijna dat volume informatie verzenden voor elk van de symbolen ai, i = 1, …, M. Gezien het feit dat de kans op het optreden van elk symbool ai gelijk is aan 1 / M, krijgen we
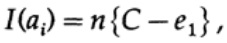
wanneer we een van de M equally probable berichten ai verzenden, hebben we
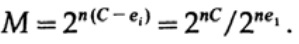
Bij het verzenden van n bits verwachten we het optreden van nQ fouten. In de praktijk, voor een bericht bestaande uit n bits, zullen we ongeveer nQ fouten in het ontvangen bericht hebben. Bij grote n wordt de relatieve variatie (variatie = breedte van de verdeling, )
van het aantal fouten steeds nauwer met toenemende n.
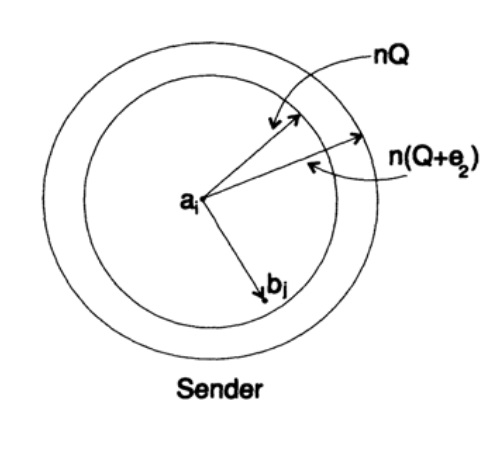
Dus, vanuit het perspectief van de zender, neem ik bericht ai om te verzenden en teken ik een bol rondom het met een straal van
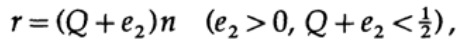
die iets groter is dan de waarde e2, die gelijk is aan het verwachte aantal fouten Q, (figuur 13.II). Als n groot genoeg is, bestaat er een willekeurig kleine kans dat het berichtspunt bj aan de ontvangende kant buiten deze bol valt. Laten we de situatie schetsen zoals ik die zie vanuit het perspectief van de zender: we hebben willekeurige stralen van het verzonden bericht ai naar het ontvangen bericht bj met een kans op fouten die gelijk (of bijna gelijk) is aan de normale verdeling, die zijn maximum bereikt in nQ. Voor elke gegeven e2 bestaat er een n dat zo groot is dat de kans dat het ontvangen punt bj buiten mijn bol valt, zo klein is als u maar wilt.
Laten we nu dezelfde situatie vanuit uw kant bekijken (fig. 13.III). Aan de ontvangende kant is er een sfeer S(r) met dezelfde straal r rond het ontvangen punt bj in een n-dimensionale ruimte, zodanig dat als het ontvangen bericht bj zich binnen mijn sfeer bevindt, het door mij verzonden bericht ai zich binnen uw sfeer bevindt.
Hoe kan een fout ontstaan? Een fout kan optreden in de onderstaande situaties:
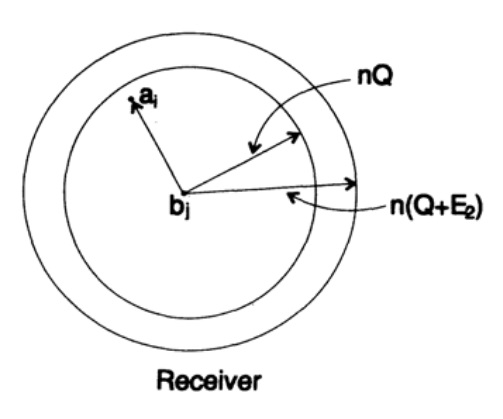
Figuur 13.III
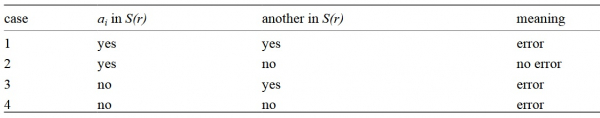
Hier zien we dat, als er binnen de sfeer rond het ontvangen punt nog minstens één punt is dat overeenkomt met een mogelijk verzonden niet-gecodeerd bericht, er een fout is opgetreden tijdens de overdracht, omdat u niet kunt bepalen welk van deze berichten is verzonden. Het verzonden bericht bevat geen fouten, alleen als het bijbehorende punt zich binnen de sfeer bevindt en er geen andere punten, mogelijk in deze code, zich in dezelfde sfeer bevinden.
We hebben een wiskundige vergelijking voor de foutkans Pe, als er een bericht ai is verzonden.
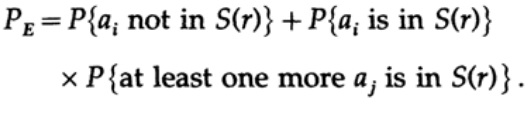
We kunnen de eerste factor in de tweede term weggooien en deze als 1 beschouwen. Zo krijgen we een ongelijkheid.
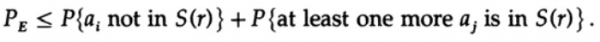
Het is duidelijk dat
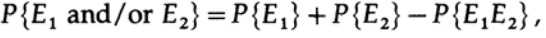
dus
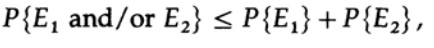
toepassen op de laatste term rechts
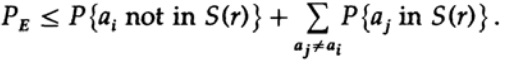
Als we aannemen dat n groot genoeg is, kan de eerste term als zo klein worden beschouwd als we willen, laten we zeggen, kleiner dan een bepaald getal d. Daarom hebben we
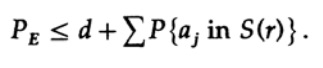
Laten we nu bekijken hoe we een eenvoudige vervangcode kunnen construeren voor het coderen van M berichten, bestaande uit n bits. Zonder een idee te hebben van hoe de code daadwerkelijk te construeren (fouten-corrigerende codes waren nog niet uitgevonden), koos Shannon voor willekeurige codering. Gooi een munt voor elk van de n bits in het bericht en herhaal het proces voor M berichten. In totaal moeten er nM muntentrekingen worden gedaan, dus zijn er mogelijk

codewoordenboeken, met een gelijke kans van ½nM. Natuurlijk betekent het willekeurige proces van het creëren van een woordenboek dat er een kans is op duplicaten en ook codepunten die dicht bij elkaar liggen en dus waarschijnlijk tot fouten leiden. Het moet worden bewezen dat als dit met een kans hoger dan elk gekozen klein foutniveau niet voorkomt, n groot genoeg is.
Het cruciale punt is dat Shannon alle mogelijke codeboeken heeft gemiddeld om de gemiddelde fout te vinden! We zullen het symbool Av [.], gebruiken om de gemiddelde waarde over een reeks van alle mogelijke willekeurige codewoordenboeken aan te duiden. Gemiddeld over de constante d geeft natuurlijk een constante, aangezien elk lid in de som overeenkomt met elk ander lid.
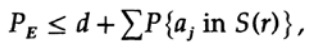
dat kan worden vergroot (M–1 gaat naar M)
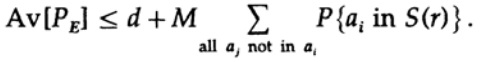
Voor een specifiek bericht, bij het gemiddeld nemen van alle codeboeken, doorloopt de codering alle mogelijke waarden, dus de gemiddelde waarschijnlijkheid dat een punt zich binnen de bol bevindt, is de verhouding van het volume van de bol tot het totale volume van de ruimte. Het volume van de bol is dan
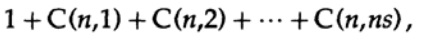
waar s=Q+e2 <1/2 en ns moet een geheel getal zijn.
Het laatste lid rechts is het grootste in deze som. Laten we eerst de waarde ervan schatten met de Stirling-formule voor faculteiten. Vervolgens kijken we naar de afnamecoëfficiënt van het lid ervoor, let op dat deze coëfficiënt toeneemt bij het verschuiven naar links, en daarom kunnen we: (1) de waarde van de som beperken tot de som van een meetkundige reeks met deze begincoëfficiënt, (2) de meetkundige reeks van ns leden uitbreiden tot een oneindig aantal leden, (3) de som van de oneindige meetkundige reeks berekenen (standaard algebra, niets wezenlijks) en uiteindelijk de limietwaarde verkrijgen (voor voldoende grote n):
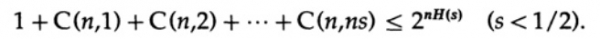
Let op hoe de entropie H(s) is verschenen in de binomiale identiteit. Merk op dat de Taylor-reeksuitbreiding H(s)=H(Q+e2) een schatting geeft die alleen rekening houdt met de eerste afgeleide en alle andere negeert. Laten we nu de eindexpressie verzamelen:
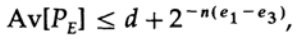
waar
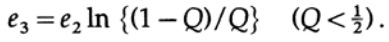
Alles wat we hoeven te doen, is e2 kiezen, zodat e3 < e1, en dan zal het laatste lid zo klein zijn als we willen, bij een voldoende grote n. Daarom kan de gemiddelde fout PE zo klein worden gemaakt bij een bandbreedte van het kanaal die zo dicht bij C ligt.
Als de gemiddelde waarde voor alle codes een voldoende kleine fout heeft, moet ten minste één code geschikt zijn, wat betekent dat er ten minste één geschikte coderingssystemen bestaat. Dit is een belangrijk resultaat van Shannon — de 'Shannon-theorema voor ruiskanalen', hoewel moet worden opgemerkt dat hij dit heeft bewezen voor een veel algemenere situatie dan voor een eenvoudige binaire symmetrische kanaal die ik heb gebruikt. Voor het algemene geval zijn de wiskundige afleidingen veel complexer, maar de ideeën zijn niet zo verschillend, daarom kan vaak met het voorbeeld van het specifieke geval de ware betekenis van de stelling worden onthuld.
Laten we het resultaat bekritiseren. We hebben herhaaldelijk gezegd: 'Bij voldoende grote n'. Maar hoe groot moet n zijn? Heel, heel groot, als je daadwerkelijk dicht bij de bandbreedte van het kanaal wilt zijn en zeker wilt zijn van een correcte gegevensoverdracht! Zodanig groot dat je feitelijk heel lang moet wachten om een bericht te accumuleren uit zoveel bits, om het later te coderen. Daarbij zal de grootte van de woordenlijst van de willekeurige code gewoon enorm zijn (want zo'n woordenlijst kan niet korter worden gepresenteerd dan een volledige lijst van alle Mn bits, terwijl n en M heel groot zijn)!
Foutencorrectiecodes vermijden het wachten op een zeer lang bericht, met de daaropvolgende codering en decodering via zeer grote codeboeken, omdat ze codeboeken als zodanig vermijden en in plaats daarvan gewone berekeningen gebruiken. In de eenvoudige theorie verliezen zulke codes meestal de mogelijkheid om dicht bij de bandbreedte van het kanaal te komen en tegelijkertijd een voldoende lage foutfrequentie te behouden, maar wanneer de code een groot aantal fouten corrigeert, presteren ze goed. Met andere woorden, als je een bepaalde capaciteit van het kanaal reserveert voor foutcorrectie, moet je deze foutcorrectiemogelijkheid het grootste deel van de tijd gebruiken, d.w.z. in elk verzonden bericht moeten een groot aantal fouten worden gecorrigeerd, anders gebruik je die capaciteit tevergeefs.
De bovenstaande bewezen stelling is echter nog steeds niet betekenisloos! Het laat zien dat effectieve transmissiesystemen doordachte coderingsschema's voor zeer lange bitreeksen moeten gebruiken. Satellieten die de buitenste planetoïden hebben bereikt, zijn hier een voorbeeld van; naarmate ze verder van de aarde en de zon afdrijven, moeten ze steeds meer fouten corrigeren in de gegevensblokken: sommige satellieten gebruiken zonnepanelen die ongeveer 5 W leveren, terwijl andere nucleaire energiebronnen gebruiken die ongeveer dezelfde kracht leveren. De zwakke kracht van de energiebron, de kleine afmetingen van de zendantennes en de beperkte afmeting van de ontvangstantennes op aarde, samen met de enorme afstand die het signaal moet afleggen, vereisen allemaal het gebruik van codes met een hoog niveau van foutcorrectie om een effectief communicatiesysteem op te bouwen.
Laten we terugkeren naar de n-dimensionale ruimte die we eerder in het bewijs hebben gebruikt. Tijdens onze bespreking hebben we aangetoond dat bijna het volledige volume van een bol zich rond het externe oppervlak concentreert; daarom is het bijna zeker dat het verzonden signaal zich op de oppervlakte van de bol zal bevinden die om het ontvangen signaal is gebouwd, zelfs bij een relatief kleine straal van deze bol. Het is dan ook niet verwonderlijk dat het ontvangen signaal, na het corrigeren van een willekeurig aantal fouten, nQ, zo dicht mogelijk bij het foutloze signaal ligt. De capaciteit van het communic kanaal dat we eerder hebben besproken, is de sleutel tot het begrijpen van dit fenomeen. Let op dat dergelijke bollen, gebouwd voor Hamming-codes met foutcorrectie, elkaar niet overlappen. Een groot aantal bijna orthogonale dimensies in n-dimensionale ruimte laat zien waarom we M bollen in een ruimte met minimale overlapping kunnen plaatsen. Als we een kleine, willekeurig kleine overlapping toestaan, die alleen tot een beperkt aantal fouten bij decodering kan leiden, kunnen we een dichte plaatsing van bollen in de ruimte verkrijgen. Hamming garandeerde een bepaald niveau van foutcorrectie, Shannon een lage foutkans, maar met behoud van de werkelijke doorvoersnelheid, hoe dicht ook bij de capaciteit van het communic kanaal, iets wat Hamming-codes niet kunnen doen.
Informatie-theorie zegt niet hoe je een efficiënt systeem ontwerpt, maar het geeft wel een richting aan hoe je kunt bewegen naar efficiënte communicatiesystemen. Het is een waardevol hulpmiddel voor het opbouwen van communicatiesystemen tussen machines, maar zoals eerder opgemerkt, heeft het niet veel te maken met hoe mensen informatie met elkaar uitwisselen. De mate waarin biologische erfelijkheid lijkt op technische communicatiesystemen is eenvoudigweg onbekend, dus het is momenteel onduidelijk in welke mate de informatie-theorie toepasbaar is op genen. We hebben niets anders te doen dan het gewoon te proberen, en als succes ons een machine-achtige aard van dit fenomeen laat zien, zal falen ons wijzen op andere belangrijke aspecten van de aard van informatie.
Laten we ons niet te veel afleiden. We hebben gezien dat alle oorspronkelijke definities, in meerdere of mindere mate, de essentie van onze oorspronkelijke overtuigingen moeten weergeven, maar ze hebben een zekere mate van vervorming, waardoor ze niet toepasbaar blijken te zijn. Het is traditioneel aangenomen dat de definitie die we gebruiken uiteindelijk de essentie ervan bepaalt; maar dit geeft ons slechts aan hoe we dingen moeten verwerken en betekent op geen enkele manier iets voor ons. De postulatieve benadering, die zo sterk wordt goedgekeurd in wiskundige kringen, laat in de praktijk te wensen over.
Laten we nu een voorbeeld bekijken van IQ-tests, waarbij de definitie zo cyclisch is als u maar wilt, en als gevolg daarvan u in verwarring brengt. Er wordt een test opgesteld die, zoals verondersteld, bedoeld is om intelligentie te meten. Daarna wordt deze herzien om zo consistent mogelijk te zijn, en vervolgens wordt deze gepubliceerd en op een eenvoudige manier gekalibreerd, zodat de gemeten 'intelligentie' normaal verdeeld is (natuurlijk volgens de kalibratiecurve). Alle definities moeten worden gecontroleerd, niet alleen wanneer ze voor het eerst worden voorgesteld, maar ook veel later, wanneer ze in getrokken conclusies worden gebruikt. In hoeverre zijn de grenzen van de definities geschikt voor de taak die opgelost moet worden? Hoe vaak worden definities die onder bepaalde voorwaarden worden gegeven, toegepast in aanzienlijk verschillende omstandigheden? Dit gebeurt vrij vaak! In de geesteswetenschappen, waarmee u onvermijdelijk in uw leven in aanraking zult komen, komt dit vaker voor.
Een van de doelen van deze presentatie over informatietheorie, naast het demonstreren van de bruikbaarheid ervan, was u te waarschuwen voor dit gevaar, of te laten zien hoe het precies te gebruiken om het gewenste resultaat te behalen. Het is lang opgemerkt dat de oorspronkelijke definities bepalen wat u uiteindelijk vindt, in veel grotere mate dan het lijkt. Oorspronkelijke definities vereisen dat u veel aandacht besteedt, niet alleen in elke nieuwe situatie, maar ook in gebieden waarmee u al lange tijd werkt. Dit zal u helpen begrijpen in hoeverre de verkregen resultaten een tautologie zijn en niet iets nuttigs.
Het bekende verhaal van Eddington vertelt over mensen die in de zee vissen met een net. Door de grootte van de vissen die ze hebben gevangen te bestuderen, bepaalden ze de minimale grootte van de vis die in de zee voorkomt! Hun conclusie was bepaald door het gebruikte hulpmiddel, niet door de werkelijkheid.
Wordt vervolgd…
Wie wil helpen met de vertaling, opmaak en publicatie van het boek — neem contact op via een persoonlijk bericht of via e-mail op magisterludi2016@yandex.ru
Trouwens, we hebben ook de vertaling van een ander geweldig boek gelanceerd — )
Specifiek zijn we op zoek naar degenen die kunnen helpen met het vertalen van . (we vertalen per 10 minuten, de eerste 20 zijn al gedaan)
Inhoud van het boek en vertaalde hoofdstukken
- Introductie tot De Kunst van Wetenschap en Ingenieurswetenschap: Leren Leren (28 maart 1995)
- «Fundamenten van de Digitale (Discrete) Revolutie» (30 maart 1995)
- «Geschiedenis van Computers — Hardware» (31 maart 1995)
- «Geschiedenis van Computers — Software» (4 april 1995)
- «Geschiedenis van Computers — Toepassingen» (6 april 1995)
- «Kunstmatige Intelligentie — Deel I» (7 april 1995)
- «Kunstmatige Intelligentie — Deel II» (11 april 1995)
- «Kunstmatige Intelligentie III» (13 april 1995)
- «n-Dimensionale Ruimte» (14 april 1995)
- «Coderingstheorie — De Representatie van Informatie, Deel I» (18 april 1995)
- «Coderingstheorie — De Representatie van Informatie, Deel II» (20 april 1995)
- «Foutcorrigerende Codes» (21 april 1995)
- «Informatietheorie» (25 april 1995)
- «Digitale Filters, Deel I» (27 april 1995)
- «Digitale Filters, Deel II» (28 april 1995)
- «Digitale Filters, Deel III» (2 mei 1995)
- «Digitale Filters, Deel IV» (4 mei 1995)
- «Simulatie, Deel I» (5 mei 1995)
- «Simulatie, Deel II» (9 mei 1995)
- «Simulatie, Deel III» (11 mei 1995)
- «Glasvezels» (12 mei 1995)
- «Computerondersteund Onderwijs» (16 mei 1995)
- «Wiskunde» (18 mei 1995)
- «Kwantummechanica» (19 mei 1995)
- «Creativiteit» (23 mei 1995). Vertaling:
- «Experts» (25 mei 1995)
- «Onbetrouwbare Gegevens» (26 mei 1995)
- «System Engineering» (30 mei 1995)
- «Je Krijgt Wat Je Meet» (1 juni 1995)
- (2 juni 1995) vertalen in stukken van 10 minuten
- Hamming, «Jij en Jouw Onderzoek» (6 juni 1995).
Wie wil helpen met de vertaling, opmaak en publicatie van het boek — neem contact op via een persoonlijk bericht of via e-mail op magisterludi2016@yandex.ru
Bron: habr.com
