

In de eerste publicatie () hebben we besproken hoe thermische potentiekanalen kunnen worden gebruikt voor het analyseren van gebieden in het algemeen. In de volgende publicaties was het gepland om te beschrijven hoe informatie over ruimtelijke objecten in databases wordt opgeslagen, hoe modelen worden opgebouwd vanuit hoofdcomponenten en welke analyse taken voor gebieden er verder kunnen zijn. Maar laten we dit alles stap voor stap bekijken.
Het gebruik van de methode van thermische potentiekanalen maakt het in de eerste plaats mogelijk om een algemeen beeld van het gebied van interesse te krijgen. Neem bijvoorbeeld de basisinformatie uit OSM over Barcelona (Catalonië), en na een integrale analyse zonder selectie van parameters, kunnen we 'thermische' afbeeldingen van de eerste hoofdcomponenten verkrijgen. We hebben ook gesproken over 'thermische' kaarten in het eerste artikel, maar het is nuttig om te herinneren dat de term 'thermische' kaart voortkomt uit de fysieke betekenis van de potentiaal die wordt gebruikt voor integrale analyse. Dat wil zeggen, in fysica is de potentiaal temperatuur, terwijl in de analyse van gebieden de potentiaal de som van de invloeden van alle factoren op een specifiek punt in het gebied vertegenwoordigt.
Hieronder is een voorbeeld van een 'thermische' kaart van Barcelona, verkregen als resultaat van een integrale analyse.
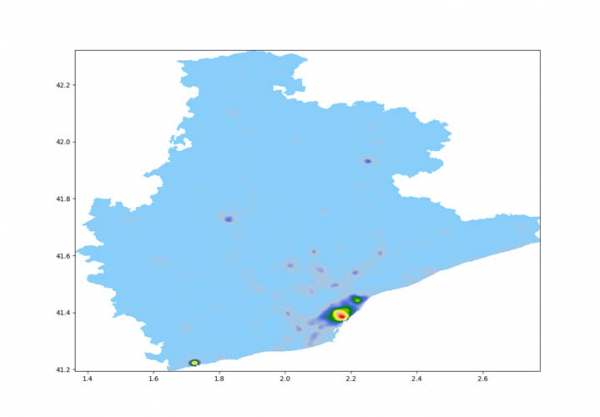
'Thermische' kaart van de eerste hoofdcomponent, zonder selectie van parameters, Barcelona
Door echter een specifieke parameter in te stellen (in dit geval hebben we industrie gekozen), kunnen we een 'thermische' kaart op basis daarvan verkrijgen.
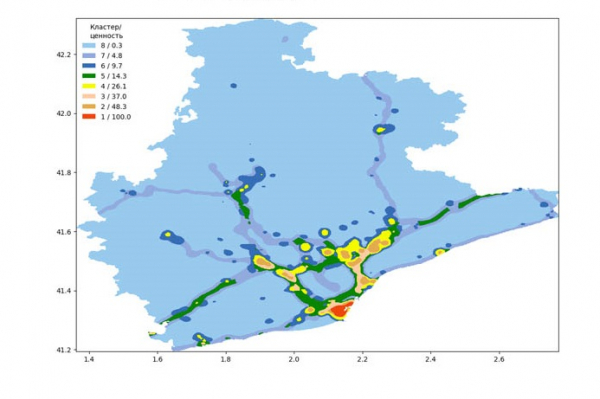
'Thermische' kaart van de eerste hoofdcomponent, industrie, Barcelona
De taken van analyes zijn uiteraard veel breder en diverser dan het verkrijgen van een algemene beoordeling van het gekozen gebied, daarom zullen we in dit artikel als voorbeeld de taak bekijken van het vinden van de beste locatie voor het plaatsen van een nieuw object en de technische implementatie van de methode van thermische potentiekanalen voor de oplossing hiervan. In de volgende publicaties zullen we ook andere onderwerpen bekijken.
Het oplossen van de taak om de beste locatie voor het plaatsen van een nieuw object te vinden, helpt te bepalen hoe 'klaar' het gebied is om dit nieuwe object op te nemen, hoe het zich zal verhouden tot andere, reeds aanwezige objecten in het gebied, hoe waardevol dit nieuwe object zal zijn voor het gebied en welke waarde het zal toevoegen.
Fases van technische implementatie
De technische implementatie kan worden gepresenteerd als een volgorde van uit te voeren procedures, zoals hieronder vermeld:
- Voorbereiding van de informatieomgeving.
- Zoeken, verzamelen en verwerken van onderliggende informatie.
- Opbouw van een knooppuntnetwerk op het te analyseren gebied.
- Verdeling van factoren van het gebied in fragmenten.
- Berekening van de potentieel van de factoren.
- Selectie van factoren voor het creëren van thematische integrale kenmerken van het gebied.
- Toepassing van de hoofdcomponenten methode voor het verkrijgen van integrale indicatoren van het gebied.
- Creëren van modellen voor het kiezen van een plaats voor de bouw van een nieuw object.
1 Fase. Voorbereiding van de informatieomgeving
In deze fase moet het databasebeheersysteem (DBMS) worden gekozen, net als de informatiebronnen, de manieren van informatieverzameling en de omvang van de verzamelde informatie.
We hebben de database (DB) PostgeSql gebruikt, maar het is belangrijk op te merken dat elke andere database die met SQL-query's werkt, ook geschikt is.
In de database worden de onderliggende informatie opgeslagen - ruimtelijke gegevens over objecten: datatypes (punten, lijnen, polygonen), hun coördinaten en andere kenmerken (lengte, oppervlakte, aantal), evenals alle berekende waarden die zijn verkregen als resultaat van het uitgevoerde werk en de resultaten van het werk zelf.
Statistische informatie wordt ook gepresenteerd als ruimtelijke gegevens (bijvoorbeeld gebieden van de provincie met statistische gegevens die aan deze gebieden zijn toegewezen).
Als resultaat van de transformatie en verwerking van de verzamelde onderliggende informatie worden tabellen gevormd die informatie bevatten over lineaire, punt- en oppervlaktfactoren, hun identificaties en coördinaten.
2 Fase. Zoeken, verzamelen en verwerken van onderliggende informatie
Als onderliggende informatie voor deze taak gebruiken we informatie uit open cartografische bronnen, die informatie over het gebied bevatten. Naar onze mening is OSM-informatie, die dagelijks over de hele wereld wordt bijgewerkt, de beste. Echter, als het lukt om informatie uit andere bronnen te verzamelen, is dat ook een plus.
De verwerking van informatie houdt in dat deze wordt genormaliseerd, onbetrouwbare gegevens worden uitgesloten en de informatie wordt voorbereid voor invoer in de database.
3 Fase. Opbouw van een knooppuntnetwerk op het te analyseren gebied
Om de continuïteit van het geanalyseerde gebied te waarborgen, is het noodzakelijk om een raster te bouwen met knooppunten die coördinaten hebben in een vastgesteld coördinatensysteem. In elk knooppunt van het raster zal later de waarde van de potentie worden bepaald. Dit maakt het mogelijk om homogene gebieden, clusters en eindresultaten van de analyse te visualiseren.
Afhankelijk van de te behalen doelen zijn er twee opties voor het opbouwen van het raster:
— Raster met regelmatige stap (S1) – is een algemene raster over het hele gebied. Hiermee worden de potentialen van de factoren berekend, worden de integrale kenmerken van het gebied bepaald (hoofdcomponenten en clusters) en worden de resultaten van de modellering weergegeven.
Bij het kiezen van dit raster moet het volgende worden ingesteld:
- stap van het raster - de interval waar tussen de knooppunten van het raster zullen worden geplaatst;
- de grens van het te analyseren gebied, die kan overeenkomen met de administratief-territoriale indeling, of dit kan een gebied op de kaart zijn dat het berekeningsgebied in de vorm van een veelhoek afbakent.
— Raster met onregelmatige stap (S2) beschrijft afzonderlijke punten in het gebied (bijvoorbeeld centroiden). Hiermee worden ook de potentialen van de factoren berekend en worden de integrale kenmerken van het gebied bepaald (hoofdcomponenten en clusters). Modellering met de berekende hoofdcomponenten wordt uitgevoerd op het raster met onregelmatige stap, en voor de visualisatie van de resultaten van de modellering worden de clustergetallen van de knooppunten van het raster met onregelmatige stap overgebracht naar de knooppunten van het raster met regelmatige stap op basis van de nabijheid van coördinaten.
In de database worden de coördinaten van de knooppunten van het raster opgeslagen in de vorm van een tabel, die voor elk knooppunt de volgende informatie bevat:
- identificatienummer van het knooppunt;
- coördinaten van het knooppunt (x, y).
Voorbeelden van rasters met regelmatige stappen voor verschillende gebieden met verschillende stappen zijn weergegeven in de onderstaande afbeeldingen.
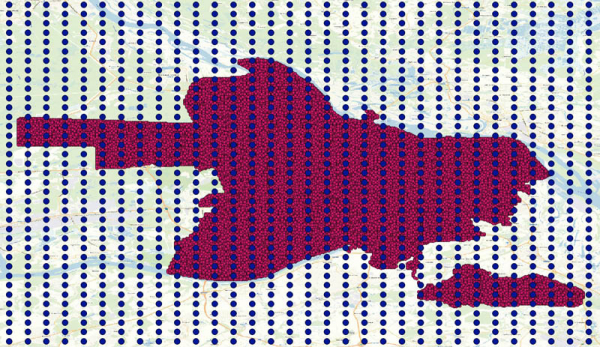
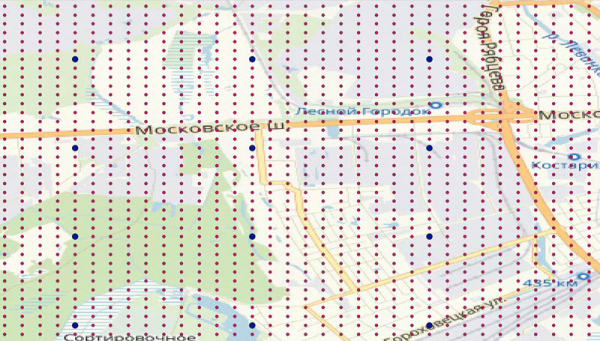
Rasterdekking van N. Novgorod (rode punten). Rasterdekking van de regio Nizhny Novgorod (blauwe punten).
4e Fase. Verdelen van de factoren van het gebied in fragmenten
Voor verdere analyse moeten de uitgestrekte factoren van het gebied worden omgevormd tot een verzameling discrete factoren, zodat elk knooppunt van het raster informatie bevat over elke aanwezige factor. Lineaire factoren worden verdeeld in segmenten, vlakfactoren in fragmenten.
De stapgrootte voor de splitsing wordt bepaald op basis van de oppervlakte van het gebied en de specifieke factor. Voor grote gebieden (regio) kan de stapgrootte 100-150 m bedragen, terwijl voor kleinere gebieden (steden) de stapgrootte 25-50 m kan zijn.
In de database worden de resultaten van de splitsing opgeslagen in de vorm van een tabel, die voor elk fragment de volgende informatie bevat:
- de identifier van de factor;
- de coördinaten van de centroiden van de verkregen splitsingsfragmenten (x, y);
- de lengte/oppervlakte van de splitsingsfragmenten.
Stap 5. Berekening van de potentiëlen van de factoren
Een van de mogelijke en begrijpelijke benaderingen voor het analyseren van de oorspronkelijke informatie is om de factoren te beschouwen als de potentiëlen van beïnvloedende objecten.
We maken gebruik van de fundamentele oplossing van de Laplace-vergelijking voor de tweedimensionale situatie — de logaritme van de afstand van een punt.
Met inachtneming van de eis van een eindwaarde van het potentieel in nul en de beperking van de waarde van het potentieel op grote afstanden, wordt het potentieel als volgt gedefinieerd:
 bij r<r1 (1)
 bij r2>r>=r1
 bij r>=r2
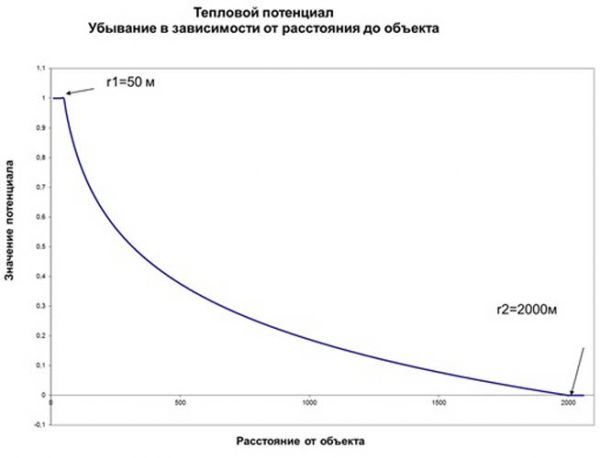
Vorm van het invloedpotentieel van een puntobject
De logaritmische functie moet in nul worden beperkt en redelijk beperkt zijn op een bepaalde afstand van de factoren. Als er geen beperkingen aan het potentieel op grote afstanden van de factor worden opgelegd, zou men een enorme hoeveelheid informatie ver weg van het geanalyseerde punt in aanmerking moeten nemen, die praktisch geen invloed heeft op de analyse. Daarom introduceren we de straal van invloed van de factor, waarbuiten de bijdrage aan het potentieel van de factor gelijk is aan nul.
Voor de stad wordt de straal van invloed van de factor vastgesteld op een half uur te voet bereikbaarheid — 2.000 meter. Voor de regio moet men spreken over een halfuur transport- bereikbaarheid — 20.000 meter.
Zo hebben we als resultaat van de berekening van de potentiëlen de totale potentie van elke factor in elk knooppunt van het regelmatige net.
Stap 6. Selectie van factoren voor het creëren van thematische integrale kenmerken van het gebied
In deze fase worden de meest significante en informatieve factoren geselecteerd voor het creëren van thematische integrale kenmerken van het gebied.
Factor selection can be done automatically by setting specific boundaries for parameters (correlation, percentage influence, etc.), or through expert evaluation, understanding the task's theme and having some knowledge of the area.
After identifying the most significant and informative factors, we can proceed to the next stage — interpreting the principal components.
Step 7. Applying the principal component method to obtain integral indicators of the area. Clustering.
The initial information about area factors, transformed in the previous stage into potentials calculated for each node in the grid, is combined into new integral indicators — principal components.
The principal component method analyzes the variability of factors in the studied area and finds the most variable linear combination among them, allowing for the calculation of their variation measure — variance across the area.
Let's take a general task of building a model to approximate the linear model function to specified values.
 (2)
Where i is the component number,
n is the number of components involved in the calculation,
j is the index of the territory node, j=1..k,
k is the total number of nodes in the territory grid used for principal component calculation.
 — coefficient for the i-th principal component of the model,
 – value of the i-th principal component at point j,
B is the free term of the model.
 — potential at point j of the factor for which we are building the model.
We will determine the unknowns in the equation (2) using the least squares method, utilizing the properties of the principal components:
 (3)
Where i and i2 are the component numbers, ii2,
j is the index of the territory node,
k is the total number of nodes in the territory.
 (4)
(3) indicates the absence of correlation between components.
(4) — the total value of any component equals zero.
We krijgen:

 (5)
Here are the notations, just as in the equation (2),  indicates the average value of the potential.
This result can be interpreted as follows:
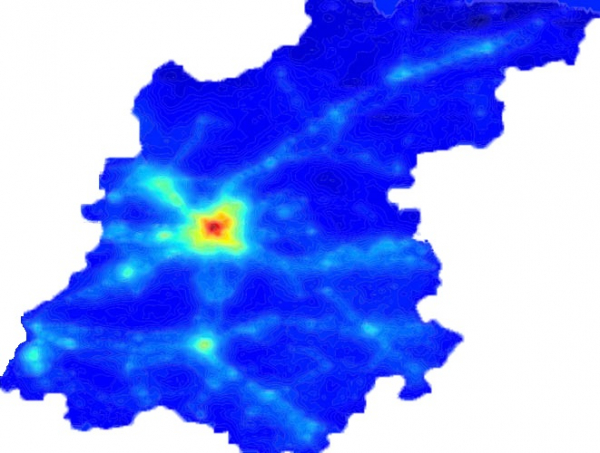
The model represents a simple expression consisting of the average value of the modeled quantity, and simple adjustments to it from each component. At a minimum, the result should include the free term B and the first principal component. Below are examples of heatmaps of the first principal components for the Nizhny Novgorod region.
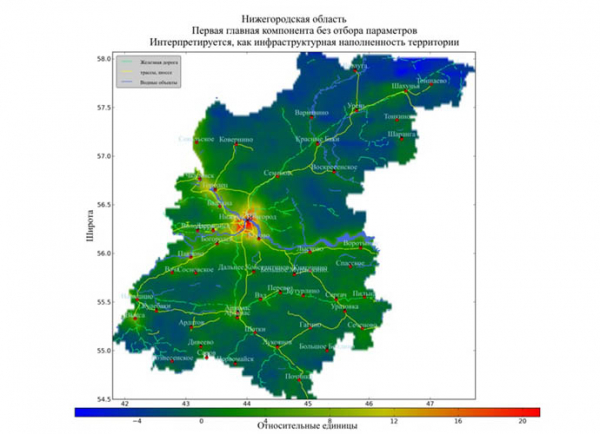
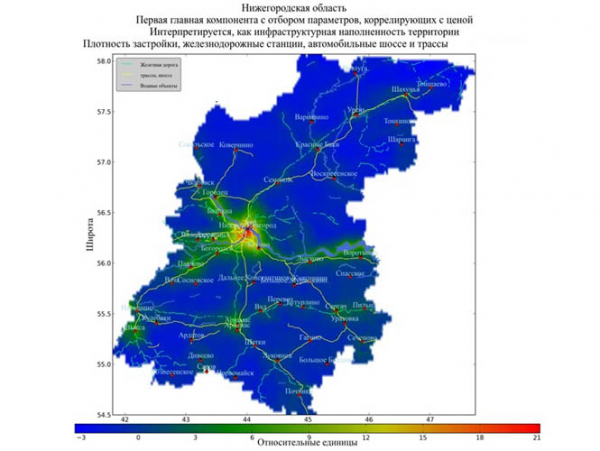
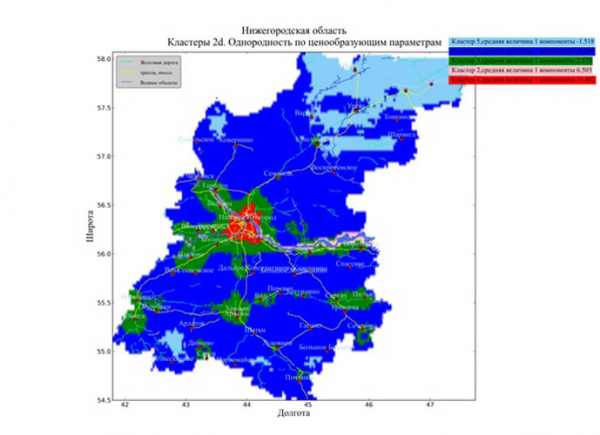
Op basis van de berekende hoofdcomponenten kunnen homogene gebieden worden opgebouwd. Dit kan gedaan worden voor alle parameters, of bijvoorbeeld alleen voor prijsbepalende – dat wil zeggen, het uitvoeren van clustering. Hiervoor kan gebruik worden gemaakt van . Voor elk homogeen gebied wordt de gemiddelde waarde van de 1e hoofdcomponent berekend, die het ontwikkelingsniveau van het gebied karakteriseert.
Een voorbeeld van clustering op prijsbepalende parameters voor de regio Nizhny Novgorod is hieronder weergegeven.
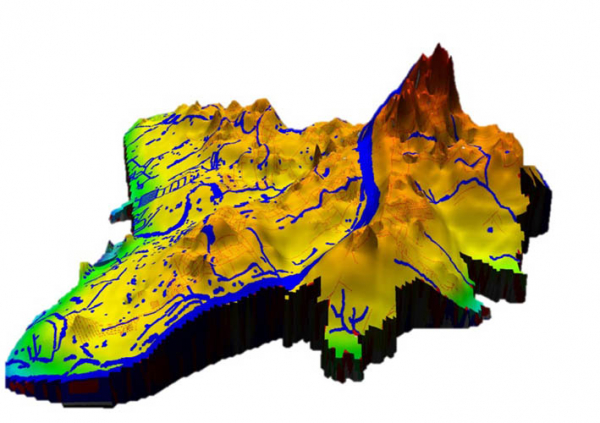
Daarnaast, door de verkregen hoofdcomponenten als parameters voor het waardemodel te gebruiken, kunnen we een prijsoppervlak voor het gebied verkrijgen.
Prijsoppervlak van N. Novgorod
Stap 8. Modellen creëren voor de locatiekeuze van een nieuw object
Om de locatie te kiezen die het meest aantrekkelijk is voor de vestiging van een nieuw object (hierna "object" genoemd), moet de locatie van het "object" worden vergeleken met de omringende infrastructuur. Voor de werking van het "object" moeten er voldoende middelen beschikbaar zijn om de functionaliteit te waarborgen, en moet rekening worden gehouden met een groot aantal factoren die zowel positieve als negatieve invloeden op het "object" hebben. Het geheel van deze factoren kan worden gedefinieerd als de "voedende" omgeving voor het functioneren van het "object". De verhouding tussen het aantal objecten en de hoeveelheid middelen in het gebied is de basis voor de stabiele werking van het "object".
Het resultaat van deze vergelijking is het potentieel dat voor elke punt in het gebied is berekend en dat een visuele en analytische analyse van de locatiekeuze voor het nieuwe "object" mogelijk maakt.
Voor de handel is bijvoorbeeld, onder andere, een constante stroom van klanten belangrijk, wat betekent dat de lijst met factoren die moeten worden overwogen voor handelsobjecten ook diegene moet bevatten die deze stroom waarborgen (zoals objecten van sociale infrastructuur, werkplekken, woonplaatsen, verkeersaders, enz.).
Aan de andere kant, bij het voldoen aan alle voorwaarden voor de werking van handelsobjecten, moet rekening worden gehouden met de dichtheid van de handelsobjecten, aangezien de "consumptie" van de omgevingsomgeving leidt tot een afname van de aankoopmogelijkheden. De stroom mensen is niet onbeperkt, en hetzelfde geldt voor hun financiële middelen en fysieke mogelijkheden.
Het algoritme voor het oplossen van de taak van het kiezen van de beste locatie voor een object komt neer op het feit dat het potentieel, verkregen als functie van de belangrijkste componenten, zo dicht mogelijk bij het potentieel van de verzameling objecten van het type 'object' komt; vervolgens wordt het verschil tussen het potentiële biedtmodel en het potentieel van objecten van het type 'object' berekend; van het verkregen verschil wordt de waarde van het potentiële aandeel van één 'object' afgetrokken; de negatieve waarden worden daarbij vervangen door nul, d.w.z. de locaties waar onvoldoende middelen zijn om het nieuwe 'object' te laten functioneren, worden uitgesloten.
Als resultaat van de uitgevoerde acties krijgen we punten op het terrein met een positieve potentiaalwaarde, d.w.z. plekken met een gunstige ligging voor ons 'object'.
Met andere woorden, we hebben de berekende potentielen van alle beschikbare factoren en de factor waarop we het model willen baseren en de analyse van het gekozen thematische gebied (handel, industrie, cultuur, sociale sector, enz.)
Hiervoor is het noodzakelijk om factoren te selecteren voor de opbouw van milieuvectoren – de belangrijkste componenten – en vervolgens modellen op basis daarvan te berekenen.
De factoren worden voorgesteld te worden geselecteerd via een correlatieanalyse van alle factoren met de referentiefactor van het thematische gebied. Voor cultuur zouden dit bijvoorbeeld theaters kunnen zijn, voor het onderwijssysteem scholen, enz.
We berekenen de correlatie van het referentieel potentieel met de potentielen van alle factoren. We selecteren die factoren waarvan de correlatiecoëfficiënten in absolute termen groter zijn dan een bepaalde waarde (vaak wordt een minimale correlatiecoëfficiënt van 0,3 genomen).
 (6)
waar  — de absolute waarde van de correlatiecoëfficiënt van de i-de factor met de referentie.
De correlatie wordt berekend over alle knooppunten van het netwerk dat het gebied bedekt.
Het verschil tussen het potentieel van het model en het potentieel van objecten van dezelfde soort als het nieuwe object in de vergelijking (2) geeft het potentieel van het gebied aan dat kan worden gebruikt voor de plaatsing van nieuwe objecten.
Als resultaat krijgen we de potentiaalwaarde die de mate van voordeel van de plaatsing van het 'object' op het onderzochte terrein karakteriseert.
Een voorbeeld van hoe de aanbevolen gebieden voor de plaatsing van het nieuwe 'object' grafisch kunnen worden weergegeven, is hieronder weergegeven.
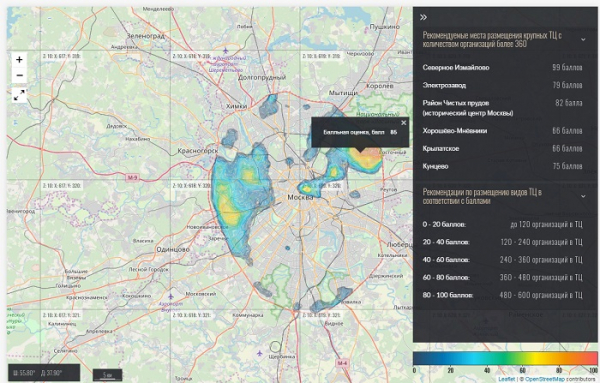
Op basis hiervan kan het resultaat van de keuze van de beste locatie voor een nieuw object worden weergegeven als een beoordeling van het gebied in punten op elk punt, wat inzicht geeft in het potentieel voor het plaatsen van een investeringsobject, dat wil zeggen: hoe hoger de score, hoe voordeliger het is om het object te plaatsen.
Tot slot moet worden opgemerkt dat we in dit artikel slechts één taak hebben behandeld die kan worden opgelost met behulp van territorialanalyse, met gegevens uit openbare bronnen. In werkelijkheid zijn er veel taken die hiermee kunnen worden opgelost; het aantal wordt alleen beperkt door uw verbeelding.
Bron: habr.com
