

JPEG afbeeldingen komen overal in ons digitale leven voor, maar achter deze schuilplaats van bewustzijn schuilen algoritmes die details verwijderen die niet door het menselijk oog worden waargenomen. Dit resulteert in de hoogste visuele kwaliteit met de kleinste bestandsgrootte – maar hoe werkt dit precies? Laten we eens kijken naar wat onze ogen niet zien!
Het is gemakkelijk om het voor vanzelfsprekend aan te nemen dat je een foto naar een vriend kunt sturen, zonder je zorgen te maken over welk apparaat, welke browser of welk besturingssysteem hij gebruikt – maar zo was het niet altijd. Begin jaren 80 konden computers digitale afbeeldingen opslaan en weergeven, maar er waren veel concurrerende ideeën over de beste manier om dit te doen. Je kon een afbeelding niet gewoon van de ene computer naar de andere sturen en hopen dat alles zou werken.
Om dit probleem op te lossen, werd in 1986 een comité van experts van over de hele wereld opgericht, genaamd(Joint Photographic Experts Group, JPEG), opgericht in samenwerking met de Internationale Organisatie voor Standaardisatie (ISO) en de Internationale Elektrotechnische Commissie (IEC) – twee internationale standaardiseringsorganisaties die hun hoofdkwartier in Genève (Zwitserland) hebben.
De groep mensen genaamd JPEG creëerde in 1992 de JPEG compressiestandaard voor digitale afbeeldingen. Iedereen die het internet heeft gebruikt, is waarschijnlijk wel eens afbeeldingen in JPEG-indeling tegengekomen. Het is de meest voorkomende manier van coderen, verzenden en opslaan van afbeeldingen. Van webpagina's tot e-mail en sociale media, JPEG wordt miljarden keren per dag gebruikt – praktisch elke keer dat we een afbeelding online bekijken of versturen. Zonder JPEG zou het web minder levendig, trager en waarschijnlijk vol met minder schattige kattenfoto's zijn!
Dit artikel gaat over hoe je een JPEG-afbeelding decodeert. Met andere woorden, het gaat erom wat er nodig is om de gecomprimeerde gegevens die op de computer zijn opgeslagen, om te zetten in een afbeelding die op het scherm verschijnt. Dit is belangrijk om te weten, niet alleen omdat het essentieel is om de technologie die we dagelijks gebruiken te begrijpen, maar ook omdat we door de compressieniveaus te onthullen, beter inzicht krijgen in waarneming en zicht, evenals in de details waaraan onze ogen het meest gevoelig zijn.
Bovendien is het erg interessant om op deze manier met afbeeldingen te spelen.
Kijkend naar de binnenkant van JPEG
Op de computer wordt alles opgeslagen als een reeks binaire cijfers. Gewoonlijk worden deze bits, nullen en enen, gegroepeerd in groepen van acht, waardoor bytes ontstaan. Wanneer je een JPEG-afbeelding op de computer opent, moet iets (de browser, het besturingssysteem, of iets anders) de bytes decoderen en de oorspronkelijke afbeelding herstellen in de vorm van een kleurenlijst die kan worden weergegeven.
Als je deze schattige downloadt en deze opent in een teksteditor, zie je een hoop onsamenhangende symbolen.
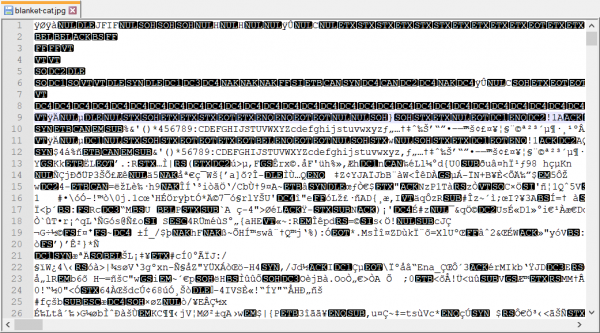
Hier gebruik ik Notepad++ om de inhoud van het bestand te bestuderen, omdat gewone teksteditors, zoals Notepad in Windows, het binaire bestand beschadigen na het opslaan, waardoor het niet meer voldoet aan het JPEG-formaat.
Wanneer je een afbeelding in een teksteditor opent, verwarrend je de computer, net zoals je je eigen hersens in de war brengt als je in je ogen wrijft en gekleurde vlekken begint te zien!
Deze vlekken die je ziet, staan bekend als , en zijn geen gevolg van een lichtprikkel of hallucinaties die door de geest worden veroorzaakt. Ze ontstaan omdat je hersenen aannemen dat elke elektrische signalen in de oogzenuwen informatie over licht doorgeven. De hersenen moeten zulke aannames doen, aangezien het gewoon niet mogelijk is om te weten of een signaal geluid, een visie of iets anders is. Alle zenuwen in het lichaam verzenden precies dezelfde elektrische impulsen. Door op je ogen te drukken, stuur je signalen die geen visuele zijn, maar die de oogreceptoren activeren, wat door je hersenen verkeerd wordt geïnterpreteerd als iets visueels. Je kunt letterlijk de druk zien!
Het is interessant om te denken hoe computers op de hersenen lijken, maar het is ook een nuttige analogie die illustreert hoe sterk de betekenis van gegevens - die door het lichaam worden verzonden via zenuwen, of opgeslagen op een computer - afhangt van hun interpretatie. Alle binaire gegevens bestaan uit nullen en enen, de basiscomponenten die in staat zijn informatie van welke soort dan ook te verzenden. Jouw computer raadt vaak hoe het deze moet interpreteren met behulp van aanwijzingen, zoals bestandsextensies. En nu laten we het deze interpreteren als tekst, omdat dat is wat de tekstverwerker verwacht.
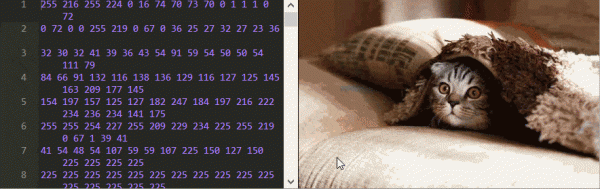
Om te begrijpen hoe JPEG gedecodeerd wordt, moeten we de oorspronkelijke signalen zien - de binaire gegevens. Dit kan gedaan worden met een hex-editor, of direct op de ! Daar staat een afbeelding waarnaast in een tekstveld alle bytes zijn weergegeven (behalve de header), gepresenteerd in decimale vorm. Je kunt ze wijzigen en het script zal de afbeelding opnieuw coderen en een nieuwe afbeelding in real-time genereren.
Je kunt veel leren door gewoon te spelen met deze editor. Bijvoorbeeld, kun je zeggen in welke volgorde de pixels zijn opgeslagen?
Wat vreemd is aan dit voorbeeld, is dat het wijzigen van bepaalde getallen helemaal geen invloed heeft op de afbeelding, maar als je bijvoorbeeld het getal 17 op de eerste regel vervangt door 0, dan is de afbeelding volledig beschadigd!
Andere wijzigingen, zoals het vervangen van 7 op regel 1988 door het getal 254, veranderen de kleur, maar alleen van de daaropvolgende pixels.
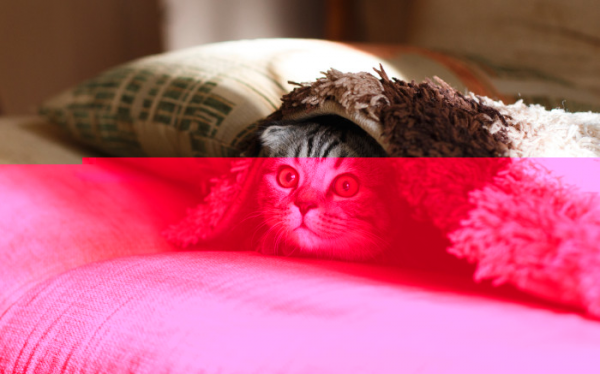
Misschien het vreemdste is dat sommige getallen niet alleen de kleur, maar ook de vorm van de afbeelding wijzigen. Wijzig 70 in regel 12 naar 2 en kijk naar de bovenste rij van de afbeelding om te zien wat ik bedoel.
En ongeacht welk JPEG-afbeelding je gebruikt, je zult altijd deze mysterieuze schaakpatronen tegenkomen bij het bewerken van bytes.
Bij het spelen met de editor is het moeilijk te begrijpen hoe een foto uit deze bytes wordt gereconstrueerd, omdat JPEG-compressie uit drie verschillende technologieën bestaat die sequentieel op niveaus worden toegepast. We zullen elk van deze afzonderlijk bestuderen om het mysterieuze gedrag dat we observeren te onthullen.
Drie niveaus van JPEG-compressie:
- .
- .
- , en
Om u een idee te geven van de compressieschalen, let op dat de afbeelding hierboven 79.819 getallen vertegenwoordigt, ofwel ongeveer 79 KB. Als we het zonder compressie zouden opslaan, zouden we drie getallen per pixel nodig hebben - voor de rode, groene en blauwe component. Dit zou 917.700 getallen opleveren, of ongeveer 917 KB. Door JPEG-compressie is het eindbestand meer dan 10 keer kleiner!
Eigenlijk kan deze afbeelding veel sterker worden gecomprimeerd. Hieronder ziet u twee afbeeldingen naast elkaar - de foto rechts is gecomprimeerd tot 16 KB, wat 57 keer minder is dan de ongecomprimeerde versie!
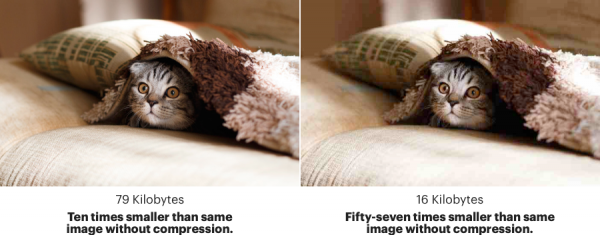
Als je goed kijkt, zie je dat deze afbeeldingen niet identiek zijn. Beide zijn JPEG-gecomprimeerde afbeeldingen, maar de rechter is veel kleiner in volume. Ook ziet deze er iets slechter uit (let op de kleurvlakken op de achtergrond). Daarom wordt JPEG ook wel verliesgevende compressie genoemd; tijdens het compressieproces verandert de afbeelding en verliest deze enkele details.
1. Kleur subafsampling
Hier is de afbeelding met alleen het eerste compressieniveau toegepast.
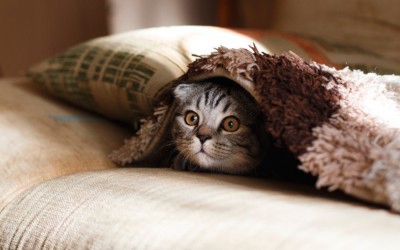
(Interactieve versie - in de artikel). Het verwijderen van één getal verstoort alle kleuren. Maar als je precies zes getallen verwijdert, heeft dit vrijwel geen invloed op de afbeelding.
Nu zijn de getallen iets eenvoudiger te ontcijferen. Het is bijna een gewone lijst van kleuren, waarbij elke byte precies één pixel verandert, maar het is al twee keer zo klein als de ongecomprimeerde afbeelding (die ongeveer 300 KB in deze verkleinde grootte zou innemen). Kun je raden waarom?
Je kunt zien dat deze getallen niet de standaard rode, groene en blauwe componenten vertegenwoordigen, aangezien als je alle getallen door nullen vervangt, we een groene afbeelding krijgen (en niet een witte).

Dit komt omdat deze bytes Y (helderheid) vertegenwoordigen,
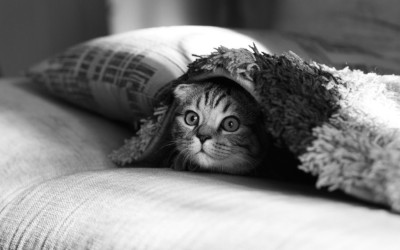
Cb (relatieve blauwheid),
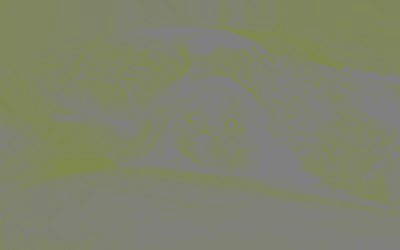
en Cr (relatieve roodheid) van de afbeelding.
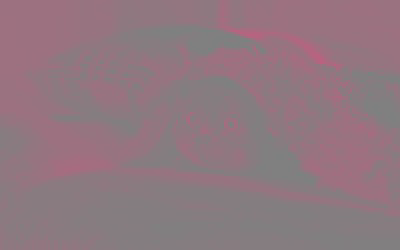
Waarom geen RGB gebruiken? Dat is immers hoe de meeste moderne schermen werken. Je monitor kan elke kleur weergeven, inclusief rood, groen en blauw met verschillende intensiteiten voor elke pixel. Wit ontstaat door alle drie helemaal aan te zetten, terwijl zwart ontstaat door ze uit te schakelen.
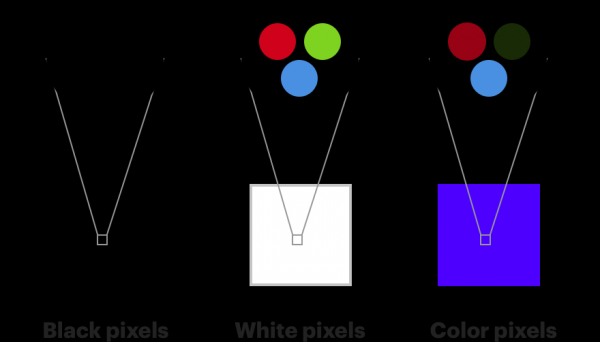
Dit lijkt ook sterk op hoe het menselijke oog werkt. De kleurreceptoren in onze ogen worden "«, en zijn verdeeld in drie typen, waarvan elk gevoeliger is voor respectievelijk rood, groen of blauw licht [S-type kegeltjes zijn gevoelig in het violet-blauwe (S van het Engelse Short — kortgolvige spectrum), M-type in groen-geel (M van het Engelse Medium — middengolvig), en L-type in geel-rood (L van het Engelse Long — langgolvig) delen van het spectrum. De aanwezigheid van deze drie soorten kegeltjes (en staafjes, die gevoelig zijn in het smaragdgroene deel van het spectrum) geeft de mens kleurenzicht. / opm. vert.]. , een ander type fotoreceptoren in onze ogen, kan veranderingen in helderheid waarnemen, maar is veel gevoeliger voor kleur. In onze ogen zijn er ongeveer 120 miljoen staafjes en slechts 6 miljoen kegeltjes.
Daarom merken onze ogen veranderingen in helderheid veel beter op dan veranderingen in kleur. Als je kleur van helderheid scheidt, kun je een beetje kleur weghalen en niemand zal iets opmerken. Kleursubdiscretisatie is het proces van het weergeven van kleurcomponenten van een afbeelding met een lagere resolutie in vergelijking met helderheidscomponenten. In het bovenstaande voorbeeld heeft elke pixel precies één Y-component, en elke afzonderlijke groep van vier pixels heeft precies één Cb- en één Cr-component. Daarom bevat de afbeelding vier keer minder kleurinformatie dan het origineel.
Het kleurengamma YCbCr wordt niet alleen in JPEG gebruikt. Het werd oorspronkelijk in 1938 uitgevonden voor televisie-uitzendingen. Niet iedereen heeft een kleuren-tv, dus het scheiden van kleur en helderheid stelde iedereen in staat om hetzelfde signaal te ontvangen, terwijl kleuren-tv's alleen de helderheidscomponent gebruikten.
Daarom verstoort het verwijderen van één nummer uit de editor volledig alle kleuren. Componenten worden opgeslagen als Y Y Y Y Cb Cr (eigenlijk niet noodzakelijk in die volgorde – de opslagvolgorde wordt in de header van het bestand bepaald). Het verwijderen van het eerste nummer zal ertoe leiden dat de eerste Cb-waarde als Y wordt waargenomen, Cr als Cb, en in het algemeen ontstaat er een domino-effect dat alle kleuren van de afbeelding verandert.
De JPEG-specificatie verplicht je niet om YCbCr te gebruiken. Maar in de meeste bestanden wordt het gebruikt, omdat het beelden van betere kwaliteit oplevert na subsampling vergeleken met RGB. Maar je hoeft me niet op mijn woord te geloven. Kijk zelf naar de tabel hieronder om te zien hoe de subsampling van elke afzonderlijke component eruitziet, zowel in RGB als in YCbCr.
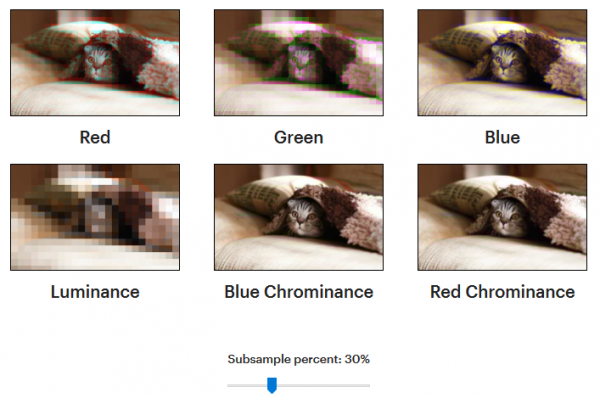
(Interactieve versie - in de artikelen).
Het verwijderen van blauw is niet zo opvallend als het verwijderen van rood of groen. Dit komt omdat van de zes miljoen kegeltjes in je ogen ongeveer 64% gevoelig is voor rood, 32% voor groen en 2% voor blauw.
De subsampling van de Y-component (links onder) is het best zichtbaar. Zelfs een kleine verandering is duidelijk.
Het omzetten van een afbeelding van RGB naar YCbCr vermindert de bestandsgrootte niet, maar maakt het gemakkelijker om minder opvallende details te vinden die verwijderd kunnen worden. Verliesgevende compressie vindt plaats in de tweede fase. De basis daarvan is het idee om gegevens in een meer compacte vorm voor te stellen.
2. Discrete cosinustransformatie en subsampling
Dit compressieniveau bepaalt voor een groot deel de essentie van JPEG. Na de omzetting van kleuren naar YCbCr worden de componenten afzonderlijk gecomprimeerd, zodat we ons daarna alleen op de Y-component kunnen concentreren. En zo zien de bytes van de Y-component eruit na het toepassen van dit niveau.
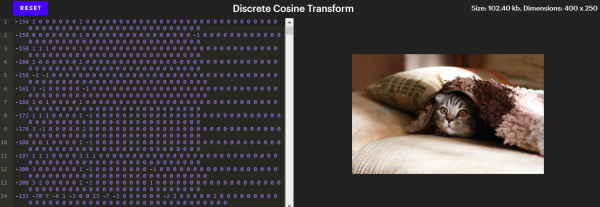
(Interactieve versie - in de artikelen). In de interactieve versie scrollt een klik op een pixel de editor naar de regel die deze vertegenwoordigt. Probeer eens een aantal cijfers aan het einde te verwijderen of voeg een paar nullen toe aan een bepaald nummer.
Op het eerste gezicht lijkt het een zeer slechte compressie. In de afbeelding zijn 100.000 pixels, en om hun helderheid (Y-componenten) aan te geven, zijn 102.400 cijfers nodig - dat is slechter dan helemaal niet comprimeren!
Let echter op dat de meeste van deze cijfers gelijk zijn aan nul. Bovendien kunnen al deze nullen aan het einde van de regels worden verwijderd zonder de afbeelding te veranderen. Er blijven ongeveer 26.000 cijfers over, bijna vier keer minder!
Op dit niveau ligt het geheim van schakenpatronen. In tegenstelling tot andere effecten die we hebben gezien, is het verschijnen van deze patronen geen glitch. Ze zijn de bouwstenen van de hele afbeelding. In elke regel van de editor staan precies 64 cijfers, de coëfficiënten van de discrete cosinustransformatie (DCT), die overeenkomen met de intensiteiten van 64 unieke patronen.
Deze patronen worden gevormd op basis van de cosinusgrafiek. Zo zien sommige van hen eruit:
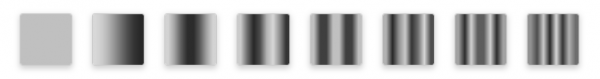
8 van de 64 coëfficiënten
Hieronder staat een afbeelding die alle 64 patronen toont.
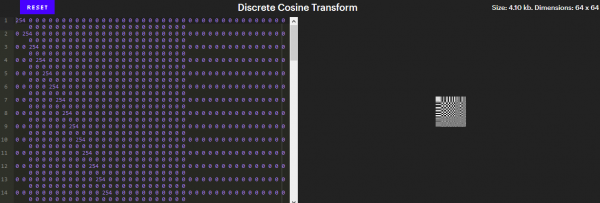
(Interactieve versie - in de artikelen).
Deze patronen hebben een speciale betekenis, omdat ze de basis vormen voor afbeeldingen van 8x8. Als je niet bekend bent met lineaire algebra, betekent dit dat elke afbeelding van 8x8 kan worden verkregen uit deze 64 patronen. DCT is het proces van het opdelen van afbeeldingen in blokken van 8x8 en het transformeren van elk blok in een combinatie van deze 64 coëfficiënten.
Het lijkt magie dat elke afbeelding kan worden samengesteld uit 64 bepaalde patronen. Het is echter hetzelfde als te zeggen dat elke locatie op aarde kan worden beschreven met twee getallen – breedte- en lengtegraad [met vermelding van de hemisferen / vert.]. We beschouwen het aardoppervlak vaak als tweedimensionaal, daarom hebben we slechts twee getallen nodig. Een afbeelding van 8x8 heeft 64 dimensies, dus we hebben 64 getallen nodig.
Het is nog niet duidelijk hoe dit ons helpt qua compressie. Als we 64 getallen nodig hebben om een afbeelding van 8x8 weer te geven, waarom is deze methode beter dan gewoon 64 helderheidcomponenten op te slaan? We doen dit om dezelfde reden als dat we drie RGB-getallen naar drie YCbCr-getallen hebben omgezet: het stelt ons in staat om onzichtbare details te verwijderen.
Het is moeilijk te zien welke specifieke details in deze fase worden verwijderd, omdat JPEG DCT toepast op blokken van 8x8. Maar er staat ons niets in de weg om het op een hele afbeelding toe te passen. Zo ziet DCT voor de Y-component eruit bij toepassing op een hele afbeelding:
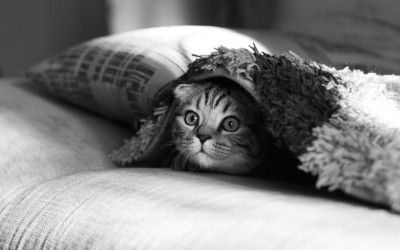
Van de uiteinden kunnen meer dan 60.000 getallen worden verwijderd zonder merkbare veranderingen op de foto.
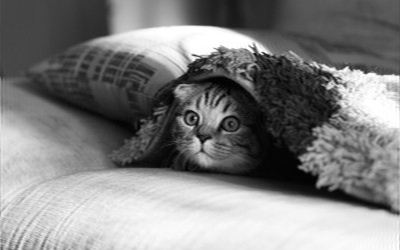
Let echter op, als we de eerste vijf getallen op nul stellen, zal het verschil duidelijk zijn.
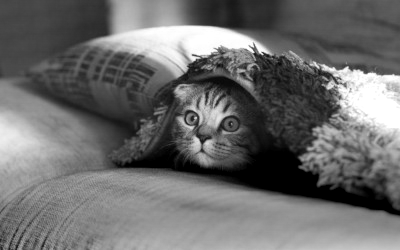
Getallen aan het begin duiden op veranderingen in lage frequentie in de afbeelding, en onze ogen vangen deze het beste op. Getallen dichter bij het einde duiden op veranderingen in hoge frequentie, die moeilijker te merken zijn. Om 'te zien wat het oog niet kan zien', kunnen we deze details van hoge frequentie isoleren door de eerste 5000 getallen op nul te stellen.
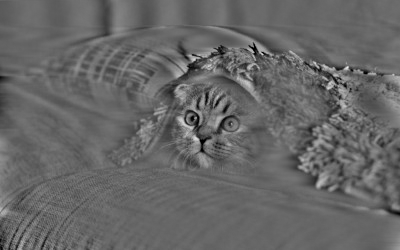
We zien alle gebieden van de afbeelding waar de grootste verandering van pixel tot pixel plaatsvindt. De ogen van de kat, zijn snorharen, het pluche dekbed en de schaduwen in de linksonderhoek worden benadrukt. We kunnen nog verder gaan door de eerste 10.000 getallen op nul te stellen:
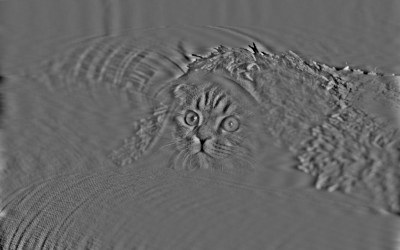
20 000:
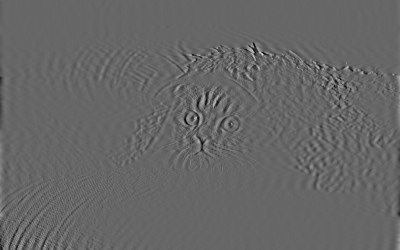
40 000:
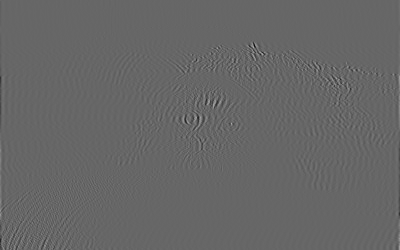
60 000:
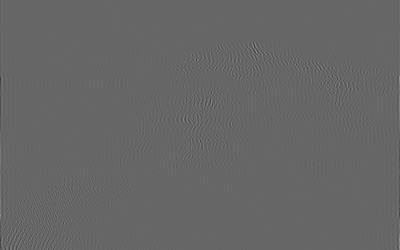
Deze hoogfrequente JPEG-gegevens worden verwijderd tijdens het compressieproces. Het omzetten van kleuren naar DCT-coëfficiënten is verliesvrij. Verliezen ontstaan in de stap van discretisatie, waar hoge frequenties of waarden dichtbij nul worden verwijderd. Wanneer je de kwaliteit van de JPEG-opslag verlaagt, verhoogt het programma de drempel voor de hoeveelheid verwijderde waarden, wat leidt tot een kleinere bestandsgrootte, maar de afbeelding pixelig maakt. Daarom zag de afbeelding in het eerste gedeelte, die 57 keer kleiner was, er zo uit. Elk 8x8 blok werd voorgesteld met veel minder DCT-coëfficiënten in vergelijking met een hoogwaardigere versie.
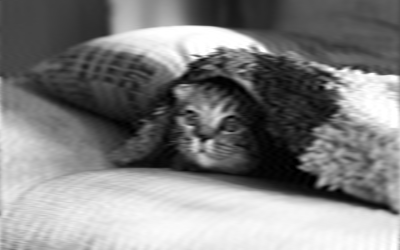
Je kunt een coole effecten krijgen, zoals geleidelijke streaming van beelden. Je kunt een wazige afbeelding gepresenteerd krijgen die steeds gedetailleerder wordt naarmate er meer coëfficiënten worden gedownload.
Hier, gewoon uit nieuwsgierigheid, wat je krijgt bij het gebruik van slechts 24.000 cijfers:
Of slechts 5.000:
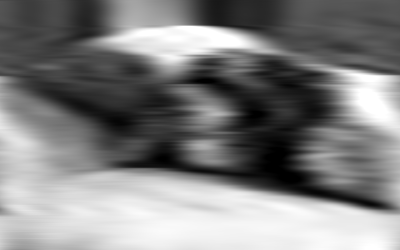
Zeer wazig, maar toch herkenbaar!
3. Codering van lange reeksen, delta en Huffman
Tot nu toe zijn alle compressiestappen verlieslatend geweest. De laatste stap, daarentegen, is verliesvrij. Het verwijdert geen informatie, maar vermindert de bestandsgrootte aanzienlijk.
Hoe kun je iets comprimeren zonder informatie weg te gooien? Stel je voor hoe we een eenvoudige zwarte rechthoek van 700 x 437 zouden beschrijven.
JPEG gebruikt hiervoor 5.000 cijfers, maar je kunt een veel beter resultaat behalen. Kun je een coderingsschema voorstellen dat een dergelijke afbeelding met zo min mogelijk bytes beschrijft?
Het minimale schema dat ik kon bedenken, gebruikt er vier: drie voor het aanduiden van de kleur, en de vierde – hoeveel pixels die kleur heeft. Het idee om herhaalde waarden op deze compacte manier voor te stellen, wordt codering van lange reeksen genoemd. Het is verliesvrij, omdat we de gecodeerde gegevens in hun oorspronkelijke vorm kunnen herstellen.
De JPEG-bestandsgrootte met een zwarte rechthoek is veel groter dan 4 bytes – bedenk dat op het DCT-niveau compressie wordt toegepast op blokken van 8x8 pixels. Daarom hebben we minimaal één DCT-coëfficiënt nodig voor elke 64 pixels. Eén hebben we nodig omdat we in plaats van één DCT-coëfficiënt te bewaren, gevolgd door 63 nullen, het coderen van lange reeksen ons in staat stelt om één getal op te slaan en aan te geven dat ‘alle andere nullen zijn’.
Delta-codering is een techniek waarbij elke byte het verschil met een bepaalde waarde bevat in plaats van een absolute waarde. Daarom verandert het bewerken van bepaalde bytes de kleur van alle andere pixels. Bijvoorbeeld, in plaats van op te slaan
12 13 14 14 14 13 13 14
We zouden met 12 kunnen beginnen en daarna gewoon aangeven hoeveel we moeten optellen of aftrekken om het volgende getal te krijgen. En deze reeks in delta-codering ziet eruit als:
12 1 1 0 0 -1 0 1
De getransformeerde gegevens zijn niet kleiner dan de oorspronkelijke, maar het is al gemakkelijker om ze te comprimeren. Het toepassen van delta-codering vóór het coderen van lange reeksen kan een grote hulp zijn, terwijl het verliesloze compressie blijft.
Delta-codering is een van de weinige technieken die buiten de blokken van 8x8 wordt toegepast. Van de 64 DCT-coëfficiënten is er één – gewoon een constante golffunctie (een uniform kleur). Dit vertegenwoordigt de gemiddelde helderheid van elk blok voor de helderheidscomponent, of de gemiddelde blauwheid voor de Cb-componenten, enzovoort. De eerste waarde van elk DCT-blok wordt het DC-waarde genoemd, en elke DC-waarde wordt delta-gecodeerd ten opzichte van de voorgaande. Daarom beïnvloedt het wijzigen van de helderheid van het eerste blok alle blokken.
Er blijft nog één raadsel over: hoe een enkele wijziging in een getal de hele afbeelding volledig verpest? Tot nu toe had het compressieniveau deze eigenschappen nog niet. Het antwoord ligt in de JPEG-header. De eerste 500 bytes bevatten metadata over de afbeelding – breedte, hoogte, enzovoorts, en zolang we niet met hen hebben gewerkt.
Zonder header is het praktisch onmogelijk (of zeer moeilijk) om JPEG te decoderen. Het zou eruitzien alsof ik probeer een schilderij aan je te beschrijven en begin woorden uit te vinden om mijn indruk over te brengen. De beschrijving zal waarschijnlijk behoorlijk kort zijn, omdat ik woorden kan uitvinden met precies de betekenis die ik wil overbrengen, maar voor iedereen anderen zullen ze geen betekenis hebben.
Het klinkt misschien gek, maar zo werkt het. Elke JPEG-afbeelding wordt gecomprimeerd met codes die specifiek voor deze afbeelding zijn. Het woordenboek van codes wordt in de header opgeslagen. Deze techniek wordt de 'Huffman-code' genoemd, en het woordenboek is de Huffman-tabel. In de header wordt de tabel gemarkeerd met twee bytes – 255 en daarna 196. Elke kleurcomponent kan zijn eigen tabel hebben.
Wijzigingen in de tabellen hebben een radicale impact op elke afbeelding. Een goed voorbeeld is het veranderen van de 1 in de 12e rij.
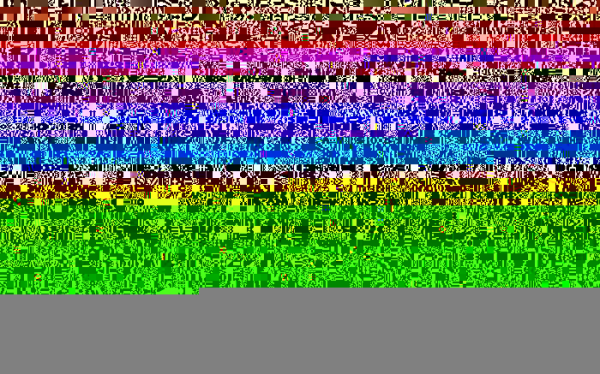
Dit gebeurt omdat in de tabellen wordt aangegeven hoe afzonderlijke bits moeten worden gelezen. Tot nu toe hebben we alleen met binaire getallen in decimale vorm gewerkt. Maar dit verbergt het feit dat als je het getal 1 in een byte wilt opslaan, het er als 00000001 uitziet, omdat er in elke byte precies acht bits moeten zijn, ook al heb je er maar één nodig.
Potentieel is dit een grote verspilling van ruimte als je veel kleine getallen hebt. De Huffman-code is een techniek die ons in staat stelt om deze eis te versoepelen, zodat elk getal acht bits moet innemen. Dit betekent dat als je twee bytes ziet:
234 115
Afhankelijk van de Huffman-tabel kunnen dit drie getallen zijn. Om deze te extraheren, moet je ze eerst in afzonderlijke bits splitsen:
11101010 01110011
Vervolgens raadpleeg je de tabel om te begrijpen hoe je ze moet groeperen. Bijvoorbeeld, dit kunnen de eerste zes bits zijn (111010), of 58 in decimale vorm, gevolgd door vijf bits (10011), of 19, en ten slotte de laatste vier bits (0011), of 3.
Daarom is het erg moeilijk om op dit punt van de compressie in bytes te begrijpen. Bytes vertegenwoordigen niet wat ze lijken te zijn. Ik zal niet diep ingaan op de werking van de tabel in dit artikel, maar over dit onderwerp op het internet .
Een van de interessante trucs die je kunt doen, als je dit weet, is de header van de JPEG scheiden en deze apart opslaan. In wezen zou het bestand alleen door jou gelezen kunnen worden. Facebook doet dit om bestanden nog verder te verkleinen.
Wat je ook kunt doen, is de Huffman-tabel een beetje veranderen. Voor anderen zal dit eruitzien als een vervormde afbeelding. En alleen jij weet de magische manier om het te corrigeren.
Laten we concluderen: wat heb je nodig om een JPEG te decoderen? Je moet:
- De Huffman-tabel(len) uit de header extraheren en de bits decoderen.
- Haal de discrete cosinustransformatiefactoren voor elk kleur- en helderheidcomponent voor elk 8x8-blok op door de inversies van lange reeks- en deltacodering uit te voeren.
- Combineer de cosinussen op basis van de factoren om pixelwaarden voor elk 8x8-blok te verkrijgen.
- Schaal de kleurcomponenten als er subdiscretisatie heeft plaatsgevonden (deze informatie is beschikbaar in de header).
- Converteer de verkregen YCbCr-waarden voor elke pixel naar RGB.
- Toon de afbeelding op het scherm!
Een serieuze klus voor een simpele weergave van een katfoto! Maar wat ik hier leuk aan vind, is dat het laat zien hoe mensgericht de JPEG-technologie is. Het is gebaseerd op de kenmerken van onze waarneming, waarmee we veel betere compressie kunnen bereiken dan met gewone technologieën. En nu, met inzicht in hoe JPEG werkt, kunnen we voorstellen hoe deze technologieën ook in andere gebieden toegepast kunnen worden. Bij voorbeeld kan delta-codering in video zorgen voor een aanzienlijke bestandsgrootte-reductie, omdat er vaak hele gebieden zijn die van frame tot frame niet veranderen (zoals de achtergrond).
, is open en bevat instructies voor het vervangen van afbeeldingen door je eigen afbeeldingen.
Bron: habr.com
