

Hallo, ik ben bezig met het ontwikkelen van applicaties voor databases. — dit is een door Mail.ru Group ontwikkelend platform dat een krachtige database en een applicatieserver in de taal Lua combineert. De hoge snelheid van oplossingen die zijn gebaseerd op Tarantool, wordt onder andere bereikt door de ondersteuning van in-memory database-modus en de mogelijkheid om de bedrijfslogica van de applicatie uit te voeren in hetzelfde adresruimte als de gegevens. Tegelijkertijd wordt gegevenspersistentie gegarandeerd met behulp van ACID-transacties (er wordt een WAL-log op schijf bijgehouden). Tarantool heeft ingebouwde ondersteuning voor replicatie en sharding. Sinds versie 2.1 worden verzoeken in SQL-taal ondersteund. Tarantool heeft een open broncode en wordt verspreid onder de Simplified BSD-licentie. Er is ook een commerciële Enterprise-versie beschikbaar.
Voel de kracht! (…oftewel geniet van de prestaties)
Alles wat hierboven is genoemd maakt Tarantool een aantrekkelijk platform voor het creëren van toepassingen met een hoge belasting die werken met databases. In dergelijke toepassingen ontstaat vaak de noodzaak voor gegevensreplicatie.
Zoals hierboven vermeld, biedt Tarantool ingebouwde gegevensreplicatie. Het principe ervan is de sequentiële uitvoering van alle transacties die in het masterlog (WAL) zijn opgenomen, op de replica's. Gewoonlijk wordt deze replicatie (waarbij we het verder zullen noemen laag-niveau) gebruikt om de fouttolerantie van de applicatie te waarborgen en/of om de leeslast over de clusterknopen te verdelen.
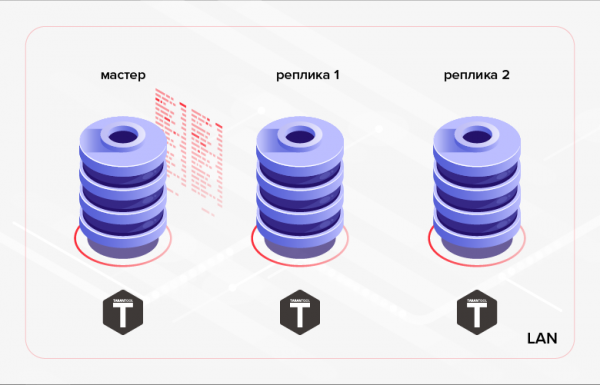
Figuur 1. Replicatie binnen het cluster
Een voorbeeld van een alternatief scenario kan de overdracht van gegevens zijn die in één database zijn aangemaakt, naar een andere database voor verwerking/bewaking. In dat geval kan een hoog-niveau replicatie — gegevensreplicatie op het niveau van de bedrijfslogica van de applicatie. Dat wil zeggen, we gebruiken geen kant-en-klaar oplossing die in de database is ingebouwd, maar implementeren zelf de replicatie binnen de applicatie die we ontwikkelen. Deze benadering heeft zowel voordelen als nadelen. Laten we de voordelen opsommen.
1. Verkeersbesparing:
- het is mogelijk om niet alle gegevens over te dragen, maar alleen een deel ervan (bijvoorbeeld kunnen we alleen bepaalde tabellen, sommige van hun kolommen of records die voldoen aan een bepaalde criterium overdragen);
- In tegenstelling tot low-level replicatie, die continu wordt uitgevoerd in een asynchrone (geïmplementeerd in de huidige versie van Tarantool - 1.10) of synchrone (zal worden geïmplementeerd in toekomstige versies van Tarantool) modus, kan high-level replicatie worden uitgevoerd in sessies (d.w.z. de applicatie synchroniseert eerst de gegevens - een gegevensuitwisselingssessie, waarna er een pauze in de replicatie komt, gevolgd door de volgende gegevensuitwisselingssessie, enz.).
- Als een record verschillende keren is gewijzigd, kan alleen de laatste versie worden doorgegeven (in tegenstelling tot low-level replicatie, waarbij op de replica's alle wijzigingen die op de master zijn aangebracht, achtereenvolgens worden afgespeeld).
2. Er zijn geen complicaties bij het implementeren van uitwisseling via HTTP, wat het mogelijk maakt om externe databases te synchroniseren.
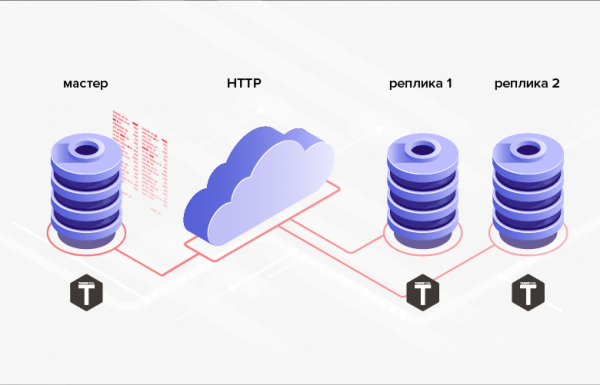
Figuur 2. Replicatie via HTTP
3. De databasestructuren waarbinnen gegevens worden overgedragen, hoeven niet dezelfde te zijn (sterker nog, in het algemeen is het zelfs mogelijk om verschillende databasesystemen, programmeertalen, platforms, enz. te gebruiken).
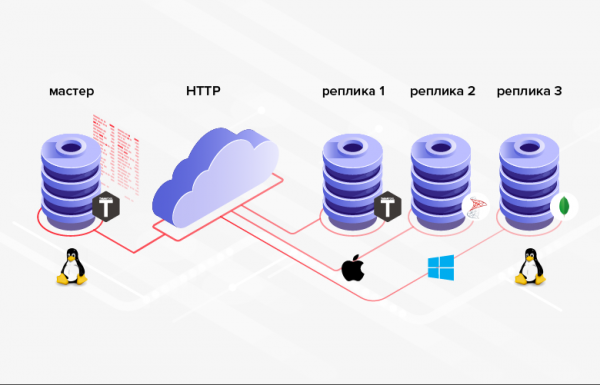
Figuur 3. Replicatie in heterogene systemen
Het nadeel is dat programmeren gemiddeld moeilijker/kostbaarder is dan configureren, en dat je in plaats van het instellen van ingebouwde functionaliteit je eigen oplossing moet implementeren.
Als de genoemde voordelen in uw situatie cruciaal zijn (of een noodzakelijke voorwaarde vormen), is het de moeite waard om high-level replicatie te gebruiken. Laten we eens kijken naar enkele manieren om high-level gegevensreplicatie te implementeren in de Tarantool databases.
Minimalisatie van verkeer
Een van de voordelen van high-level replicatie is dus het besparen van verkeer. Om dit voordeel volledig te benutten, is het noodzakelijk om de hoeveelheid gegevens die bij elke gegevensuitwisselingssessie wordt verzonden te minimaliseren. Uiteraard moet hierbij niet worden vergeten dat aan het einde van de sessie de gegevensontvanger gesynchroniseerd moet zijn met de bron (minstens voor dat deel van de gegevens dat betrokken is bij de replicatie).
Hoe kunnen we de hoeveelheid gegevens minimaliseren die bij high-level replicatie wordt verzonden? Een directe oplossing kan zijn om gegevens op datum-tijd te selecteren. Hiervoor kan het al bestaande datum-tijdveld in de tabel worden gebruikt (als het er is). Bijvoorbeeld, een "bestel" document kan een veld hebben voor de "benodigde tijd voor de uitvoering van de bestelling" - leveringstijd. Het probleem met deze oplossing is dat de waarden in dit veld niet noodzakelijkerwijs in de volgorde staan van de plaatsing van bestellingen. Daarom kunnen we de maximale waarde van het veld niet onthouden. leveringstijd, die tijdens de vorige uitwisseling is doorgegeven, en bij de volgende uitwisseling alle records met een hogere waarde van het veld selecteren. leveringstijd. Tussen de uitwisselingen kunnen er records zijn toegevoegd met een lagere waarde van het veld. leveringstijd. Ook kan de bestelling wijzigingen hebben ondergaan die dit veld echter niet hebben aangetast. leveringstijd. In beide gevallen zullen de wijzigingen niet van de bron naar de ontvanger worden doorgegeven. Om deze problemen op te lossen, moeten we gegevens 'overlapping' verzenden. Dat wil zeggen, bij elke uitwisseling zullen we alle gegevens doorgeven met een waarde van het veld leveringstijd, die groter is dan een bepaald moment in het verleden (bijvoorbeeld N uren vanaf het huidige moment). Het is echter duidelijk dat deze aanpak voor grote systemen sterk overbodig is en de besparing op verkeer die we nastreven, teniet kan doen. Bovendien kan het veld dat met datum en tijd is verbonden ontbreken in de te verzenden tabel.
Een andere oplossing, die complexer is qua implementatie, bestaat uit het bevestigen van de ontvangst van gegevens. In dit geval worden bij elke uitwisseling alle gegevens verzonden waarvan de ontvangst niet door de ontvanger is bevestigd. Voor de implementatie moet er een boolse kolom (bijvoorbeeld is_transferred) aan de bron tabel worden toegevoegd. Als de ontvanger bevestigt dat hij het record heeft ontvangen, krijgt het overeenkomstige veld de waarde true, waarna het record niet meer deelneemt aan de uitwisselingen. Dit implementatiealternatief heeft de volgende nadelen. Ten eerste moet er voor elk doorgegeven record een bevestiging worden gegenereerd en verzonden. Grofweg gesproken kan dit vergelijkbaar zijn met het verdubbelen van de hoeveelheid verzonden gegevens en kan het leiden tot het verdubbelen van het aantal roundtrips. Ten tweede ontbreekt de mogelijkheid om hetzelfde record naar meerdere ontvangers te sturen (de eerste ontvanger die het record ontvangt, bevestigt de ontvangst voor zichzelf en voor alle anderen).
Een manier die vrij is van de bovengenoemde tekortkomingen, bestaat uit het toevoegen van een kolom aan de verzonden tabel voor het volgen van wijzigingen in de rijen. Zo'n kolom kan een datum-tijd type hebben en moet door de applicatie worden ingesteld/geüpdatet op de huidige tijd telkens wanneer er records worden toegevoegd/wijzigd (atomair met het toevoegen/wijzigen). Als voorbeeld noemen we de kolom update_time. Door de maximale waarde van dit kolomveld voor de verzonden records op te slaan, kunnen we de volgende uitwisselingssessie met deze waarde beginnen (records selecteren met een veldwaarde update_time, die hoger is dan de eerder opgeslagen waarde). Het probleem met deze laatste benadering is dat gegevenswijzigingen batchgewijs kunnen plaatsvinden. Daarom kunnen de waarden in de kolom update_time niet uniek zijn. Hierdoor kan deze kolom niet worden gebruikt voor paginerende (geclusterde) gegevensuitgifte. Voor paginerende gegevensuitgifte moeten we extra mechanismen verzinnen die waarschijnlijk zeer inefficiënt zullen zijn (bijvoorbeeld het ophalen van alle records uit de database met een waarde update_time boven een bepaalde drempel en het uitgeven van een bepaald aantal records, te beginnen vanaf een bepaalde offset vanaf het begin van de selectie).
We kunnen de efficiëntie van gegevensoverdracht verbeteren door de vorige benadering iets te verfijnen. Hiervoor zullen we als waarden voor de kolom die wijzigingen bijhoudt een geheel getal type (lange integer) gebruiken. We noemen de kolom row_ver. De waarde van dit kolomveld moet nog steeds worden ingesteld/geüpdatet telkens wanneer er een record wordt aangemaakt/wijzigd. Maar in dit geval krijgt het veld niet de huidige datum-tijd, maar de waarde van een bepaalde teller, die met één wordt verhoogd. Hierdoor zal de kolom row_ver unieke waarden bevatten en kan het niet alleen worden gebruikt voor het uitgeven van de 'delta' van gegevens (gegevens die zijn toegevoegd/wijzigd na de beëindiging van de vorige uitwisselingssessie), maar ook voor eenvoudige en efficiënte paginering.
De laatste voorgestelde methode om de hoeveelheid gegevens die binnen hoog-niveau replicatie wordt verzonden te minimaliseren, lijkt me het meest optimaal en universeel. Laten we hier dieper op ingaan.
Gegevensoverdracht met behulp van een regelversie teller
Implementatie van de server-/masterkant
In MS SQL Server bestaat er voor de implementatie van een dergelijk benadering een speciaal type kolom — rowversion. Elke database heeft een teller die met één toeneemt elke keer dat er een record wordt toegevoegd of gewijzigd in de tabel die een kolom van het type rowversion. De waarde van deze teller wordt automatisch toegewezen aan het veld van deze kolom in het nieuw toegevoegde of gewijzigde record. De DBMS Tarantool heeft geen gelijkwaardige ingebouwde mechanisme. Het is echter niet moeilijk om dit in Tarantool handmatig te implementeren. Laten we eens kijken hoe dit wordt gedaan.
Laten we beginnen met wat terminologie: tabellen in Tarantool worden ruimtes (space) genoemd, en records zijn tuples. In Tarantool kunnen sequenties (sequence) worden gemaakt. Sequenties zijn simpelweg benoembare generators van geordende waarden van gehele getallen. Dit is precies wat we nodig hebben voor onze doeleinden. Hieronder zullen we zo'n sequentie creëren.
Voordat je enige bewerking op de database in Tarantool kunt uitvoeren, moet je de volgende opdracht uitvoeren:
box.cfg{}Als resultaat zal Tarantool beginnen met het opslaan van database snapshots en transactie logs in de huidige map.
Laten we een sequentie maken row_version:
box.schema.sequence.create('row_version',
    { if_not_exists = true })
Optie if_not_exists maakt het mogelijk om het creatiescript herhaaldelijk uit te voeren: als het object bestaat, zal Tarantool niet proberen het opnieuw te maken. Deze optie zal gebruikt worden in alle volgende DDL-commando's.
Laten we een ruimte creëren voor de voorbeeld.
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        },
        {
            name = 'row_ver',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})
Hier hebben we de naam van de ruimte (goods), de namen van de velden en hun types gedefinieerd.
Auto-increment velden in Tarantool worden ook gemaakt met behulp van sequenties. Laten we een auto-increment primaire sleutel aanmaken op het veld id:
box.schema.sequence.create('goods_id',
    { if_not_exists = true })
box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Tarantool ondersteunt verschillende soorten indexen. Het meest voorkomende zijn de indexen van de types TREE en HASH, die zijn gebaseerd op de respectieve structuren. TREE is het meest veelzijdige type index. Het stelt ons in staat om gegevens in een geordende vorm op te halen. Maar voor selecties op gelijkheid is HASH geschikter. Daarom is het logisch om HASH te gebruiken voor de primaire sleutel (wat we ook gedaan hebben).
Om een kolom te gebruiken row_ver voor het doorgeven van gewijzigde gegevens, moet je de waarden van de sequentie aan de velden van deze kolom koppelen row_ver. Maar in tegenstelling tot de primaire sleutel, moet de waarde van het kolomveld row_ver met één toenemen, niet alleen bij het toevoegen van nieuwe records, maar ook bij het wijzigen van bestaande records. Hiervoor kunnen triggers worden gebruikt. In Tarantool zijn er twee soorten triggers voor spaces: before_replace en on_replace. Triggers worden geactiveerd bij elke wijziging van gegevens in de space (voor elke tuple die door de wijzigingen wordt aangeraakt, wordt de triggerfunctie geactiveerd). In tegenstelling tot on_replace, before_replace-triggers stellen ons in staat om de gegevens van de tuple, waarvoor de trigger wordt uitgevoerd, te wijzigen. Daarom is de laatste soort triggers geschikt voor ons.
box.space.goods:before_replace(function(old, new)
    return box.tuple.new({new[1], new[2], new[3],
        box.sequence.row_version:next()})
end)
De gegeven trigger vervangt de waarde van het veld row_ver van de opgeslagen tuple met de volgende waarde van de sequentie row_version.
Om gegevens uit de space goods op kolom row_ver, te kunnen ophalen, creëren we een index:
box.space.goods:create_index('row_ver', {
    parts = { 'row_ver' },
    unique = true,
    type = 'TREE',
    if_not_exists = true
})
Het type index is boom (TREE), omdat we de gegevens in oplopende volgorde van de waarden in de kolom moeten ophalen. row_ver.
Laten we enkele gegevens aan de space toevoegen:
box.space.goods:insert{nil, 'pen', 123}
box.space.goods:insert{nil, 'pencil', 321}
box.space.goods:insert{nil, 'brush', 100}
box.space.goods:insert{nil, 'watercolour', 456}
box.space.goods:insert{nil, 'album', 101}
box.space.goods:insert{nil, 'notebook', 800}
box.space.goods:insert{nil, 'rubber', 531}
box.space.goods:insert{nil, 'ruler', 135}
Aangezien het eerste veld een auto-increment tellercode is, geven we nil in plaats van dit veld door. Tarantool plaatst automatisch de volgende waarde. Op dezelfde manier kunnen we voor de waarden van de kolomvelden row_ver nil doorgeven - of we hoeven helemaal geen waarde op te geven, omdat deze kolom de laatste positie in de space inneemt.
Laten we het resultaat van de invoer controleren:
tarantool> box.space.goods:select()
---
- - [1, 'pen', 123, 1]
  - [2, 'pencil', 321, 2]
  - [3, 'brush', 100, 3]
  - [4, 'watercolour', 456, 4]
  - [5, 'album', 101, 5]
  - [6, 'notebook', 800, 6]
  - [7, 'rubber', 531, 7]
  - [8, 'ruler', 135, 8]
...
Zoals we zien, zijn het eerste en laatste veld automatisch ingevuld. Het zal nu niet moeilijk zijn om een functie te schrijven voor paginering van wijzigingen in de ruimte. goods:
local page_size = 5
local function get_goods(row_ver)
    local index = box.space.goods.index.row_ver
    local goods = {}
    local counter = 0
    for _, tuple in index:pairs(row_ver, {
        iterator = 'GT' }) do
        local obj = tuple:tomap({ names_only = true })
        table.insert(goods, obj)
        counter = counter + 1
        if counter >= page_size then
            break
        end
    end
    return goods
end
De functie neemt als parameter de waarde row_ver, vanaf waar de wijzigingen moeten worden geëxporteerd, en retourneert een reeks gewijzigde gegevens.
Data-extractie in Tarantool gebeurt via indexen. De functie get_goods maakt gebruik van een iterator over de index row_ver om gewijzigde gegevens te verkrijgen. Het type iterator is GT (Greater Than, groter dan). Dit betekent dat de iterator de waarden van de index achtereenvolgens doorloopt, te beginnen vanaf de meegegeven sleutel (waarde van het veld row_ver).
De iterator retourneert tuples. Om de gegevens later via HTTP te kunnen doorgeven, is het nodig om de tuples om te zetten naar een structuur die geschikt is voor latere serialisatie. In het voorbeeld wordt hiervoor de standaardfunctie tomap. In plaats van deze te gebruiken, tomap kun je een eigen functie schrijven. Bijvoorbeeld, we kunnen ervoor kiezen om het veld naamte hernoemen, het veld code niet door te geven en het veld comment:
local function unflatten_goods(tuple)
    local obj = {}
    obj.id = tuple.id
    obj.goods_name = tuple.name
    obj.comment = 'some comment'
    obj.row_ver = tuple.row_ver
    return obj
end
De paginagrootte van de weergegeven gegevens (aantal records in één portie) wordt bepaald door de variabele page_size. In het voorbeeld is de waarde page_size is gelijk aan 5. In een echte toepassing heeft de pagina-omvang vaak een grotere betekenis. Het hangt af van de gemiddelde grootte van een tuple van de ruimte. De optimale pagina-grootte kan experimenteel worden bepaald door de overdrachtstijd te meten. Hoe groter de pagina-grootte, hoe minder round-trips er zijn tussen de verzendende en ontvangende partij. Dit kan de totale tijd voor het uploaden van wijzigingen verkorten. Maar bij een te grote pagina-grootte kan de server te lang bezig zijn met het serialiseren van de selectie. Dit kan leiden tot vertragingen bij de verwerking van andere verzoeken die naar de server zijn gestuurd. De parameter page_size kan worden geladen uit het configuratiebestand. Voor elke overgedragen ruimte kan een eigen waarde worden ingesteld. Voor de meeste ruimtes kan echter de standaardwaarde (bijvoorbeeld 100) worden gebruikt.
Laten we de functie uitvoeren get_goods:
tarantool> get_goods(0)

---
- - row_ver: 1
    code: 123
    name: pen
    id: 1
  - row_ver: 2
    code: 321
    name: pencil
    id: 2
  - row_ver: 3
    code: 100
    name: brush
    id: 3
  - row_ver: 4
    code: 456
    name: watercolour
    id: 4
  - row_ver: 5
    code: 101
    name: album
    id: 5
...
Laten we de waarde van het veld row_ver uit de laatste regel nemen en de functie opnieuw aanroepen:
tarantool> get_goods(5)

---
- - row_ver: 6
    code: 800
    name: notebook
    id: 6
  - row_ver: 7
    code: 531
    name: rubber
    id: 7
  - row_ver: 8
    code: 135
    name: ruler
    id: 8
...
En nogmaals:
tarantool> get_goods(8)
---
- []
...
Zoals we zien, retourneert de functie bij dit gebruik alle records van de ruimte paginagewijs. goodsNa de laatste pagina volgt een lege selectie.
Laten we wijzigingen aanbrengen in de ruimte:
box.space.goods:update(4, {{'=', 6, 'copybook'}})
box.space.goods:insert{nil, 'clip', 234}
box.space.goods:insert{nil, 'folder', 432}
We hebben de waarde van het veld naam voor één record gewijzigd en twee nieuwe records toegevoegd.
Laten we de laatste functie-aanroep herhalen:
tarantool> get_goods(8)
---


- - row_ver: 9
    code: 800
    name: copybook
    id: 6
  - row_ver: 10
    code: 234
    name: clip
    id: 9
  - row_ver: 11
    code: 432
    name: folder
    id: 10
...
De functie retourneerde de gewijzigde en toegevoegde records. Zo stelt de functie get_goods in staat om gegevens te verkrijgen die zijn gewijzigd sinds de laatste aanroep, wat de basis is van de besproken replicatiemethode.
We laten de resultatenoverdracht via HTTP in de vorm van JSON buiten beschouwing in dit artikel. Hierover kan hier worden gelezen:
Implementatie van de client/slave-kant
Laten we bekijken hoe de implementatie van de ontvangende kant eruit ziet. We creëren een ruimte aan de ontvangende kant voor het opslaan van de geladen gegevens:
box.schema.space.create('goods', {
    format = {
        {
            name = 'id',
            type = 'unsigned'

        },
        {
            name = 'name',
            type = 'string'

        },
        {
            name = 'code',
            type = 'unsigned'

        }
    },
    if_not_exists = true
})

box.space.goods:create_index('primary', {
    parts = { 'id' },
    sequence = 'goods_id',
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
De structuur van de ruimte lijkt op de structuur van de ruimte in de bron. Maar aangezien we de verkregen gegevens niet ergens anders naartoe willen overdragen, ontbreekt de kolom row_ver in de ontvangende ruimte. In het veld id worden de identificatoren van de bron opgeslagen. Daarom is het aan de ontvangende kant niet nodig om het automatisch incrementerend te maken.
Daarnaast hebben we een ruimte nodig voor het opslaan van de waarden row_ver:
box.schema.space.create('row_ver', {
    format = {
        {
            name = 'space_name',
            type = 'string'

        },
        {
            name = 'value',
            type = 'string'

        }
    },
    if_not_exists = true
})

box.space.row_ver:create_index('primary', {
    parts = { 'space_name' },
    unique = true,
    type = 'HASH',
    if_not_exists = true
})
Voor elke te laden ruimte (veld space_name) slaan we hier de laatst geladen waarde op row_ver (veld value). De kolom fungeert als primaire sleutel space_name.
Laten we een functie maken voor het laden van gegevens uit de ruimte goods via HTTP. Hiervoor hebben we een bibliotheek nodig die de HTTP-client implementeert. De volgende regel laadt de bibliotheek en creëert een instantie van de HTTP-client:
local http_client = require('http.client').new()We hebben ook een bibliotheek nodig voor het deserialiseren van json:
local json = require('json')Dit is voldoende voor het creëren van een functie om gegevens te laden:
local function load_data(url, row_ver)
    local url = ('%s?rowVer=%s'):format(url,
        tostring(row_ver))
    local body = nil
    local data = http_client:request('GET', url, body, {
        keepalive_idle =  1,
        keepalive_interval = 1
    })
    return json.decode(data.body)
end
De functie voert een HTTP-verzoek uit naar het adres url, geeft het door row_ver als parameter en retourneert het gedeserialiseerde resultaat van het verzoek.
De functie voor het opslaan van de verkregen gegevens ziet er als volgt uit:
local function save_goods(goods)
    local n = #goods
    box.atomic(function()
        for i = 1, n do
            local obj = goods[i]
            box.space.goods:put(
                obj.id, obj.name, obj.code)
        end
    end)
end
De lus voor het opslaan van gegevens in de ruimte goods is in een transactie geplaatst (hiervoor wordt de functie gebruikt box.atomic) om het aantal schrijfoperaties naar de schijf te verminderen.
Ten slotte kan de functie voor het synchroniseren van de lokale ruimte goods met de bron als volgt worden geïmplementeerd:
local function sync_goods()
    local tuple = box.space.row_ver:get('goods')
    local row_ver = tuple and tuple.value or 0

    —— set your url here:
    local url = 'http://127.0.0.1:81/test/goods/list'

    while true do
        local goods = load_goods(url, row_ver)

        local count = #goods
        if count == 0 then
            return
        end

        save_goods(goods)

        row_ver = goods[count].rowVer
        box.space.row_ver:put({'goods', row_ver})
    end
end
Eerst lezen we de eerder opgeslagen waarde row_ver voor de ruimte goods. Als deze ontbreekt (de eerste uitwisseling), dan nemen we als row_ver nul. Vervolgens voeren we paginagewijs het ophalen van gewijzigde gegevens uit de bron uit via de opgegeven url. Bij elke iteratie slaan we de verkregen gegevens op in de bijbehorende lokale ruimte en werken we de waarde bij row_ver (in de ruimte row_ver en in de variabele row_ver) — we nemen de waarde row_ver van de laatste regel van de geladen gegevens.
Om te voorkomen dat er per ongeluk een eindeloze lus ontstaat (in het geval van een fout in het programma) kan de lus while vervangen worden door voor:
for _ = 1, max_req do ... Als resultaat van de functie-uitvoering sync_goods ruimte goods in de ontvanger zal de nieuwste versies van alle records in de ruimte bevatten goods in de bron.
Het is duidelijk dat op deze manier gegevensverwijdering niet kan worden getransleerd. Als er een noodzaak is, kan een markering voor verwijdering worden gebruikt. We voegen toe aan de ruimte goods booleaanse veld is_deleted en in plaats van het fysiek verwijderen van een record gebruiken we logische verwijdering — we stellen de waarde van het veld in is_deleted op de waarde van true. Soms is het handiger om in plaats van een booleaanse veld is_deleted een veld te gebruiken deletedwaarin de datum-tijd van de logische verwijdering van de record wordt opgeslagen. Na logische verwijdering zal het gemarkeerde record voor verwijdering van de bron naar de ontvanger worden overgedragen (volgens de eerder besproken logica).
De sequens row_ver kan worden gebruikt voor de overdracht van gegevens van andere ruimtes: er is geen behoefte aan het maken van een aparte sequentie voor elke over te dragen ruimte.
We hebben een effectieve methode voor high-level datareplicatie in applicaties die de DBMS Tarantool gebruiken, besproken.
Conclusies
- DBMS Tarantool is een aantrekkelijk, veelbelovend product voor het creëren van hoogbelaste applicaties.
- High-level datareplicatie heeft een aantal voordelen ten opzichte van low-level replicatie.
- De in het artikel besproken methode voor high-level replicatie maakt het mogelijk om de hoeveelheid overgedragen gegevens te minimaliseren door alleen die records te verzenden die zijn gewijzigd sinds de laatste uitwisselingssessie.
Bron: habr.com
