

Hallo! Mijn naam is Vadim Madison, en ik leid de ontwikkeling van het System Platform van Avito. Er is al vaker gesproken over hoe we binnen het bedrijf van een monolithische architectuur naar microservices overstappen. Het is tijd om te delen hoe we onze infrastructuur hebben getransformeerd om het meeste uit microservices te halen en onszelf niet te verliezen in dit proces. Hoe PaaS ons hierbij helpt, hoe we de deployment hebben vereenvoudigd en het creëren van een microservice tot één klik hebben gereduceerd — lees verder. Niet alles wat ik hieronder schrijf, is volledig geïmplementeerd bij Avito; een deel is hoe we onze platform ontwikkelen.
(En aan het einde van dit artikel zal ik vertellen over de mogelijkheid om deel te nemen aan een driedaagse workshop van microservices-expert Chris Richardson).
Hoe we bij microservices zijn gekomen
Avito is een van de grootste classifieds ter wereld, met meer dan 15 miljoen nieuwe advertenties per dag. Onze backend verwerkt meer dan 20.000 aanvragen per seconde. Momenteel hebben we enkele honderden microservices.
We bouwen al jaren aan onze microservice-architectuur. Hoe precies — onze collega's zullen het in detail uitleggen op onze sessie op RIT++ 2017. Tijdens CodeFest 2017 (zie ), hebben Sergei Orlov en Mikhail Prokoptchuk uitgebreid uitgelegd waarom we überhaupt zijn overgestapt naar microservices en welke rol Kubernetes daarbij voor ons speelde. Nu doen we er alles aan om de kosten van schaling, die inherent zijn aan deze architectuur, tot een minimum te beperken.
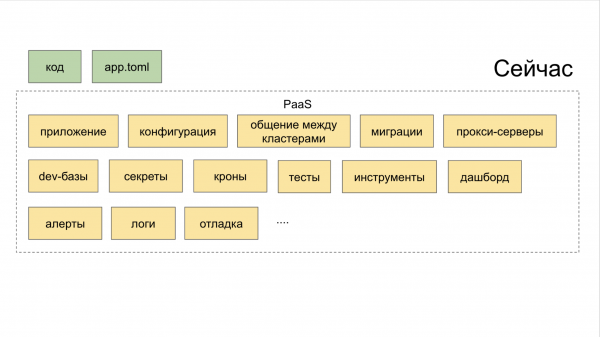
Aanvankelijk hebben we geen ecosysteem gebouwd dat ons uitgebreid hielp bij de ontwikkeling en lancering van microservices. We verzamelden gewoon nuttige open-source oplossingen, implementeren deze bij ons en boden de ontwikkelaar aan om ermee om te gaan. Uiteindelijk moest hij naar tientallen plekken (dashboards, interne services) gaan, waarna hij versterkt werd in zijn verlangen om de oude manier van coderen, in een monolith, voort te zetten. In de schema's hieronder geeft de groene kleur aan wat de ontwikkelaar op de een of andere manier zelf doet, terwijl de gele kleur de automatisering aangeeft.
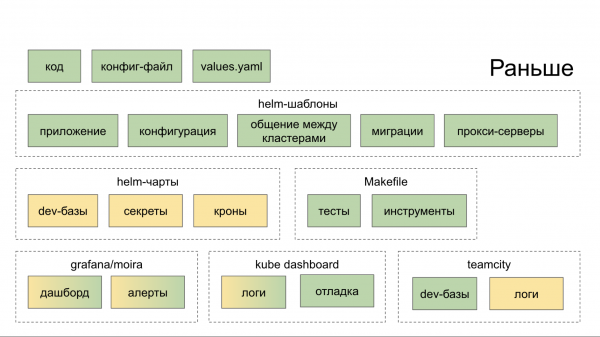
Nu kan in de CLI-tool van PaaS met één commando een nieuwe service worden aangemaakt, terwijl er met nog twee commando's een nieuwe database wordt toegevoegd en naar Stage wordt gedeployed.
Hoe de tijdperk van 'microservice fragmentatie' te overwinnen
Bij een monolithische architectuur waren ontwikkelaars gedwongen om te begrijpen wat er bij hun buren gebeurde, omwille van de consistentie van wijzigingen in het product. Bij het werken met de nieuwe architectuur zijn de contexten van de services niet meer afhankelijk van elkaar.
Daarnaast is het noodzakelijk om een aantal processen op te zetten voor een effectieve microservices-architectuur, namelijk:
• logging;
• tracing van verzoeken (Jaeger);
• foutaggregatie (Sentry);
• status, berichten, evenementen vanuit Kubernetes (Event Stream Processing);
• race limit / circuit breaker (bijvoorbeeld met Hystrix);
• controle van de samenhang van services (wij gebruiken Netramesh);
• monitoring (Grafana);
• build (TeamCity);
• communicatie en notificatie (Slack, e-mail);
• taaktracking; (Jira)
• documentatie opstellen.
Om de integriteit van het systeem te behouden en effectief te blijven naarmate het schaalt, hebben we de organisatie van microservices in Avito heroverwogen.
Hoe we omgaan met microservices
Een uniforme ‘partijpolitiek’ door de vele microservices van Avito wordt ondersteund door:
- het splitsen van de infrastructuur in lagen;
- het concept van Platform as a Service (PaaS);
- monitoring van alles wat met microservices gebeurt.
De abstractielagen van de infrastructuur omvatten drie lagen. Laten we van boven naar beneden gaan.
A. Bovenste — service mesh. In het begin hebben we Istio geprobeerd, maar het bleek te veel middelen te verbruiken, wat bij onze volumes te duur uitpakt. Daarom heeft onze senior engineer in het architectuurteam, Alexander Lukyanchensko, een eigen oplossing ontwikkeld — (beschikbaar in Open Source), dat we nu in productie gebruiken en dat een fractie van de middelen consumeert in vergelijking met Istio (hoewel het ook niet alles kan wat Istio beweert te kunnen).
B. Middelste — Kubernetes. Daarop zetten we microservices uit en beheren we ze.
C. Onderste — bare metal. We gebruiken geen clouds of dingen zoals OpenStack, maar we draaien volledig op bare metal.
Alle lagen zijn samengevoegd in PaaS. En dit platform bestaat op zijn beurt uit drie delen.
I. Generators, beheerd via een CLI-tool. Deze helpt de ontwikkelaar om microservices op de juiste manier en met minimale inspanning te creëren.
II. Gecombineerde verzamelcontainer met controle over alle tools via een gemeenschappelijk dashboard.
III. Opslag. Koppelt met planners die automatisch triggers instellen voor significante acties. Dankzij dit systeem blijft geen enkele taak onopgemerkt, alleen omdat iemand vergat zichzelf een taak in Jira te zetten. Hiervoor gebruiken we een interne tool genaamd Atlas.
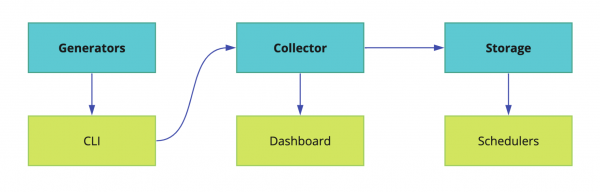
De implementatie van microservices bij Avito verloopt ook volgens een uniforme methode, wat het toezicht op hen in elke fase van ontwikkeling en release vergemakkelijkt.
Hoe een standaard microservice-ontwikkelingspipeline is opgebouwd
In algemene termen ziet de keten voor het creëren van een microservice er als volgt uit:
CLI-push → Continuous Integration → Bake → Deploy → Kunstmatige testen → Canary-testen → Squeeze Testing → Productie → Onderhoud.
Laten we ze in precies die volgorde doorlopen.
CLI-push
• Het creëren van een microservice.
We hebben lang geprobeerd elke ontwikkelaar te leren microservices te maken. We hebben ook gedetailleerde instructies in Confluence geschreven. Maar de schemas veranderden en werden aangevuld. Eindresultaat — er ontstond een bottleneck in het begin van de weg: het opstarten van microservices kostte veel meer tijd dan toegestaan, en er kwamen vaak problemen bij het creëren naar voren.
Uiteindelijk hebben we een eenvoudige CLI-hulpmiddel gemaakt dat de belangrijkste stappen bij het creëren van een microservice automatiseert. Het vervangt feitelijk de eerste git push. Dit is wat het specifiek doet.
— Het maakt een service aan volgens een sjabloon — stap voor stap, in wizard-modus. We hebben sjablonen voor de belangrijkste programmeertalen in de backend van Avito: PHP, Golang en Python.
— Met één commando zet het een omgeving op voor lokale ontwikkeling op een specifieke machine — Minikube wordt opgestart, Helm-charts worden automatisch gegenereerd en gestart in de lokale Kubernetes.
— Het verbindt met de benodigde database. De ontwikkelaar hoeft geen IP, gebruikersnaam en wachtwoord te kennen om toegang te krijgen tot de benodigde database — of het nu lokaal, in Stage of op productie is. De database wordt bovendien meteen in een fault-tolerante configuratie en met load balancing ingesteld.
— Het voert live-builds uit. Stel dat de ontwikkelaar iets heeft aangepast in de microservice via zijn IDE. Het hulpmiddel detecteert de wijzigingen in het bestandssysteem en bouwt de applicatie opnieuw (voor Golang) en herstart deze. Voor PHP sturen we eenvoudigweg de directory door naar binnen en daar gebeurt de live-reload 'automatisch'.
— Genereert autotests. In de vorm van sjablonen, maar absoluut bruikbaar.
• Deploy microservice.
Het opzetten van een microservice was voor ons vroeger een beetje gedoe. Het vereiste absoluut:
I. Dockerfile.
II. Configuratie.
III. Helm-chart, dat op zichzelf al omvangrijk is en het volgende omvat:
— de charts zelf;
— sjablonen;
— specifieke waarden rekening houdend met verschillende omgevingen.
We hebben de pijn met het herschrijven van Kubernetes-manifesten verholpen, en nu worden ze automatisch gegenereerd. Maar het belangrijkste is dat we de deploy tot een minimum hebben vereenvoudigd. Voortaan hebben we een Dockerfile, en de hele configuratie wordt door de ontwikkelaar in één enkele korte app.toml-bestand geschreven.
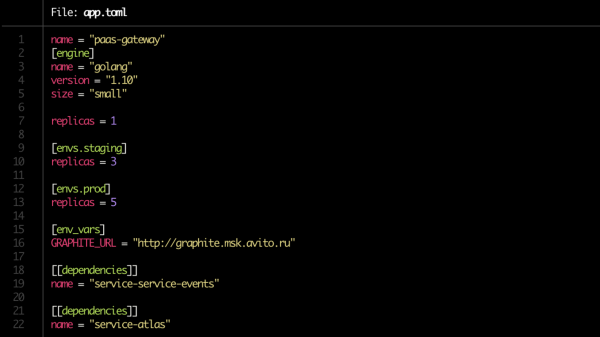
Ook in het app.toml is het nu in een paar minuten gedaan. We geven aan hoeveel kopieën van de service moeten worden opgestart (op de dev-server, staging, productie), en we geven de afhankelijkheden aan. Let op de regel size = "small" in het blok [engine]. Dit is de limiet die aan de service zal worden toegewezen via Kubernetes.
Verder worden op basis van de configuratie automatisch alle benodigde Helm-charts gegenereerd en de verbindingen met databases aangemaakt.
• Basisvalidatie. Dergelijke controles zijn ook geautomatiseerd.
We moeten controleren:
— of er een Dockerfile is;
— of er een app.toml is;
— of er documentatie beschikbaar is;
— of de afhankelijkheden in orde zijn;
— of de waarschuwingsregels zijn ingesteld.
Wat het laatste punt betreft: de eigenaar van de service geeft zelf aan welke productmetriek gecontroleerd moet worden.
• Voorbereiding van documentatie.
Nog steeds een probleemgebied. Het lijkt zo voor de hand liggend, maar is ook het meest "vergeten" en dus het kwetsbaarste schakel in de keten.
Het is noodzakelijk dat er documentatie is voor elke microservice. Dit omvat de volgende onderdelen.
I. Korte beschrijving van de service. Letterlijk een paar zinnen over wat het doet en waarvoor het nodig is.
II. Link naar het architectuurdiagram. Het is belangrijk dat het bij een vluchtige blik duidelijk is, bijvoorbeeld of je Redis gebruikt voor caching of als opslag voor gegevens in persistentiemodus. Bij Avito is dit voorlopig een link naar Confluence.
III. Runbook. Korte gids voor het starten van de service en de nuances van het werken ermee.
IV. FAQ, waar het goed zou zijn om problemen te anticiperen waarmee je collega’s bij het werken met de service kunnen worden geconfronteerd.
V. Beschrijving van de endpoints voor de API. Als je per ongeluk geen bestemmingen hebt opgegeven, zullen waarschijnlijk je collega's degene zijn die ervoor betalen, wiens microservices met de jouwe verbonden zijn. Momenteel gebruiken we hiervoor Swagger en onze oplossing genaamd brief.
VI. Labels. Of markers die aangeven tot welk product, functionaliteit of organisatorische eenheid van het bedrijf de service behoort. Helpt snel te begrijpen of je functionaliteit aan het ontwikkelen bent die je collega's een week geleden voor dezelfde business unit hebben uitgerold.
VII. Eigenaar of eigenaren van de service. In de meeste gevallen kan dat automatisch worden bepaald met PaaS, maar voor de zekerheid vragen we de ontwikkelaar om deze handmatig op te geven.
Tot slot is het een goede praktijk om documentatie te herzien, vergelijkbaar met code review.
Continue Integratie
- Voorbereiding van de repositories.
- Creëren van een pipeline in TeamCity.
- Rechten instellen.
- Zoeken naar eigenaren van de service. Hier is er een hybride aanpak — handmatige labeling en minimale automatisering van PaaS. Een volledig automatische aanpak faalt bij de overdracht van services naar ondersteuning in een ander ontwikkelingsteam of bijvoorbeeld als de ontwikkelaar van de service is vertrokken.
- Registratie van de service in Atlas (zie hierboven). Met al zijn eigenaren en afhankelijkheden.
- Controle van migraties. We controleren of er geen potentieel gevaarlijke migraties zijn. Bijvoorbeeld, als er een 'alter table' of iets dergelijks in voorkomt dat de compatibiliteit van het datamodel tussen verschillende versies van de service kan verstoren. Dan wordt de migratie niet uitgevoerd, maar wordt deze op een abonnement geplaatst — PaaS moet de eigenaar van de service informeren wanneer het veilig is om deze toe te passen.
Bake
De volgende fase is het verpakken van services vóór de inzet.
- Bouwen van de applicatie. Volgens de klassieker — in een Docker-image.
- Genereren van Helm-charts voor de service zelf en de daaropvolgende middelen. Inclusief voor databases en cache. Ze worden automatisch aangemaakt volgens de configuratie van app.toml die is opgesteld tijdens de CLI-push.
- Tickets aanmaken voor beheerders om poorten te openen (wanneer dit nodig is).
- Unit-tests uitvoeren en de code coverage berekenen.Als de code coverage onder de vereiste drempel ligt, zal de service waarschijnlijk niet verder gaan naar de deployment. Als het op de grens van acceptabel is, krijgt de service een 'pessimistisch' coëfficiënt toegewezen: dan ontvangt de ontwikkelaar een melding dat er geen vooruitgang is in de testresultaten (en dat er iets aan gedaan moet worden).
- Rekening houden met geheugen- en CPU-beperkingenWe schrijven voornamelijk microservices in Golang en draaien ze in Kubernetes. Dit brengt een klein detail met zich mee dat verband houdt met de eigenaardigheden van de Golang-taal: standaard worden alle kernen op de machine gebruikt bij het starten, tenzij de GOMAXPROCS-variabele expliciet is ingesteld, en wanneer meerdere van dergelijke services op één machine draaien, gaan ze om middelen concurreren, waardoor ze elkaar in de weg zitten. In de onderstaande grafieken is te zien hoe de uitvoeringstijd verandert als de applicatie zonder concurrentie en in een concurrerende modus wordt uitgevoerd. (De bronbestanden van de grafieken zijn beschikbaar ).
Uitvoeringstijd, hoe lager, hoe beter. Maximale: 643 ms, minimale: 42 ms. Afbeelding is aanklikbaar.
Tijd per operatie, hoe lager, hoe beter. Maximale: 14091 ns, minimale: 151 ns. Afbeelding is aanklikbaar.
In de voorbereidingsfase van de build kan deze variabele expliciet worden ingesteld, of er kan gebruik worden gemaakt van de bibliotheek van de jongens van Uber.
Deploy
• Controle van conventies. Voordat we beginnen met het leveren van builds van de service naar de beoogde omgevingen, moeten we het volgende controleren:
— API-eindpunten.
— De overeenstemming van de API-eindpunten met het schema.
— Het formaat van de logs.
— Het instellen van headers bij verzoeken naar de service (dit doet momenteel netramesh)
— Het instellen van een eigenaarsembleem bij het verzenden van berichten naar de bus (event bus). Dit is nodig voor het volgen van de samenhang tussen services via de bus. In de bus kunnen zowel idempotente gegevens worden verzonden die de samenhang van de services niet verhogen (wat goed is), als bedrijfsgegevens die de samenhang van de services versterken (wat erg slecht is!). En op het moment dat deze samenhang een probleem wordt, helpt het begrip wie schrijft en leest op de bus om services correct te scheiden.
Op dit moment zijn er niet zoveel conventies binnen Avito, maar hun aantal groeit. Hoe meer van dergelijke overeenkomsten er in een begrijpelijke en handige vorm voor het team zijn, hoe gemakkelijker het is om de consistentie tussen microservices te onderhouden.
Synthetische tests
• Testen binnen een gesloten circuit. Voor dit doel gebruiken we momenteel de opensource . Eerst legt hij de daadwerkelijke belasting op de service vast, vervolgens emuleert hij deze — gewoon in de gesloten cirkel.
• Belastbaarheidstest. Wij proberen alle services naar optimale prestaties te brengen. En alle versies van elke service moeten worden onderworpen aan belastbaarheidstests — zo kunnen we de huidige prestaties van de service begrijpen en het verschil met eerdere versies van dezelfde service. Als de prestaties van de service na een update met anderhalf is gedaald, is dat een duidelijk signaal voor de eigenaren: ze moeten in de code duiken en de situatie corrigeren.
Van de verzamelde gegevens vertrekken we bijvoorbeeld om auto-scaling correct te implementeren en uiteindelijk te begrijpen in hoeverre de service kan worden geschaald.
Bij belastbaarheidstests controleren we of het resourceverbruik binnen de gestelde limieten blijft. En we richten onze aandacht vooral op de extremen.
a) We kijken naar de totale belasting.
— Te laag — waarschijnlijk werkt er iets helemaal niet, als de belasting plotseling met meerdere keren is gedaald.
— Te hoog — optimalisatie is vereist.
b) We kijken naar de drempelwaarde van RPS.
Hier kijken we naar het verschil tussen de huidige versie en de vorige en het totale aantal. Bijvoorbeeld, als de service 100 rps levert — dan is het ofwel slecht geschreven, ofwel is dat de specificiteit ervan, maar het is in elk geval een reden om zeer kritisch naar de service te kijken.
Als de RPS daarentegen te hoog is, dan is er mogelijk een bug en heeft een van de endpoints zijn nuttige payload gestopt en triggert deze gewoon iets van return true;
Canary-tests
Nadat de synthetische tests zijn doorlopen, testen we de werking van de microservice bij een klein aantal gebruikers. We beginnen voorzichtig, met een uiterst klein percentage van het verwachte publiek van de service — minder dan 0,1%. In deze fase is het cruciaal dat in de monitoring de juiste technische en productgerichte metrics zijn vastgelegd, zodat ze het probleem in de service zo snel mogelijk kunnen signaleren. De minimale tijd voor een canary-test is 5 minuten, de belangrijkste tijd is 2 uur. Voor complexe services stellen we de tijd handmatig in.
We analyseren:
— metrics die specifiek zijn voor de taal, met inbegrip van php-fpm workers;
— fouten in Sentry;
— statuscodes;
— responsetijden, zowel exact als gemiddeld;
— latency;
— uitzonderingen, afgehandeld en niet-afgehandeld;
— productmetrics.
Squeeze Testing
Squeeze Testing wordt ook wel "uitpersingstests" genoemd. De methode is geïntroduceerd door Netflix. Het idee is dat we eerst één instantie vullen met echte verkeer tot deze faalt, waarmee we de limiet vaststellen. Vervolgens voegen we een andere instantie toe en belasten we dit paar opnieuw tot het maximum; we zien hun plafond en de delta met de eerste "squeeze". Zo voegen we stap voor stap één instantie toe en berekenen we de patronen in de veranderingen.
Gegevens van de "uitpersingstests" worden ook verzameld in een centrale metric database, waar we deze resultaten gebruiken om de resultaten van kunstmatige belasting te verrijken of deze volledig vervangen door "synthetische" gegevens.
Productie
• Schalen. Wanneer we de service in productie nemen, volgen we hoe deze schaalt. Alleen het monitoren van de CPU-gegevens is volgens onze ervaring niet effectief. Autoscaling met RPS-benchmarking werkt in zijn puurste vorm, maar alleen voor specifieke services, zoals online streaming. Dus kijken we in eerste instantie naar applicatiespecifieke productmetrics.
Uiteindelijk analyseren we bij het schalen:
— CPU- en RAM-gegevens,
— het aantal verzoeken in de wachtrij,
— responsetijd,
— prognoses op basis van verzamelde historische gegevens.
Bij het schalen van de service is het ook belangrijk om de afhankelijkheden te volgen, zodat we niet per ongeluk de eerste service in de keten schalen terwijl diegenen waarop deze afhankelijk is, falen onder de belasting. Om een acceptabele belasting voor de hele pool van services vast te stellen, bekijken we de historische gegevens van de "dichtstbijzijnde" afhankelijke service (gecombineerd met CPU- en RAM-gegevens in combinatie met app-specifieke metrics) en vergelijken deze met de historische gegevens van de initiërende service, en zo verder door de hele "afhankelijkheidsketen", van boven naar beneden.
Onderhoud
Nadat de microservice is ingevoerd, kunnen we triggers aanbrengen.
Dit zijn typische situaties waarin triggers afgaan.
— Potentieel gevaarlijke migraties zijn gevonden.
— Beveiligingsupdates zijn vrijgegeven.
— De service is al lange tijd niet bijgewerkt.
— De belasting op de service is aanzienlijk verminderd of bepaalde productmetrics komen buiten de norm.
— De service voldoet niet meer aan de nieuwe platformvereisten.
Een deel van de triggers is verantwoordelijk voor de stabiliteit van de werking, een ander deel — zoals een functie voor systeemonderhoud — bijvoorbeeld, een bepaalde service die al lange tijd niet is gedeployed en waarvan de basisafbeelding de beveiligingscontrole niet meer doorstaat.
Dashboard
Simpel gezegd, het dashboard is het controlepaneel van onze hele PaaS.
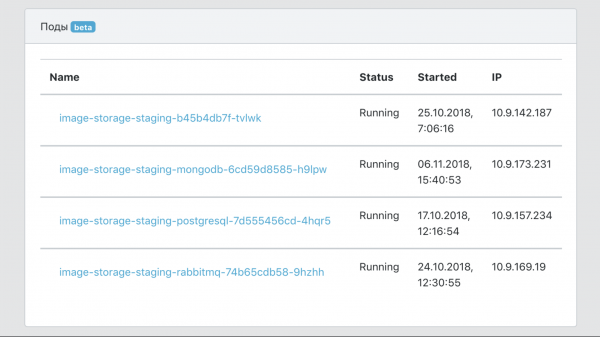
- Een enkele informatieve bron over de service, met gegevens over de testdekking, het aantal afbeeldingen, het aantal productie-exemplaren, versies, enz.
- Een middel om gegevens te filteren op basis van diensten en labels (markeringslabels voor bedrijfsunits, productfunctionaliteit, enz.).
- Een middel voor integratie met infrastructuurtools voor tracing, logging en monitoring.
- Een enkele documentatiebron voor diensten.
- Een enkele overzichtspagina van alle gebeurtenissen met diensten.
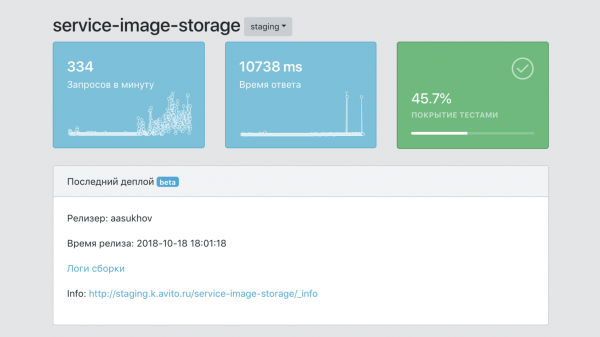
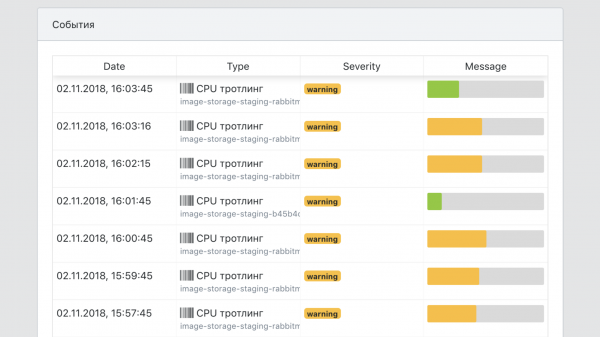
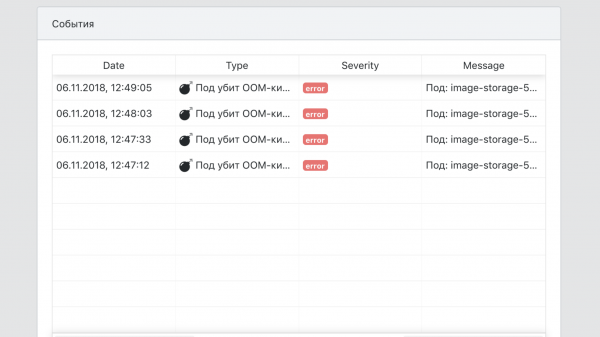
Total
Voor de implementatie van PaaS kon een nieuwe ontwikkelaar enkele weken besteden aan het begrijpen van alle tools die nodig waren om een microservice in productie te draaien: Kubernetes, Helm, — binnen onze interne bijzonderheden van TeamCity, configuratie van de verbinding met databases en caches op een fouttolerante manier, enz. Tegenwoordig kost dit een paar uur — lees de quickstart en maak de service zelf.
Ik heb hierover een presentatie gegeven voor HighLoad++ 2018, je kunt het bekijken. en .
Een bonustrack voor degenen die tot het einde hebben gelezen.
Bij Avito organiseren we een interne driedaagse training voor ontwikkelaars door , een expert in microservicesarchitectuur. We willen de kans bieden om eraan deel te nemen aan iemand uit de lezers van deze post. Het trainingsschema is gepubliceerd.
De training vindt plaats van 5 tot 7 augustus in Moskou. Dit zijn werkdagen die volledig in beslag worden genomen. Lunch en les zijn in ons kantoor, de geselecteerde deelnemer betaalt zelf voor vervoer en verblijf.
Je kunt je aanmeldingen indienen . Van jou is er — een antwoord op de vraag waarom jij de training moet bijwonen en informatie over hoe we contact met je kunnen opnemen. Antwoord in het Engels, omdat Chris zelf de deelnemer voor de training zal selecteren.
We zullen de naam van de deelnemer aan de training bekendmaken via een update van deze post en op de sociale netwerken van Avito voor ontwikkelaars (AvitoTech op , , ) uiterlijk 19 juli.
Bron: habr.com
