

Inleiding
Een informatiesysteem wordt vanuit het perspectief van de gebruiker goed gedefinieerd in GOST RV 51987 als 'een geautomatiseerd systeem waarvan de functie bestaat uit het presenteren van outputinformatie voor toekomstig gebruik'. Als we naar de interne structuur kijken, is in feite elk IS een systeem van in code geïmplementeerde onderling verbonden algoritmen. In brede zin voert de stelling van Turing-Church het algoritme (en dus IS) een transformatie uit van een set invoergegevens naar een set uitvoergegevens.
Men kan zelfs zeggen dat de transformatie van invoergegevens de essentie van het bestaan van een informatiesysteem vormt. De waarde van een IS en het gehele complex van IS wordt derhalve bepaald door de waarde van de invoer- en uitvoergegevens.
Op basis hiervan moet het ontwerp beginnen en zijn fundament vinden in de gegevens, waarbij de architectuur en methoden worden afgestemd op de structuur en betekenis van de gegevens.
Opgeslagen gegevens
Een cruciale stap in de voorbereiding van het ontwerp is het verkrijgen van kenmerken van alle datasets die bewerkt en opgeslagen zullen worden. Deze kenmerken omvatten:
— De hoeveelheid gegevens;
— Informatie over de levenscyclus van de gegevens (toename van nieuwe gegevens, levensduur, verwerking van verouderde gegevens);
— Classificatie van gegevens vanuit het perspectief van invloed op de kernactiviteiten van het bedrijf (de triade van vertrouwelijkheid, integriteit, beschikbaarheid), samen met financiële indicatoren (bijv. de kostprijs van gegevensverlies in het afgelopen uur);
— Geografie van gegevensverwerking (fysieke locatie van verwerkende systemen);
— Vereisten van toezichthouders voor elke klasse gegevens (bijv. FZ-152, PCI DSS).
Informatiesystemen
Gegevens worden niet alleen opgeslagen, maar ook verwerkt (getransformeerd) door informatiesystemen. De volgende stap, na het verkrijgen van de gegevenskenmerken, is een zo volledig mogelijke inventarisatie van de informatiesystemen, hun architectonische kenmerken, onderlinge afhankelijkheden en infrastructuurvereisten in termen van vier soorten middelen:
— Verwerkingskracht van de processor;
— Hoeveelheid RAM;
— Vereisten voor de hoeveelheid en prestaties van de opslagsystemen;
— Netwerkvereisten voor gegevensoverdracht (externe kanalen, kanalen tussen IS-componenten).
De vereisten moeten per service/microservice in het informatiesysteem aanwezig zijn.
Het is belangrijk om de gegevens over de impact van het informatiesysteem op de kernbusiness van het bedrijf op te nemen in termen van de kosten van stilstand van het informatiesysteem (rubels per uur).
Bedreigingsmodel
Er moet een formeel bedreigingsmodel beschikbaar zijn om de gegevens/services te beschermen. Dit model omvat niet alleen aspecten van vertrouwelijkheid, maar ook van integriteit en beschikbaarheid. Bijvoorbeeld:
— Uitval van een fysieke server;
— Uitval van een top-of-the-rack switch;
— Onderbreking van de optische communicatielijn tussen datacenters;
— Volledige uitval van de operationele opslag.
In sommige gevallen worden bedreigingsmodellen niet alleen voor infrastructuurcomponenten geschreven, maar ook voor specifieke informatiesystemen of hun componenten, zoals bijvoorbeeld de uitval van een databasesysteem met logische vernietiging van de datastructuur.
Alle oplossingen binnen het project ter bescherming tegen niet-omschreven bedreigingen zijn overbodig.
Regulatoire vereisten
Als de verwerkte gegevens onder speciale regels vallen die door de regelgevers worden vastgesteld, is informatie over datasets en regels voor verwerking/opslag absoluut noodzakelijk.
Doelstellingen RPO/RTO
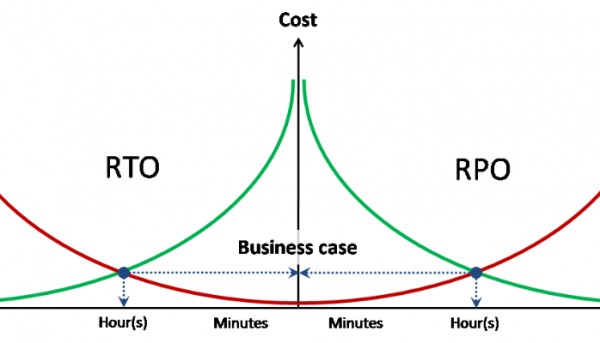
Het ontwerpen van elke vorm van bescherming vereist gegevens over de doelverliezen en de doelhersteltijd van de service voor elke van de beschreven bedreigingen.
Idealiter moeten RPO en RTO gekoppelde kosten voor dataverlies en stilstand per tijdseenheid hebben.
Verdeling in resources pools
Na het verzamelen van alle initiële invoergegevens is de eerste stap het groeperen van datasets en informatiesystemen in pools, rekening houdend met de bedreigingsmodellen en de vereisten van de regelgevers. Het type scheiding van verschillende pools wordt bepaald - programmatisch op het niveau van de systeemsoftware of fysiek.
Voorbeelden:
— De contour die persoonlijke gegevens verwerkt, is volledig fysiek gescheiden van andere systemen;
— Back-ups worden opgeslagen op een aparte opslag.
Pools kunnen echter met onvolledige onafhankelijkheid zijn, bijvoorbeeld er worden twee pools van rekenkracht (processorvermogen + RAM) gedefinieerd die gebruikmaken van een enkele pool voor gegevensopslag en een enkele pool voor gegevensoverdracht.
Processorvermogen
Abstracte behoeften aan de verwerkingskracht van een gevirtualiseerd datacenter worden gemeten in het aantal virtuele processoren (vCPU) en de consolidatiefactor ervan op fysieke processoren (pCPU). In dit specifieke geval is 1 pCPU = 1 fysiek processor core (zonder rekening te houden met Hyper-Threading). Het aantal vCPU wordt opgeteld over alle gedefinieerde resource pools (elke pool kan zijn eigen consolidatiefactor hebben).
De consolidatiefactor voor drukke systemen wordt empirisch bepaald, gebaseerd op de bestaande infrastructuur, of tijdens een pilotinstallatie en belastingstest. Voor niet-belaste systemen worden 'best practices' toegepast. VMware noemt bijvoorbeeld een gemiddelde factor van 8:1.
Geheugen
De totale behoefte aan RAM wordt verkregen door eenvoudige optelling. Het gebruik van overboeking van RAM wordt niet aanbevolen.
Opslagresources
De eisen voor opslagresources worden verkregen door de totale hoeveelheid en prestaties van alle pools op te tellen.
De prestatie-eisen worden uitgedrukt in IOPS, in combinatie met de gemiddelde verhouding van lezen/schrijven en indien nodig de maximale responstijd.
De eisen voor kwaliteitsborging (QoS) moeten afzonderlijk worden vermeld voor specifieke pools of systemen.
Netwerkresources
De eisen voor netwerkresources worden verkregen door de totale bandbreedte van alle pools op te tellen.
De eisen voor kwaliteitsborging (QoS) en latentie (RTT) moeten afzonderlijk worden vermeld voor specifieke pools of systemen.
Binnen de eisen voor netwerkresources worden ook eisen voor isolatie en/of encryptie van netwerkverkeer en de voorkeurmechanismen (802.1q, IPSec, enz.) opgegeven.
Architectuuroptie
In deze handleiding wordt geen andere optie behandeld dan de x86-architectuur en 100% servervirtualisatie. Daarom beperkt de keuze van de architectuur van het rekensysteem zich tot de keuze van het virtualisatieplatform, de serverformfactor en de algemene configuratie-eisen voor servers.
Een belangrijk punt bij de keuze is de duidelijkheid over het gebruik van de klassieke benadering met scheiding van gegevensverwerking, opslag en overdracht, of convergente architectuur.
Klassieke architectuur betekent het gebruik van intelligente externe opslagsystemen en gegevensoverdracht, terwijl servers alleen rekenkracht en RAM aan de gezamenlijke pool van fysieke middelen bijdragen. In extreme gevallen worden servers volledig anoniem, zonder niet alleen eigen schijven maar zelfs zonder een systeemidentificator. In dat geval wordt het besturingssysteem of hypervisor op ingebouwde flashdragers of vanuit een extern opslagsysteem opgestart (boot from SAN).
Binnen de klassieke architectuur wordt de keuze tussen blades en rackservers vooral gemaakt op basis van de volgende principes:
— Kosten-effectiviteit (gemiddeld zijn rackservers goedkoper);
— Rekendichtheid (blades hebben een hogere dichtheid);
— Energieverbruik en warmteontwikkeling (blades hebben een hoger verbruik per eenheid);
— Schaalbaarheid en beheersbaarheid (blades vereisen over het algemeen minder inspanning bij grote installaties);
— Gebruik van uitbreidingskaarten (voor blades is de keuze zeer beperkt).
Convergente architectuur (ook bekend als hyperconvergent) houdt in dat de functies voor gegevensverwerking en -opslag worden gecombineerd, wat leidt tot het gebruik van lokale schijven van servers en daardoor het afzien van het klassieke blade-formaat. Voor convergente systemen worden zowel rackservers als cluster systemen gebruikt, die in één behuizing meerdere blade-servers en lokale schijven combineren.
CPU / Geheugen
Voor een correcte configuratieberekening is het belangrijk om het type belasting voor de omgeving of elk van de onafhankelijke clusters te begrijpen.
CPU bound – een omgeving die beperkt is in prestaties door de CPU-kracht. Het toevoegen van RAM verandert niets aan de prestaties (aantal VM's op de server).
Geheugen bound – een omgeving die beperkt is door RAM. Meer RAM op de server maakt het mogelijk om meer VM's op de server te draaien.
GB / MHz (GB / pCPU) – de gemiddelde verhouding van het geheugenverbruik door deze specifieke belasting in verhouding tot de CPU-kracht. Dit kan worden gebruikt om de benodigde hoeveelheid geheugen te berekenen bij een gegeven prestatiedoel en vice versa.
Configuratieberekening van de server
Om te beginnen moet je alle soorten belasting bepalen en beslissen of je verschillende rekenpools over verschillende clusters wilt combineren of scheiden.
Vervolgens wordt voor elk van de gedefinieerde clusters de verhouding GB / MHz vastgesteld bij een vooraf bekende belasting. Als de belasting niet van tevoren bekend is, maar er wel een globaal begrip is van het niveau van de CPU-belasting, kunnen standaardverhoudingen vCPU:pCPU worden gebruikt om de vereisten van de pools om te zetten naar fysiek.
Voor elk cluster delen we de totale vCPU-vereisten van de pools door de verhouding:
vCPUtotaal / vCPU:pCPU = pCUtotaal – benodigd aantal fysieke kernen
pCUtotaal / 1.25 = pCUht – aantal kernen gecorrigeerd voor Hyper-Threading
Laten we aannemen dat we een cluster moeten berekenen met 190 kernen / 3,5 TB RAM. We nemen daarbij een doelstelling van 50% CPU-belasting en 75% voor het RAM.
pCPU
190
CPU-util
50%
Geheugen
3500
Geheugen-util
75%
Socket
Core
Srv / CPU
Srv Geheugen
Srv / Geheugen
2
6
25,3
128
36,5
2
8
19,0
192
24,3
2
10
15,2
256
18,2
2
14
10,9
384
12,2
2
18
8,4
512
9,1
In dit geval gebruiken we altijd afronding naar het dichtstbijzijnde gehele getal naar boven (=ROUNDUP(A1;0)).
Uit de tabel blijkt duidelijk dat er verschillende serverconfiguraties zijn die in balans zijn met de doelstellingen:
— 26 servers 2*6c / 192 GB
— 19 servers 2*10c / 256 GB
— 10 servers 2*18c / 512 GB
De keuze uit deze configuraties moet verder worden gemaakt op basis van aanvullende factoren, zoals thermisch pakket en beschikbare koeling, al gebruikte servers, of kosten.
Kenmerken van de keuze van serverconfiguratie
Breed VM. Bij de noodzaak om brede VM's te plaatsen (vergelijkbaar met 1 NUMA-knooppunt en meer) wordt aanbevolen om indien mogelijk een server te kiezen met een configuratie die dergelijke VM's binnen het NUMA-knooppunt kan houden. Bij een groot aantal brede VM's bestaat het gevaar van fragmentatie van de clusterresources, en in dat geval worden servers gekozen die het mogelijk maken om brede VM's zo dicht mogelijk te plaatsen.
Grootte van de enkele falldomein.
De keuze van de servergrootte wordt ook gemaakt vanuit het principe van het minimaliseren van de enkele falldomein. Bijvoorbeeld bij de keuze tussen:
— 3 x 4*10c / 512 GB
— 6 x 2*10c / 256 GB
Bij gelijkblijvende omstandigheden moet de tweede optie worden gekozen, omdat bij uitval van één server (of onderhoud) niet 33% van de clusterresources verloren gaat, maar 17%. Evenzo wordt het aantal VM's en IS waarop de storing impact heeft, gehalveerd.
Berekening van traditionele opslag op basis van prestaties
Traditionele opslag wordt altijd berekend op basis van het slechtste scenario, waarbij de invloed van interne cache en optimalisatie van bewerkingen worden uitgesloten.
Als basisindicatoren voor prestaties nemen we de mechanische IOPS-prestaties van de schijf:
— 7.2k – 75 IOPS
— 10k – 125 IOPS
— 15k – 175 IOPS
Daarna wordt het aantal schijven in de schijfpool berekend volgens de volgende formule: = TotalIOPS * ( RW + (1 –RW) * RAIDPen) / IOPSdisk. Waarbij:
— TotalIOPS – de totale vereiste prestatie in IOPS van de schijfpool
— RW – het percentage van leesopdrachten
— RAIDpen – RAID-straf voor het gekozen RAID-niveau
Meer informatie over RAID en RAID Penalty is hier te vinden — en en
Op basis van het aantal berekende schijven worden mogelijke opties berekend die voldoen aan de capaciteitsvereisten, inclusief opties met meerdere niveaus van opslag.
De berekening van systemen met SSD als niveau van opslag wordt apart behandeld.
Kenmerken van de berekening van systemen met Flash Cache
Flash Cache – een algemene term voor alle merkgebonden technologieën die flash-geheugen als tweede niveau-cache gebruiken. Bij het gebruik van flash-cache wordt de opslag gewoonlijk berekend om te voldoen aan de constante belasting van magnetische schijven, terwijl de pieken door de cache worden verwerkt.
Het is belangrijk om het profiel van de belasting en de mate van localisatie van de aanvragen naar de opslagvolumes te begrijpen. Flash-cache is een technologie voor zwaar gelokaliseerde aanvragen, en is praktisch niet toepasbaar voor gelijkmatig belaste volumes (zoals bij analysesystemen).
Berekening van hybride systemen low-end / mid-range
Hybride systemen van lage en middelgrote klasse gebruiken meerlagige opslag met gegevensverschuiving tussen niveaus volgens een schema. Daarbij heeft de blokgrootte van de meervoudige opslag bij de beste modellen een grootte van 256 MB. Deze kenmerken maken het onmogelijk om de technologie voor meervoudige opslag als prestatieverhoging te beschouwen, zoals door velen ten onrechte wordt aangenomen. Meerlagige opslag in systemen van lage en middelgrote klasse is een technologie voor het optimaliseren van opslagkosten voor systemen met een uitdrukkelijke ongelijkheid in belasting.
Voor gelaagde opslag wordt in de eerste plaats de prestatie op het bovenste niveau berekend, terwijl het onderste niveau van opslag slechts wordt beschouwd als een aanvulling voor het ontbrekende opslagcapaciteit. Voor een hybride gelaagd systeem is het gebruik van flash-cache technologie voor de gelaagde pool essentieel om de prestatieverlies van plotseling opwarmende gegevens op het onderste niveau te compenseren.
Gebruik van SSD in een gelaagde schijfpool
Het gebruik van SSD in een gelaagde schijfpool varieert, afhankelijk van de implementatie van de flash-cache-algoritmen door de betreffende fabrikant.
De algemene praktijk van het opslagsbeleid voor een schijfpool met SSD-niveau is SSD first.
Alleen-lezen Flash-cache. Voor een alleen-lezen flash-cache verschijnt het opslagniveau op SSD bij aanzienlijke lokalisatie van schrijfoperaties, ongeacht de cache.
Lees/Schrijf Flash-cache. In het geval van een schrijfflash-cache wordt eerst het maximale cachevolume ingesteld, en het opslagniveau op SSD verschijnt pas wanneer de cachecapaciteit onvoldoende is voor het verwerken van de gehele gelokaliseerde belasting.
De prestatie van SSD en cache wordt telkens berekend op basis van de aanbevelingen van de fabrikant, maar altijd voor het slechtste scenario.
Bron: habr.com
