

In dit artikel vertel ik over hoe het project waaraan ik werk is getransformeerd van een grote monoliet naar een set microservices.
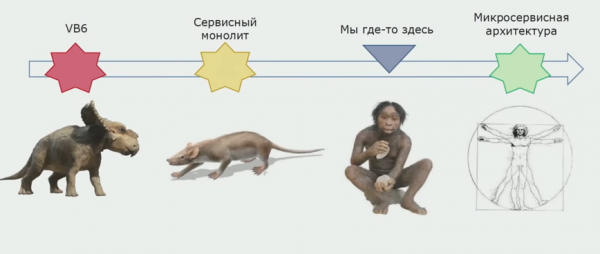
Het project is zijn geschiedenis begonnen in het begin van de jaren 2000. De eerste versies waren geschreven in Visual Basic 6. In de loop der tijd werd duidelijk dat het moeilijk zou zijn om in de toekomst met deze taal verder te ontwikkelen, omdat zowel de IDE als de taal langzaam evolueerden. Aan het einde van de jaren 2000 werd besloten om over te gaan op het meer veelbelovende C#. De nieuwe versie werd parallel geschreven met aanpassingen aan de oude, steeds meer code werd .NET. De backend in C# was aanvankelijk gericht op een service-architectuur, echter werden er tijdens de ontwikkeling gemeenschappelijke bibliotheken met logica gebruikt en werden de services in een enkel proces uitgevoerd. Het resultaat was een applicatie die wij 'service-monoliet' noemden.
Een van de weinige voordelen van deze combinatie was de mogelijkheid dat services elkaar konden aanroepen via een externe API. Er waren duidelijke aanwijzingen voor de overgang naar een meer correcte service-architectuur en in de toekomst naar een microservice-architectuur.
We zijn begonnen met ons werk aan de decompositie rond 2015. We hebben nog niet de ideale staat bereikt - er zijn delen van het grote project die moeilijk meer als monolieten kunnen worden aangeduid, maar ook niet lijken op microservices. Desondanks is er aanzienlijke vooruitgang geboekt.
Daarover zal ik in dit artikel vertellen.
Inhoud
Architectuur en problemen van de bestaande oplossing
Aanvankelijk zag de architectuur er als volgt uit: UI - een aparte applicatie, de monolithische component was geschreven in Visual Basic 6, de applicatie op .NET bestond uit een set gerelateerde services die werkten met een behoorlijk grote database.
Nadelen van de vroegere oplossing
Enkele punten van falen
We had a single point of failure: the .NET application was running in one process. If any module failed, the entire application would crash, requiring a restart. Since we automate a large number of processes for different users, when one of them failed, everyone was unable to work for some time. Even with backup systems, software errors were not resolved.
Queue for improvements
This drawback is more organizational. Our application has many clients, and they all want their improvements implemented as quickly as possible. In the past, it was impossible to do this in parallel, and all clients had to queue up. This process caused frustration for the business since they needed to prove that their task was valuable. The development team spent time organizing this queue, which consumed a lot of effort, and as a result, the product could not change as quickly as desired.
Suboptimal resource utilization
When hosting services in a single process, we always completely copied the configuration from server to server. We wanted to host the most heavily loaded services separately to avoid wasting resources and achieve more flexible management of our deployment scheme.
Difficulties in adopting modern technologies
A problem familiar to all developers: the desire to implement modern technologies in the project, but lacking the means to do so. With a large monolithic solution, any update of the current library, not to mention transitioning to a new one, becomes a rather non-trivial task. It takes a long time to convince the team lead that this will yield more benefits than nerves spent.
Complexity of delivering changes
This was the most serious problem — we released updates every two months.
Each release turned into a real disaster for the bank, despite testing and the developers' efforts. The business understood that part of the functionality would not work at the beginning of the week. Developers realized that they faced a week of serious incidents.
Everyone wanted to change the situation.
Verwachtingen van microservices
Delivery of components as ready. Delivery of components as they become ready, thanks to the decomposition of the solution and the separation of different processes.
Kleine productteams. Dit is belangrijk omdat het moeilijk was om een grote groep die aan een oude monoliet werkte te beheren. Zo'n team was gedwongen om volgens een strikt proces te werken, terwijl er meer creativiteit en onafhankelijkheid gewenst was. Dit konden alleen kleine teams zich permitteren.
Isolatie van services in aparte processen. Idealiter wilden we deze in containers isoleren, maar veel services geschreven in .NET Framework draaien alleen op Windows. Er komen nu services op .NET Core, maar die zijn voorlopig nog schaars.
Flexibiliteit in implementatie. We willen services combineren zoals wij dat nodig hebben, en niet zoals de code het dwingt.
Gebruik van nieuwe technologieën. Dit is interessant voor elke programmeur.
Problemen bij de overgang
Natuurlijk, als het eenvoudig was om een monoliet in microservices te splitsen, zouden we het er niet op conferenties over hebben en artikelen over schrijven. Dit proces heeft veel valkuilen; ik zal de belangrijkste beschrijven die ons in de weg stonden.
Het eerste probleem typisch voor de meeste monolieten: de gekoppeldheid van de bedrijfslogica. Wanneer we een monoliet schrijven, willen we onze klassen hergebruiken om onnodige code te vermijden. Bij de overstap naar microservices wordt dit een probleem: de hele code is vrij strak gekoppeld, en het is moeilijk om services te splitsen.
Bij de start van het werk waren er meer dan 500 projecten in de repository en meer dan 700.000 regels code. Dit is een behoorlijk grote oplossing en het tweede probleem. Gewoon het in microservices splitsen was niet mogelijk.
Het derde probleem — het ontbreken van de juiste infrastructuur. We waren feitelijk handmatig de broncode naar de servers aan het kopiëren.
Hoe van monoliet naar microservices te gaan
Splitsing van microservices
Ten eerste hebben we ons meteen gerealiseerd dat de splitsing van microservices een iteratief proces is. Van ons werd altijd gevraagd om tegelijkertijd met de ontwikkeling van zakelijke taken door te gaan. Hoe we dit technisch zouden realiseren, was al ons probleem. Daarom hebben we ons voorbereid op een iteratief proces. Het kan niet anders als je een grote applicatie hebt die oorspronkelijk niet is voorbereid om herschreven te worden.
Welke methoden gebruiken we voor de splitsing van microservices?
De eerste manier — bestaande modules als services aanbieden. In dit opzicht hadden we geluk: er waren al diensten opgezet die werkten met het WCF-protocol. Ze waren verdeeld over aparte assemblies. We verplaatsen ze afzonderlijk, waarbij we aan elke assembly een kleine opstartmodule toevoegden. Deze was geschreven met de geweldige Topshelf-bibliotheek, die het mogelijk maakt om de applicatie zowel als service als console uit te voeren. Dit is handig voor debuggen, omdat er geen extra projecten in de oplossing nodig zijn.
De diensten waren verbonden op basis van businesslogica, omdat ze gebruik maakten van gemeenschappelijke assemblies en werkten met een gedeelde database. Ze waren moeilijk volledig als microservices te bestempelen. Niettemin konden we deze services afzonderlijk draaien, in verschillende processen. Dit verminderde al de invloed die ze op elkaar hadden, waardoor het probleem van gelijktijdige ontwikkeling en een enkelvoudig foutpunt afnam.
De assembly met de host is gewoon één regel code in de Program-klasse. Het gebruik van Topshelf hebben we verstopt in een hulpkursus.
namespace RBA.Services.Accounts.Host
{
   internal class Program
   {
      private static void Main(string[] args)
      {
        HostRunner.Run("RBA.Services.Accounts.Host");

       }
    }
}
De tweede manier om microservices te onderscheiden: ze te creëren voor het aanpakken van nieuwe taken. Als de monolith daardoor niet groeit, is dat al geweldig, wat betekent dat we de goede richting op gaan. Voor het oplossen van nieuwe taken probeerden we afzonderlijke services te maken. Als de mogelijkheid zich voordeed, maakten we meer ‘canonieke’ services, die volledig hun eigen datamodel en een aparte database beheren.
Net als velen begonnen we met authenticatie- en autorisatieservices. Deze zijn hier uitermate geschikt voor. Ze zijn onafhankelijk, en hebben meestal een gescheiden datamodel. Ze communiceren zelf niet met de monolith, alleen deze roept hen aan om bepaalde taken op te lossen. Op deze services kun je beginnen met de overgang naar een nieuwe architectuur, de infrastructuur daarop debuggen, verschillende benaderingen die met netwerkbibliotheken te maken hebben uitproberen, enzovoort. In onze organisatie zijn er geen teams die geen werkende authenticatieservice kunnen maken.
De derde manier om microservices te onderscheiden, die wij gebruiken, is een beetje specifiek voor ons. Dit houdt in dat de businesslogica uit de UI-laag wordt gehaald. Onze belangrijkste UI-toepassing is desktop-gebaseerd, en is, net als de backend, geschreven in C#. Ontwikkelaars maakten af en toe fouten en namen logica mee naar de UI die eigenlijk in de backend had moeten bestaan en hergebruikt moest worden.
Als we een echt voorbeeld uit de UI-code bekijken, zien we dat een groot deel van deze oplossing echte businesslogica bevat, die nuttig is voor andere processen, niet alleen voor het opbouwen van de UI-formulieren.
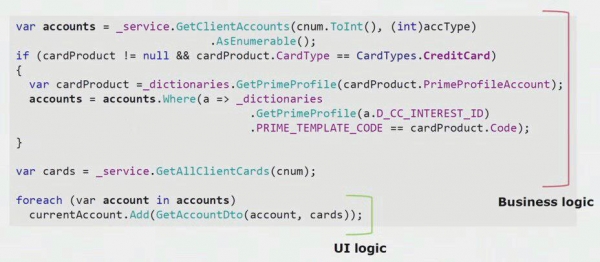
De echte logica van de UI bevindt zich slechts in de laatste paar regels. We hebben dit naar de server verplaatst zodat we het konden hergebruiken, waardoor we de UI verkleinen en een goede architectuur bereiken.
De vierde, en belangrijkste, manier om microservices te creëren, die het monolithische systeem kan verminderen, is het hervormen van bestaande services. Wanneer we bestaande modules zoals ze zijn verplaatsen, zijn de resultaten niet altijd naar de zin van de ontwikkelaars en kan het bedrijfsproces sinds de creatie van de functionaliteit verouderd zijn. Dankzij refactoring kunnen we het nieuwe bedrijfsproces ondersteunen, omdat de zakelijke vereisten voortdurend veranderen. We kunnen de oorspronkelijke code verbeteren, bekende defecten verwijderen en een kwalitatief beter datamodel creëren. Dit brengt veel voordelen met zich mee.
Het scheiden van services met herstructurering is onlosmakelijk verbonden met het concept van beperkte context. Dit concept komt uit domeingerichte ontwerpprincipes. Het houdt in dat er een deel van het domeinmodel is waar alle termen van de gezamenlijke taal eenduidig zijn gedefinieerd. Laten we dit illustreren met een voorbeeld uit de context van verzekeringen en rekeningen. We hebben een monolithische applicatie en het is nodig om in de verzekeringen met de rekening te werken. We verwachten dat de ontwikkelaar in een andere assemblage de bestaande klasse 'Rekening' vindt, daar een verwijzing naar maakt vanuit de klasse 'Verzekering', en dat we werkende code krijgen. Het DRY-principe wordt gerespecteerd, de taak wordt sneller uitgevoerd door gebruik te maken van bestaande code.
Uiteindelijk blijkt dat de contexten van rekeningen en verzekeringen met elkaar verbonden zijn. Wanneer er nieuwe vereisten ontstaan, zal deze verbinding de ontwikkeling bemoeilijken, waardoor de al complexe bedrijfslogica verder ingewikkeld wordt. Om dit probleem op te lossen, moeten we in de code de grenzen tussen de contexten vinden en hun schendingen verwijderen. Bijvoorbeeld, voor de verzekeringscontext is het wellicht voldoende om een 20-cijferig rekeningnummer van de centrale bank en de datum van opening van de rekening te hebben.
Om deze beperkte contexten van elkaar te scheiden en het proces van het выделing van microservices uit een monolithische oplossing te starten, hebben we een aanpak gebruikt waarbij we externe API's binnen de applicatie creëerden. Als we wisten dat een bepaalde module een microservice moest worden of op een andere manier moest worden gewijzigd in het proces, deden we meteen aanroepen naar de logica die behoort tot een andere beperkte context, via externe aanroepen. Bijvoorbeeld, via REST of WCF.
Wij hebben voor onszelf duidelijk besloten dat we code niet zullen vermijden die het vereist om gedistribueerde transacties uit te voeren. In ons geval bleek het eigenlijk vrij eenvoudig om deze regel na te leven. Tot nu toe hebben we nog geen situaties gehad waarin echt strikte gedistribueerde transacties nodig waren – het is voldoende om eindconsistentie tussen de modules te waarborgen.
Laten we een specifiek voorbeeld bekijken. We hebben het concept van een orkestrator – een pijplijn die de entiteit 'aanvraag' verwerkt. Deze maakt achtereenvolgens een klant, een rekening en een bankkaart aan. Als de klant en de rekening succesvol zijn aangemaakt, maar de aanmaak van de kaart mislukt, krijgt de aanvraag niet de status 'succesvol' en blijft in de status 'kaart niet aangemaakt'. In de toekomst zal een achtergrondactiviteit deze oppakken en afronden. Het systeem verkeert een tijd lang in een staat van inconsistentie, maar dat is voor ons over het algemeen acceptabel.
In het geval dat er toch een situatie ontstaat waarbij een deel van de gegevens consistent moet worden opgeslagen, zullen we waarschijnlijk de service in omvang vergroten om dit in één proces te kunnen verwerken.
Laten we een voorbeeld bekijken van het выделing van een microservice. Hoe kunnen we dit relatief veilig naar productie brengen? In dit voorbeeld hebben we een apart gedeelte van het systeem – de module voor salarisadministratie, waarvan we een deel van de code graag microservice-achtig willen maken.
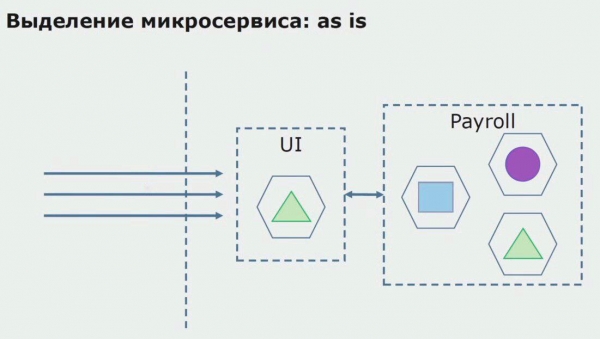
Allereerst creëren we een microservice door de code opnieuw te schrijven. We verbeteren een aantal aspecten waar we niet tevreden over waren. We implementeren nieuwe zakelijke eisen van de klant. We voegen een API Gateway toe tussen de UI en de backend, die de doorvoer van oproepen zal waarborgen.
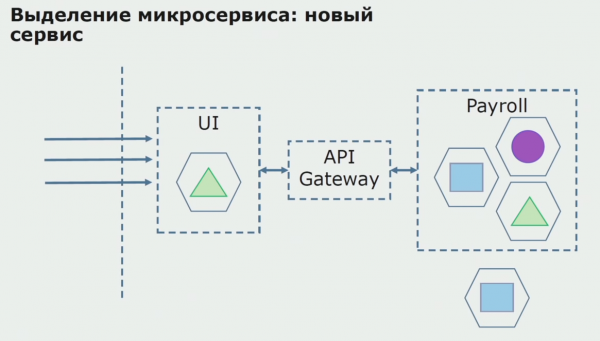
Vervolgens zetten we deze configuratie in productie, maar in een pilotstatus. De meeste gebruikers werken nog steeds met de oude bedrijfsprocessen. Voor nieuwe gebruikers ontwikkelen we een nieuwe versie van de monolithische applicatie die dit proces al niet meer bevat. In wezen draait er in de vorm van een pilot een combinatie van de monoliet en de microservice.
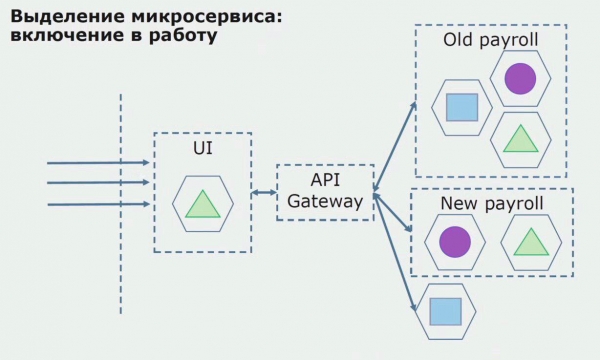
Bij een succesvolle pilot begrijpen we dat de nieuwe configuratie echt werkt, we kunnen de oude monoliet uit de vergelijking halen en de nieuwe configuratie op de plaats van de oude oplossing behouden.
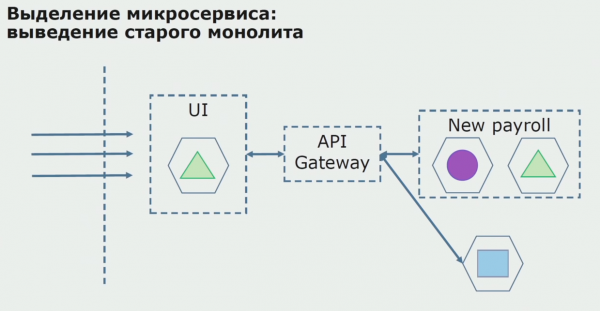
Kortom, we gebruiken vrijwel alle bestaande methoden voor het splitsen van de broncode van de monoliet. Al deze methoden stellen ons in staat om de grootte van delen van de applicatie te verminderen en ze over te brengen naar nieuwe bibliotheken, waardoor de kwaliteit van de broncode verbetert.
We zullen een database maken — MySQL. Als je PhpMyAdmin hebt geïnstalleerd, maak je een nieuwe database "
De database laat zich moeilijker splitsen dan de broncode, omdat deze niet alleen het huidige schema bevat, maar ook opgebouwde historische gegevens.
Onze database, net als vele anderen, had nog een belangrijk nadeel — een enorme omvang. Deze database was ontworpen volgens de ingewikkelde bedrijfslogica van de monoliet, en er waren verbanden ontstaan tussen de tabellen van verschillende begrensde contexten.
In ons geval kwam er, ter aanvulling op alle problemen (grote database, veel relaties, soms onduidelijke grenzen tussen tabellen), een probleem op dat vaak in grote projecten voorkomt: het gebruik van het shared database-patroon. Gegevens werden uit tabellen gehaald via een view, via replicatie en werden in andere systemen geladen waar die replicatie nodig was. Als gevolg hiervan konden we tabellen niet in een aparte schema plaatsen, omdat ze actief gebruikt werden.
Bij het splitsen helpt diezelfde splitsing in begrensde contexten in de code ons. Het geeft ons doorgaans een redelijk goed inzicht in hoe we gegevens op het niveau van de database splitsen. We begrijpen welke tabellen tot één begrensde context behoren en welke tot een andere.
We hebben twee globale methoden voor het scheiden van de database toegepast: het scheiden van bestaande tabellen en het scheiden met herontwerp.
Het scheiden van bestaande tabellen is een methode die goed toepasbaar is wanneer de datastructuur van hoge kwaliteit is, voldoet aan de zakelijke vereisten en voor iedereen acceptabel is. In dit geval kunnen we bestaande tabellen in een aparte schema onderscheiden.
Het scheiden met herontwerp is nodig wanneer het bedrijfsmodel drastisch is veranderd en de tabellen ons niet langer bevallen.
Scheiden van bestaande tabellen. We moeten vaststellen wat we gaan scheiden. Zonder deze kennis is het onmogelijk, en hier kan het scheiden van beperkte contexten in de code ons helpen. Over het algemeen, als we de grenzen van contexten in de oorspronkelijke code begrijpen, wordt duidelijk welke tabellen in de scheiding moeten worden opgenomen.
Stel je voor dat we een oplossing hebben waarbij twee modules van de monoliet interactie hebben met één database. We moeten ervoor zorgen dat alleen één module interactie heeft met het gedeelte van de te scheiden tabellen, terwijl de andere module met dit gedeelte via een API begint te communiceren. In het begin is het voldoende als alleen schrijfoperaties via de API plaatsvinden. Dit is een noodzakelijke voorwaarde om te kunnen spreken over de onafhankelijkheid van microservices. Lezen kan behouden blijven, zolang dit geen groot probleem vormt.
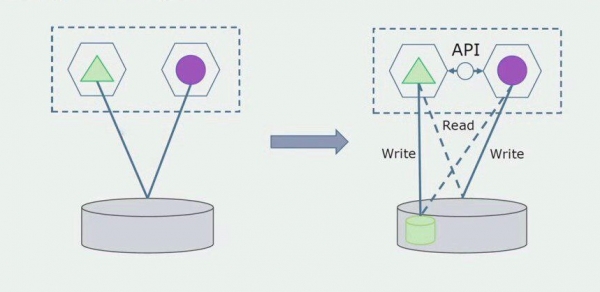
De volgende stap is dat we het codefragment dat met de te scheiden tabellen werkt, met of zonder herontwerp, kunnen onderscheiden als een aparte microservice en deze in een apart proces of container kunnen draaien. Dit zal een aparte service zijn met verbinding met de database van de monoliet en die tabellen die niet direct daarmee verband houden. De monoliet heeft nog steeds leesverbindingen met het scheidbare gedeelte.
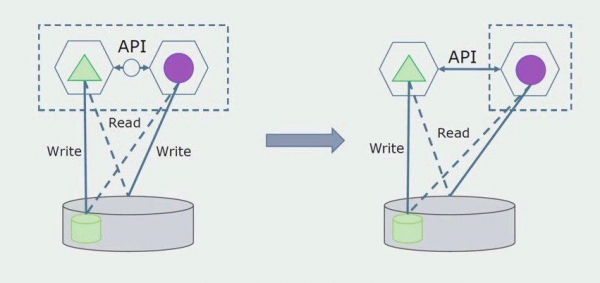
Later zullen we deze verbinding verwijderen, dat wil zeggen dat het lezen van gegevens uit de te scheiden tabellen door de monolithische applicatie ook op de API zal worden overgeschakeld.
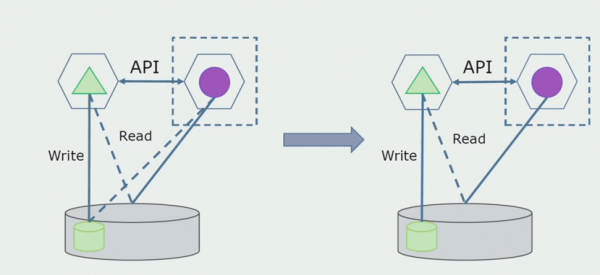
Vervolgens zullen we de tabellen scheiden uit de gezamenlijke database, waar alleen de nieuwe microservice mee werkt. We kunnen de tabellen in een apart schema of zelfs in een aparte fysieke database plaatsen. Er blijft een leesverbinding tussen de microservice en de database van de monoliet bestaan, maar dat is geen probleem, in deze configuratie kan het vrij lang doorgaan.
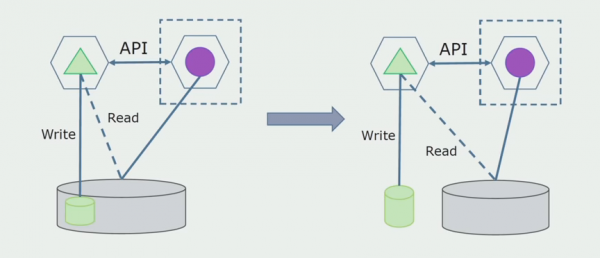
De laatste stap is om alle verbindingen volledig te verwijderen. In dit geval hebben we mogelijk migratie van gegevens vanuit de hoofd database nodig. Soms willen we gegevens of referenties die in verschillende databases worden gerepliceerd vanuit externe systemen, hergebruiken. Dit komt regelmatig voor.
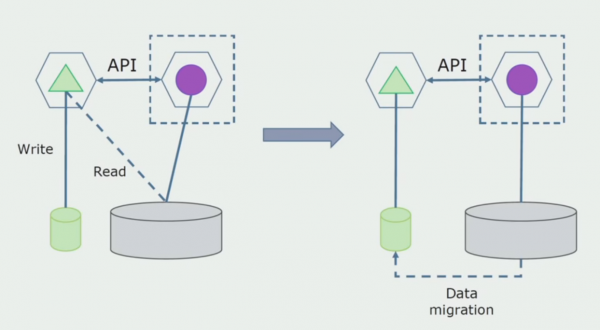
Afdeling met herstructurering. Deze methode is erg vergelijkbaar met de eerste, alleen gaat het in omgekeerde volgorde. We creëren meteen een nieuwe database en een nieuwe microservice, die communiceert met de monoliet via API. Maar we behouden een set tabellen in de database die we in de toekomst willen verwijderen. We hebben ze niet meer nodig, in het nieuwe model hebben we ze vervangen.
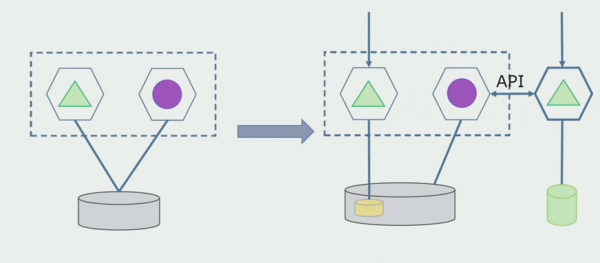
Om dit schema te laten werken, hebben we waarschijnlijk een overgangsperiode nodig.
Daarna zijn er twee mogelijke benaderingen.
Eerste: we dupliceren alle gegevens in de nieuwe en oude databases. In dit geval ontstaat er gegevensredundantie, en kunnen er synchronisatieproblemen optreden. Maar we kunnen twee verschillende klanten bedienen. De ene werkt met de nieuwe versie, de andere met de oude.
De tweede: we scheiden gegevens op basis van een bepaald businesskenmerk. Bijvoorbeeld, in ons systeem waren er 5 producten die in de oude database werden opgeslagen. De zesde voegen we qua nieuwe zakelijke taak toe aan de nieuwe database. Maar we hebben een API Gateway nodig die deze gegevens synchroniseert en de klant laat zien waar en wat te halen.
Beide benaderingen zijn werkbaar, kies afhankelijk van de situatie.
Zodra we zijn verzekerd dat alles werkt, kan het deel van de monoliet dat met de oude databasestructuren werkt, worden uitgeschakeld.
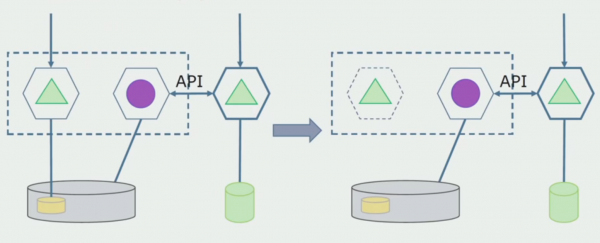
De laatste stap is het verwijderen van oude datastructuren.
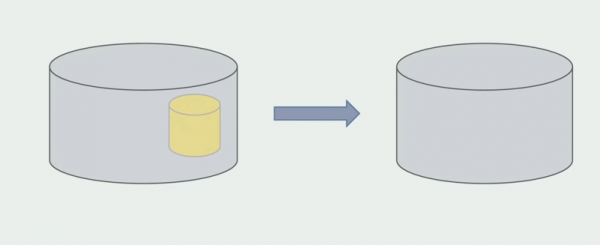
Samenvattend kunnen we zeggen dat we problemen hebben met de database: het is moeilijker om ermee te werken in vergelijking met de broncode, het is moeilijker om te splitsen, maar het is mogelijk en nodig. We hebben enkele manieren gevonden die het relatief veilig maken, want met gegevens is het gemakkelijker om een fout te maken dan met de broncode.
Werken met de broncode
Zo zag het schema van de broncode eruit toen we begonnen met het analyseren van het monolithische project.
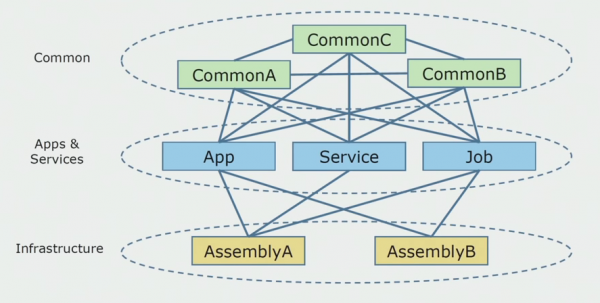
Het kan voorwaardelijk in drie lagen worden verdeeld. Dit is de laag van uitvoerbare modules, plugins, services en afzonderlijke activiteiten. In feite waren dit de toegangspunten binnen een monolithische oplossing. Ze waren allemaal stevig verbonden met de Common-laag. Hierin bevond zich de bedrijfslogica die door de services gezamenlijk werd gebruikt, en er waren talloze verbanden. Elke service en plugin gebruikte tot wel 10 of meer common-assemblies, afhankelijk van hun grootte en de integriteit van de ontwikkelaars.
We hadden geluk, we beschikten over infrastructuurbibliotheken die afzonderlijk konden worden gebruikt.
Soms deed zich een situatie voor waarin sommige Common-objecten eigenlijk niet tot deze laag behoorden, maar infrastructuurbibliotheken waren. Dit werd opgelost door ze een andere naam te geven.
Beperkingen met betrekking tot contexten veroorzaakten de meeste bezorgdheid. Het gebeurde dat 3-4 contexten mengden in één Common-assembly en elkaar gebruikten binnen dezelfde bedrijfsfuncties. Het was nodig om te begrijpen waar dit kon worden gescheiden en langs welke grenzen, en wat daarna moest gebeuren met de mapping van deze scheiding naar de broncode-assemblies.
We hebben verschillende regels geformuleerd voor het proces van het scheiden van code.
Ten eerste: we wilden niet langer dat bedrijfslogica werd gedeeld tussen services, activiteiten en plugins. We wilden de bedrijfslogica onafhankelijk maken binnen de microservices. Aan de andere kant worden microservices idealiter waargenomen als services die volledig onafhankelijk bestaan. Ik geloof dat deze benadering enigszins verspild is en dat het moeilijk te bereiken is, aangezien bijvoorbeeld services in C# hoe dan ook verbonden zullen zijn met een standaardbibliotheek. Ons systeem is geschreven in C#, andere technologieën hebben we vooralsnog niet gebruikt. Daarom hebben we besloten dat we het ons konden veroorloven om gemeenschappelijke technische assemblies te gebruiken. Het belangrijkste is dat er geen fragmenten van bedrijfslogica in zitten. Als je een handige wrapper hebt voor de ORM die je gebruikt, dan is het heel kostbaar om deze van service naar service te kopiëren.
Ons team is een fan van domeingericht ontwerp, daarom past de "ui architectuur" ons perfect. De basis van onze diensten is geen data access layer, maar een assemblage met domeinlogica, die alleen bedrijfslogica bevat en vrij is van infrastructuurverbindingen. Hierdoor kunnen we de domeinassemblage onafhankelijk verder ontwikkelen om problemen met frameworks op te lossen.
In deze fase stuitten we op het eerste serieuze probleem. De service moest naar één domeinassemblage verwijzen, we wilden de logica onafhankelijk maken, maar het DRY-principe stak hierbij flink dwars. Developers wilden om duplicatie te voorkomen klassen uit naburige assemblages hergebruiken, en als resultaat begonnen de domeinen weer met elkaar te koppelen. We analyseerden de resultaten en besloten dat het probleem mogelijk ook in de structuur van de broncodeopslag zat. We hadden een grote repository waarin alle broncodes lagen. Het was zeer moeilijk om een oplossing voor het gehele project op een lokale machine te verzamelen. Daarom werden er aparte kleine oplossingen voor delen van het project aangemaakt, en niemand verbood het om daarin een Common- of domeinassemblage toe te voegen en te hergebruiken. Het enige hulpmiddel dat ons dit niet toestond, was code review. Maar soms faalde ook dat.
Toen begonnen we over te stappen op een model met aparte repositories. De bedrijfslogica lekte niet meer van de ene service naar de andere, en de domeinen werden inderdaad onafhankelijk. Beperkte contexten worden veel duidelijker ondersteund. Hoe hergebruiken we daarbij infrastructuurbibliotheken? We hebben deze in een aparte repository geplaatst en vervolgens in Nuget-pakketten gestopt, die we in Artifactory hebben geplaatst. Bij elke wijziging vindt de assemblage en publicatie automatisch plaats.
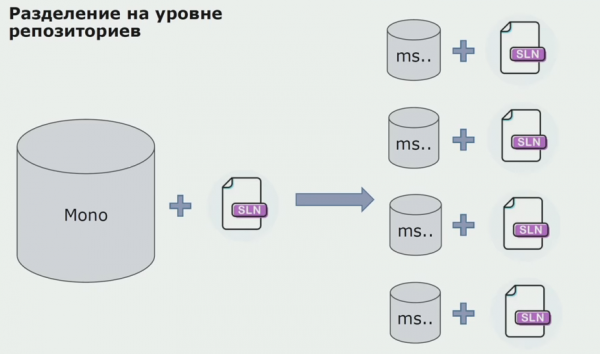
Onze services begonnen naar interne infrastructuurpakketten te verwijzen op dezelfde manier als naar externe. Externe bibliotheken downloaden we uit Nuget. Voor de interactie met Artifactory, waar we deze pakketten plaatsten, hebben we twee pakketbeheerders toegepast. In kleine repositories gebruikten we ook Nuget. In repositories met meerdere services gebruikten we Paket, dat meer consistentie in versies tussen modules garandeert.
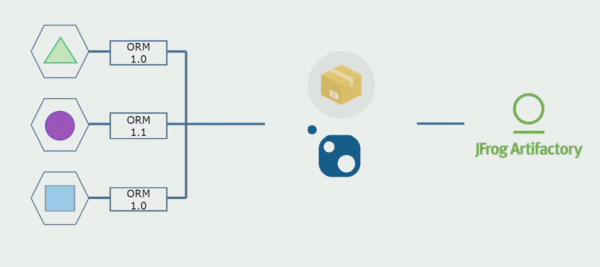
Door de broncode aan te passen, de architectuur enigszins te wijzigen en de repositories te splitsen, maken we onze services onafhankelijker.
Problemen met de infrastructuur
De meeste nadelen bij de overstap naar microservices zijn gerelateerd aan de infrastructuur. Je hebt geautomatiseerde implementatie nodig en nieuwe bibliotheken voor de infrastructuur.
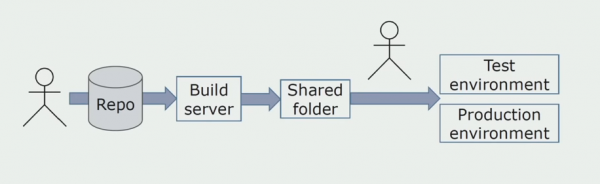
Handmatige installatie in omgevingen
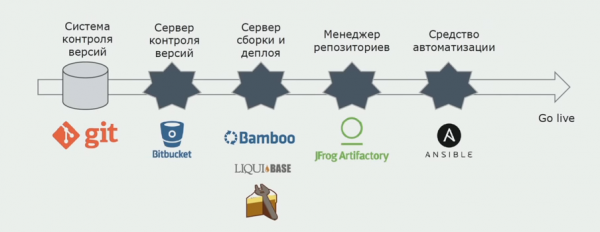
Oorspronkelijk installeerden we de omgevingen handmatig. Om dit proces te automatiseren, hebben we een CI/CD-pijplijn gecreëerd. We hebben gekozen voor een continuous delivery-proces, omdat continuous deployment voor ons op dit moment onaanvaardbaar is vanuit het oogpunt van de bedrijfsprocessen. Daarom gebeurt de implementatie op knopdruk, terwijl het testen automatisch plaatsvindt.
We gebruiken Atlassian en Bitbucket voor het opslaan van de broncode en Bamboo voor de builds. We vinden het fijn om build-scripts te schrijven in Cake, omdat dit dezelfde syntaxis heeft als C#. De kant-en-klare pakketten komen in Artifactory binnen en Ansible zet ze automatisch op testservers, waarna ze direct getest kunnen worden.
Gescheiden logging
Tegenwoordig was een van de ideeën van de monolith het waarborgen van gezamenlijke logging. We moesten ook begrijpen hoe we met afzonderlijke logs moesten omgaan die op schijven liggen. We schrijven logs in tekstbestanden. We hebben besloten om de standaard ELK-stack te gebruiken. We zijn niet rechtstreeks in ELK gaan schrijven via providers, maar hebben besloten om de tekstlogs aan te passen en daar de trace-ID als identificator aan toe te voegen, inclusief de naam van de service, zodat deze logs later geanalyseerd kunnen worden.
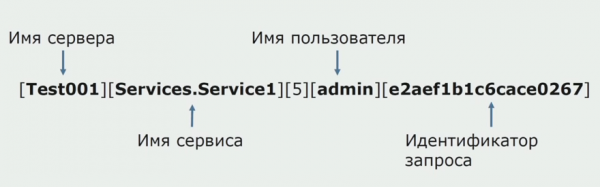
Met Filebeat hebben we de mogelijkheid om onze logs te verzamelen van servers, en ze vervolgens te transformeren, om met Kibana queries in de UI op te bouwen en te zien hoe de aanroep tussen de services verliep. Dit wordt sterk ondersteund door de trace-ID.
Testen en debuggen van gerelateerde services
In het begin begrepen we niet helemaal hoe we de ontwikkelde services moesten debuggen. Met een monolith was het eenvoudig, we draaiden deze op onze lokale machine. We probeerden hetzelfde met microservices, maar soms moet je voor een volledige uitvoering van één microservice ook meerdere andere opstarten, wat ongemakkelijk is. We realiseerden ons dat we moesten overstappen naar een model waarin we alleen de service of services die we willen debuggen op de lokale machine laten draaien. De andere services worden gebruikt vanaf servers die qua configuratie overeenkomen met prod. Na het debuggen, tijdens het testen, worden voor elke taak alleen de gewijzigde services naar de testserver uitgerold. Op deze manier wordt de oplossing getest in de vorm waarin deze in de toekomst op prod zal komen.
Er zijn servers met alleen productieversies van de services. Deze servers zijn nodig voor incidenten, om de levering voor de implementatie te controleren en voor interne trainingen.
We hebben een proces voor automatische testen toegevoegd met behulp van de populaire bibliotheek Specflow. De tests worden automatisch uitgevoerd met NUnit direct na uitrol vanuit Ansible. Als de dekking van de taak volledig automatisch is, is handmatig testen niet nodig. Toch is soms aanvullend handmatig testen vereist. Om te bepalen welke tests voor een specifieke taak moeten worden uitgevoerd, gebruiken we tags in Jira.
Daarnaast is de behoefte aan load testing toegenomen, wat eerder alleen in zeldzame gevallen werd uitgevoerd. Voor het uitvoeren van tests gebruiken we JMeter, voor de opslag — InfluxDB, en voor het maken van grafieken van het proces — Grafana.
Wat hebben we bereikt?
Ten eerste hebben we het begrip ‘release’ afgeschaft. De monsterlijke releases van twee maanden, waarbij deze mastodont in de productieomgeving werd uitgerold en tijdelijk de bedrijfsprocessen verstoorde, zijn verdwenen. Nu rollen we services gemiddeld eens in de 1,5 dag uit, waarbij we ze groeperen, omdat ze in gebruik worden genomen na goedkeuring.
In ons systeem zijn er geen fatale storingen. Als we een microservice met een fout hebben uitgebracht, zal de functionaliteit die daarmee samenhangt gebroken zijn, maar de rest van de functionaliteit lijdt geen schade. Dit verbetert de gebruikerservaring aanzienlijk.
Wij kunnen het implementatieschema beheren. Het is mogelijk om groepen diensten afzonderlijk van de rest van de oplossing te выделять, indien nodig.
Bovendien hebben we het probleem van lange wachttijden voor aanpassingen aanzienlijk verminderd. We hebben aparte productteams die onafhankelijk aan een deel van de diensten werken. Hier past het Scrum-proces al goed. Een specifiek team kan een aparte producteigenaar hebben die hen taken toewijst.
Samenvatting
- Microservices zijn goed geschikt voor de decompostitie van complexe systemen. In dit proces beginnen we te begrijpen wat er in ons systeem is, welke beperkte contexten bestaan en waar de grenzen daarvan liggen. Dit maakt het mogelijk om aanpassingen correct over de modules te verdelen en verwarring in de code te voorkomen.
- Microservices bieden organisatorische voordelen. Ze worden vaak alleen als architectuur besproken, maar elke architectuur is nodig om de behoeften van het bedrijf te vervullen en niet op zichzelf. Daarom kunnen we zeggen dat microservices goed zijn voor het oplossen van taken door kleine teams, gezien het feit dat Scrum nu erg populair is.
- Opsplitsing is een iteratief proces. Je kunt een applicatie niet zomaar in microservices splitsen. Het resulterende product zal waarschijnlijk niet functioneel zijn. Bij het выделять van microservices is het voordelig om bestaande legacy opnieuw te schrijven, dat wil zeggen het om te zetten in code die we leuk vinden en die beter voldoet aan de behoeften van het bedrijf op het gebied van functionaliteit en snelheid.
Een kleine waarschuwing: de kosten voor de overgang naar microservices zijn behoorlijk significant. Alleen al voor het oplossen van het infrastructuurprobleem is veel tijd verloren gegaan. Daarom, als je een kleine applicatie hebt die geen specifieke schaling vereist, en als er niet veel klanten zijn die strijden om de aandacht en tijd van je team, dan zijn microservices misschien niet wat je vandaag nodig hebt. Het is behoorlijk duur. Als je begint met microservices, zullen de kosten in het begin hoger zijn dan wanneer je hetzelfde project start met het ontwikkelen van een monolith.
P.S. Een meer emotioneel verhaal (alsof het persoonlijk voor jou is) – op .
Hier is de volledige versie van de presentatie.
Bron: habr.com
