

SDCM is afgelopen, maar het ongecontroleerde verlangen om te schrijven is gebleven.
Jarenlang heeft onze broer geleden onder het uitvoeren van routinematige taken, met gekruiste vingers voor de commit en slaaptekort door nachtelijke rollbacks.
Maar aan donkere tijden komt een einde.
Met dit artikel begin ik een serie over hoe mij automatisering zich laat zien.
In de loop van de tijd zullen we de fasen van automatisering bespreken, het opslaan van variabelen, het formaliseren van het ontwerp, met RestAPI, NETCONF, YANG, YDK, en we zullen heel veel programmeren.
Voor mij betekent dat a) dit is geen objectieve waarheid, b) het is niet zonder meer de beste benadering c) mijn kijk kan zelfs tijdens de overgang van het eerste naar het laatste artikel veranderen – eerlijk gezegd, van het concept tot de publicatie heb ik alles in totaal twee keer volledig herschreven.
Inhoud
- Doelen
- Het netwerk - als één organisme
- Configuratietests
- Versiebeheer
- Monitoring en zelfherstel van diensten
- Hulpmiddelen
- Inventarisatiesysteem
- Systeem voor IP-beheer
- Systeem voor het beschrijven van netwerkdiensten
- Mechanisme voor apparaatinitialisatie
- Vendor-agnostisch configuratiemodel
- Vendor-specifieke driver interface
- Mechanisme voor het verzenden van configuratie naar een apparaat
- CI/CD
- Mechanisme voor back-up en afwijkingsdetectie
- Monitoring systeem
- Conclusie
Ik zal proberen ADSCM te leiden in een iets andere opzet dan SDCM. Er zullen nog steeds grote, gedetailleerde genummerde artikelen verschijnen, en daartussen zal ik kleine notities uit de dagelijkse ervaring publiceren. Ik zal proberen hier te strijden tegen perfectionisme en niet elk van hen te verfijnen.
Het is grappig dat je voor de tweede keer dezelfde weg moet bewandelen.
Eerst moest ik zelf artikelen over netwerken schrijven omdat die niet beschikbaar waren in het Russisch.
Nu kon ik geen uitgebreid document vinden dat de benaderingen van automatisering systematiseerde en de bovenstaande technologieën aan de hand van eenvoudige praktische voorbeelden uitlegde.
Misschien vergis ik me, dus gooi gerust links naar goede bronnen. Toch zal dit mijn vastberadenheid om te schrijven niet veranderen, want het belangrijkste doel is uiteindelijk om iets zelf te leren, en het verlichten van het leven van anderen is een prettige bonus die de verspreiding van ervaring bevorderd.
We zullen proberen een middelgroot datacenter LAN DC te nemen en het volledige automatiseringsschema uit te werken.
Sommige dingen zal ik bijna voor het eerst samen met jullie doen.
In de beschreven ideeën en hulpmiddelen zal ik niet origineel zijn. Dmitry Figol heeft een uitstekende .
De artikelen zullen in vele opzichten met hen overlappen.
In LAN DC 4 Datacenters, ongeveer 250 switches, een handvol routers en een paar firewalls.
Geen Facebook, maar genoeg om diep na te denken over automatisering.
Er bestaat echter de mening dat als je meer dan 1 apparaat hebt, automatisering al nodig is.
Het is eigenlijk moeilijk voor te stellen dat iemand tegenwoordig zonder ten minste een stapel scripts kan leven.
Hoewel ik heb gehoord dat er bedrijven zijn waar IP-adressen in Excel worden bijgehouden, en elk van de duizenden netwerkapparaten handmatig wordt ingesteld met een unieke configuratie. Dit kan natuurlijk worden gepresenteerd als moderne kunst, maar de gevoelens van de ingenieur zullen zeker gekwetst zijn.
Doelen
Laten we nu de meest abstracte doelen stellen:
- Het netwerk - als één organisme
- Configuratietests
- Versiebeheer van de netwerkstaat.
- Monitoring en zelfherstel van diensten
Later in dit artikel zullen we kijken naar de middelen die we gaan gebruiken, en in de volgende artikelen naar zowel de doelen als de middelen in detail.
Het netwerk - als één organisme
De bepalende zin van de cyclus, hoewel deze op het eerste gezicht niet zo significant lijkt: we zullen het netwerk instellen, niet afzonderlijke apparaten..
In de afgelopen jaren hebben we een verschuiving gezien naar het omgaan met netwerken als één enkele entiteit, en daarom komen Software Defined Networking, Intent Driven Networks en Autonomous Networks.
Want wat hebben applicaties globaal van het netwerk nodig: connectiviteit tussen punt A en B (en soms +B-Y) en isolatie van andere applicaties en gebruikers.
En zo is onze taak in deze serie om een systeem op te bouwen, dat de actuele configuratie ondersteunt van het hele netwerk, dat al wordt gedecomprimeerd tot de actuele configuratie op elk apparaat, afhankelijk van zijn rol en locatie.
Systeem netwerkbeheer houdt in dat we voor wijzigingen in het netwerk informatie opvragen, en het vervolgens de juiste staat voor elk apparaat berekent en instelt.
Op deze manier minimaliseren we bijna tot nul het handmatig werken in CLI — alle wijzigingen in de instellingen van apparaten of netwerkontwerpen moeten worden geformaliseerd en gedocumenteerd — en pas daarna uitgerold naar de juiste netwerkcomponenten.
Bijvoorbeeld, als we besluiten dat de rack switches in Kazan vanaf nu twee netwerken in plaats van één moeten aankondigen, dan
- documenteren we eerst de wijzigingen in de systemen
- Generen we de doelconfiguratie van alle netwerkapparaten
- Starten we het programma voor het bijwerken van de netwerkconfiguratie, dat berekent wat op elke node moet worden verwijderd, wat moet worden toegevoegd, en brengt de nodes in de gewenste toestand.
In deze fase voeren we handmatig wijzigingen alleen in de eerste stap door.
Configuratietests
, dat 80% van de problemen zich voordoen tijdens het wijzigen van de configuratie — een indirect bewijs hiervoor is dat het meestal rustig is tijdens de kerstvakantie.
Ik heb persoonlijk tientallen wereldwijde downtime's meegemaakt door menselijke fouten: een verkeerde opdracht, niet in de juiste configuratietak uitgevoerd, vergeten om de community in te voegen, MPLS wereldwijd op de router gewist, vijf apparaten ingesteld, maar op de zesde een fout niet opgemerkt, oude wijzigingen die door iemand anders zijn aangebracht gecommitteerd. Er zijn ontelbare scenario's.
Automatisering helpt ons om minder fouten te maken, maar op een grotere schaal. Zo kan je niet slechts één apparaat, maar het hele netwerk in één keer onbruikbaar maken.
Van oudsher controleerden onze voorouders de juistheid van de aangebrachte wijzigingen met een scherp oog, stalen zenuwen en het functioneren van het netwerk na hun implementatie.
De voorouders wiens werk leidde tot stilstand en catastrofale verliezen, lieten minder nageslacht achter en zouden met de tijd moeten uitsterven, maar evolutie is een traag proces, en daarom controleren nog steeds niet iedereen de wijzigingen vooraf in een laboratorium.
Echter, aan de voorhoede van de vooruitgang zijn degenen die het proces van het testen van configuraties hebben geautomatiseerd, en de verdere toepassing in het netwerk. Met andere woorden — hebben ze de CI/CD-procedure () van ontwikkelaars overgenomen.
In een van de secties zullen we bekijken hoe dit kan worden gerealiseerd met behulp van een versiebeheersysteem, waarschijnlijk GitHub.
Zodra je het idee van netwerk CI/CD accepteert, zal de methode om de configuratie te controleren door deze in het werkelijke netwerk toe te passen je ineens middeleeuwse onwetendheid lijken. Bijna alsof je met een hamer op een kernkop klopt.
De organieke uitbreiding van ideeën over het netwerk beheer en CI/CD resulteert in een volledige versiebeheer van de configuratie.
Versiebeheer
We will assume that with any changes, even the slightest, even on one unnoticed device, the entire network transitions from one state to another.
And we never execute a command on the device; we change the state of the network.
So, shall we call these states versions?
Let’s say the current version is 1.0.0.
Did the IP address of the Loopback interface change on one of the ToRs? This is a minor version—it will be numbered 1.0.1.
Reviewing the route import policies in BGP—this is a bit more serious—already 1.1.0.
Deciding to get rid of the IGP and only switch to BGP—that’s already a radical design change—2.0.0.
At the same time, different DCs may have different versions—the network evolves, new equipment is installed, new levels of spines are added somewhere, and not elsewhere, etc.
Over we will discuss this in a separate article.
I repeat—any change (except for debugging commands) is a version update. Administrators should be notified of any deviations from the current version.
The same applies to rolling back changes—this is not cancelling recent commands, nor is it a rollback by the operating system of the device—it is bringing the entire network to a new (old) version.
Monitoring en zelfherstel van diensten
This self-evident task in modern networks is reaching a new level.
Often, large service providers adopt the approach that a fallen service must be quickly resolved and a new one raised instead of figuring out what happened.
"Very" means that from all sides, there should be ample monitoring that will detect any deviations from the norm within seconds.
And here, the usual metrics like interface load or node availability are not enough. Manual monitoring by the on-duty staff is also insufficient.
For many things, there should be - monitoring lights up red and goes to apply a band-aid where it hurts.
And here we also monitor not only individual devices but the health of the entire network, both in white-box (which is relatively clear) and black-box (which is already more complex) terms.
What do we need to implement such ambitious plans?
- To have a list of all devices in the network, their locations, roles, models, and software versions.
kazan-leaf-1.lmu.net, Kazan, leaf, Juniper QFX 5120, R18.3. - To have a system for describing network services.
IGP, BGP, L2/3VPN, Policy, ACL, NTP, SSH. - Vermogen om een apparaat te initialiseren.
Hostname, Mgmt IP, Mgmt Route, Gebruikers, RSA-Keys, LLDP, NETCONF - Het apparaat configureren en de configuratie naar de gewenste (inclusief oude) versie terugbrengen.
- De configuratie testen
- Periodiek de status van alle apparaten controleren op afwijkingen van de actuele situatie en het juiste bericht versturen.
Iemand heeft 's nachts stilletjes een regel aan de ACL toegevoegd. - Toezicht houden op de werking.
Hulpmiddelen
Dat klinkt behoorlijk ingewikkeld om het project in componenten te decomponeren.
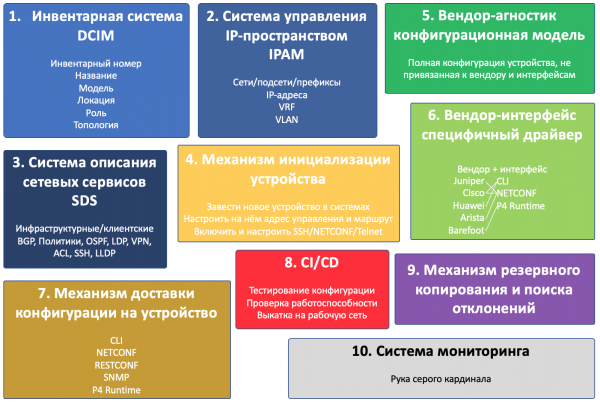
En het zullen er tien zijn:
- Inventarisatiesysteem
- Systeem voor IP-beheer
- Systeem voor het beschrijven van netwerkdiensten
- Mechanisme voor apparaatinitialisatie
- Vendor-agnostisch configuratiemodel
- Vendor-specifieke driver interface
- Mechanisme voor het verzenden van configuratie naar een apparaat
- CI/CD
- Mechanisme voor back-up en afwijkingsdetectie
- Monitoring systeem
Dit is trouwens een voorbeeld van hoe de kijk op de doelstellingen van de cyclus is veranderd - in de conceptversie waren het er vier.
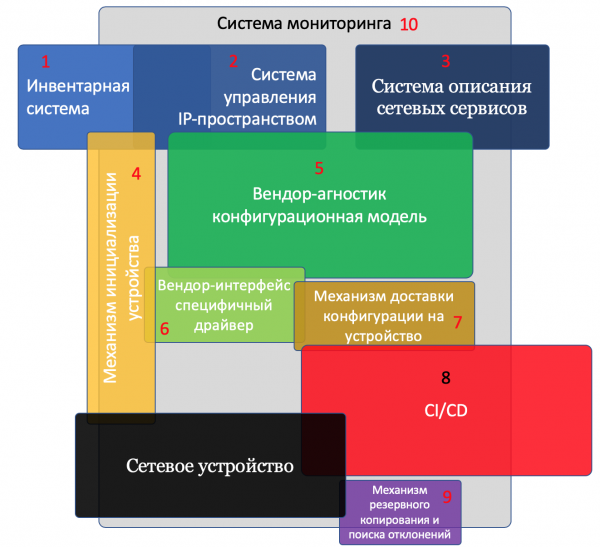
Op de afbeelding heb ik alle componenten en het eigenlijke apparaat afgebeeld.
Overlappende componenten communiceren met elkaar.
Hoe groter het blok, hoe meer aandacht aan deze component gegeven moet worden.
Component 1. Inventarissysteem
Het is duidelijk dat we willen weten welk apparaat waar staat en waaraan het is aangesloten.
Het inventarissysteem is een essentieel onderdeel van elke onderneming.
Vaak heeft een onderneming voor netwerkapparaten een apart inventarissysteem dat meer specifieke taken behandelt.
In de reeks artikelen zullen we dit DCIM - Data Center Infrastructure Management - noemen. Hoewel de term DCIM strikt genomen veel meer omvat.
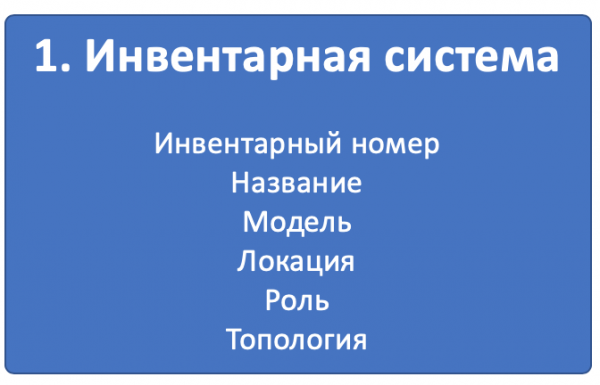
Voor onze doeleinden gaan we hierin de volgende informatie over het apparaat opslaan:
- Inventarisnummer
- Naam/beschrijving
- Model (Huawei CE12800, Juniper QFX5120, enz.)
- Kenmerken (kaarten, interfaces, enz.)
- Rol (Leaf, Spine, Border Router, enz.)
- Locatie (regio, stad, datacenter, rack, eenheid)
- Interconnects tussen apparaten
- Netwerk topologie
Het is volkomen begrijpelijk dat we zelf al deze informatie willen hebben.
Maar helpt dit bij automatiseringsdoelen?
Zeker.
Bijvoorbeeld, we weten dat in dit datacenter op Leaf-schakelaars, als het Huawei is, ACL's voor het filteren van bepaalde verkeer op VLAN moeten worden toegepast, en als het Juniper is, dan op unit 0 van de fysieke interface.
Of we moeten een nieuwe Syslog-server op alle borders van de regio implementeren.
In deze zullen we ook virtuele netwerkapparaten opslaan, bijvoorbeeld virtuele routers of route-reflectoren. We kunnen DNS-servers, NTP, Syslog en eigenlijk alles toevoegen dat op de een of andere manier met het netwerk te maken heeft.
Component 2. IP-adresbeheer systeem
Ja, ook tegenwoordig zijn er groepen mensen die voor het bijhouden van prefixen en IP-adressen een Excel-bestand gebruiken. Maar de moderne aanpak is toch een database, met een frontend op nginx/apache, API en uitgebreide functies voor het beheren van IP-adressen en netwerken met scheiding in VRF.
IPAM - IP Adresbeheer.
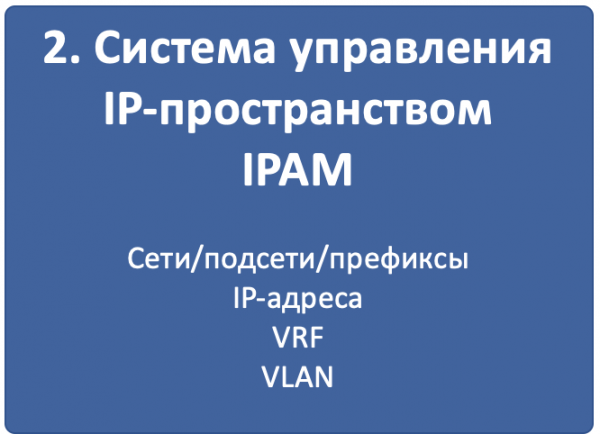
Voor onze doeleinden slaan we hierin de volgende informatie op:
- VLAN
- VRF
- Netwerken/Subnetten
- IP-adressen
- Koppeling van adressen aan apparaten, netwerken aan locaties en VLAN-nummers
Het is duidelijk dat we er zeker van willen zijn dat, wanneer we een nieuw IP-adres toewijzen voor de loopback van de ToR, we niet tegenkomen dat het al aan iemand anders is toegewezen. Of dat we hetzelfde prefix tweemaal in verschillende delen van het netwerk hebben gebruikt.
Maar hoe helpt dit bij de automatisering?
Eenvoudig.
We vragen in het systeem het prefix met de rol Loopbacks aan, waarin beschikbare IP-adressen zijn voor toewijzing - als het gevonden wordt, wijzen we het adres toe, als dat niet zo is, vragen we om een nieuw prefix te creëren.
Of bij het maken van de configuratie van een apparaat kunnen we vanuit hetzelfde systeem achterhalen in welk VRF de interface moet zijn.
Bij de opstart van een nieuwe server gaat het script naar het systeem, ontdekt in welke serverswitch, op welke poort en welk subnet aan de interface is toegewezen - hieruit wordt het serveradres toegewezen.
Het dringt zich op om DCIM en IPAM te combineren in één systeem, om functies niet te dupliceren en niet twee vergelijkbare entiteiten te onderhouden.
Dat gaan we doen.
Component 3. Systeem voor het beschrijven van netwerkservices
Als de eerste twee systemen variabelen opslaan die nog op de een of andere manier moeten worden gebruikt, beschrijft de derde voor elke rol van het apparaat hoe het moet worden ingesteld.
Er zijn twee verschillende typen netwerkservices te onderscheiden:
- Infrastructuur
- Klantservices.
De eerste zijn bedoeld om basisconnectiviteit en apparaatbeheer te waarborgen. Dit omvat VTY, SNMP, NTP, Syslog, AAA, routeringsprotocollen, CoPP, enz.
De tweede organiseert een dienst voor de klant: MPLS L2/L3VPN, GRE, VXLAN, VLAN, L2TP, enz.
Natuurlijk zijn er ook grensgevallen - waar moeten we MPLS LDP, BGP onderbrengen? En routeringsprotocollen kunnen ook voor klanten worden gebruikt. Maar dat is niet cruciaal.
Beide typen services worden onderverdeeld in configuratie-primitive:
- fysieke en logische interfaces (tag/untag, mtu)
- IP-adressen en VRF (IP, IPv6, VRF)
- ACL en verkeersverwerkingspolicies
- Protocollen (IGP, BGP, MPLS)
- Routeringsbeleid (prefix-lijsten, communities, ASN-filters).
- Service Services (SSH, NTP, LLDP, Syslog...)
- Etc.
Hoe we dit precies gaan doen, heb ik nog geen idee. We zullen het in een apart artikel uitzoeken.
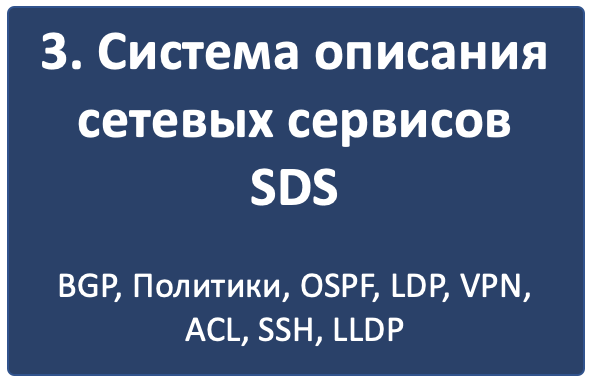
Als we iets dichter bij het leven blijven, zouden we kunnen beschrijven dat
De leaf-switch moet BGP-sessies hebben met alle verbonden spine-switches, de verbonden netwerken importeren in het proces en alleen netwerken van een bepaald prefix van spine-switches accepteren. CoPP IPv6 ND beperken tot 10 pps, enz.
Op hun beurt houden de spine-switches sessies met alle verbonden leafs, fungeren als route-reflectors en accepteren alleen routes van bepaalde lengte en met een bepaalde community.
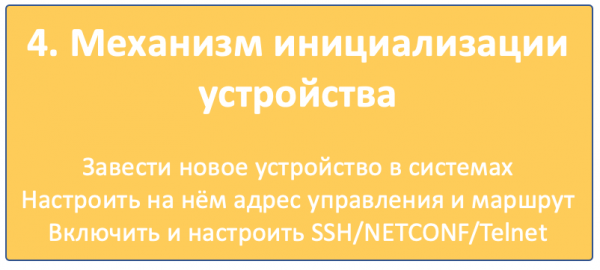
Component 4. Mechanisme voor apparaatinitialisatie
Onder deze titel verzamel ik de vele acties die moeten plaatsvinden zodat het apparaat op de radar verschijnt en van afstand benaderd kan worden.
- Het apparaat registreren in het inventarissysteem.
- Een IP-adres voor beheer toewijzen.
- Basis toegang configureren:
Hostname, beheers-IP-adres, route naar het beheernetwerk, gebruikers, SSH-sleutels, protocollen — telnet/SSH/NETCONF
Er zijn drie benaderingen:
- Helemaal handmatig. Het apparaat wordt naar de stand gebracht, waar een gewone organische persoon het in systemen registreert, zich aansluit via de console en het configureert. Dit kan werken in kleine statische netwerken.
- ZTP — Zero Touch Provisioning. De hardware is aangekomen, is aangesloten en heeft via DHCP een adres ontvangen, is naar een speciale server gegaan en heeft zichzelf geconfigureerd.
- Infrastructuur van console-servers, waar de eerste configuratie via de consolepoort automatisch plaatsvindt.
We zullen het over alle drie in een apart artikel hebben.
Component 5. Vendor-onafhankelijke configuratiemodel
Tot nu toe waren alle systemen losse lappen die variabelen en een declaratieve beschrijving gaven van wat we in het netwerk zouden willen zien. Maar vroeg of laat, zullen we met de specificiteit te maken krijgen.
In deze fase worden primitieve, diensten en variabelen voor elk specifiek apparaat gecombineerd in een configuratiemodel dat feitelijk de volledige configuratie van het specifieke apparaat beschrijft, maar op een vendor-onafhankelijke manier.
Wat levert deze stap op? Waarom zouden we niet meteen de configuratie van het apparaat maken die we gewoon kunnen uploaden?
In feite lost dit drie problemen op:
- Zorg ervoor dat je niet afhankelijk bent van een specifiek apparaatinterface. Of het nu CLI, NETCONF, RESTCONF of SNMP is - het model blijft hetzelfde.
- Houd het aantal sjablonen/scripts niet gelijk aan het aantal leveranciers in het netwerk, en wijzig bij een herontwerp niet hetzelfde op meerdere plaatsen.
- Laad de configuratie van het apparaat (back-up), leg deze in precies hetzelfde model, en vergelijk vervolgens de doelconfiguratie met de bestaande om de delta te berekenen en een configuratiepatch voor te bereiden die alleen die delen wijzigt die nodig zijn, of om afwijkingen vast te stellen.
Als resultaat van deze fase krijgen we een leverancieronafhankelijke configuratie.
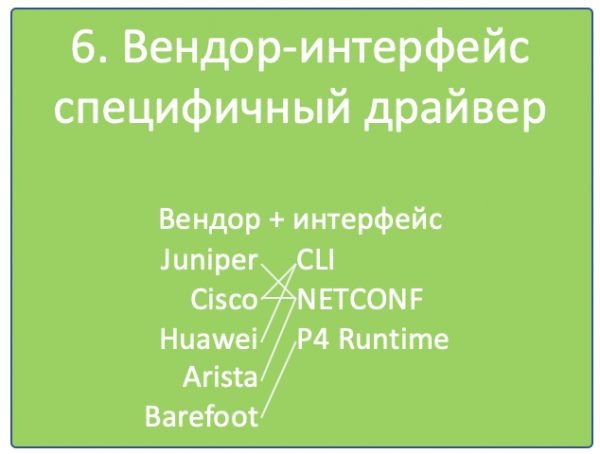
Component 6. Leverancier-specifieke interface driver
Verlies de hoop niet dat je ooit Cisco-configuraties zult kunnen instellen zoals Juniper-configuraties, gewoon door dezelfde oproepen naar hen te sturen. Ondanks de opkomende populariteit van whiteboxes en de ondersteuning voor NETCONF, RESTCONF en OpenConfig, verschilt de specifieke content die met deze protocollen wordt geleverd van leverancier tot leverancier, en dat is een van hun concurrentievoordelen die ze niet zomaar zullen opgeven.
Dit is eigenlijk vergelijkbaar met OpenContrail en OpenStack, die REST API gebruiken als hun NorthBound-interface en totaal verschillende oproepen verwachten.
Dus in stap vijf moet het leverancieronafhankelijke model de vorm aannemen waarin het op de hardware kan worden geïmplementeerd.
En hier is alles toegestaan (niet echt): CLI, NETCONF, RESTCONF, SNMP, gewoon bij het afschaffen.
Daarom hebben we een driver nodig die het resultaat van de vorige stap omzet naar het juiste formaat van de specifieke leverancier: een set CLI-commando's, een XML-structuur.
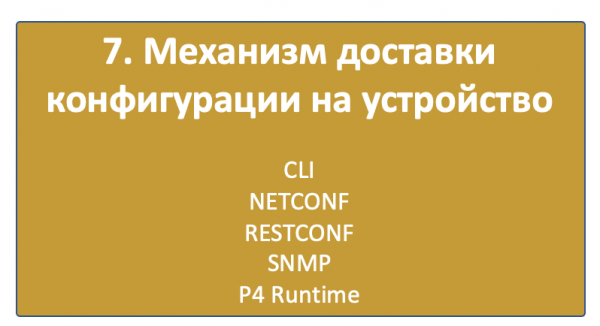
Component 7. Mechanisme voor het afleveren van configuraties op het apparaat
We hebben de configuratie gegenereerd, maar deze moet nog op de apparaten worden afgeleverd - en dat doen we uiteraard niet met de hand.
Firstly, dat brengt ons bij de vraag welk transport we gaan gebruiken? En de keuze van vandaag is al behoorlijk groot:
- CLI (telnet, ssh)
- SNMP
- NETCONF
- RESTCONF
- REST API
- OpenFlow (hoewel dit uit de lijst valt, omdat het een manier is om FIB af te leveren, niet om instellingen)
Laten we hier de puntjes op de i zetten. CLI - dat is legacy. SNMP... khem-khem.
RESTCONF is vooralsnog een onbekend beestje, REST API wordt bijna door niemand ondersteund. Daarom zullen we ons in de cyclus concentreren op NETCONF.
Eigenlijk, zoals de lezer al heeft begrepen, hebben we op dit punt al besloten over de interface — het resultaat van de vorige stap is al gepresenteerd in het formaat van de gekozen interface.
Secondly, en met welke tools gaan we dat doen?
Hier is de keuze ook groot:
- Een zelfgeschreven script of een platform. We bewapenen ons met ncclient en asyncIO en doen alles zelf. Wat staat ons in de weg om een deployment-systeem vanaf nul op te bouwen?
- Ansible met zijn rijke bibliotheek aan netwerkmodules.
- Salt met zijn beperkte netwerkfunctionaliteit en integratie met Napalm.
- Eigenlijk Napalm, dat slechts een paar leveranciers kent en verder niets, tot ziens.
- Nornir — nog een beestje dat we in de toekomst zullen ontleden.
Hier is er nog geen favoriet gekozen — we gaan verder kijken.
Wat is hier nog meer belangrijk? De gevolgen van het toepassen van de configuratie.
Succesvol of niet. Is de toegang tot de hardware behouden of niet?
Het lijkt erop dat hier een commit met bevestiging en validatie van wat in het apparaat is geladen kan helpen.
Dit, in combinatie met een correcte implementatie van NETCONF, beperkt het aantal geschikte apparaten aanzienlijk — normale commits worden door niet zo veel fabrikanten ondersteund. Maar dit is gewoon een van de vereiste voorwaarden in . Uiteindelijk maakt niemand zich zorgen dat geen enkele Russische leverancier voldoet aan de voorwaarde van 32*100GE-interface. Of maken ze zich daar wel zorgen over?
Component 8. CI/CD
Op dit moment hebben we al een configuratie voor alle netwerkapparaten.
Ik schrijf 'voor alle', omdat we het hebben over versiebeheer van de staat van het netwerk. En zelfs als we alleen de instellingen van één switch moeten wijzigen, worden de wijzigingen voor het gehele netwerk berekend. Voor de meeste knooppunten kunnen deze uiteraard nul zijn.
Maar, zoals eerder al werd gezegd, zijn we geen barbaren die alles in één keer in productie gooien.
De gegenereerde configuratie moet eerst door de CI/CD-pipeline gaan.
CI/CD staat voor Continuous Integration, Continuous Deployment. Dit is een aanpak waarbij het team niet één keer per half jaar een nieuwe grote release uitbrengt die de oude volledig vervangt, maar regelmatig incrementeel nieuwe functionaliteit introduceert (Deployment) in kleine porties, waarbij elke portie uitgebreid wordt getest op compatibiliteit, veiligheid en functionaliteit (Integration).
Hiervoor hebben we een versiebeheersysteem dat de wijzigingen in de configuratie bijhoudt, een laboratorium waar gecontroleerd wordt of de klantendienst werkt, een monitoring systeem dat deze feiten controleert, en de laatste stap is het uitrollen van wijzigingen naar het productienetwerk.
Met uitzondering van debug-commando's moeten alle wijzigingen in het netwerk via de CI/CD Pipeline gaan — dit is onze garantie voor een zorgeloos leven en een lange, gelukkige carrière.
Component 9. Back-up- en afwijkingsdetectiesysteem
Er hoeft niet veel gezegd te worden over back-ups.
We zullen ze gewoon op cron of bij iedere wijziging in de configuratie in Git opslaan.
Maar het tweede deel is interessanter — iemand moet deze back-ups in de gaten houden. In sommige gevallen moet deze persoon alles terugdraaien naar hoe het was, en in andere gevallen moet hij of zij iemand verwittigen dat er iets niet klopt.
Bijvoorbeeld, als er een nieuwe gebruiker is geïntroduceerd die niet in de variabelen is opgenomen, moet je deze verwijderd houden van de hacks. En als er een nieuwe firewallregel is — beter niet aanraken, misschien heeft iemand gewoon de debug ingeschakeld, of misschien heeft een nieuwe dienst, onhandig, deze niet volgens het reglement ingesteld, terwijl mensen er al gebruik van maken.
Van een bepaalde kleine delta binnen het gehele netwerk zullen we hoe dan ook niet kunnen ontsnappen, ongeacht welke automatiseringssystemen en de strikte hand van het management. Voor het debuggen van problemen zal niemand de configuratie in systemen aanbrengen. Bovendien is het mogelijk dat het configuratiemodel deze zelfs niet ondersteunt.
Bijvoorbeeld, een firewallregel voor het tellen van het aantal pakketten voor een bepaald IP, voor het lokaliseren van een probleem — is een vrij gangbare tijdelijke configuratie.
Component 10. Monitoringsysteem
In eerste instantie was ik niet van plan om het onderwerp monitoring te behandelen — het is immers een omvangrijk, controversieel en complex onderwerp. Maar al snel bleek dat het een integraal onderdeel van automatisering is. En je kunt er simpelweg niet omheen, zelfs niet zonder praktische ervaring.
Als we die gedachte verder ontwikkelen — dit is een organisch onderdeel van het CI/CD-proces. Na het uitrollen van de configuratie naar het netwerk, moeten we kunnen vaststellen of alles nu in orde is.
En het gaat niet alleen om grafieken van het gebruik van interfaces of de beschikbaarheid van knooppunten, maar ook om meer verfijnde zaken — de aanwezigheid van de benodigde routes, de attributen daarop, het aantal BGP-sessies, OSPF-buren, end-to-end functionaliteit van de hogere services.
Zijn er geen problemen meer met het verzamelen van syslogs op de externe server, is de SFlow-agent niet defect, zijn de drops in de wachtrijen niet toegenomen en is de connectiviteit tussen een paar prefixes niet verbroken?
In een apart artikel zullen we hier ook over nadenken.
Conclusie
Als basis heb ik een van de moderne ontwerpen van datacenter-netwerken gekozen — L3 Clos Fabric met BGP als routeringsprotocol.
We zullen deze keer het netwerk bouwen met Juniper, omdat de JunOs-interface nu gebruiksvriendelijk is.
We zullen het ons moeilijk maken door alleen Open Source-tools en een multi-vendor netwerk te gebruiken — daarom kies ik naast Juniper ook een andere gelukkige leverancier.
Het plan voor de komende publicaties is ongeveer als volgt:
Eerst zal ik vertellen over virtuele netwerken. Allereerst omdat ik dat graag wil, en ten tweede omdat het ontwerp van het infrastructuurnetwerk zonder dit niet echt duidelijk zal zijn.
Dan ga ik het hebben over het ontwerp van het netwerk: topologie, routering, beleidsregels.
We zullen een laboratoriumstand opzetten.
We zullen nadenken en misschien oefenen met het initialiseren van het apparaat in het netwerk.
En daarna over elk component in intieme details.
En ja, ik beloof niet om deze cyclus elegant af te sluiten met een kant-en-klare oplossing. 🙂
Nuttige links
- Voordat we verder ingaan op de serie, is het de moeite waard om het boek van Natasha Samoylenko te lezen, . Misschien moet u ook de .
- lezen over het ontwerp van datacenterfabrieken van Facebook, geschreven door Petr Lapukhov. De documentatie over de architectuur geeft je een idee van hoe Overlay SDN werkt,
- (voorheen Open Contrail). Roman Gorgé. Voor opmerkingen en correcties.
Bedankt
Artem Chernobai. Voor KDPV.
Automatisering voor de allerkleinsten. Deel één (deze komt na nul). Netwerkvirtualisatie
Bron: habr.com
